Einführung
Northline Library hilft Lesern, Bücher zu entdecken, Verfügbarkeit zu prüfen und eine Reservierung anzusehen. Die Startseite kann gesund aussehen, obwohl die Suche nicht funktioniert. Deine Aufgabe ist, dieses Kundenergebnis zu überwachen und das Team erst bei anhaltenden Fehlern zu benachrichtigen.
Grundlegende Terminalkenntnisse reichen. Bibliothek, Prometheus (Messwerte und Regeln), Blackbox Exporter (echte HTTP-Prüfungen), Alertmanager (Zustellung) und lokaler Posteingang sind vorbereitet. Du bearbeitest zwei kurze YAML-Dateien. Programmierung, Installation, Mailkonto oder externe Nachrichten sind nicht nötig. Alles läuft auf einer Übungsinstanz mit erfundenen Büchern und schreibgeschützten Reservierungsvorschauen.
Nutze Library für Leseraktionen, Workstation für Befehle und Monitoring für echte Beobachtungen und zugestellte Webhooks. Website und Beschriftungen bleiben Englisch. Jede Einheit beginnt unabhängig.
Die Suche des Lesers überwachen
In diesem Schritt wählst du eine Kundenprüfung aus. Beginne in Library: Nutze zuerst den normalen Dienst und wähle dann eine Prüfung des tatsächlichen Leserbedarfs.
Den Leserablauf ausprobieren
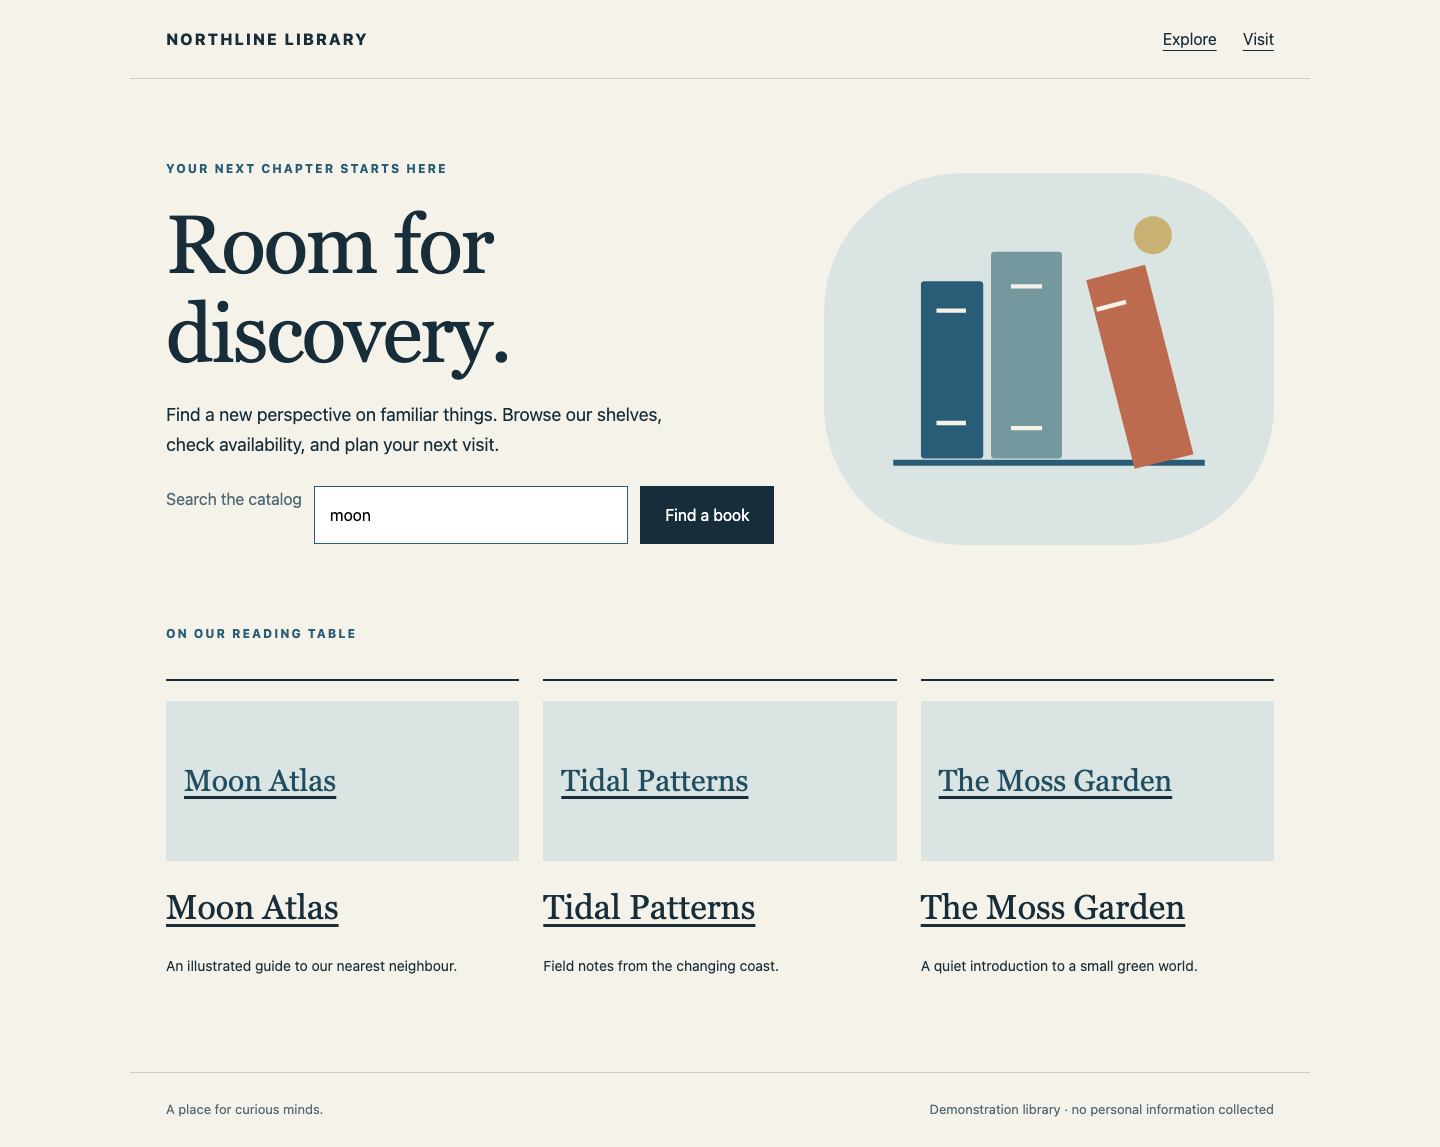
Lass moon in Search the catalog stehen und wähle Find a book. Das Ergebnis muss Moon Atlas, Available und den Regalplatz enthalten. Öffne Moon Atlas, dann Check reservation: Die schreibgeschützte Vorschau zeigt Ready to collect: Moon Atlas. Es wird nichts reserviert. Wähle Back to book, danach NORTHLINE LIBRARY. Öffne Visit, lies die Öffnungszeiten und kehre über den Markenlink zurück.
Die Prüfung verstehen
Wechsle zu Workstation, bereits im Verzeichnis /home/labex/project/library-watch. Ein Pfad benennt eine Datei oder ein Verzeichnis; dieser absolute Pfad beginnt an der Systemwurzel. pwd zeigt deinen Standort, ls listet Namen und cat zeigt eine Datei:
pwd
ls
cat prometheus.yml
Du findest prometheus.yml, alerts.yml und watch.sh. Eine Konfiguration beschreibt das Verhalten eines Programms. YAML verwendet Leerzeichen zur Einrückung, Paare aus key: value und einen Bindestrich für Listenelemente. Behalte die gezeigten Abstände bei. Du brauchst keinen Editor: Die kleine Konfiguration wird durch einen vollständigen Textblock ersetzt.
HTTP ist das Anfrage-Antwort-Protokoll des Browsers. Eine URL enthält Adresse, einen Port für den Dienst und einen Pfad. In Workstation bedeutet 127.0.0.1 diese Instanz. Port 8081 bietet die Bibliothek an; /search?q=moon sucht mit dem Abfrageparameter q gleich moon. Behalte im Terminal die Anführungszeichen um die URL, damit die Shell sie als ein Argument behandelt.
Der vorbereitete Job library prüft bisher nur die Startseite. Ein Job ist eine benannte Gruppe von Abfragezielen. Der Exporter auf Port 9115 sendet eine echte Anfrage und liefert probe_success: 1 für Erfolg, 0 für Fehler. Sein Modul search verlangt die Inhalte Moon Atlas und Available, zusätzlich zum HTTP-Status 200. Prometheus fragt dieses Ergebnis alle 2 Sekunden ab. Die separate Metrik up sagt nur, ob Prometheus den Exporter abfragen konnte; sie beweist keinen erfolgreichen Leserablauf.
Den Kundenpfad auswählen
cat > prometheus.yml ersetzt die Datei. <<'YAML' startet ein wörtliches Here-Dokument: Füge den ganzen Block einschließlich des abschließenden YAML auf einer eigenen Zeile ein. global definiert die Zeitabstände, rule_files benennt die Regeln, alerting verbindet die vorbereitete Zustellung. Behalte diese Einstellungen und ändere Modul und Ziel auf die Suche. Das Label journey: search kennzeichnet den Geschäftsablauf.
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload startet das bereitgestellte Hilfsprogramm. Es prüft die Syntax und fordert anschließend Prometheus zum Neuladen auf. Es verändert weder die Bibliothek noch Beobachtungen.
bash watch.sh reload
Erwarte Configuration accepted. Warte etwa 4 Sekunden und wechsle zu Monitoring. Business probes sollte search: healthy anzeigen. Bei einem YAML-Fehler gehe zu Workstation zurück, ersetze die Datei durch den vollständigen Block und lade erneut. Sind Messwerte unavailable, warte und versuche es erneut: unavailable bedeutet niemals healthy. Richte das Ziel nicht auf Monitoring selbst.
Erreichbarkeit mit Erfolg vergleichen
Wechsle zu Workstation. fault search seconds 6 lässt nur die Suche 6 echte Sekunden ausfallen und stellt sie danach automatisch wieder her. Es setzt keinen Alarmzustand. curl sendet HTTP-Anfragen; -sS versteckt den Fortschritt, zeigt aber Verbindungsfehler. Führe aus:
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
Der Inhalt meldet Search is taking a break. Der Server liefert absichtlich weiter HTTP 200. Eine reine Statusprüfung würde den Geschäftsfehler übersehen. Wechsle sofort zu Monitoring: Innerhalb eines Abfrageintervalls sollte die Suche failed werden und nach der Erholung zu healthy zurückkehren. Verpasst du das kurze Fenster, wiederhole die 6 Sekunden. Noch ist kein Alarm konfiguriert. Warte vor der Schrittprüfung auf healthy.
Nur bei anhaltendem Fehler alarmieren
In diesem Schritt konfigurierst du einen Kundenalarm mit ausreichend Wartezeit, um den kurzen Fehler zu ignorieren. Beginne in Workstation.
Die Bedingung lesen
Prometheus wertet Regeln alle 2 Sekunden aus. probe_success{job="library",journey="search"} == 0 wählt fehlgeschlagene Suchmesswerte des Jobs library. Die geschweiften Klammern enthalten Labelfilter; == 0 wählt Fehler statt Erfolg. Nur up würde die Datenerfassung überwachen, nicht die Leser. Ohne Labels könnten fremde Dienste einbezogen werden.
for: 20s verlangt, dass die Bedingung 20 Sekunden aktiv bleibt. pending bedeutet, dass sie vorliegt, aber noch wartet; firing, dass sie lange genug vorliegt; inactive, dass sie fehlt. Die kurzen 20 Sekunden sind für diese Übung, keine allgemeine Produktionsempfehlung. Fehlende Prüfdaten zeigt Monitoring als unavailable. Sie beweisen weder einen gesunden Dienst noch einen tatsächlichen Geschäftsfehler.
alert benennt die Regel. severity ist ein Routinglabel und annotations.summary beschreibt die Kundenfolge. Schreibe die vollständige Regel:
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Erwarte Configuration accepted. Schlägt die Prüfung fehl, korrigiere Leerzeichen oder Satzzeichen und lade neu. Bis die neue Konfiguration angenommen wird, bleibt die letzte gültige aktiv.
Wechsle zu Monitoring. Bei gesunder Suche sollte CustomerJourneyFailed: inactive (20 seconds) erscheinen. Der lokale Posteingang sollte noch leer sein.
Einen kurzen Fehler ohne Störung nachweisen
Wechsle zu Workstation und wiederhole denselben kurzen Geschäftsfehler:
bash watch.sh fault search seconds 6
Wechsle sofort zu Monitoring. Die Suche fällt aus; die Regel kann kurz pending zeigen. Nach automatischer Erholung kehren Prüfung und Regel zu healthy/inactive zurück. Der Posteingang bleibt leer. Lass etwa 12 Sekunden für den ganzen Ablauf. Hast du zuvor einen längeren Fehler ausgelöst, bleiben frühere Meldungen erhalten: Vergleiche neue Ereignisse, statt Belege zu löschen.
Eine firing-Regel und eine zugestellte Meldung sind verschiedene Tatsachen. Alertmanager empfängt firing-Alarme, gruppiert sie, wartet bei einer neuen Gruppe 1 Sekunde und stellt sie dem lokalen Webhook-Posteingang zu. Erfassung, Auswertung und Zustellung bringen jeweils eine kleine Verzögerung. Entferne for nicht und senke nicht alle Schwellen, nur weil die Meldung nicht sofort erscheint.
Ausfall und Wiederherstellung empfangen
In diesem Schritt übst du einen anhaltenden Fehler und beobachtest die tatsächliche Zustellung. Beginne in Workstation.
Einen anhaltenden Fehler beobachten
Der nächste Fehler dauert 60 echte Sekunden, damit du alle Zustände sehen kannst. Nur die Suche fällt aus; die Startseite funktioniert weiter.
bash watch.sh fault search seconds 60
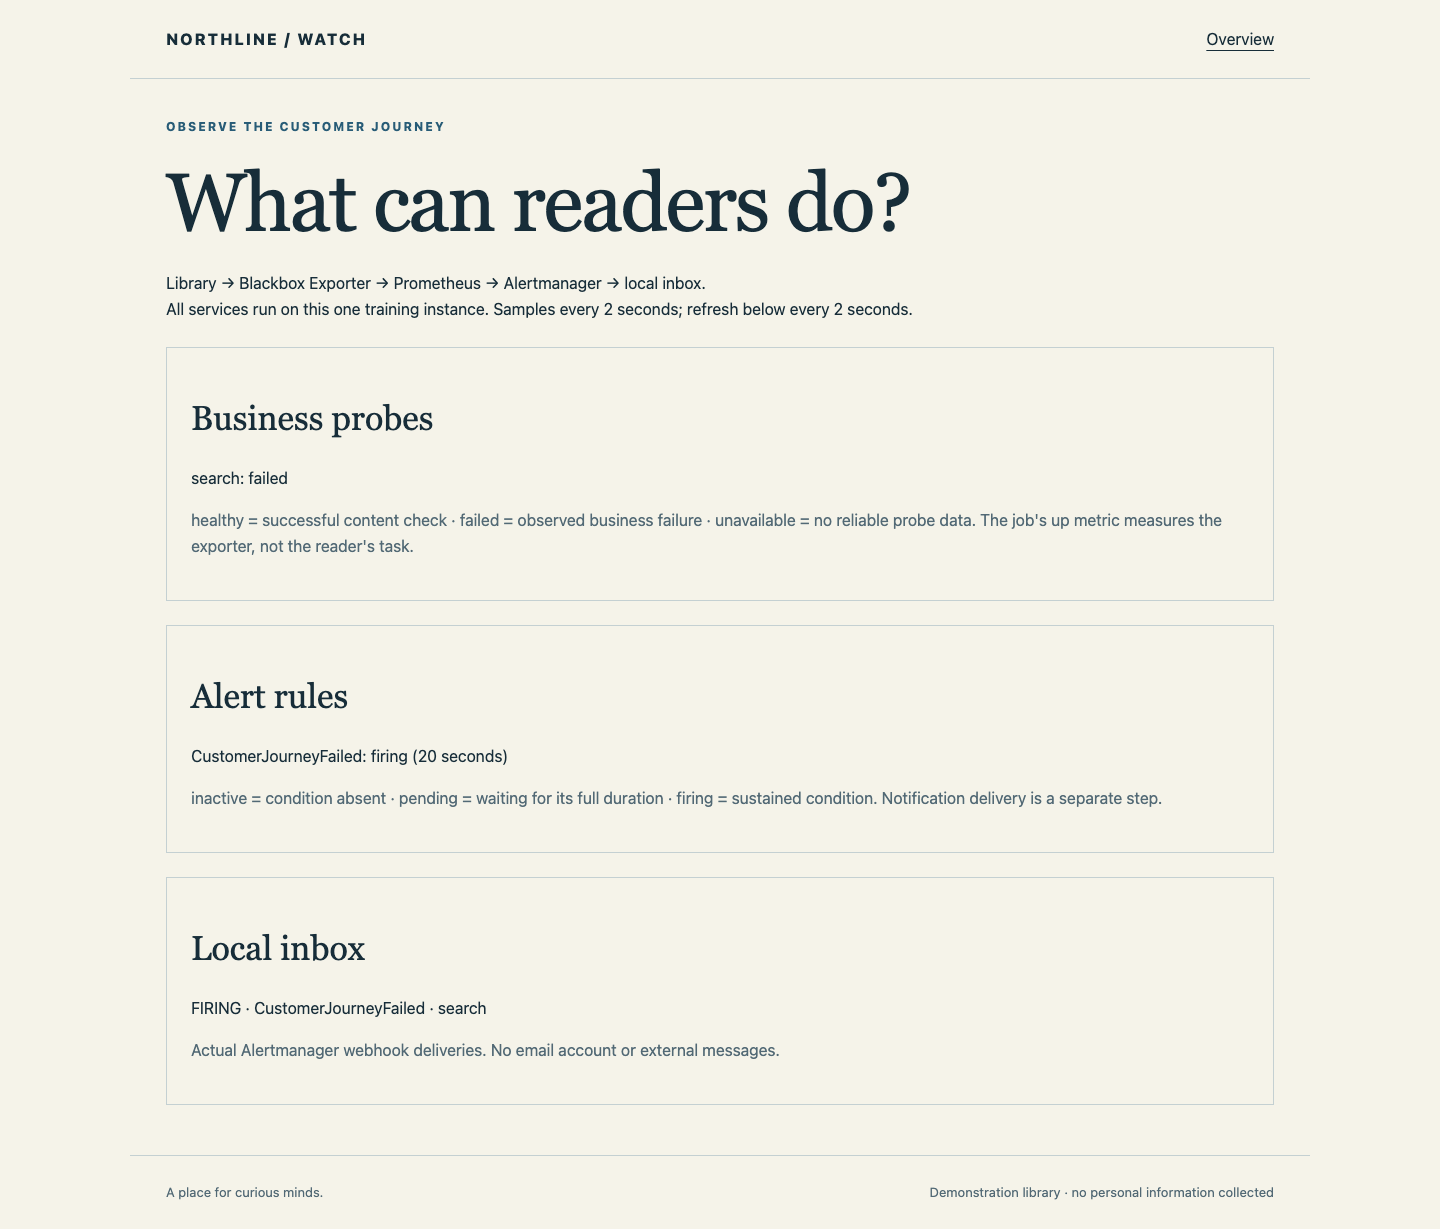
Wechsle zu Library. Kehre über den Markenlink zur Startseite zurück: Sie sieht normal aus. Suche erneut nach moon. Die Fehlermeldung beweist, dass der Leser den Katalog nicht nutzen kann. Wechsle zu Monitoring. Die Suche zeigt failed und die Regel zunächst pending. Etwa 20 Sekunden nach dem ersten fehlgeschlagenen Messwert wird sie firing; anschließend sollte FIRING · CustomerJourneyFailed · search im Posteingang erscheinen. Erlaube ab Fehlerbeginn bis zu 35 Sekunden für Erfassung, Auswertung und Zustellung. Das sind echte Beobachtungen, keine Fortschrittsanimation.
Ist der Posteingang nach 35 Sekunden noch leer, wechsle zu Workstation und verwende den nur lesenden Statusbefehl:
bash watch.sh status
Lies checks und alerts: unavailable bedeutet fehlende Erfassung; pending, dass die Dauer noch nicht erreicht ist; firing ohne Posteingangsereignis deutet auf die Zustellung. Lies die Konfiguration erneut und lade neu, falls du sie korrigierst. Ein abgelaufener 60-Sekunden-Fehler kann wiederholt werden. Erzeuge keine gefälschten Meldungen und stoppe das Monitoring nicht.
Wiederherstellen und Entwarnung bestätigen
Wechsle zu Workstation. Null Sekunden stellt die Suche sofort wieder her, auch vor dem automatischen Ablauf:
bash watch.sh fault search seconds 0
Wechsle zu Library und suche von der Startseite erneut nach moon. Moon Atlas und Available müssen wieder erscheinen. Öffne Buch und Reservierungsvorschau erneut; Visit muss ebenfalls benutzbar bleiben.
Wechsle zu Monitoring. Innerhalb etwa 10 Sekunden wird die Suche healthy, der Alarm inactive und der Posteingang ergänzt RESOLVED · CustomerJourneyFailed · search. Die ursprüngliche firing-Meldung bleibt sichtbar. resolved bedeutet, dass dieser Fehler behoben ist, nicht dass die Bibliothek nie wieder ausfällt.
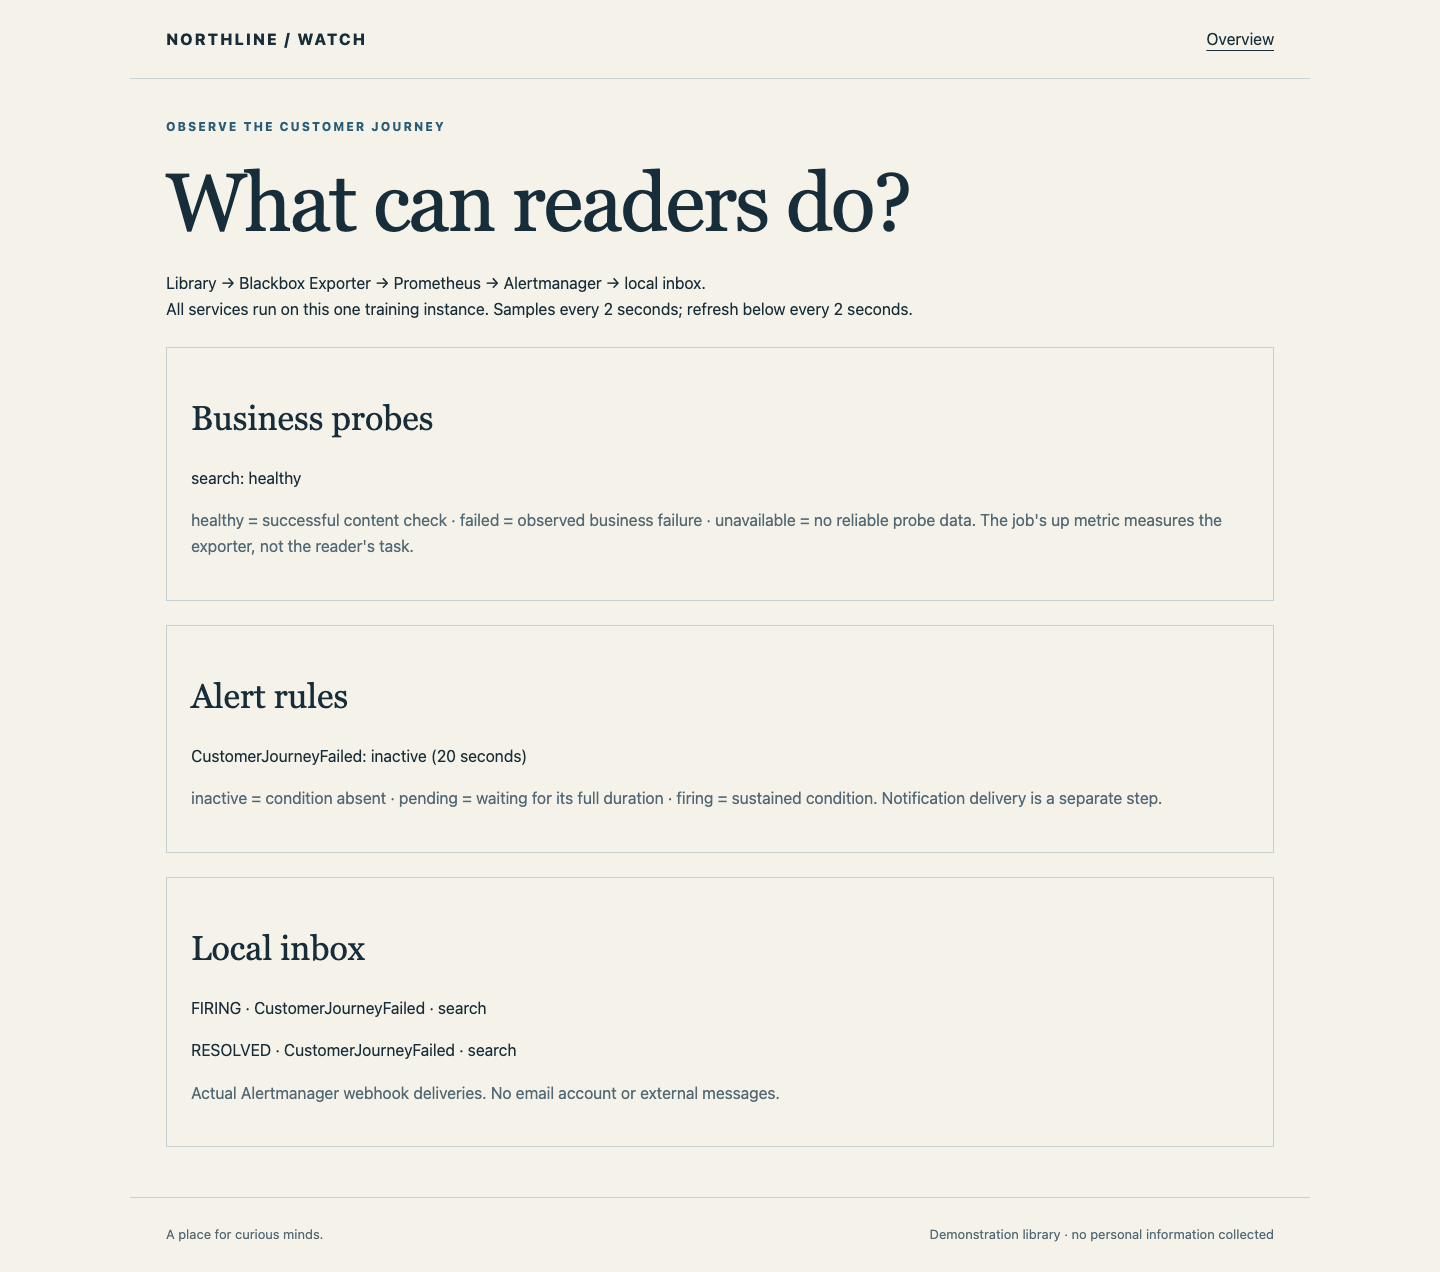
Der Schritt prüft das tatsächlich zugestellte firing/resolved-Paar und die aktuell nutzbare Bibliothek. Außerdem prüft er deine geladene Regel mit isolierten Messwerten für Gesundheit, kurze und anhaltende Fehler, Erholung, fehlende Daten und fremde Fehler. Die Bewertung injiziert keine Fehler, stellt nichts wieder her und ändert keine Konfiguration. Lass die Bibliothek gesund und die Regel für künftige Ausfälle bereit.
Zusammenfassung
Du hast eine echte Kundensuche und eine Inhaltsprüfung ausgewählt, den Alarm mit Labels eingegrenzt, einen kurzen Fehler ignoriert und echte Ausfall- und Entwarnungswebhooks empfangen. Du unterscheidest einen funktionierenden Exporter von einem nutzbaren Dienst und fehlende Daten von Erfolg. Die eigenständige Challenge überträgt diese Methoden auf Reservierungen und schließt einen fremden fehlerhaften Dienst aus.