Einführung
Bei einem Kurzfilm wurde der zweisekündige Titel am Anfang entfernt, doch die Untertitel verwenden noch die ursprüngliche Zeitleiste. Die erste grüne Szene beginnt jetzt bei 2 Sekunden, ihr Untertitel aber noch bei 4 Sekunden. Die sichtbaren Szenenkarten zeigen die Zeiten; du musst sie nicht durch Hören erraten.
Du stellst Untertitelzeiten als ganzzahlige Millisekunden dar und implementierst eine Rust-Umwandlung, die jeden Block verschiebt und dabei vollständigen Unicode- und mehrzeiligen Text erhält. Anschließend lädst du die tatsächlich exportierte Datei als Untertitelspur eines Videos im Browser. Das nächste Lab behandelt die geschützte Ausgabegrenze und die Wiederherstellung nach gewöhnlichen Fehlern. Filme und Untertitel sind eigens erstellte synthetische Kursdaten und keine Aufnahmen realer Ereignisse.
Du solltest Rust-Structs, Enums, Vektoren, Result, Strings, Dateioperationen sowie einfache Tests und Schleifen bereits verstehen. Der bestehende Rust-CLI-Kurs ist hilfreich, aber optional; dieses Lab stellt die Argumentverarbeitung bereit und setzt keine clap-Kenntnisse voraus. Der Autor schätzt 45 Minuten einschließlich Lesen und gewöhnlicher Korrekturen; das ist keine mit Anfängern gemessene Bearbeitungszeit.
Synchronisierung ansehen und Millisekunden modellieren
In diesem Schritt siehst du dir ein funktionierendes Untertitelbeispiel an, untersuchst dessen Beziehung zur ursprünglichen Zeitleiste und implementierst die numerische Zeitumrechnung.
Öffne den Tab Preview. Der vorbereitete Player wählt zunächst data/edited.webm und data/reference.vtt aus. Die Referenz ist ein bereits funktionierendes Beispiel, nicht deine abzugebende Ausgabe. Klicke auf Load actual files und anschließend beim Video auf Play. Du solltest eine grüne Szenenkarte und den zweizeiligen Untertitel sehen, der mit Café 林地 🌿 beginnt. Pausiere das Video. Gib unter Time (seconds) 2.5 ein und klicke auf Go to time, um diese Szene direkt zu prüfen. Dieses Steuerelement springt im echten Video; der Untertitel wird von dessen tatsächlicher Untertitelspur angezeigt.
Im geschnittenen Film wurde ein 2000-ms-Titel entfernt. Der erste ursprüngliche Block liegt bei 4000–7000 ms; der angepasste Block muss bei 2000–5000 ms liegen. -2000 auf beide Zeitgrenzen anzuwenden verschiebt ihn nach vorn, ohne seine Dauer zu verändern. Positive Verschiebungen lassen Untertitel später erscheinen. Die blaue Szene bei 4.5 Sekunden zeigt später eine beabsichtigte Überlappung, und die bernsteinfarbene Szene bei 60.5 Sekunden prüft einen Minutenübergang. Diese Beobachtungspunkte sind öffentlich angegeben; es gibt kein Hörrätsel.
Wechsle zu Terminal. Das Projekt liegt unter /home/labex/project/subtitle-sync. Die vorbereitete Umgebung enthält Rust 1.99.1. Ergänze das Cargo-Verzeichnis im Befehlssuchpfad dieser Shell und wähle für diese Sitzung eine verfügbare UTF-8-Locale:
export PATH=/home/labex/.cargo/bin:$PATH
export LANG=C.UTF-8 LC_ALL=C.UTF-8
$PATH behält die vorhandenen Suchverzeichnisse bei. Diese Exporte gelten für die aktuelle Terminalsitzung und bearbeiten keine Shell-Startdateien; wiederhole sie in jedem neuen Terminal. Die Schriftanzeige des Terminals kann für manche Unicode-Zeichen weiterhin Platzhalter darstellen. Verlässliche Textprüfungen sind hier die gespeicherten Bytes und die echten Browseruntertitel.
Wechsle ins Projekt. Alle weiteren Befehle verwenden dieses Verzeichnis; wiederhole den Befehl, wenn du deine Position nicht mehr kennst:
cd /home/labex/project/subtitle-sync
Das vorbereitete Projekt trennt die Aufgaben. src/cues.rs definiert Cue, prüft unser kontrolliertes WebVTT-Format, extrahiert numerische Zeitfelder und formatiert die Ausgabe. src/main.rs verarbeitet Befehle und zeigt Erfolg oder behandelbare Fehler an. src/export.rs liest die tatsächlich angeforderte Eingabe und erstellt nach der vollständigen Umwandlung eine neue Ausgabe. Diese Dateigrenze vermittelt das nächste Lab. Du bearbeitest ausschließlich src/time.rs und behältst die Namen und Signaturen der öffentlichen Funktionen bei. Lass alle anderen Quelldateien, Cargo.toml, rust-toolchain.toml und sämtliche Originaldateien unter data/ unverändert. Gleichwertige interne Implementierungen sind erlaubt. Unveränderte vorbereitete Dateien behalten Bytes, Berechtigungen, Eigentümer/Gruppe und Änderungszeit; gewöhnliches Lesen kann die Zugriffszeit aktualisieren, die nicht zu dieser Anforderung gehört.
Ein Block hat eine Startzeit, eine Endzeit und eine oder mehrere Textzeilen. Sein Diagnosefeld line vermerkt die Position der ursprünglichen Zeitzeile; es ist kein Teil des Untertiteltexts. Der bereitgestellte Struct lautet:
pub struct Cue {
    pub start: i64,
    pub end: i64,
    pub text: String,
    pub line: usize,
}
i64 ist eine vorzeichenbehaftete 64-Bit-Ganzzahl. Wir speichern ganze Millisekunden, sodass ein Minutenübergang Ganzzahlarithmetik statt Änderungen an Satzzeichen eines Zeitstempels erfordert. Start und Ende sind nicht negativ, das Ende liegt nach dem Start, und der Parser prüft diese Beziehungen. String besitzt den vollständigen Text; seine Unicode-Zeichen belegen nicht alle jeweils nur ein Byte.
Prüfe die echten ursprünglichen Untertitel mit cat, das eine Datei liest, ohne sie zu verändern:
cat data/original.vtt
WEBVTT

00:00:04.000 --> 00:00:07.000
Café 林地 🌿
Second line intact

00:00:06.000 --> 00:00:09.000
Overlap stays

00:01:01.750 --> 00:01:04.250
Across a minute
Dieser Kurs unterstützt bewusst eine kleine WebVTT-Teilmenge mit reinem Text:
- Die erste Zeile lautet exakt
WEBVTT, gefolgt von einer leeren Zeile. Header-Metadaten und eine Byte-Order-Mark werden in diesem Kurs nicht unterstützt. - Jede Zeitzeile hat das Format
HH:MM:SS.mmm --> HH:MM:SS.mmmmit genau einem Leerzeichen auf jeder Seite des Pfeils. Alle Ziffern sind ASCII-Ziffern. Stunden haben mindestens zwei Dezimalziffern, Minuten und Sekunden genau zwei im Bereich 00–59 und Millisekunden genau drei. Jeder vollständige Zeitstempel muss in einen nicht negativen i64-Millisekundenwert passen. - Die Startzeiten dürfen in Dateireihenfolge nicht abnehmen; gleiche Starts und überlappende Intervalle sind gültig. Das Ende muss größer als der Start sein. Das Programm erhält die Dateireihenfolge.
- Jeder Block besitzt mindestens eine nicht leere logische Textzeile. Unicode, Tabulatoren, führende/nachgestellte Leerzeichen und mehrere Textzeilen bleiben erhalten. Selbst ausschließlich aus Leerzeichen oder Tabulatoren bestehender Inhalt ist erlaubt, auch wenn er leer aussehen kann. Eine wirklich leere Zeile beendet einen Block; sie kann keine interne leere Inhaltszeile darstellen. Text nach dieser Grenze muss einen weiteren gültigen Block beginnen und darf keine verwaiste Fortsetzung sein.
- Die Eingabe erlaubt LF- und CRLF-Zeilenenden, einen optionalen abschließenden Zeilenumbruch und mehrere leere Blocktrenner. Das vorbereitete Ausgabeformat verwendet LF, zwei Stundenziffern für 0–99 Stunden (darüber nur die zusätzlich erforderlichen Ziffern), eine leere Zeile nach dem Header und eine nach jedem Block einschließlich des letzten. Es vereinheitlicht die Schreibweise der Zeitstempel und die Anzahl der Trenner; der logische Inhaltstext bleibt unverändert. Einzelne Wagenrückläufe werden nicht unterstützt.
- Block-IDs, Einstellungen, NOTE, STYLE, REGION, Markup, Zeichenreferenzen und die Inhaltszeichen
<,>oder&werden nicht unterstützt. Andere Steuerzeichen einschließlich NUL sind ebenfalls nicht unterstützt; nur Tabulatoren sind ausgenommen. Nicht unterstützter Inhalt wird abgelehnt, statt stillschweigend entfernt zu werden.
Diese Einschränkungen beschreiben das Kursformat und nicht den gesamten WebVTT-Standard. Der vorbereitete Parser setzt Struktur- und Textregeln um. Er erledigt nicht deine noch fehlende Millisekundenumrechnung. Seine Hilfsfunktion time_fields prüft Zeitstempelschreibweise und Feldbereiche und liefert [hours, minutes, seconds, milliseconds] als vier nicht negative i64-Werte zurück. Deine Funktion milliseconds erhält diese geprüften Felder, keine beliebigen negativen Zahlen oder Minuten außerhalb des Bereichs. Beim Zusammensetzen muss sie dennoch Überläufe ablehnen.
Die erste Implementierung rechnet jedes Feld mit dem Maßstab seiner Einheit um. Das Array scales enthält Millisekunden pro Stunde, Minute, Sekunde und Millisekunde. Der Bereich 0..4 umfasst 0 bis 3; entsprechende Arraypositionen ordnen jedem Feld seinen Maßstab zu. Unterstriche machen große Zahlenliterale leichter lesbar. 0_i64 legt den Typ des Akkumulators ausdrücklich fest.
checked_mul und checked_add liefern Some(value), wenn das Ergebnis darstellbar ist, andernfalls bei Ganzzahlüberlauf None. ok_or macht aus diesem Option-Wert einen Result-Wert mit einer Fehlermeldung in einem String, der den Text besitzt. ? setzt mit dem Erfolgswert fort oder gibt den Fehler sofort zurück. Überlauf ist eine gewöhnlich abgelehnte Eingabe und führt weder zu einem Panic noch zu einem durch Überlauf umgesprungenen Zeitwert.
Sage vor dem Programmieren die Summe für 00:01:01.750 voraus: Wie viel trägt jedes nicht nullwertige Feld bei? Notiere die erwartete Ganzzahl und prüfe deine Vorhersage dann mit dem folgenden Lauf.
Lies zuerst den tatsächlichen Starter:
cat src/time.rs
use crate::Cue importiert den vorbereiteten Typ aus dieser Bibliothek. Erhalte diesen Import. Es gibt drei Funktionen; bearbeite jetzt nur milliseconds. Ihre öffnende { steht auf der Signaturzeile und die passende schließende } unmittelbar vor shift_one. Die beiden Verschiebefunktionen müssen in dieser Phase ihre unfertigen Rümpfe behalten.
Erstelle vor dem Bearbeiten einen Sicherungsstand nur der erlaubten Quelldatei. mktemp -d erstellt durch Ersetzen der sechs X-Zeichen ein eindeutiges Verzeichnis; ein vorhandener Name wird abgelehnt. $() übernimmt diesen Pfad in eine Variable für diese Shell-Sitzung. Anführungszeichen halten den Pfad zusammen, und && kopiert erst nach erfolgreicher Verzeichniserstellung. cp -p kopiert die Datei unter Erhaltung ihrer Berechtigungen und Änderungszeit. Dies ist ein Quelltext-Sicherungsstand, keine Sicherung einer Untertitelausgabe. Gib die Variable aus und bewahre den tatsächlichen Namen auf; rate das Suffix nicht.
rs01_before_milliseconds=$(mktemp -d .edit-before-milliseconds.XXXXXX) && cp -p src/time.rs "$rs01_before_milliseconds/time.rs"
printf '%s\n' "$rs01_before_milliseconds"
printf gibt diesen Verzeichnisnamen mit anschließendem Zeilenumbruch aus. Öffne den vorhandenen Quelltext mit nano; -c zeigt die Cursorposition:
nano -c src/time.rs
Drücke Ctrl+W, tippe pub fn milliseconds und drücke zum Suchen Enter. Pfeiltasten bewegen dich in der Datei. Entferne in dieser Signatur den führenden Unterstrich von _parts, damit der Rumpf parts verwenden kann; erhalte [i64; 4] und den Rückgabetyp unverändert. Ersetze nur die Zeile Err(...) dieser Funktion innerhalb ihrer vorhandenen Klammern durch deine Umrechnungslogik. Entferne die nächste Funktion nicht.
Erstelle die vier Maßstäbe in derselben Reihenfolge wie die validierten Felder. Beginne eine veränderbare i64-Summe bei null. Multipliziere für jeden Index in 0..4 das Feld überlaufgeprüft mit seinem Maßstab und addiere diesen Beitrag dann überlaufgeprüft zur Summe. Wandle beide möglichen Überläufe mit ok_or(String::from("time integer overflow"))? in einen Fehler um. Zum Beispiel berechnet der erste Schleifenteil einen einzelnen Beitrag:
let piece = parts[i]
    .checked_mul(scales[i])
    .ok_or(String::from("time integer overflow"))?;
Verwende let scales = [3_600_000, 60_000, 1_000, 1]; und let mut total = 0_i64; vor dieser Schleife. Die Addition folgt demselben geprüften Muster mit total.checked_add(piece). Gib nach der Schleife Ok(total) als letzten Ausdruck ohne Semikolon zurück. Lasse beide übrigen Platzhalter unverändert.
Drücke Ctrl+O zum Schreiben, Enter zum Bestätigen des vorhandenen Dateinamens und dann Ctrl+X zum Beenden. Fragt nano beim Beenden nach dem Speichern, antworte Y und bestätige dann den Dateinamen. Lies vor dem Ausführen nach, was du gespeichert hast:
cat src/time.rs
Führe eine einzelne Umrechnung aus. cargo run kompiliert und startet das vorbereitete Programm, --quiet unterdrückt Cargo-Fortschrittsmeldungen und -- übergibt die folgenden Argumente an das Programm. Dessen Befehl time verwendet deine Umrechnung:
cargo run --quiet -- time 00:01:01.750
00:01:01.750 = 61750 ms
Sechzig Sekunden plus eine Sekunde plus 750 Millisekunden ergeben 61750. Prüfe jetzt sämtliche ursprünglichen Blockwerte; inspect liest die tatsächlich genannte Datei und ruft den Parser auf:
cargo run --quiet -- inspect data/original.vtt
Cue 1: 4000 --> 7000 ms
Café 林地 🌿
Second line intact
Cue 2: 6000 --> 9000 ms
Overlap stays
Cue 3: 61750 --> 64250 ms
Across a minute
Alle drei Datensätze und beide Textzeilen des ersten Blocks bleiben erhalten. Vergleiche die Umrechnung mit deiner Vorhersage.
Wenn du eine versehentliche Änderung noch nicht gespeichert hast, drücke Ctrl+X und dann N bei der Speicherfrage, um die Datei unverändert zu lassen. Lies bei einem gespeicherten Fehler Cargos genannten Dateinamen und die Zeile, öffne diesen Quelltext erneut und korrigiere den lokalen Ausdruck. Alternativ stelle deinen eigenen Sicherungsstand wieder her. Der Sicherungsstand milliseconds enthält den Zustand vor dieser Phase; nach dem Wiederherstellen musst du diese Phase und alle späteren Funktionen erneut implementieren.
Wenn du ein neues Terminal geöffnet hast, werden seine Variablen und sein Arbeitsverzeichnis nicht übernommen. Wiederhole zuerst die sichtbaren Umgebungs- und Verzeichnisbefehle:
export PATH=/home/labex/.cargo/bin:$PATH
export LANG=C.UTF-8 LC_ALL=C.UTF-8
cd /home/labex/project/subtitle-sync
Die folgenden Wiederherstellungsbefehle sind bedingt: Verwende sie nur, wenn du einen gespeicherten Fehler rückgängig machst. ls -d listet die Verzeichnisnamen selbst auf; * passt auf ihre erzeugten Suffixe. Existiert kein Sicherungsstand, lies diesen Fehler und repariere den Quelltext, statt einen Pfad zu erfinden.
ls -d .edit-before-milliseconds.*
read wartet auf eine Zeile und speichert sie in einer Sitzungsvariable. Führe es aus, tippe oder füge dann einen tatsächlichen vollständigen oben ausgegebenen Verzeichnisnamen ein und drücke Enter. Tippe weder ein Beispielsuffix noch das Dollarzeichen:
read rs01_restore
Prüfe vor dem Wiederherstellen, dass die Datei den erwarteten früheren Quelltext enthält:
cat "$rs01_restore/time.rs"
cp -p "$rs01_restore/time.rs" src/time.rs
Öffne danach nano erneut, ergänze die fehlende Implementierung und wiederhole den fehlgeschlagenen Befehl. Führe das Setup nicht erneut aus und ändere keine geschützten Eingabedateien. Eine Codekorrektur ersetzt weder eine vorhandene Ausgabe-VTT noch die bereits in einen Browser-Blob geladene Datei; bewahre das alte Ergebnis vor dem Neuerzeugen seines geforderten Pfads und wähle dann diese tatsächliche Ausgabe aus und klicke erneut auf Load actual files.
Die gesamte Untertitelsammlung verschieben
In diesem Schritt verschiebst du einen typisierten Block, wendest die Operation auf jeden Block an und siehst dir die tatsächlich gespeicherte Ausgabe an. Arbeite in Terminal unter /home/labex/project/subtitle-sync weiter.
shift_one leiht mit &Cue einen vom Parser geprüften Block aus; die Funktion muss einen neuen Block zurückgeben, ohne das Original zu ändern. Addiere den vorzeichenbehafteten Versatz mit checked_add unabhängig zu beiden Zeitgrenzen und lehne danach negative Ergebnisse ab. Wandle negative Werte nicht in vorzeichenlose Ganzzahlen um, bilde keinen Absolutwert und begrenze sie nicht auf null. Solche Abkürzungen ändern die geforderten Zeiten.
Der zurückgegebene Struct behält die neuen Zeiten, klont den vollständigen Text, der dem ursprünglichen Block gehört, und kopiert die Diagnosezeile. .clone() erhält den gesamten String einschließlich Unicode und jeder Textzeile. Die verkürzten Struct-Felder start, end übernehmen gleichnamige Variablen. || bedeutet, dass bereits eine negative Zeitgrenze zur Ablehnung ausreicht.
Erstelle vor dem Bearbeiten einen Sicherungsstand nur der erlaubten Quelldatei. mktemp -d erstellt durch Ersetzen der sechs X-Zeichen ein eindeutiges Verzeichnis; ein vorhandener Name wird abgelehnt. $() übernimmt diesen Pfad in eine Variable für diese Shell-Sitzung. Anführungszeichen halten den Pfad zusammen, und && kopiert erst nach erfolgreicher Verzeichniserstellung. cp -p kopiert die Datei unter Erhaltung ihrer Berechtigungen und Änderungszeit. Dies ist ein Quelltext-Sicherungsstand, keine Sicherung einer Untertitelausgabe. Gib die Variable aus und bewahre den tatsächlichen Namen auf; rate das Suffix nicht.
rs01_before_one_cue=$(mktemp -d .edit-before-one-cue.XXXXXX) && cp -p src/time.rs "$rs01_before_one_cue/time.rs"
printf '%s\n' "$rs01_before_one_cue"
printf gibt diesen Verzeichnisnamen mit anschließendem Zeilenumbruch aus. Öffne den vorhandenen Quelltext mit nano; -c zeigt die Cursorposition:
nano -c src/time.rs
Suche mit Ctrl+W nach pub fn shift_one, dann Enter. Ihr Rumpf endet an der schließenden } auf oberster Ebene unmittelbar vor pub fn shift_all, nicht an einer inneren if-Klammer. Erhalte milliseconds unverändert. Entferne die führenden Unterstriche von _cue und _delta und behalte Typen und Rückgabesignatur bei. Implementiere jetzt nur diese eine Funktion; lasse shift_all unfertig.
Verwende einen lokalen Wert start aus cue.start.checked_add(delta) und einen Wert end aus der entsprechenden Operation mit cue.end. Gib jedem Überlauf einen eigenen String-Fehler über ok_or(...)?. Prüfe beide neuen Werte mit if start < 0 || end < 0; gib aus diesem Zweig einen Fehler zurück. Erzeuge andernfalls Ok(Cue { start, end, text: cue.text.clone(), line: cue.line }). Dies erhält den ursprünglichen Block und gibt seine verschobene Kopie zurück. Speichere mit Ctrl+O, Enter und beende mit Ctrl+X.
Sage vor dem Ausführen das Ergebnis für den vorbereiteten einzelnen Block voraus: 4000–7000 ms, -2000, Text A green scene:
cargo run --quiet -- cue -2000
2000 --> 5000 ms | A green scene
Dies weist einen Block nach, nicht den ganzen Film. Der folgende absichtliche Versuch liefert weiterhin einen Status ungleich null, weil shift_all unfertig ist. Er darf weder die erfolgreiche Erstellung melden noch die genannte Datei erzeugen:
cargo run --quiet -- shift data/original.vtt output/unfinished-collection.vtt -2000
ls listet einen angegebenen Pfad auf. Hier sollte auch dieser Befehl einen Status ungleich null liefern, weil keine Teilausgabe existieren darf:
ls output/unfinished-collection.vtt
Erstelle nun die Sammlungsoperation, ohne eine der fertigen Funktionen zu ersetzen. Ein ausgeliehener Slice &[Cue] stellt die Eingabedatensätze bereit; Vec<Cue> besitzt das neue Ergebnis. Vec::new erzeugt einen leeren Vektor und push hängt einen vollständigen Block an. iter().enumerate() besucht jeden ausgeliehenen Block mit einem bei null beginnenden Index. map_err wandelt eine Fehlermeldung um; seine Closure |error| ... erhält den bisherigen Fehler, und format! erstellt einen String mit der bei eins beginnenden Blockposition und ursprünglichen Diagnosezeile.
Erstelle vor dem Bearbeiten einen Sicherungsstand nur der erlaubten Quelldatei. mktemp -d erstellt durch Ersetzen der sechs X-Zeichen ein eindeutiges Verzeichnis; ein vorhandener Name wird abgelehnt. $() übernimmt diesen Pfad in eine Variable für diese Shell-Sitzung. Anführungszeichen halten den Pfad zusammen, und && kopiert erst nach erfolgreicher Verzeichniserstellung. cp -p kopiert die Datei unter Erhaltung ihrer Berechtigungen und Änderungszeit. Dies ist ein Quelltext-Sicherungsstand, keine Sicherung einer Untertitelausgabe. Gib die Variable aus und bewahre den tatsächlichen Namen auf; rate das Suffix nicht.
rs01_before_all_cues=$(mktemp -d .edit-before-all-cues.XXXXXX) && cp -p src/time.rs "$rs01_before_all_cues/time.rs"
printf '%s\n' "$rs01_before_all_cues"
printf gibt diesen Verzeichnisnamen mit anschließendem Zeilenumbruch aus. Öffne den vorhandenen Quelltext mit nano; -c zeigt die Cursorposition:
nano -c src/time.rs
Suche nach pub fn shift_all. Dies ist die letzte Funktion der Datei; ihr Rumpf endet an der letzten passenden } auf oberster Ebene. Innere for- und if-Blöcke haben eigene schließende Klammern; verwechsle diese nicht mit der Funktionsgrenze. Entferne die Unterstriche von _cues und _delta. Ersetze nur ihren unfertigen Rumpf Err(...). Beginne mit let mut shifted = Vec::new();, durchlaufe for (index, cue) in cues.iter().enumerate() und rufe die gerade vervollständigte Funktion auf. Ergänze Fehlerkontext:
let next = shift_one(cue, delta)
    .map_err(|error| format!("cue {} at line {}: {error}", index + 1, cue.line))?;
Hänge next innerhalb der Schleife mit shifted.push(next); an. Gib nach der Schleife Ok(shifted) zurück. Das ? muss einen Fehler zurückgeben, statt einen schlechten Block zu überspringen oder ein erfolgreiches Präfix zu behalten. Speichere, bestätige den Dateinamen und beende nano. Deine bisherigen Implementierungen von milliseconds und shift_one bleiben bestehen.
cat src/time.rs
Wiederhole den Einzelblock-Regressionstest mit dem nun vollständigen Modul:
cargo run --quiet -- cue -2000
Verwende nun den Befehl shift mit dem tatsächlichen Eingabepfad, einem neuen Ausgabepfad und dem vorzeichenbehafteten Millisekundenversatz:
cargo run --quiet -- shift data/original.vtt output/aligned.vtt -2000
Created output/aligned.vtt with 3 cues (offset -2000 ms)
Die vorbereitete Dateigrenze liest, parst und verschiebt die gesamte Sammlung, bevor sie eine neue Datei erstellt. Beobachte ihre Ablehnung, indem du denselben Befehl absichtlich wiederholst. Der folgende Befehl muss einen Status ungleich null zurückgeben und die bestehende Ausgabe nennen:
cargo run --quiet -- shift data/original.vtt output/aligned.vtt -2000
Eine vorhandene Datei kann ein korrektes früheres Ergebnis oder ein falsches Ergebnis einer älteren Codeänderung sein. Eine Codekorrektur schreibt sie nicht neu. Bewahre diese Arbeit auf, bevor du den geforderten Ausgabepfad erneut versuchst. Der folgende Befehl erstellt ein neues Sicherungsverzeichnis und verschiebt die vorhandene Datei hinein:
mktemp -d erzeugt ein neues Verzeichnis und ersetzt die sechs X-Zeichen durch ein eindeutiges Suffix; ein vorhandenes Sicherungsverzeichnis wird nicht wiederverwendet. $() übernimmt den ausgegebenen Pfad in die Sitzungsvariable rs01_backup_dir. Die Anführungszeichen um die Variable halten den Pfad zusammen. && führt mv nur nach erfolgreicher Verzeichniserstellung aus; mv verschiebt die vorhandene Datei in das neue leere Verzeichnis. So wird keine ältere Sicherung überschrieben. Scheitert die Erstellung, entfällt das Verschieben und die ursprüngliche Ausgabe bleibt an ihrem Platz; lies vor dem Wiederholen den Fehler. Wenn du dich von einem früheren fehlgeschlagenen Erstversuch erholst, nutze dieselbe Sicherung, sobald eine Ausgabe vorhanden ist.
rs01_backup_dir=$(mktemp -d output/aligned-backup.XXXXXX) &&
mv output/aligned.vtt "$rs01_backup_dir/aligned.vtt"
Erzeuge nun mit dem aktuellen Code erneut den geforderten Pfad:
cargo run --quiet -- shift data/original.vtt output/aligned.vtt -2000
Dabei sollten drei Blöcke entstehen. Das alte Ergebnis bleibt im eindeutigen Sicherungsverzeichnis erhalten. Das nächste Lab erklärt und implementiert die geschützte Schreibgrenze selbst.
Prüfe die tatsächlich gespeicherte Datei:
cat output/aligned.vtt
WEBVTT

00:00:02.000 --> 00:00:05.000
Café 林地 🌿
Second line intact

00:00:04.000 --> 00:00:07.000
Overlap stays

00:00:59.750 --> 00:01:02.250
Across a minute
Die ersten beiden Blöcke überlappen sich weiterhin. Der Beginn des dritten Blocks ist von Minute 1 in die vorherige Minute gerückt, und jede vollständige Textzeile blieb erhalten. Das Programm hat die gesamte Sammlung verschoben; ein korrekter erster Block allein genügt nicht.
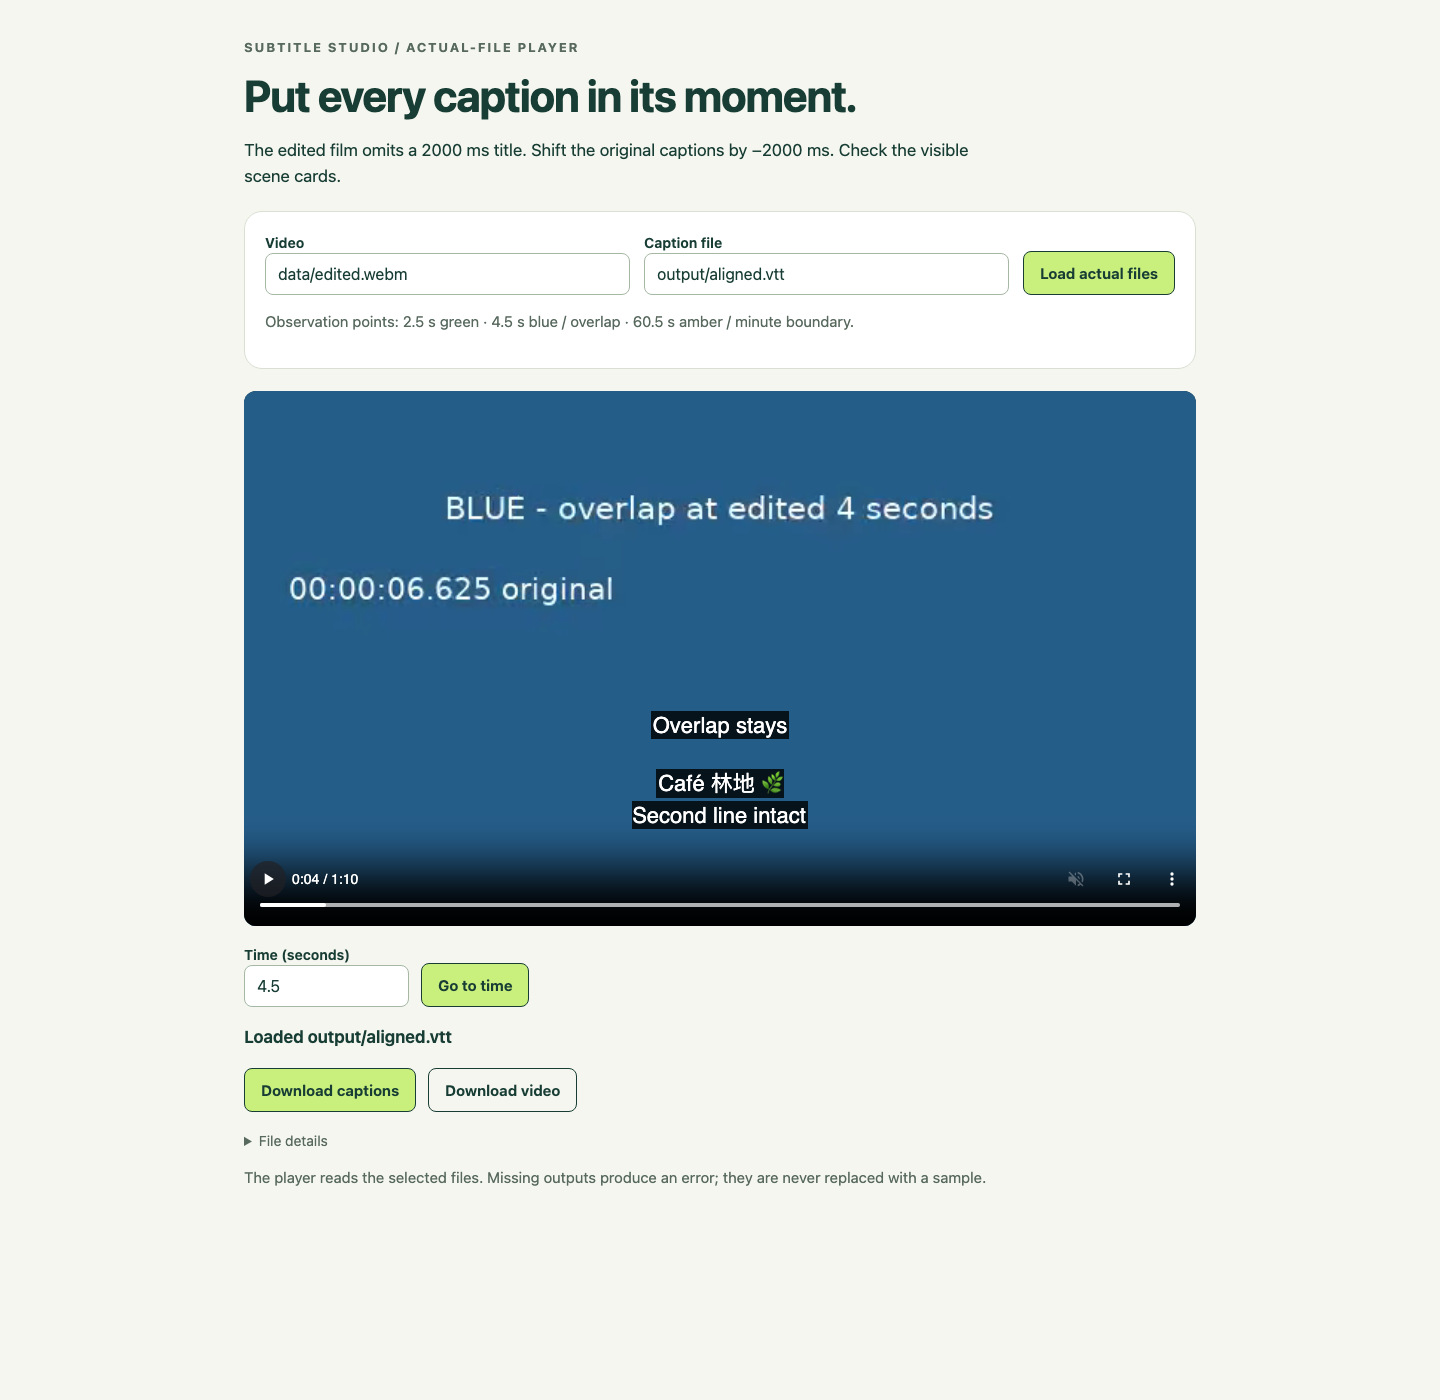
Wechsle zu Preview. Lass Video auf data/edited.webm, ändere Caption file zu output/aligned.vtt und klicke auf Load actual files. Der ausgewählte Dateiname im Ladestatus muss deine Ausgabe kennzeichnen. Die Vorschau liest die tatsächlichen Bytes dieser Datei; sie erstellt keine Untertitel neu und weicht nicht auf das Beispiel aus.
Gib unter Time (seconds) 2.5 ein und klicke auf Go to time: Die grüne Szene und der zweizeilige Unicode-Untertitel sollten zusammenpassen. Prüfe danach 4.5: Die blaue Szene sollte sowohl den ersten Block als auch Overlap stays zeigen. Bei 60.5 sollte die bernsteinfarbene Szene Across a minute zeigen. Ein Browser kann aktive Blöcke mit gleichem Start anders als die Datei anordnen; alle vollständigen Texte müssen erhalten bleiben. Klicke zur Bestätigung echter Wiedergabe auf Play und pausiere dann. Download captions speichert die geladene Ausgabedatei und Download video den geladenen Film; keine Schaltfläche verändert den Inhalt.
Das folgende Beispiel zeigt die tatsächlich gespeicherte Datei in der blauen Szene. Achte auf den vollständigen zweizeiligen Unicode-Block, den getrennten überlappenden Block und den Namen der geladenen Ausgabedatei.
Kehre zu Terminal zurück. Verwende für einen absichtlichen Pfadfehler den nicht vorhandenen Dateinamen im Singular:
cargo run --quiet -- inspect data/caption.vtt
Der Befehl muss einen Status ungleich null zurückgeben und den fehlenden Pfad nennen. Eine fehlende Datei ist etwas anderes als ein fehlerhafter Block in einer vorhandenen Datei. Korrigiere den Aufruf durch Angabe deiner tatsächlichen Ausgabe:
cargo run --quiet -- inspect output/aligned.vtt
Du solltest erneut alle drei verschobenen Blöcke mit vollständigem Text sehen. Bewahre ursprüngliche Untertitel und Video; ihre Änderung würde die Wirkung der Umwandlung verbergen.
Wenn du eine versehentliche Änderung noch nicht gespeichert hast, drücke Ctrl+X und dann N bei der Speicherfrage, um die Datei unverändert zu lassen. Lies bei einem gespeicherten Fehler Cargos genannten Dateinamen und die Zeile, öffne diesen Quelltext erneut und korrigiere den lokalen Ausdruck. Alternativ stelle deinen eigenen Sicherungsstand wieder her. Der Sicherungsstand one-cue enthält den Zustand vor dieser Phase; nach dem Wiederherstellen musst du diese Phase und alle späteren Funktionen erneut implementieren.
Wenn du ein neues Terminal geöffnet hast, werden seine Variablen und sein Arbeitsverzeichnis nicht übernommen. Wiederhole zuerst die sichtbaren Umgebungs- und Verzeichnisbefehle:
export PATH=/home/labex/.cargo/bin:$PATH
export LANG=C.UTF-8 LC_ALL=C.UTF-8
cd /home/labex/project/subtitle-sync
Die folgenden Wiederherstellungsbefehle sind bedingt: Verwende sie nur, wenn du einen gespeicherten Fehler rückgängig machst. ls -d listet die Verzeichnisnamen selbst auf; * passt auf ihre erzeugten Suffixe. Existiert kein Sicherungsstand, lies diesen Fehler und repariere den Quelltext, statt einen Pfad zu erfinden.
ls -d .edit-before-one-cue.*
read wartet auf eine Zeile und speichert sie in einer Sitzungsvariable. Führe es aus, tippe oder füge dann einen tatsächlichen vollständigen oben ausgegebenen Verzeichnisnamen ein und drücke Enter. Tippe weder ein Beispielsuffix noch das Dollarzeichen:
read rs01_restore
Prüfe vor dem Wiederherstellen, dass die Datei den erwarteten früheren Quelltext enthält:
cat "$rs01_restore/time.rs"
cp -p "$rs01_restore/time.rs" src/time.rs
Öffne danach nano erneut, ergänze die fehlende Implementierung und wiederhole den fehlgeschlagenen Befehl. Führe das Setup nicht erneut aus und ändere keine geschützten Eingabedateien. Eine Codekorrektur ersetzt weder eine vorhandene Ausgabe-VTT noch die bereits in einen Browser-Blob geladene Datei; bewahre das alte Ergebnis vor dem Neuerzeugen seines geforderten Pfads und wähle dann diese tatsächliche Ausgabe aus und klicke erneut auf Load actual files.
Der Sicherungsstand .edit-before-one-cue.* enthält nur die fertige Millisekundenumrechnung. Verwende bei einem auf die Sammlung begrenzten Fehler dasselbe Bestätigungsverfahren mit .edit-before-all-cues.*: Dieser Sicherungsstand enthält auch die fertige Einzelblockfunktion. Keiner ist eine vollständige Endimplementierung.
Optionale vollständige time.rs-Vergleichs- und Wiederherstellungsreferenz
Versuche die Funktionsänderungen und prüfe ihre Ergebnisse, bevor du diese Referenz öffnest. Sie zeigt eine vollständige Implementierung, keine vorgeschriebene Befehlsfolge. Gleichwertige Algorithmen sind im Rahmen des öffentlichen Vertrags erlaubt. Vergleiche die betroffene Funktion, statt bereits fertige Arbeit unnötig zu ersetzen.
use crate::Cue;

pub fn milliseconds(parts: [i64; 4]) -> Result<i64, String> {
    let scales = [3_600_000, 60_000, 1_000, 1];
    let mut total = 0_i64;
    for i in 0..4 {
        let piece = parts[i]
            .checked_mul(scales[i])
            .ok_or(String::from("time integer overflow"))?;
        total = total
            .checked_add(piece)
            .ok_or(String::from("time integer overflow"))?;
    }
    Ok(total)
}

pub fn shift_one(cue: &Cue, delta: i64) -> Result<Cue, String> {
    let start = cue.start
        .checked_add(delta)
        .ok_or(String::from("start integer overflow"))?;
    let end = cue.end
        .checked_add(delta)
        .ok_or(String::from("end integer overflow"))?;
    if start < 0 || end < 0 {
        return Err(String::from("shift would produce negative time"));
    }
    Ok(Cue { start, end, text: cue.text.clone(), line: cue.line })
}

pub fn shift_all(cues: &[Cue], delta: i64) -> Result<Vec<Cue>, String> {
    let mut shifted = Vec::new();
    for (index, cue) in cues.iter().enumerate() {
        let next = shift_one(cue, delta)
            .map_err(|error| format!("cue {} at line {}: {error}", index + 1, cue.line))?;
        shifted.push(next);
    }
    Ok(shifted)
}
Zusammenfassung
Du hast geprüfte Zeitfelder in ganzzahlige Millisekunden mit Überlaufprüfung umgerechnet, einen einzelnen Block und eine gesamte Sammlung verschoben sowie Text, Reihenfolge, Dauer und gültige Überlappung erhalten. Anschließend hast du die tatsächliche neue Datei als Video-Untertitelspur geladen, die angegebenen visuellen Ausrichtungspunkte geprüft und einen falschen Eingabepfad korrigiert. Das nächste Lab vermittelt die Dateigrenze, die ungültige Eingaben und bestehende Ausgabepfade ablehnt, bevor sie eine Ergebnisdatei ändert.