Einführung
Beim Vergleich der zugewiesenen Personen der Werkstatt hat Seite B die höhere Anmelderate. Kann allein die zufällige Zuweisung scheinbar unterschiedliche Gruppen erzeugen, auch wenn die Seite das Ergebnis keiner Person verändert? Ein kleiner manueller Tausch macht die Frage anschaulich, bevor du eine Verteilung tatsächlich zufälliger Differenzen erzeugst.
Diese unabhängige Umgebung enthält bereits die zuvor gelehrten korrekten Funktionen für Personenergebnisse und Ratenvergleiche sowie eigene Originaldaten. Du solltest diese Ideen, Python-Funktionen, einfache NumPy-Arrays und Matplotlib-Grundlagen kennen. Dateien aus einer früheren VM und Kenntnisse statistischer Inferenz sind nicht erforderlich. Du speicherst 399 explorative Neuzuweisungen und deren tatsächliches Diagramm; hier berechnest du keinen p-Wert und wählst keinen Gewinner. Alle Datensätze sind eigens erstellte synthetische Lehrbeispiele. Die 55 Minuten sind eine Schätzung des Autors einschließlich Lesen und gewöhnlicher Fehlerkorrekturen.
Tausche Personen bei gleichen Gruppengrößen
In diesem Schritt berechnest du eine Differenz für sechs Personen, tauschst zwei Gruppenzugehörigkeiten und siehst, warum sich der Vergleich ändern kann.
Öffne in WebIDE Terminal → New Terminal und wechsle in das Verzeichnis dieser Einheit:
cd /home/labex/project/signup-experiment
cat liest Dateien, ohne sie zu verändern. Lies die Übungskarten und die beiden vorbereiteten Funktionen noch einmal:
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
Die sechs Karten haben die binären Ergebnisse [1, 0, 0] in A und [1, 1, 0] in B. Jede 1 oder 0 gehört zu einer zugewiesenen Person; wiederholte Ereignisse sind keine zusätzlichen Beobachtungen. In A haben sich 1/3, in B 2/3 angemeldet; B−A beträgt etwa +33.33 Prozentpunkte.
Stelle dir vor, die zweite Person aus A (Ergebnis 0) tauscht die Gruppenzugehörigkeit mit der ersten aus B (Ergebnis 1). A wird [1, 1, 0], B wird [0, 1, 0], und die Differenz liegt nahe −33.33 Prozentpunkten. Jede Gruppe hat weiterhin drei Personen, insgesamt gibt es weiterhin drei positive Ergebnisse. Du hast die Zuweisung geändert, nicht die Personenergebnisse oder die Stichprobengröße.
Schreibe die Differenzfunktion. np.mean berechnet den Mittelwert binärer Werte in einem NumPy-Array. Ziehe den Mittelwert von A von dem von B ab und multipliziere anschließend mit 100, um Prozentpunkte zu erhalten. Die Skizze von sample_null wird später vervollständigt; eine Funktion zu definieren führt sie nicht aus.
Das Shell-Zeichen > ersetzt die Datei. Das Here-Dokument mit Anführungszeichen <<'PY' kopiert den gesamten Block bis zum letzten PY ohne Shell-Erweiterung. Du kannst denselben Inhalt auch mit File → Save in WebIDE speichern.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
Die Stufe contrast des Ausführungsprogramms übergibt die ursprünglichen Karten und genau den beschriebenen Tausch, ruft deine Funktion zweimal auf und speichert beide tatsächlichen Ergebnisse:
python3 run.py contrast
Das Anzeigeprogramm zeigt das gespeicherte Ergebnis, ohne es neu zu erstellen:
python3 show_results.py contrast
Erwarte original_pp nahe +33.33 und swapped_pp nahe −33.33. Keiner dieser Werte sagt vorher, was einer echten Person auf einer anderen Seite passieren würde. Sie zeigen, wie die Zusammensetzung der Gruppen den Vergleich verändern kann, während dieselben sechs Ergebnisse fest bleiben.
Du darfst resample.py, später plot.py, bearbeiten oder gewöhnliche Python-Hilfsdateien daneben ergänzen. Erhalte die ursprünglichen CSV-Dateien, Einstellungen, das Wörterbuch sowie Ausführungs- und Anzeigeprogramm. Bei einem falschen Verzeichnis nutze pwd und ls, dann wiederhole das obige cd. Kopiere einen vollständigen Block erneut, um einen Bearbeitungsfehler zu korrigieren; Setup weigert sich, ein bestehendes Arbeitsverzeichnis zu überschreiben.
Erzeuge tatsächliche Neuzuweisungen
In diesem Schritt mischst du die vollständigen Besucherergebnisse wiederholt in Gruppen ihrer ursprünglichen Größen und speicherst jede entstehende Differenz.
Fahre im selben WebIDE-Terminal unter /home/labex/project/signup-experiment fort. Die vollständige feste Stichprobe enthält 12 zugewiesene Personen, sechs je Gruppe. Die vorbereitete Ergebnisfunktion verwendet die vollständigen Siebentagefenster. Lies die tatsächlichen vollständigen Eingaben, wenn du die Grenzfälle und Personen ohne Ereignisse erneut finden möchtest:
cat assignments.csv
cat events.csv
Unter der hier verwendeten Nullannahme ohne Effekt verändert die Seitenzuweisung das binäre Ergebnis keiner Person. Die Neuzuweisung dieser festen Personenergebnisse zwischen beiden Gruppen zeigt daher die allein durch die Zuweisung erwartete Variation. Diese Annahme beruht auf dem randomisierten Versuchsplan, den diese synthetischen Datensätze darstellen. Das Mischen eines beliebigen beobachtenden Website-Protokolls würde daraus kein randomisiertes Experiment machen.
np.concatenate([a, b]) vereinigt die beiden Arrays. np.random.default_rng(seed) erstellt einen Pseudozufallsgenerator mit reproduzierbarem Anfangszustand. Seine Methode permutation gibt eine gemischte Kopie zurück und lässt das vereinigte Original unverändert. Der Ausschnitt shuffled[:len(a)] nimmt den ersten Teil in der Größe von A, shuffled[len(a):] den übrigen Teil in der Größe von B. Jede Person wird pro Ziehung einmal verwendet; beide Gruppengrößen bleiben erhalten. Mische nicht die wiederholten rohen Ereigniszeilen.
Ersetze die Datei durch beide vollständigen Funktionen. Die for-Schleife führt die angeforderte Anzahl von Ziehungen aus; append erhält jede berechnete Differenz. Die Rückgabe eines Arrays bewahrt die ganze Stichprobe statt nur ihres Mittelwerts oder einer günstigen Ziehung.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
Das Ausführungsprogramm ruft diese Funktionen für die vollständige Personenstichprobe auf und speichert die tatsächlichen Gruppengrößen, die beobachtete Differenz und 399 gemischte Differenzen. --seed übergibt den reproduzierbaren Anfangszustand; die beiden Bindestriche kennzeichnen eine benannte Befehlsoption.
python3 run.py sample --seed 17
python3 show_results.py sample
In den vollständigen Daten haben sich weiterhin in A 1 von 6 und in B 5 von 6 Personen angemeldet; die beobachtete Differenz liegt nahe +66.67 Prozentpunkten. null_count muss 399 sein. Für eine übersichtliche Anzeige zeigt das Anzeigeprogramm nur die ersten acht Ziehungen als null_preview; das vollständige Array steht in output/sample.json.
Erzeuge eine zweite gewöhnliche Stichprobe, um zu sehen, warum ein Seed keine maßgebliche Musterantwort ist:
python3 run.py sample --seed 42
python3 show_results.py sample
Damit ersetzt du die gespeicherte Stichprobe durch den tatsächlichen Lauf mit Seed 42. Die Folge ändert sich normalerweise, während die ursprünglichen Personenergebnisse, Gruppengrößen und der beobachtete Vergleich gleich bleiben. Derselbe Seed muss bei erneuter Ausführung dieselbe Folge erzeugen. Jeder nichtnegative reproduzierbare Seed und jede gleichwertige Implementierung unabhängiger Ziehungen sind erlaubt; eine bestimmte Autorenfolge ist nicht vorgeschrieben. Wiederhole die Ausführung nicht ständig auf der Suche nach einer Stichprobe, die eine Seite zu begünstigen scheint. Die spätere exakte Analyse verwendet alle Zuweisungen, nicht die schönste explorative Stichprobe.
Jede gemischte Statistik liegt zwischen −100 und +100 Prozentpunkten, obwohl nicht jeder Wert in diesem Intervall erreichbar ist. Für die Übung mit sechs Personen ergeben alle 20 verschiedenen Drei-gegen-drei-Zuweisungen die Häufigkeiten 1, 9, 9, 1 bei den Differenzen −100, −100/3, +100/3, +100. Die vollständige Stichprobe mit 12 Personen hat 924 Zuweisungen: Ihre Häufigkeiten sind 1, 36, 225, 400, 225, 36, 1 bei −100, −200/3, −100/3, 0, +100/3, +200/3, +100. Das nächste Lab berechnet dies exakt, statt das Auswendiglernen dieser Zahlen zu verlangen.
Für diese explorative Trainingsaufgabe darf die Stichprobenhäufigkeit jeder erreichbaren Differenz um höchstens 0.15 als absolute Anteilsdifferenz von ihrer exakten Referenzhäufigkeit abweichen. Beispielsweise unterscheiden sich 0.40 und 0.46 um 0.06. Das ist eine bewusst breite Akzeptanztoleranz für das Training, kein Konfidenzintervall, keine Signifikanzschwelle, Geschäftsgarantie oder Vorgabe zur Seed-Auswahl. Sie erlaubt gewöhnliche Stichproben und unabhängige Methoden, ohne identische Arrays zu verlangen. In einem gültigen Beispiel mit ausschließlich Nullen ist jede neu zugewiesene Differenz null; eine Streuung größer als null ist nicht erforderlich.
Der Funktionsvertrag gilt für die übergebenen binären Arrays und dieselben begrenzten Kursvarianten: mindestens zwei Personen je Gruppe und insgesamt höchstens 14. Die Prüfungen verwenden isolierte Eingaben und Seeds, einschließlich anderer Gruppengrößen, negativer und nullwertiger Differenzen sowie degenerierter Ergebnisse. Sie ersetzen niemals die vorhandene Stichprobe. Ein aus Ziehungen geschätzter p-Wert wird weder verlangt noch bewertet.
Zeichne die gespeicherten Zuweisungsdifferenzen
In diesem Schritt zeigst du die tatsächliche gezogene Häufigkeit jeder Differenz und markierst die Lage des unveränderten beobachteten Vergleichs.
Fahre im selben WebIDE-Terminal unter /home/labex/project/signup-experiment fort. np.unique(..., return_counts=True) liefert die unterschiedlichen gespeicherten Differenzen und ihre Häufigkeiten. Das ist ein diskretes Häufigkeitsdiagramm: Die vertikale Achse zeigt, wie viele der 399 Neuzuweisungen jede Differenz ergaben. Es ist kein Konfidenzintervall des Effekts.
Die Zeichenfunktion erhält dein gespeichertes Ergebnis und einen Ausgabepfad. Das PNG muss für gute Lesbarkeit mindestens 500 × 250 Pixel groß sein. figsize=(9, 4.5) legt die Abmessungen in Zoll fest. DPI (dots per inch, Punkte pro Zoll) bestimmt die gespeicherte Rasterauflösung: 140 Pixel pro Zoll ergeben etwa 9 × 140 mal 4.5 × 140, also 1260 × 630 Pixel. Matplotlibs subplots erstellt eine Abbildung und Achsen. bar zeichnet Häufigkeiten, und axvline markiert die beobachtete Differenz, ohne sie als weitere Zuweisungshäufigkeit auszugeben. Eine Beschriftung und sichtbare Legende kennzeichnen die Markierung. Feste horizontale Grenzen von −110 bis +110 lassen Platz für jede mögliche Differenz binärer Raten, auch wenn ein Extremwert in dieser endlichen Stichprobe fehlt. Die vertikale Achse beginnt bei null; tight_layout lässt Platz für Beschriftungen, bevor savefig ein tatsächliches PNG schreibt.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Lies die bereits gespeicherte Stichprobe und zeichne sie mit deiner Funktion:
python3 run.py plot-sample
Klappe im Dateiexplorer von WebIDE signup-experiment/output auf und öffne sample.png. Lies beide Achsenbeschriftungen. Die meisten Häufigkeiten sollten sich um eine Differenz nahe null sammeln; die rote Beobachtungsmarkierung bleibt nahe +66.67 Prozentpunkten. Ein in der Stichprobe fehlender Wert hat Häufigkeit null und bedeutet keine ausgelassene Person. Alle 399 Ziehungen und alle 12 ursprünglichen Personen sind weiterhin in den gespeicherten Daten vertreten.
Das folgende Referenzbild verwendet das gerade ausgeführte NumPy-Beispiel mit Seed 42. Eine andere erlaubte Ziehungsmethode oder ein anderer Seed kann die Balkenhöhen ändern; deine gespeicherte Datei muss deine eigenen tatsächlichen Ziehungen zeigen.
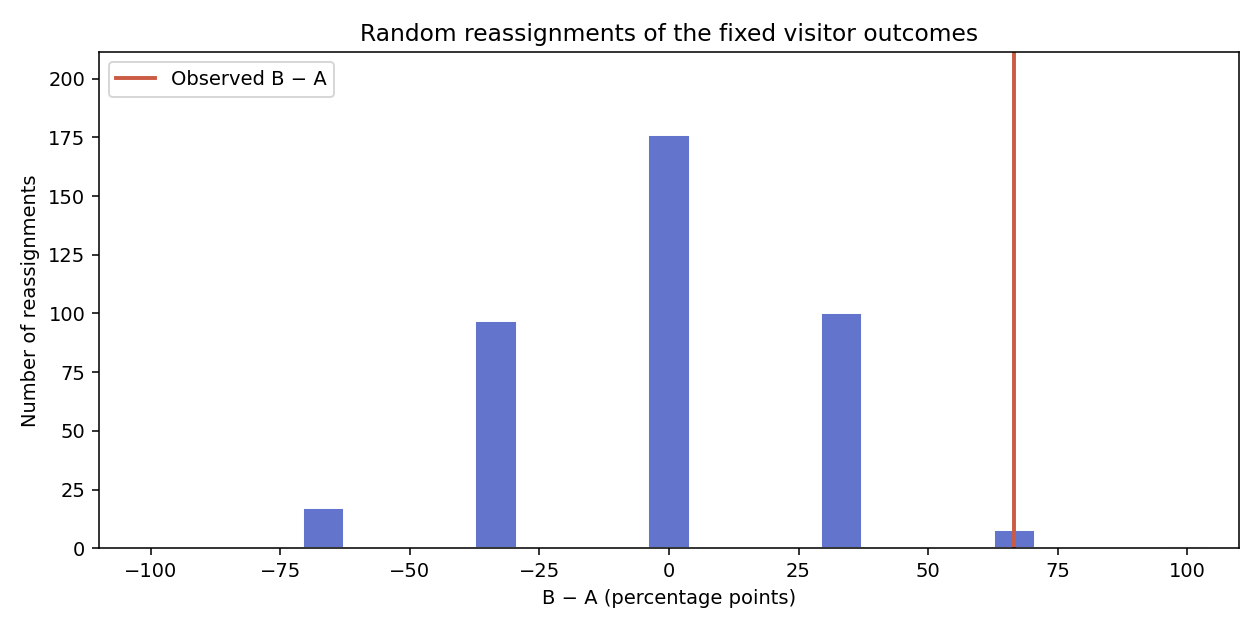
Das gespeicherte PNG muss aus deiner aktuellen Zeichenfunktion und der gespeicherten Stichprobe reproduzierbar sein. Du kannst lesbare Balken, eine Häufigkeitslinie oder Häufigkeitspunkte bei den tatsächlichen Differenzwerten verwenden, ergänzt durch eine sichtbare Linie oder einen Punkt mit Beschriftung Observed an der beobachteten Differenz. Halte alle möglichen Differenzen und die Beobachtungsmarkierung innerhalb der angezeigten Achsen, erhalte die Nullbasis der Häufigkeiten und beschrifte beide Achsen. Eine Markierung zu verbergen, Daten abzuschneiden, ein fremdes Bild zu kopieren oder eine Dichte als Häufigkeit zu beschriften erfüllt die Aufgabe nicht.
Fehlt das PNG, prüfe zuerst, ob python3 show_results.py sample eine gespeicherte Stichprobe lesen kann, und führe dann den Zeichenbefehl erneut aus. Das Anzeigeprogramm selbst erzeugt keine fehlenden Dateien. Im nächsten Lab vergleichst du eine exakte Zuweisungsverteilung mit dem beobachteten Ergebnis und lernst, was diese Evidenz aussagt und was nicht.
Zusammenfassung
Du hast zwei Gruppenzugehörigkeiten manuell getauscht, 399 tatsächliche Neuzuweisungen bei festen Gruppengrößen erzeugt und ihre gespeicherten Differenzen mit dem beobachteten Vergleich gezeichnet. Ein reproduzierbarer Seed ermöglicht die Wiederholung eines Laufs; er wählt weder eine Antwort noch eine Gewinnerseite. Du hast nun die nötige Anschauung für die exakte Evidenz im nächsten Lab.