Einführung
Ein exploratives Diagramm von Neuzuweisungen zeigt, wie feste Personenergebnisse unterschiedliche Gruppenvergleiche ergeben können. Dieses Lab führt die Analyse weiter: Es zählt jede unterschiedliche Zuweisung der kleinen festen Stichprobe, definiert einen zweiseitigen p-Wert genau und hält fest, was die Daten stützen.
Die korrekten Personen- und Vergleichsfunktionen stehen in dieser unabhängigen Umgebung bereits bereit. Du solltest Personenfenster, Differenzen in Prozentpunkten und Neuzuweisungen bei festen Gruppengrößen aus den bisherigen Labs sowie Python-, NumPy- und Matplotlib-Grundlagen kennen. Dateien aus einer früheren VM und Vorkenntnisse zu p-Werten sind nicht erforderlich. Diese eigens erstellten synthetischen Lehrdaten sind kein echtes Geschäftsexperiment; weder eine große beobachtete Differenz noch ein kleiner p-Wert garantieren ein Ergebnis im Produktivbetrieb. Die 55 Minuten sind eine Schätzung des Autors einschließlich Lesen und gewöhnlicher Fehlerkorrekturen.
Zähle jede unterschiedliche Zuweisung
In diesem Schritt ersetzt du eine endliche Zufallsstichprobe durch die vollständige Zuweisungsverteilung und berechnest den ausdrücklich definierten zweiseitigen p-Wert.
Beginne in WebIDE, öffne Terminal → New Terminal und wechsle in das Arbeitsverzeichnis:
cd /home/labex/project/signup-experiment
Lies die Quelldefinitionen und Einstellungen, bevor du das Testergebnis ansiehst:
cat data-dictionary.md
cat config.json
Die Analyse verwendet eine einzige feste, vollständig nachbeobachtete Stichprobe und ein binäres Anmeldeergebnis pro Person. Ihre spätere Interpretation verwendet das bereits ausgewählte alpha = 0.05. Alpha ist eine übliche Vergleichsschwelle für diese Übung, keine 95-prozentige Wahrscheinlichkeit, dass eine Seite funktioniert. Es wurde nicht nach der Suche nach einem günstigen Ergebnis ausgewählt. Ändere nach Ansicht des Vergleichs weder Daten noch Analysezeitpunkt, Schwelle oder Population.
Unter der Nullannahme ohne Seiteneffekt dieser Übung bliebe das Ergebnis jeder Person unabhängig von ihrer Seitenzuweisung unverändert. Der dargestellte randomisierte Versuchsplan erlaubt dann die Neuverteilung dieser festen Ergebnisse unter Erhaltung beider Gruppengrößen. Diese Inferenz gilt nicht automatisch für ein beliebiges nicht randomisiertes Beobachtungsprotokoll.
Eine exakte Zuweisungsverteilung enthält jede unterschiedliche Möglichkeit, die Personen auf beide Gruppen zu verteilen. Die Reihenfolge innerhalb einer Gruppe erzeugt für eine auf Mittelwerten beruhende Statistik keine zusätzliche Zuweisung. Pythons math.comb(n, k) zählt die Möglichkeiten, k Personen aus n auszuwählen. Hier bestimmt die Auswahl der sechs Personen von A aus 12 zugleich die sechs von B.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
Dieses Experiment hat 924 Zuweisungen, jedes bereitgestellte Kursbeispiel höchstens 3432. Bei dieser bewusst kleinen Größe ist vollständiges Aufzählen praktikabel; die Methode verspricht keine Aufzählung beliebig großer Produktionsstichproben.
Für die Statistik B−A in Prozentpunkten folgt dieser Kurs genau der SciPy-Konvention two-sided:
Bestimme zuerst den Anteil der exakten Zuweisungsdifferenzen, die kleiner oder gleich der beobachteten Differenz sind. Bestimme getrennt davon den Anteil, der größer oder gleich ihr ist. Verdopple den kleineren dieser beiden Anteile und begrenze das Ergebnis auf 1.
Gleiche Werte gehören jeweils zu beiden Verteilungsenden. Das ist ein definierter zweiseitiger p-Wert; die Definitionen sind nicht universell. Das Zählen von abs(null) >= abs(observed) ist bei einer asymmetrischen diskreten Verteilung nicht immer gleichwertig. Beispielsweise hat eine A-Gruppe mit zwei Personen ohne Anmeldung und eine B-Gruppe mit fünf Personen und zwei Anmeldungen beobachtete +40 Punkte. Ihre 21 Zuweisungen ergeben −100 einmal, −30 zehnmal und +40 zehnmal. Der definierte p-Wert lautet 2 * 10 / 21 = 20/21; der Anteil am absoluten Verteilungsende wäre dagegen 11/21. Weder Gruppierung noch Definition dürfen stillschweigend geändert werden, um eine kleinere Zahl zu erhalten.
Verwende SciPys vorbereitete Schnittstelle permutation_test. permutation_type="independent" verteilt Beobachtungen zwischen unabhängigen Gruppen neu und erhält deren Größen; Besucher werden nicht als gepaarte Messungen behandelt. vectorized=False bedeutet, dass die Statistik gewöhnliche eindimensionale Arrays erhält. n_resamples=np.inf fordert die gesamte endliche Verteilung statt 399 Zufallsziehungen an. alternative="two-sided" wählt die obige Konvention. Für diese exakte Aufzählung ist kein Zufallsseed nötig.
Die DataFrame-Auswahl .loc[mask, "signed_up"] wählt diese Spalte für passende Personen aus; .to_numpy() macht daraus ein eindimensionales NumPy-Array. Die innere Funktion statistic verwendet dieselbe Differenzformel wie das vorige Lab und wird hier vollständig definiert. Diese Einheit ist deshalb nicht von resample.py aus einer anderen VM abhängig.
result.statistic, result.pvalue und result.null_distribution sind die tatsächlich berechneten Größen. Erhalte ihre ungerundeten Zahlenwerte; .tolist() wandelt das Array in eine JSON-kompatible Liste um, ohne wiederholte Differenzen aus unterschiedlichen Zuweisungen zu entfernen.
Das Shell-Zeichen > ersetzt eine Datei; das Here-Dokument mit Anführungszeichen <<'PY' kopiert den vollständigen Block bis zum letzten PY ohne Shell-Erweiterung. Du kannst die Datei stattdessen in WebIDE bearbeiten und File → Save wählen.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
Die Stufe distribution des Ausführungsprogramms ruft deine Analyse auf und speichert die tatsächlichen Ergebnisse, ohne schon eine Interpretationsfunktion zu verlangen:
python3 run.py distribution
Das Anzeigeprogramm zeigt vorhandene Daten und lässt das lange Array nur in der Terminalanzeige weg:
python3 show_results.py exact
Erwarte 12 Personen, eine Anmeldung unter den sechs Personen von A und fünf unter den sechs von B, eine beobachtete Differenz nahe +66.67 Punkten, null_count 924 und p nahe 0.08009. Die vollständige Verteilung bleibt in output/analysis.json. Das Interpretationsfeld kommt im nächsten Schritt hinzu.
Du darfst inference.py und plot.py bearbeiten oder gewöhnliche Python-Hilfsdateien daneben ergänzen. Erhalte die ursprünglichen CSV-Dateien, Einstellungen, das Wörterbuch sowie Ausführungs- und Anzeigeprogramm. Das vorbereitete outcomes.py und compare.py implementieren zuvor gelehrte Funktionen; gleichwertige Implementierungen sind zulässig, solange ihre öffentlichen DataFrame-/Objektverträge und gültigen Ergebnisse erhalten bleiben. Isolierte Prüfungen umfassen andere begrenzte Gruppengrößen, entgegengesetzte Richtungen, Differenzen von null und ausschließlich nullwertige Ergebnisse. Ein fester p-Wert oder eine feste Verteilung ist keine wiederverwendbare Analyse.
Bei einem gewöhnlichen Pfad- oder Dateinamenfehler verwende pwd und ls, wiederhole das anfängliche cd und kopiere den vollständigen Block erneut. Setup ist kein Hilfsmittel zur Bearbeitungskorrektur: Es weigert sich absichtlich, ein vorhandenes Arbeitsverzeichnis zu überschreiben.
Trenne Evidenz von Gewissheit
In diesem Schritt ergänzt du eine transparente Interpretationsregel, die beide Richtungen oder unzureichende Evidenz ausgeben kann.
Fahre im selben WebIDE-Terminal unter /home/labex/project/signup-experiment fort. Ein p-Wert beschreibt einen Vergleich unter der gewählten Nullannahme und dem Zuweisungsplan. Er ist nicht die Wahrscheinlichkeit, dass die Nullannahme wahr ist, nicht die Wahrscheinlichkeit, dass kein Seiteneffekt besteht, und keine Garantie für die nächste Werkstatt.
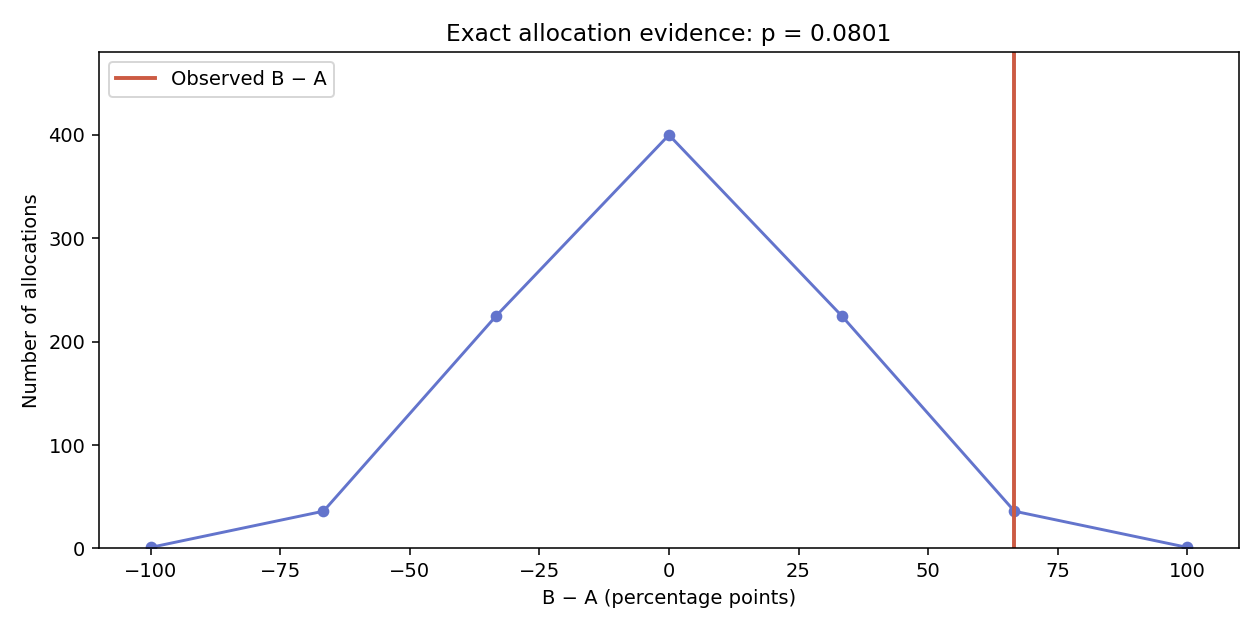
Hier wirken etwa +66.67 beobachtete Punkte groß, doch der exakte p-Wert beträgt etwa 0.08009. Mit dieser festen kleinen Stichprobe und dem vorab ausgewählten Alpha 0.05 meldet die Übung nicht eindeutige Evidenz. Das beweist nicht, dass die Seiten identisch sind. Es bedeutet, dass dieser bestimmte Test und diese Stichprobe nicht das gewählte Evidenzniveau gegen die Nullannahme liefern.
Verwende diese ausdrücklichen Ausgabelabels:
evidence_for_b, wenn p <= alpha und die Differenz positiv ist;evidence_for_a, wenn p <= alpha und die Differenz negativ ist;inconclusiveandernfalls, einschließlich einer Differenz von null.
Gleichheit an der Schwelle gehört zum Evidenzzweig: p == alpha erfüllt <=. Runde p vor diesem Vergleich nicht. Dies sind Labels einer begrenzten Analyse, keine automatische Geschäftsentscheidung zur Einführung einer Seite. Ein anderes gültiges Experiment kann A oder keine der Seiten stützen; kein Label muss B begünstigen.
Das Shell-Zeichen >> hängt an die vorhandene Datei an, statt sie zu ersetzen. Der folgende vollständige Block fügt conclude unter analyze hinzu; füge ihn einmal ein. Bei Bearbeitung in WebIDE ergänze die Funktion am Ende und speichere. Pythons and verlangt beide Bedingungen, bevor ein Zweig sein Label zurückgibt.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
Führe die exakte Analyse erneut über die Interpretationsstufe aus. Dies ersetzt die Ergebnisdatei absichtlich durch eine vollständige aktuelle Analyse, die auch das Label enthält:
python3 run.py exact
python3 show_results.py exact
Für diese vollständige Stichprobe muss das Ergebnis inconclusive lauten. Beobachtete Differenz, roher p-Wert und die 924 Zuweisungsdifferenzen bleiben gleich. Entferne keine Personen, wähle kein einzelnes Datum, ändere keine tatsächlichen Gruppenzuweisungen und ersetze nichts durch eine explorative Zufallsstichprobe, um ein bevorzugtes Label zu erhalten. Alle erforderlichen siebentägigen Nachbeobachtungen sind bereits beendet; eine Abbruchregel zu ändern oder weitere Daten hinzuzufügen liegt außerhalb dieser Übung.
Speichere eine lesbare Ansicht der exakten Evidenz
In diesem Schritt zeichnest du die vollständige gespeicherte Zuweisungsverteilung und kennzeichnest den beobachteten Vergleich, ohne seinen Kontext zu verbergen.
Fahre im selben WebIDE-Terminal unter /home/labex/project/signup-experiment fort. Dieses Diagramm verwendet die exakte Verteilung in result["analysis"], nicht die explorative Stichprobe aus einer anderen Einheit. np.unique(..., return_counts=True) zählt, wie viele unterschiedliche Zuweisungen jede Differenz erzeugen; die Höhen müssen sich bei den aktuellen Daten zu 924 summieren. Wiederholte Werte sind bedeutungsvoll und dürfen nicht aus der zugrunde liegenden Verteilung entfernt werden.
Einige exakte Randhäufigkeiten entsprechen nur einer Zuweisung. Sichtbare Punktmarkierungen halten diese seltenen Häufigkeiten über der Nullbasis lesbar. Die Verbindungslinie hilft, den diskreten Punkten zu folgen; sie bedeutet nicht, dass jede Differenz dazwischen erreichbar wäre.
Die horizontale Koordinate ist die Differenz B−A in Prozentpunkten, die vertikale die Zuweisungshäufigkeit. Die sichtbare Markierung Observed zeigt den tatsächlichen Vergleich. Ein gerundeter p-Wert im Titel dient nur der Anzeige; gespeicherte Zahl und Interpretation verwenden den ungerundeten Wert. Der vollständige mögliche Differenzbereich und die Nullbasis der Häufigkeiten bleiben sichtbar, einschließlich berechtigter Nullen und Randwerte.
Speichere ein PNG mit mindestens 500 × 250 Pixeln. Wie im vorherigen Lab ergibt eine Abbildung von 9 × 4.5 Zoll bei DPI 140 etwa 1260 × 630 Pixel; diese Auflösung lässt Platz für lesbare Achsen und Markierungen seltener Häufigkeiten.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Erzeuge das PNG aus der tatsächlich gespeicherten Analyse:
python3 run.py plot-exact
Klappe im Dateiexplorer von WebIDE signup-experiment/output auf und öffne evidence.png. Suche die Verteilung um null und die Beobachtungsmarkierung nahe +66.67. Lies daneben output/analysis.json mit dem Anzeigeprogramm: 12 Personen, beide Zuweisungsnenner, rohe Differenz, exaktes p, Alpha und das Label inconclusive bilden gemeinsam die Evidenz. Ein Diagramm allein beweist keine korrekte Analyse.
Die folgende Referenz ist das tatsächlich gespeicherte Diagramm aus diesen geführten Daten und dem bereitgestellten Zeichencode. Die Punkte enthalten seltene Zuweisungshäufigkeiten an beiden Enden; die Linie verbindet nur erreichbare Differenzen. Lies sie zusammen mit dem gespeicherten numerischen Ergebnis.
Du darfst lesbare Balken, eine Häufigkeitslinie oder Häufigkeitspunkte bei den tatsächlichen Differenzwerten verwenden. Der beobachtete Vergleich benötigt eine sichtbare Linie oder einen Punkt mit Beschriftung Observed, und beide Achsen benötigen aussagekräftige Beschriftungen. Halte den gesamten Wertebereich, die Beobachtungsmarkierung und die Nullbasis sichtbar. Das PNG muss sich aus den tatsächlich gespeicherten Daten und der aktuellen Zeichenfunktion dekodieren und reproduzieren lassen; unsichtbare Striche, Markierungen außerhalb der Achsen, abgeschnittene Diagramme und fremde Bilder bestehen nicht. Fehlt das PNG, prüfe zunächst das gespeicherte exakte Ergebnis mit python3 show_results.py exact und führe dann den Zeichenbefehl erneut aus; das Anzeigeprogramm repariert es nicht.
Du hast eine synthetische Stichprobe eines randomisierten Experiments unter einer angegebenen Annahme und Konvention analysiert. Du hast weder ein reales Geschäftsergebnis gemessen noch identische Seiten bewiesen oder festgestellt, dass ein beobachteter Effekt im Produktivbetrieb fortbesteht.
Zusammenfassung
Du hast eine begrenzte exakte Verteilung aufgezählt, einen zweiseitigen p-Wert mit einschließenden Verteilungsenden verwendet, eine vorab gewählte Schwelle ohne Rundung angewendet und das tatsächliche Diagramm gespeichert. Eine große Differenz kann bei einer kleinen Stichprobe nicht eindeutig bleiben; ein nicht eindeutiges Ergebnis beweist keine Gleichheit der Seiten. Die unabhängige Challenge überträgt denselben Ablauf nun auf eine andere Zuweisung und Ereignishistorie.