Einführung
Eine Vorschau mit drei Karten eignet sich zum Stöbern, doch die Redakteurin benötigt jeden passenden Datensatz. Vervollständige den Client derselben lokalen Demo-API, sodass er Fortsetzungs-Tokens folgt, Identitäten über Seiten hinweg erhält und die CSV erst nach erfolgreichem Abschluss des gesamten Laufs veröffentlicht. Auch auf eine leere oder kurze Seite können weitere Seiten folgen.
Diese Einheit wird unabhängig mit den Anfrage- und Auswahlfunktionen des ersten geführten Labs vorbereitet. Du benötigst dieses Lab oder gleichwertige HTTP/JSON/CSV-Kenntnisse. Verwende in WebIDE Terminal → New Terminal und Web 8080 für Quelle, gespeicherte Exporte und die öffentlichen Demo controls. Bearbeite nur client.py und storage.py; verwende die Standardbibliothek und interne Hilfsfunktionen, keine zusätzlichen Hilfsmodule oder Ressourcen. Liefere CSVs als echte reguläre Dateien im Arbeitsverzeichnis ab, nicht als symbolische Links. Lasse catalog.py, /opt/commonlight, synthetische Illustrationen und erfundene Quelldatensätze unverändert. Die geschätzten 55 Minuten für Lesen und Üben sind keine mit Anfängern gemessene Zeit.
Dem Protokoll bis zum Ende folgen
In diesem Schritt sammelst du alle Seiten, einschließlich einer leeren und einer kurzen Datenseite, und behältst jede ID genau einmal. Öffne im Terminal von WebIDE das unabhängig vorbereitete Arbeitsverzeichnis:
cd /home/labex/project
Die Anfragefunktion verarbeitet bereits JSON, kodierte Cursor und eine Zeitgrenze von drei Sekunden für blockierende Vorgänge. Untersuche mit cat die vorbereiteten Regeln:
cat client.py
Das aktuelle collect gibt nur eine Seite zurück. Ein page_size von 3 bedeutet höchstens drei Datensätze, nicht zwingend drei auf jeder Seite. Sage diese kleine Folge voraus: erst drei Datensätze, dann keine mit einem weiteren Cursor, danach ein Datensatz mit noch einem Cursor. Die leere Seite fügt nichts hinzu, beweist aber nicht das Ende. Führe die Folge ausschließlich mit den zurückgegebenen Cursorn aus:
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
Nur next_cursor is None beendet einen Lauf erfolgreich. Halte nicht an, weil items leer, eine Seite kurz oder eine vermutete Seitenanzahl erreicht ist.
Dieselbe Foto-ID kann auf mehreren Seiten mit identischen Werten erneut vorkommen. Ein Dictionary mit photo_id als Schlüssel erhält die Verbindung zwischen Identität und sämtlichen Feldern. setdefault(key, value) fügt den Wert nur ein, wenn der Schlüssel fehlt. So bleibt eine Kopie erhalten; ein wiederholter Titel ist keine doppelte ID. Widersprüchliche Versionen liegen außerhalb dieses Demo-Vertrags. Beide unterschiedlichen IDs mit dem Titel Blue hour müssen erhalten bleiben.
Eine Menge speichert eindeutige Werte. set() erzeugt die leere Menge, cursor in seen_cursors prüft auf ein bereits vorhandenes Token, und seen_cursors.add(cursor) merkt sich ein neues Token. Diese Menge enthält die bereits gesehenen Fortsetzungs-Tokens. Prüfe zuerst das legitime null-Ende und lehne dann ein wiederholtes Token ab, statt endlos weiterzulaufen oder einen Zyklus als Abschluss anzusehen. raise ValueError stoppt die Sammlung, bevor ein unvollständiges Ergebnis gespeichert wird. Normale vorbereitete Kataloge sind endlich; es gibt keine feste Seitengrenze und keine automatische Wiederholung oder Wiederaufnahme.
Ersetze client.py durch das folgende vollständige Modul. Wie zuvor ersetzt > die Datei; das zitierte Here-Dokument lässt den Inhalt unverändert. Anfrage und Filter bleiben gleich, neu ist collect.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
Starte eine vollständige Sammlung. Lasse --first-page weg; diese Option erzeugt bewusst nur eine Stichprobe.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
Prüfe die gespeicherten Identitäten, statt nur einer Anzahl zu vertrauen:
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
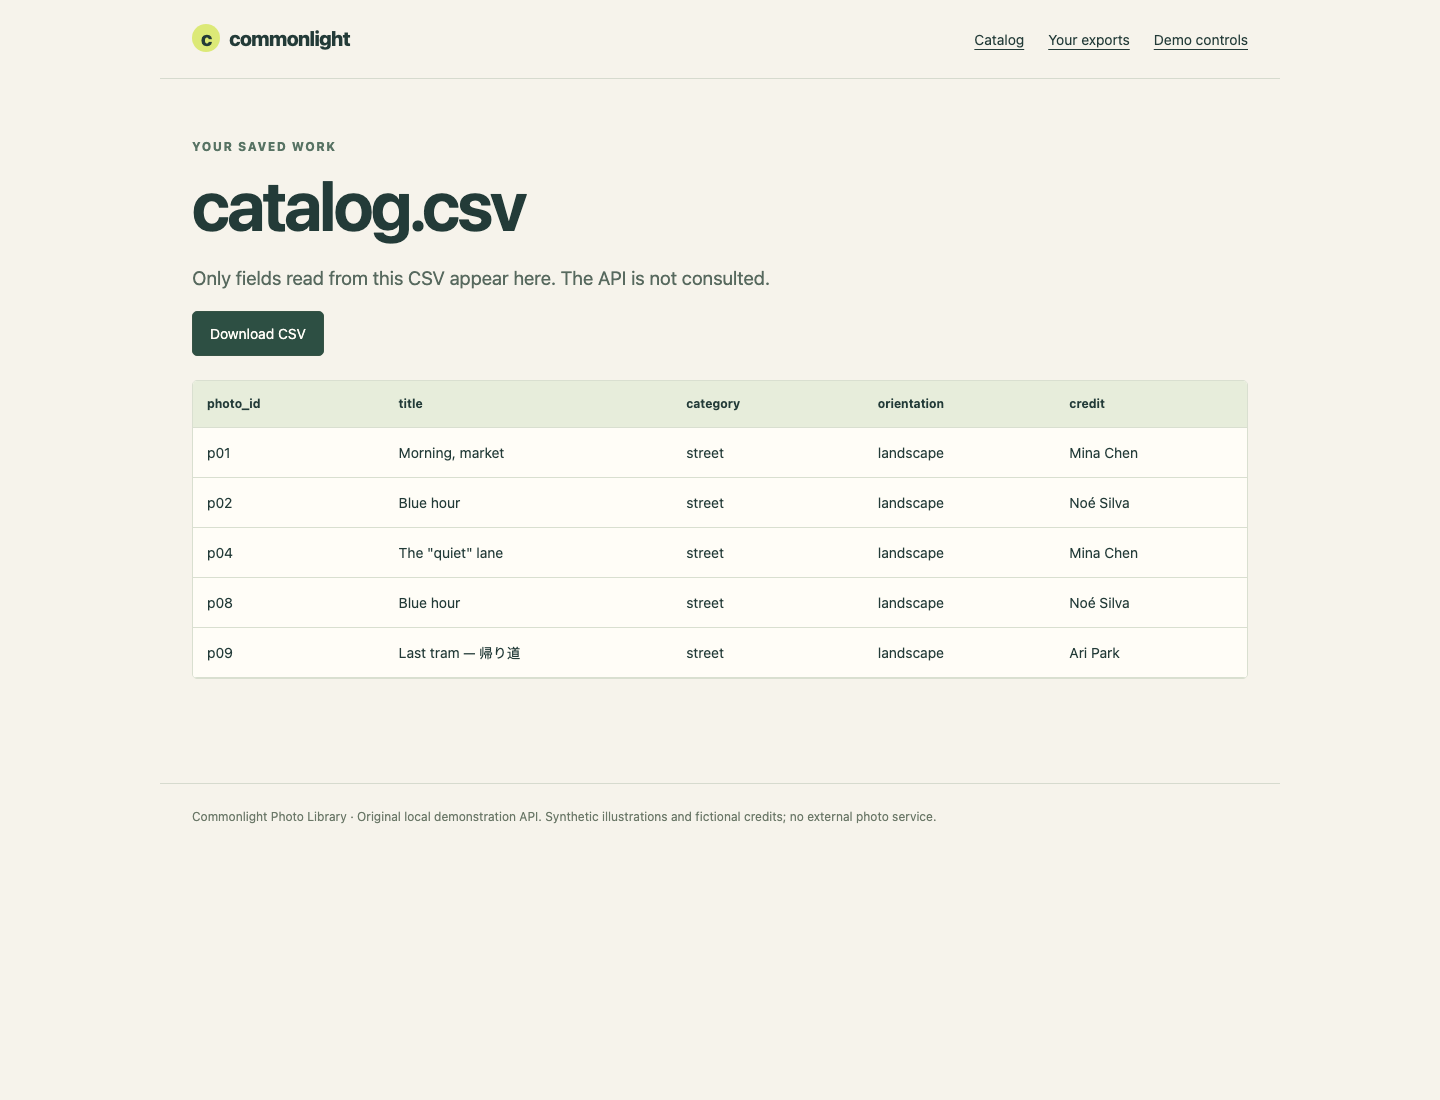
Der Datensatz der letzten Seite p09 ist enthalten, p02 erscheint einmal, und p08 behält denselben Titel mit einer anderen ID. Sieh dir dieselben Werte unter Web 8080 → Your exports → catalog.csv an. Diese Tabelle liest ausschließlich deine CSV; eine unvollständige Datei bliebe auch dort unvollständig. Kehre zur Selbstprüfung zu WebIDE zurück. Bei einem falschen Dateinamen oder Verzeichnis helfen pwd, ls und das zuvor verwendete cd, bevor du es erneut versuchst.
Nur einen vollständigen Export veröffentlichen
In diesem Schritt schützt du den letzten erfolgreichen Export, wenn eine spätere Anfrage, ein Protokollzyklus oder eine Dateiausgabe fehlschlägt. Das Sammeln endet schon vor dem Speichern. Auch der Writer braucht eine Grenze für vollständigen Erfolg: Wird die Zieldatei mit w geöffnet, kann eine gute Datei abgeschnitten werden, bevor die neue Ausgabe fertig ist.
Path(output) macht aus dem übergebenen Dateinamen ein Pfadobjekt. .parent ist das übergeordnete Verzeichnis, .name der endgültige Dateiname. NamedTemporaryFile erzeugt einen neuen eindeutigen Namen, statt einen vorhersehbaren Nachbarn wie catalog.csv.tmp zu verwenden. dir=output.parent legt ihn im Zielverzeichnis an, damit die Ersetzung im gleichen Dateisystem bleibt. delete=False erhält die Datei nach dem Schließen für die Ersetzung; stream.name liefert den vergebenen Namen, den wir als Path speichern. Der Block finally läuft nach Erfolg und nach einer Ausnahme. exists() prüft, ob der temporäre Pfad noch existiert; unlink() entfernt nur die neu angelegte Datei, falls sie übrig ist. Nach erfolgreicher Ersetzung ist der temporäre Pfad verschwunden, daher wird nichts entfernt. Eine Ausnahme wird weiterhin an die Befehlsschnittstelle weitergegeben und führt zu einem Exit-Status ungleich null. Path.replace veröffentlicht die fertige Datei, nachdem der Block with sie geschlossen hat. Eine erfolgreiche POSIX-Ersetzung ist atomar, verspricht aber weder Dauerhaftigkeit bei Stromausfall noch eine Transaktion über mehrere Dateien oder die Koordination gleichzeitiger Writer. Eine vorhandene fremde .tmp-Datei darf niemals überschrieben oder entfernt werden.
Ersetze im Terminal von WebIDE storage.py. Die fünf CSV-Felder müssen jeweils genau einmal im Kopf stehen; gleichwertige Implementierungen dürfen andere gültige Anführungszeichenformen sowie andere Zeilen- und Spaltenreihenfolgen verwenden.
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
Führe vor der Fehlersimulation einmal einen normalen Lauf aus. sha256sum zeigt einen Fingerabdruck des Inhalts und den Dateinamen an. Merke ihn dir oder lasse die Ausgabe sichtbar; der nächste fehlgeschlagene Lauf muss ihn unverändert lassen. Auch eine fehlgeschlagene Ausgabe muss die letzte vollständige Datei erhalten; die Prüfung testet dies isoliert, ohne dein Arbeitsverzeichnis zu verändern.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Wechsle zu Web 8080. Wähle Demo controls, dann Enable middle-page failure. Prüfe Middle-page failure ON.
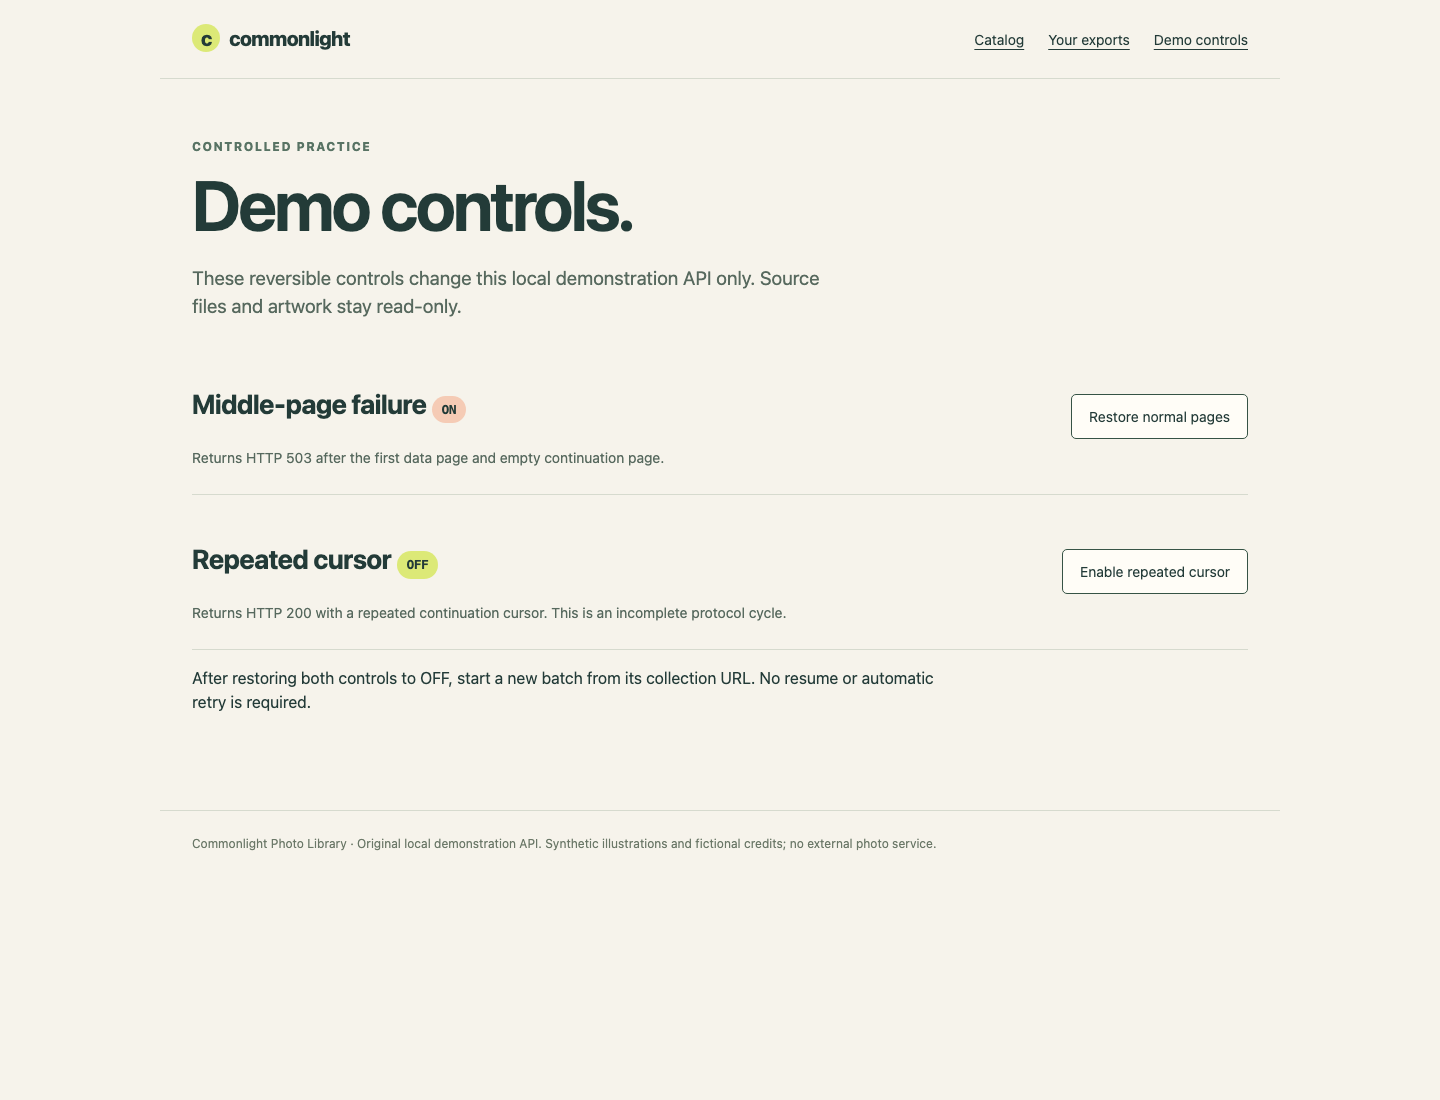
Benutze die Karte für den aktivierten Fehler. Diese reversible Änderung ist ausdrücklich erlaubt und betrifft nur den Arbeitsspeicher der Demo-API; die Quelldateien bleiben schreibgeschützt. Kehre zu WebIDE zurück und löse diesen beabsichtigten Fehler aus. printf erfasst $? unmittelbar:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
HTTP 503 bedeutet hier, dass die Demo-API eine Anfrage für eine mittlere Seite ablehnt. Das ist weder ein Verbindungsfehler noch ein erfolgreiches leeres Ergebnis. Der Fingerabdruck muss gleich bleiben; der alte Export mit fünf Zeilen muss weiterhin lesbar sein. Ein Exit-Status ungleich null reicht nicht, wenn das Programm die Datei bereits beschädigt hat.
Wähle unter Web 8080 → Demo controls beim Fehler auf mittleren Seiten Restore normal pages und bestätige OFF. Kehre zu WebIDE zurück und starte einen neuen endlichen Lauf von der Sammlungs-URL aus; verwende keinen alten Cursor:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Wechsle anschließend zu Web 8080 → Demo controls und wähle Enable repeated cursor. Prüfe Repeated cursor ON und den Fehlerregler auf OFF. Kehre zu WebIDE zurück:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
Diese Antworten haben HTTP 200, aber ihr wiederholter Cursor ist ein Protokollfehler und kein Abschluss. Die Mengenprüfung verhindert die Endlosschleife und die Veröffentlichung. Wähle unter Web 8080 → Demo controls innerhalb der Karte Repeated cursor die Schaltfläche Restore normal pages und prüfe OFF; beide Regler müssen jetzt auf OFF stehen. Kehre zu WebIDE zurück, wiederhole den erfolgreichen Befehl und teste dann einen gültigen Filter ohne Treffer unter einem neuen Ausgabenamen:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
Das zweite Ergebnis ist erfolgreich und enthält nur den Kopf; es unterscheidet sich von den beiden Fehlern. Öffne unter Web 8080 → Your exports die Datei empty.csv mit ihren fünf Spaltennamen und ohne Datenzeilen, dann catalog.csv, und wähle Download CSV. Die tatsächlich gespeicherte Datei mit fünf Datensätzen ist dein Ergebnis. Kehre zur Selbstprüfung zu WebIDE zurück. Erhalte Programm und vorbereitete Quellen: Die Prüfung liest das wirkliche Ergebnis und führt unveränderte Kopien in isolierten echten HTTP-Tests mit anderen URLs, Filtern, Größen und Schreibfehlern aus.
Zusammenfassung
Du bist undurchsichtigen Fortsetzungs-Tokens bis zum ausdrücklichen null-Ende gefolgt, hast trotz gleicher Titel verschiedene Identitäten bewahrt und einen Protokollzyklus abgelehnt. Eine vollständige UTF-8-CSV wurde über eine eindeutige temporäre Datei veröffentlicht, während Fehler das vorherige gute Ergebnis unberührt ließen. Dasselbe Programm kann eine andere übergebene Sammlung und Auswahl verarbeiten.