Einführung
Das Studio hat jetzt eine ehrliche Vorhersagegrenze. Verbessert ein kleines Regressionsmodell die Materialplanung gegenüber einem früheren Teilnehmermedian? Du passt eine kurze Pipeline an, vergleichst beide Methoden an denselben gelabelten Workshops und speicherst eine echte Vergleichsgrafik sowie Zukunftsvorhersagen.
Du benötigst Python-Funktionen, pandas-Auswahl und Joins, grundlegende Scikit-learn-Regression und Trainings-/Testkonzepte sowie erste Matplotlib-Kenntnisse. Das vorherige Guided Lab erklärt den Sieben-Tage-Stichtag und die ausschließlich an Trainingsdaten gelernte Imputation. Dieses Lab bereitet sämtliche Dateien unabhängig vor, einschließlich der fertigen ID-/Datumsaufteilung; Dateien der vorherigen VM werden nicht benötigt. Alle Daten sind eigens erstelltes synthetisches Lehrmaterial. Die 60 Minuten sind eine Schätzung des Autors.
Eine kleine Pipeline an früheren Workshops anpassen
In diesem Schritt ersetzt du ein verlockendes nachträgliches Modell durch einen wiederverwendbaren Sieben-Tage-Prädiktor.
Beginne in WebIDE → Terminal → New Terminal. cd ändert das Arbeitsverzeichnis dieses Terminals. Die vorbereitete ausführbare Datei ./python startet die Kursumgebung; ./ wählt den Starter in diesem Verzeichnis statt eines Systeminterpreters.
cd /home/labex/project/workshop-attendance
cat zeigt Dateien unverändert an; mehrere Dateinamen als Argumente zeigen sie nacheinander an.
cat season.json history.csv labels.csv future.csv
Jede historische Zeile ist ein durch session_id identifizierter Workshop. labels.csv ordnet actual_attendance über diesen Schlüssel in unabhängiger Reihenfolge zu. Die einzigen erlaubten numerischen Modellmerkmale sind booked_7d, ein genau sieben Tage vorher gespeicherter Buchungsstand, und duration_minutes, die am Stichtag bereits angekündigte Dauer. Leere numerische Zellen bedeuten fehlende Information; jedes erlaubte Merkmal besitzt eine nichtleere Trainingsbeobachtung. IDs und Datumsangaben dienen Zuordnung und Aufteilung, nicht als Modelleingaben. final_bookings und scanned_entries entstehen während der Veranstaltung und verraten sieben Tage zuvor noch nicht verfügbare Informationen.
Die fertige Aufteilung friert das Training am 1. April 2026 um 00:00 UTC ein und reserviert historische Veranstaltungen ab dem 12. April zur Auswertung. Trainingslabels sind bis zum Ende jedes früheren Veranstaltungstags bekannt; die letzte Trainingsveranstaltung ist hier am 8. März. Die früheste Holdout-Vorhersage erfolgt am 5. April mit dem eigenen Sieben-Tage-Stand dieser Veranstaltung und dem bereits eingefrorenen Modell. Es wird nicht behauptet, die Eingabe vom 5. April sei am 1. April verfügbar. Spätere Dateien spielen die jeweiligen späteren Vorhersagetage nach. future.csv enthält keine tatsächlichen Labels; seine Mai-Veranstaltungen erhalten Vorhersagen, keine gemessenen Fehler. Im konfigurierten Zwischenraum gibt es keine historischen Zeilen. Rollierende Neuanpassungen und vollständig leere Trainingsmerkmale sind nicht Teil des Kurses.
cat split.py
Beachte den schlüsselbasierten merge, die eingelesenen Kalendergrenzen und die Datumssortierung. Dies ist die fertige Aufteilung aus der vorherigen Lektion, hier für die Unabhängigkeit bereitgestellt. Bewahre sie, sämtliche CSV/JSON-Eingaben, python, run.py, coursekit.py, show_results.py und die starter-*.py-Dateien auf. Bearbeite nur model.py, chart.py und deine output/-Ergebnisse. Die gelieferte model.py beginnt mit einem scanbasierten Modell: Perfekt aussehende historische Ergebnisse würden die unzulässige Informationswahl nicht retten.
Eine Pipeline verbindet Vorverarbeitung und Modell. Bei fit lernt der Imputer Mittelwerte aus den übergebenen Trainingsmerkmalen, anschließend lernt die Regression aus der ergänzten Trainingsmatrix. Bei predict transformiert derselbe Imputer die späteren Eingaben nur. Er wird niemals erneut an Holdout oder Zukunft angepasst. LinearRegression passt Achsenabschnitt und Merkmalskoeffizienten durch gewöhnliche kleinste Quadrate an; wir behalten dieses kleine Modell, statt viele Alternativen abzustimmen.
Schreibe die zwei wiederverwendbaren Modellfunktionen. FEATURES ist genau ['booked_7d', 'duration_minutes']. fit_model gibt den angepassten Schätzer und den Trainingszielmedian zurück. predict_events wählt für jede Eingabetabelle dieselben erlaubten Merkmale. Die vorläufige Funktion evaluate wird im nächsten Schritt ergänzt; die Phase fit ruft sie nicht auf.
Das Shell-Zeichen > ersetzt die Datei. <<'PY' beginnt ein zitiertes Here-Dokument: Füge alles bis zur letzten Zeile mit nur PY ein; die Shell speichert den enthaltenen Python-Code wörtlich. Alternativ bearbeitest du model.py im WebIDE Explorer und wählst File → Save.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
Die gespeicherte Vorschau sollte W-88 mit einer rohen Vorhersage nahe 32.718, tatsächlicher Teilnehmerzahl 46 und Baseline 24.5 verknüpfen; W-09 sollte nahe 62.236 vorhersagen, tatsächlich 74 und dieselbe Baseline haben. Ein Regressionsergebnis darf einen Bruchteil enthalten, obwohl eine tatsächliche Veranstaltung eine ganze Personenzahl hat.
./python show_results.py fit
Dies sind Vorhersagen vor der Fehlerzusammenfassung. Sie wurden ohne die späteren Labels angepasst. Änderungen dieser Labels sollen die späteren Fehler verändern, nicht die angepassten Vorhersagen. Ein Merkmal mit gelerntem Koeffizienten null darf berechtigterweise ohne Einfluss sein; eine beliebige Eingabeänderung verändert nicht zwingend die Vorhersage.
Kontinuierliche Fehler auf demselben Holdout vergleichen
In diesem Schritt berechnest du absolute Fehler aus echten Holdout-Labels und vergleichst ihre Mittelwerte in Personen.
Fahre in WebIDE unter /home/labex/project/workshop-attendance fort. Ein absoluter Fehler ist der Betrag von actual - predicted. np.abs berechnet ihn elementweise; np.mean mittelt das resultierende Array. Für eine faire Baseline ziehst du denselben früheren Zielmedian von jedem derselben tatsächlichen Holdout-Labels ab. Vergleiche niemals unterschiedliche Veranstaltungsmengen und ersetze kein tatsächliches Ergebnis durch eine Vorhersage.
Verwende für alle Fehler und MAEs die rohen kontinuierlichen Vorhersagen. Die Vorhersage zuerst auf eine angezeigte Personenzahl zu runden verändert die Auswertung. Das Hilfsprogramm formatiert den Konsolen-MAE zur Lesbarkeit auf drei Nachkommastellen, speichert aber den ungerundeten Zahlenwert in JSON.
Ersetze model.py durch die vollständige Version unten. Sie erhält Modellanpassung und Vorhersagelogik und ergänzt die zuvor leere Funktion evaluate. Diese liefert Fehlerarrays pro Veranstaltung und deren Mittelwerte zurück; beim Schreiben von output/holdout.csv bewahrt das Hilfsprogramm die IDs derselben Holdout-Zeilen. Fehlervektoren folgen der Positionsreihenfolge der übergebenen Ist-/Vorhersagearrays. Gleichwertige arrayähnliche Werte einschließlich pandas Series werden in dieser Reihenfolge akzeptiert; ihre numerischen Series-Indexlabels sind keine Workshop-IDs.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
Erwartete Konsolenzusammenfassung:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
Für W-88 beträgt der Modellfehler etwa 13.282 Personen, der Baseline-Fehler 21.5. Für W-09 sind es etwa 11.764 und 49.5. Die ungerundeten Mittelwerte sind ungefähr 12.5230751656 beziehungsweise genau 35.5 Personen. Die frühere Einstiegsbaseline war 18; der Trainingsmedian der vollständigen Saison ist 24,5, weil eine andere frühere Stichprobe verwendet wird.
Hier hat das kleine Modell auf diesen beiden zurückgehaltenen Veranstaltungen den geringeren Fehler. Das ist ein Befund für diesen kleinen synthetischen Holdout, kein Beweis künftiger Zuverlässigkeit oder einer durch Buchungen verursachten Wirkung. Hat ein korrektes Modell stattdessen einen höheren MAE, lautet die ehrliche Schlussfolgerung, dass es diesen Vergleich nicht verbessert. Die Bewertung verlangt niemals, dass das Modell die Baseline schlägt; konstante oder informationslose Merkmale sind zulässig.
Grafik und Zukunftsvorhersagen ohne Labels liefern
In diesem Schritt machst du den Holdout-Vergleich lesbar und exportierst Zukunftsschätzungen, ohne tatsächliche Ergebnisse zu erfinden.
Fahre in WebIDE unter /home/labex/project/workshop-attendance fort. Die Grafik muss für jede Holdout-ID je einen Wert der Reihen Actual, Model und Baseline anhand der rohen Personenwerte aus der Vergleichstabelle darstellen. Linien oder Streupunkte sind geeignet; Beschriftungen und IDs verdeutlichen die Bedeutung. Das PNG muss lesbar und mindestens 600 mal 300 Pixel groß sein; bei erneuter Ausführung mit denselben Daten muss dieselbe sichtbare Grafik entstehen. Die Gestaltung darf abweichen. Geprüft werden tatsächlich gezeichnete Werte und die gespeicherte Grafik, kein selbst gemeldetes Diagrammmanifest. Jeder fachliche Punkt muss innerhalb der sichtbaren Achsengrenzen bleiben, keine erforderliche Reihe darf versteckt oder vollständig transparent sein. Punkte genau auf einer Grenze sind erlaubt; Farben und Achsenbereiche dürfen variieren.
Matplotlibs Backend Agg schreibt Bilder ohne Desktopfenster. subplots erzeugt Abbildung und Achsen; plot zeichnet jede ID-bezogene Reihe. Die Markierungen unten unterscheiden offene Istwert-Kreise, Modell-Rauten und gestrichelte Baseline-Kreuze, auch bei überlappenden Ist- und Baseline-Werten. tight_layout reserviert Platz für Beschriftungen. savefig schreibt das echte PNG, close gibt die Abbildung frei.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
Übe zunächst einen harmlosen Tippfehler. Der folgende Befehl verwendet absichtlich einen ungültigen Phasennamen und endet mit einem Argumentfehler; er verändert keine gespeicherten Ergebnisse.
./python run.py delvier
Die Meldung nennt die erlaubten Optionen. Korrigiere die Schreibweise und führe die Lieferphase aus. Erhältst du stattdessen einen Fehler wegen einer fehlenden Datei, verwende pwd und ls, kehre mit dem anfänglichen cd zurück und versuche den richtig geschriebenen Dateinamen.
./python run.py deliver
./python show_results.py deliver
Der Leser lädt gespeicherte CSV/JSON-Dateien und decodiert das tatsächliche PNG; er ergänzt niemals Lücken aus Eingabedaten. Klappe im WebIDE Explorer output auf und öffne comparison.png. Das Modell sollte unter beiden tatsächlichen Teilnehmerpunkten liegen; die Baseline bleibt bei 24,5. Verschiedene Markierungen machen auch gleichwertige Reihen unterscheidbar. Vergleiche holdout.csv neben dem Bild, um jeden Punkt mit seiner ID und seinem tatsächlichen Fehler zu verbinden.
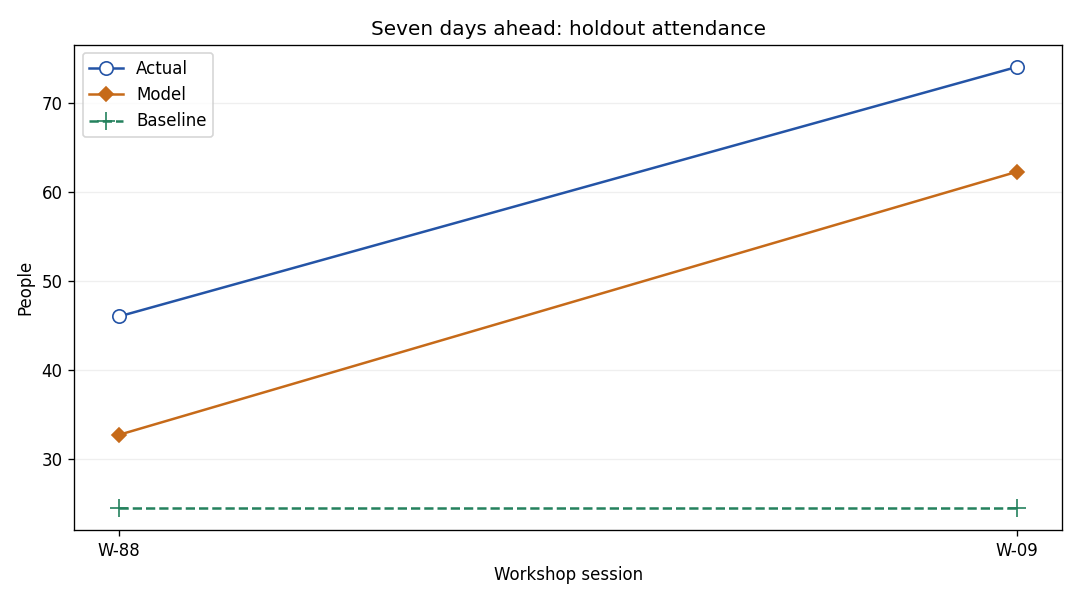
Das Beispiel mit den gelieferten Daten zeigt tatsächliche Zahlen 46 und 74 bei W-88 und W-09, Modellvorhersagen nahe 32,718 und 62,236 sowie die gestrichelte Baseline bei 24,5. Der vertikale Abstand vom tatsächlichen Punkt zur Vorhersage entspricht dem absoluten Fehler der Veranstaltung. Deine Gestaltung darf abweichen; IDs und zugrunde liegende Werte müssen übereinstimmen.
forecast.csv enthält nur session_id, die rohe model_prediction und display_people. F-6 hat eine Vorhersage nahe 19.119 und die angezeigte Zahl 19; F-101 liegt nahe 25.245 und zeigt 25. Nur für die Anzeige begrenzt das Hilfsprogramm negative Schätzungen auf null und rundet halbe Werte mit floor(max(raw, 0) + 0.5) nach oben. Das ist eine praktische Darstellungsregel, keine Änderung des ausgewerteten Modells. Die rohe Vorhersage bleibt erhalten, auch wenn sie negativ oder nicht ganzzahlig ist.
Es werden weder künftige Istzahlen noch künftige MAEs erfunden. Ein Modell kann eingefroren werden, bevor ein späterer Vorhersagestand eintrifft: Am Sieben-Tage-Stichtag jeder Mai-Veranstaltung verwendest du das bestehende Modell und ihre gespeicherten bekannten Merkmale erneut. Kleine synthetische Stichproben, fehlende Stände und verändertes Teilnahmeverhalten begrenzen die Aussagekraft. Die unabhängige Challenge ändert Saison und Daten bei gleichem Ablauf. Gleichwertige numerische Implementierungen, Ausgabereihenfolgen und Linien-/Punktstile werden mit 1e-8 numerischer Toleranz und korrekten ID-Beziehungen akzeptiert.
Zusammenfassung
Du hast eine kleine Imputations-/Regressions-Pipeline an früheren Workshops trainiert, ihre rohen Holdout-Fehler mit einer Trainingsmedian-Baseline verglichen und eine ID-bezogene Grafik gespeichert. Außerdem hast du Zukunftsschätzungen exportiert, ohne ihre unbekannten Ergebnisse auszuwerten. Ein niedrigerer Holdout-MAE kann diesen begrenzten Vergleich stützen; ein schlechteres Ergebnis ist ebenso gültig, wenn es ehrlich berechnet wurde.