



Einführung
EARLY CRUMB braucht eine Liste, mit der am Samstag wirklich gepackt werden kann. Eine bezahlte Bestellung kann storniert sein und eine gültige Bestellung mehrere unterschiedliche Artikel benötigen. Deine Aufgabe ist, die richtigen Bestellungen mit jeder Menge zu erhalten und einzelne Tütenetiketten zu übergeben.
Dieses neue Lab stellt alle ursprünglichen Daten und eine sortierte Datei bezahlter Bestell-IDs bereit. Du brauchst keine Dateien einer vorherigen VM. Grundlegende Terminalkenntnisse reichen aus; Auswahl, Sortierung und Verknüpfung werden bei der Verwendung erklärt. Du entwickelst keine Anwendung und kein allgemeines Skript.
Verwende Workstation für Dateien und Pickup Preview, um Daten, die echte Liste und Etiketten anzusehen sowie die Übergabe herunterzuladen. Die Vorschau liest nur deine Datei; sie entfernt keine Stornierungen und korrigiert keine Mengen.
Stornierte Bestellungen ausschließen
In diesem Schritt erstellst du die Menge bezahlter, nicht stornierter Bestell-IDs. Beginne in Pickup Preview.
Zuerst die tatsächliche Packentscheidung verstehen
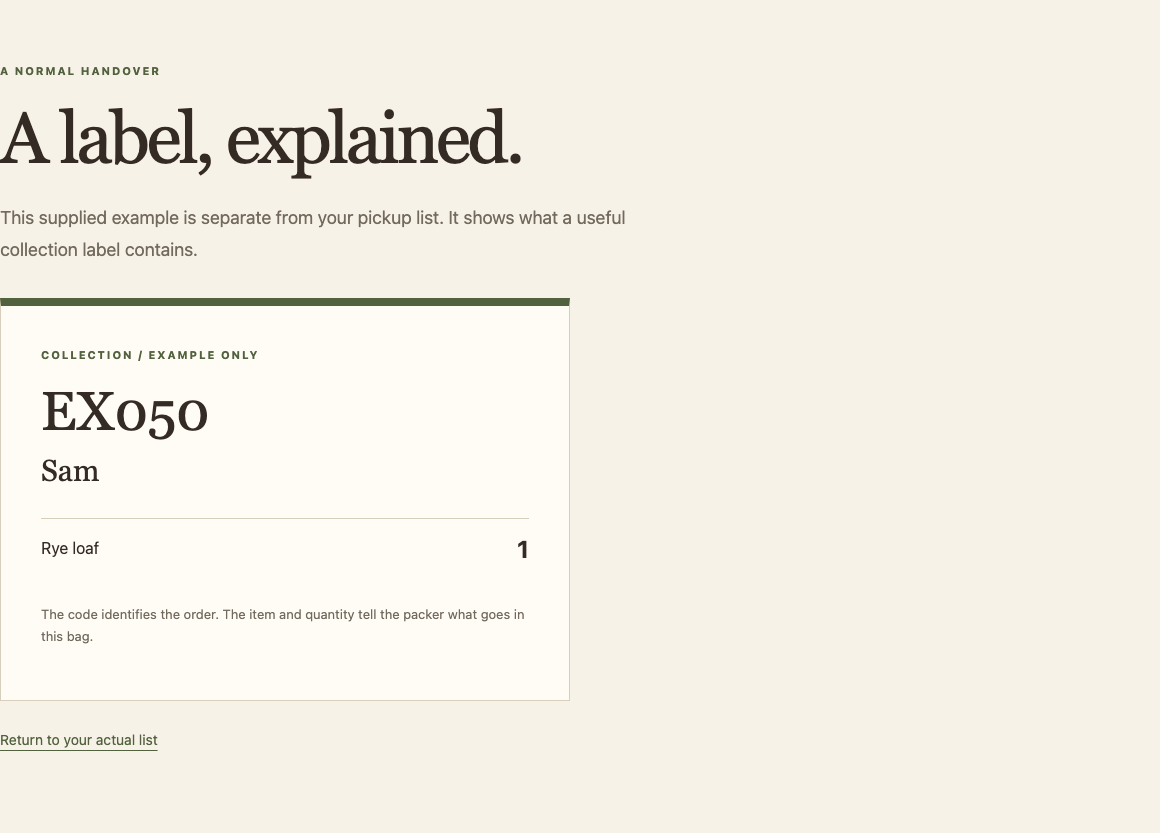
Öffne Sample label, um zu sehen, wie Bestell-ID, Kunde und Artikelmenge ein brauchbares Tütenetikett ergeben. Öffne dann Records. P101 gehört Alex und benötigt zwei Roggenbrote und einen Haferkeks. P102 gehört ebenfalls Alex, ist aber unbezahlt. P103 ist bezahlt und steht in cancellations.tsv. Dafür darf keine Tüte entstehen.
Zahlungen und Stornierungen beantworten verschiedene Fragen. Für diese Abholung ist eine Bestellung nur berechtigt, wenn ihr exakter Status paid lautet und ihre ID nicht in den Stornierungen vorkommt.
Den unabhängigen Arbeitsbereich prüfen
Wechsle zu Workstation. pwd zeigt das aktuelle Verzeichnis; cat zeigt eine Datei:
pwd
/home/labex/project/pickup
cat paid-order-ids.txt
P101
P103
P104
P105
Diese sortierte Datei wird in diesem Lab bereitgestellt. Sie enthält die IDs mit exakt paid, einschließlich P103. Lies die zweite Entscheidungsgrundlage:
cat source/cancellations.tsv
order_id
P103
Lasse source/ unverändert. Dateien unter work/ und dein fertiges pickup-list.tsv darfst du neu erstellen. Wenn du das Verzeichnis wechselst, bringt dich cd /home/labex/project/pickup zurück.
Zwei sortierte Mengen vergleichen
Eine Menge ist hier eine Liste verschiedener IDs. comm vergleicht zwei sortierte Dateien. Die erste Spalte enthält IDs nur aus Eingabe 1, die zweite IDs nur aus Eingabe 2 und die dritte gemeinsame IDs. -23 blendet Spalten 2 und 3 aus. Übrig bleiben IDs aus der ersten Eingabe, die in der zweiten fehlen: genau bezahlte IDs minus stornierte IDs.
LC_ALL=C hält Sortierung und Vergleich in diesem Terminal konsistent. tail -n +2 entfernt die Kopfzeile; sort -u sortiert und entfernt identische ID-Zeilen. Eine Pipe gibt die Ausgabe an den nächsten Befehl weiter. > speichert in einer getrennten Arbeitsdatei und ersetzt sie beim Wiederholen. Verwende nie den Eingabepfad als Ausgabepfad.
export LC_ALL=C
sort -u paid-order-ids.txt > work/paid.sorted.txt
tail -n +2 source/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
cat work/eligible-order-ids.txt
P101
P104
P105
P103 wurde entfernt, die übrigen bezahlten Bestellungen bleiben. Bei einer Warnung über unsortierte Eingaben erstelle beide Mengen mit der oben gezeigten Einstellung neu. Entferne keine Bestellungen aus den Quellen und behandle fehlende Zahlungsinformationen nicht als Erlaubnis zum Packen.
Die Artikelliste erstellen und echte Tütenetiketten öffnen
In diesem Schritt erhältst du alle Produkte und Mengen der berechtigten IDs und nutzt die tatsächliche Übergabe. Beginne in Workstation.
IDs mit sämtlichen Artikelzeilen verbinden
Eine Bestell-ID kann in orders.tsv mehrfach erscheinen. P101 benötigt sowohl rye als auch oat. Drei berechtigte IDs bedeuten nicht drei Stück Brot. Behalte jede ursprüngliche Artikelzeile mit ihrer Menge.
Lies die Tabelle:
cat source/orders.tsv
Die vier tabulatorgetrennten Felder heißen order_id, customer, item, quantity. Die erste Zeile ist die Kopfzeile. tail -n +2 entfernt nur diese. TAB=$(printf '\t') speichert einen Tabulator in einer Shell-Variablen. -t "$TAB" gibt ihn sort und join als Trennzeichen; doppelte Anführungszeichen erhalten ihn als ein Argument. sort -k1,1 -k3,3 sortiert nach Bestell-ID und danach Artikelcode und behält alle vier Felder. Ersetze die Artikeltabelle nicht durch sort -u nur auf dem ID-Feld.
TAB=$(printf '\t')
tail -n +2 source/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join verknüpft die ersten Felder sortierter Eingaben. Die erste enthält berechtigte IDs, die zweite alle Artikelzeilen. Das Standardverhalten mit ausschließlich passenden Zeilen ist hier sinnvoll: Nur berechtigte Bestellungen bleiben und jede zugehörige Artikelzeile wird ausgegeben. Die ID erscheint einmal, gefolgt von Kundenname, Artikel und Menge.
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
cat work/pickup.rows
P101 Alex oat 1
P101 Alex rye 2
P104 Noor oat 2
P105 Jules oat 1
P105 Jules rye 1
Die Abstände oben sind Tabulatoren. Es gibt fünf Artikelzeilen für drei Bestellungen. Prüfe beide unterschiedlichen Artikel und Mengen von P101, bevor du die Datei bereitstellst.
Dem Empfänger ein klares Format geben
Die Leseansicht benötigt dieselbe Kopfzeile mit vier Feldern. printf interpretiert \t als Tabulator und \n als Zeilenumbruch. > beginnt ein neues Ziel; >> hängt an, ohne die Kopfzeile zu löschen. Beide Befehle erneut auszuführen ersetzt die bisherige Übergabe sauber, statt doppelte Zeilen hinzuzufügen.
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
Die Übergabe verwenden, statt nur Summen anzusehen
Wechsle zu Pickup Preview und öffne Pickup list. Lade die Seite neu, falls sie schon geöffnet war. Du solltest 3 collection bags · 5 item lines · 7 pieces sehen. Diese Summen helfen bei der Fehlersuche, beweisen aber nicht die richtigen Inhalte für jede Person.
Öffne Alex’ Etikett P101. Es muss Oat cookie 1 und Rye loaf 2 zeigen. Folge All collection bags, öffne P104 und bestätige Oat cookie 2 für Noor; P105 gibt Jules Oat cookie 1 und Rye loaf 1. P102, P103 und P106 dürfen keine Tüte haben. Kundennamen allein belegen diese Beziehungen nicht.
Öffne mit Print label den Druckdialog, wenn dein Browser dies unterstützt, und brich nach der Vorschau ab. Ein physischer Drucker ist nicht nötig. Kehre zur Liste zurück und wähle Download the actual list. Der Download enthält deine TSV-Datei und keine vorberechnete Referenz.
Erklärt die Vorschau einen Formatfehler, prüfe Kopfzeile und Tabulatoren in Workstation, erstelle die Datei neu und lade die Seite erneut. Bei falschen Mengen vergleiche work/pickup.rows mit den ursprünglichen Bestellungen. Die Leseansicht behebt Fehler nicht heimlich.
Eine späte Bestellung ohne doppelte frühere Tüten aufnehmen
In diesem Schritt baust du die Übergabe aus einem vollständigen überarbeiteten Eingabestand neu auf. Beginne in Workstation mit den bisherigen Shell-Einstellungen.
Die neue Eingabe verstehen
Die ursprünglichen Dateien unter source/ bleiben unverändert. source/late/ enthält einen vollständigen späteren Stand aller drei Tabellen, nicht nur einige Zeilen zum Anhängen. Die neue bezahlte Bestellung P107 gehört Aya und benötigt zwei Haferkekse. Die frühere Stornierung gilt weiter.
cat source/late/orders.tsv
cat source/late/payments.tsv
Das bereitgestellte paid-order-ids.txt beschreibt den ursprünglichen Stand. Berechne für die neue Bestellung eine neue bezahlte Menge aus der späteren Zahlungstabelle. grep $'\tpaid$' wählt einen Tabulator mit dem vollständigen Status am Zeilenende und vermeidet unpaid; cut -f1 behält die Bestell-ID. sort -u bereitet die Menge für den Vergleich vor. Verwende LC_ALL=C und TAB aus den vorherigen Schritten; stelle sie hier nach einer Terminal-Neuverbindung wieder her.
export LC_ALL=C
TAB=$(printf '\t')
tail -n +2 source/late/payments.tsv | grep $'\tpaid$' | cut -f1 | sort -u > work/paid.sorted.txt
tail -n +2 source/late/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
Du hast dieselbe Regel auf einen neuen vollständigen Datenstand angewendet. Erstelle nun die passende Artikeleingabe und das Ziel neu:
tail -n +2 source/late/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
Jetzt sollten sechs Artikelzeilen vorliegen: die früheren fünf plus P107/Aya/oat/2. Die Kopfzeile erscheint einmal. Aus dem vollständigen Stand neu aufzubauen bedeutet, nicht alle alten Zeilen erneut anzuhängen.
Die tatsächliche neue Übergabe prüfen
Wechsle zu Pickup Preview, öffne Pickup list und lade neu. Erwarte 4 collection bags · 6 item lines · 9 pieces. Öffne P107 und bestätige Ayas zwei Oat cookie. Öffne P101 erneut und prüfe die zwei weiterhin richtigen Produktzeilen. Die stornierte P103 und unbezahlte P102 haben immer noch keine Etiketten.
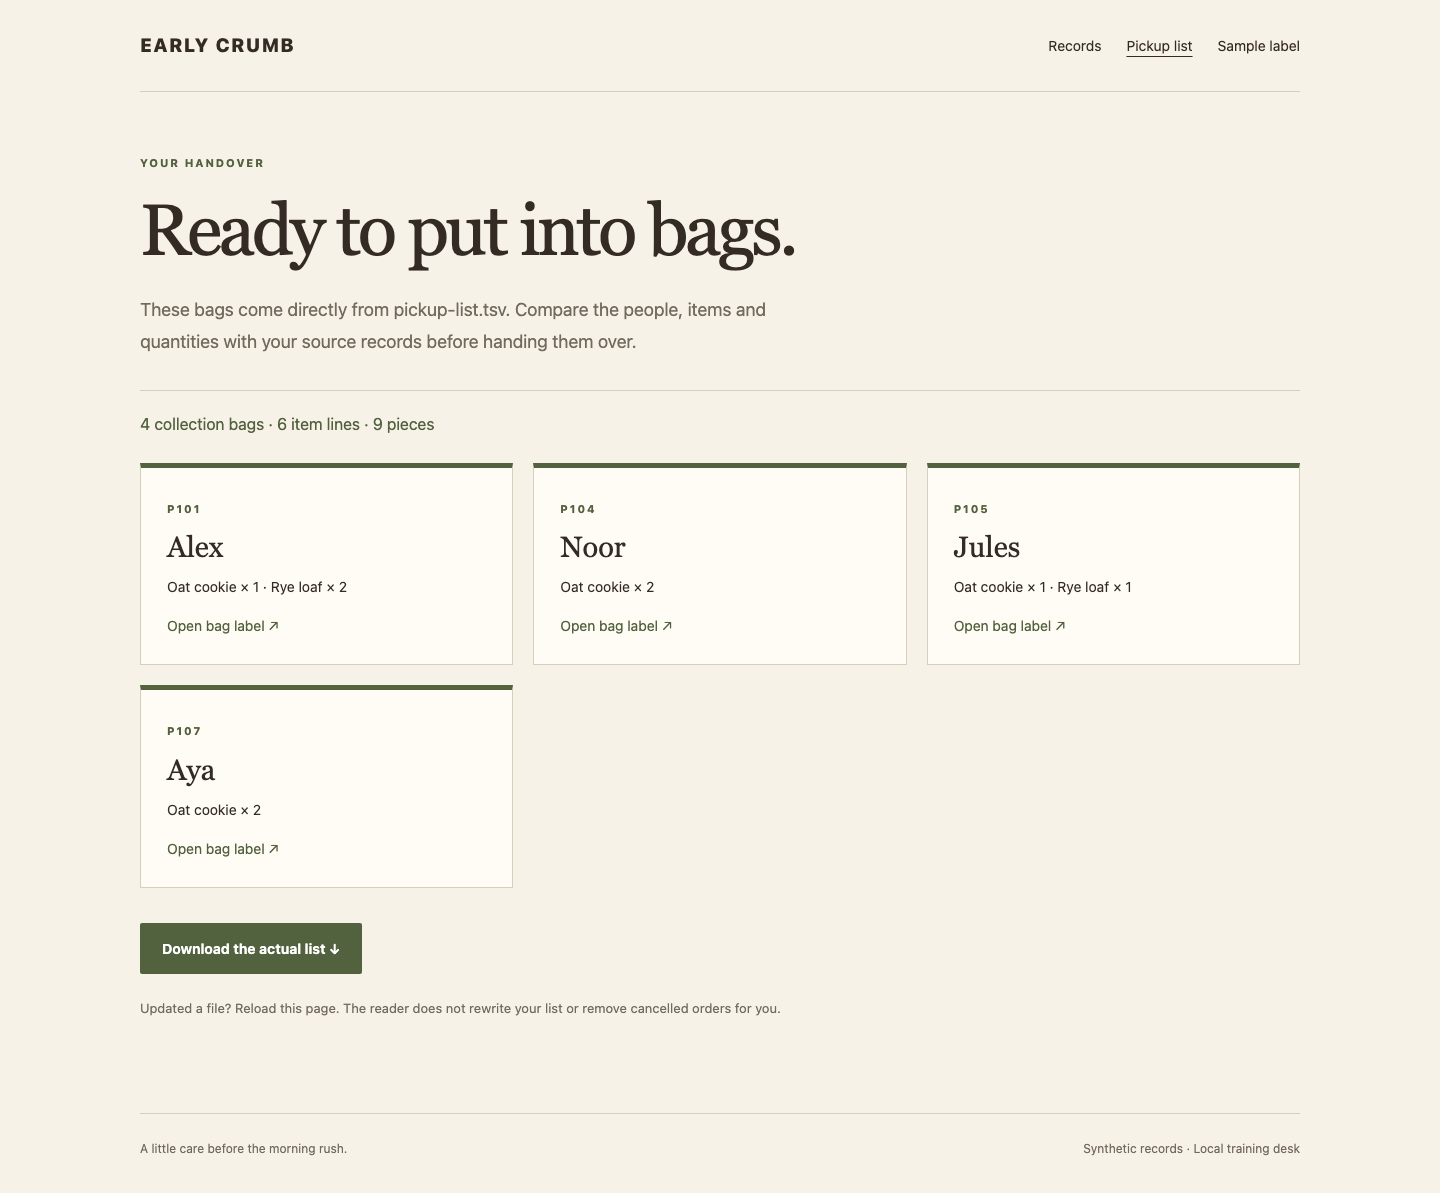
Lade die tatsächliche Liste erneut herunter und vergleiche sie mit der überarbeiteten Übergabe. Records behält absichtlich den ursprünglichen Stand als Kontext; die späteren Eingaben liegen unter source/late/. Eine alte Browserseite ist kein Beleg für fehlgeschlagene Befehle: Lade vor dem Vergleich neu.
Haben sich die Summen verdoppelt, prüfe die zwei Schreibbefehle: > muss eine neue Kopfzeile erzeugen, bevor >> die aktuellen Zeilen anhängt. Fehlt P107, prüfe, ob Zahlungen und Artikel aus source/late/ stammen. Korrigiere die Arbeitsdateien und erstelle das Ziel neu; trage nicht die erwartete Summe anstelle echter Bestellzeilen ein.
Zusammenfassung
Du hast sortierte ID-Mengen verglichen, berechtigte Bestellungen mit allen Artikelzeilen verbunden und eine echte Abholliste samt Tütenetiketten erstellt. Dasselbe Vorgehen hast du auf einen vollständigen späteren Datenstand angewendet, ohne frühere Tüten zu duplizieren. Die unabhängige Workshop-Challenge nutzt dieselben Methoden mit anderen Berechtigungsbeziehungen und Materialien.


