



Einführung
EARLY CRUMB bereitet die Brot-Abholung am Samstag vor. Bestellungen, Zahlungen und Stornierungen werden getrennt erfasst. Zwei Kunden haben denselben Namen und eine Bestellung kann mehrere Produkte enthalten. Eine brauchbare Übergabe beginnt damit, die richtigen Datensätze zu verbinden, statt anhand von Namen zu raten.
In diesem Lab bereitest du Bestell- und Zahlungstabellen vor, ordnest jeder Bestell-ID ihren Zahlungsstatus zu und erstellst eine Liste der bezahlten IDs. Stornierungen behandelt das nächste unabhängige Lab. Grundlegende Terminalkenntnisse reichen aus; Tabulatoren, Felder, Sortierung und Befehle werden vor ihrer Verwendung erklärt. Alle Personen und Daten sind erfunden.
Verwende Workstation für Befehle und Pickup Preview für die vorbereitete Abholansicht. Sie zeigt Quelldaten und ein Beispieletikett. Sie berechnet keine Antworten und erstellt deine Dateien nicht.
Tabellen für die Zuordnung vorbereiten
In diesem Schritt bereitest du Datensätze ohne Kopfzeile und eine sortierte Liste der Bestell-IDs vor, ohne Artikelzeilen zu verlieren. Beginne in Pickup Preview.
Die Übergabe verstehen
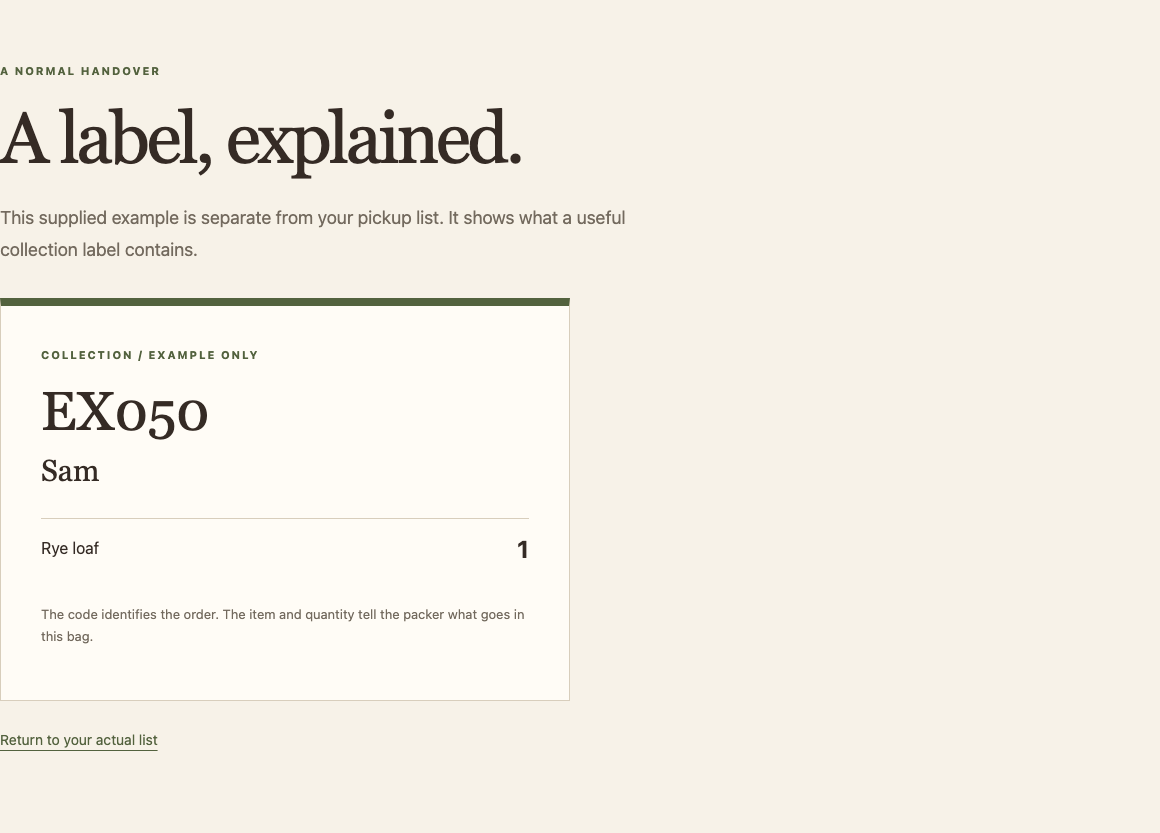
Öffne Sample label. EX050 gehört Sam und enthält ein Roggenbrot. Das ist ein separates Beispiel und nicht deine fertige Abholliste. Die Bestellnummer kennzeichnet eine Tüte, der Name hilft dem Kunden beim Wiedererkennen und Artikel mit Mengen sagen der packenden Person, was hineingehört.
Öffne Records. Der Artikelschlüssel ordnet rye dem Rye loaf und oat dem Oat cookie zu. Suche P101 in orders.tsv: Alex bestellt zwei Roggenbrote und einen Haferkeks. P102 gehört ebenfalls zu Alex, ist aber eine andere Bestellung mit Status unpaid. Eine Namenszuordnung würde die falsche Tüte mit der falschen Bestellung verbinden. Verwende order_id.
Die vorbereiteten Dateien lesen
Wechsle zu Workstation, das in /home/labex/project/pickup startet. pwd zeigt das aktuelle Verzeichnis; ls listet dessen Einträge:
pwd
/home/labex/project/pickup
ls
Du solltest source und work sehen. Quelldaten bleiben unverändert; work/ enthält Zwischendateien, die du neu erstellen darfst. Ein Pfad wie source/orders.tsv ist relativ zu diesem Verzeichnis. Wenn du es verlässt, kehre so zurück:
cd /home/labex/project/pickup
cat zeigt eine Datei. Lies beide Tabellen:
cat source/orders.tsv
cat source/payments.tsv
TSV bedeutet tabulatorgetrennte Werte. Jede Zeile ist ein Datensatz; Tabulatoren trennen die Felder. Die erste Zeile ist die Kopfzeile. Die vier Bestellfelder sind Bestell-ID, Kunde, Artikel und Menge. Eine Bestellung kann mehrere Artikelzeilen haben. Zahlungen besitzen zwei Felder: Bestell-ID und den exakten Status paid oder unpaid. Pro Bestellung gibt es höchstens einen Zahlungseintrag. Das vorbereitete Format enthält keine Tabulatoren oder Zeilenumbrüche innerhalb eines Wertes.
P106 steht in den Bestellungen, hat aber keinen Zahlungseintrag. Fehlende Information bedeutet nicht bezahlt. Beim Zuordnen machst du diesen Fall sichtbar.
Kopfzeilen und Datensätze trennen
tail -n +2 gibt ab Zeile 2 aus. > speichert die Ausgabe in einer Datei und ersetzt das Ziel, falls es bereits existiert. Die Quelle bleibt unverändert. Verwende mit > niemals denselben Eingabe- und Ausgabepfad: Die Shell würde die Datei vor dem Lesen leeren.
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
Prüfe die Artikelzeilen:
cat work/orders.rows
P101 und P105 kommen jeweils zweimal vor, weil sie je zwei Produkte enthalten. Behalte diese Zeilen. Eine wiederholte Bestell-ID ist nicht automatisch ein doppelter Datensatz.
Die Zuordnungsschlüssel vorbereiten
Ein Schlüssel ist das Feld, das Datensätze verbindet. cut -f1 wählt das erste tabulatorgetrennte Feld. Eine Pipe | leitet die Ausgabe an den nächsten Befehl. sort -u sortiert Zeilen und behält jede identische Zeile nur einmal. Hier gilt das nur für die ID-Liste, nicht für die Artikeltabelle.
Sortieren und Zuordnen müssen dieselbe Reihenfolge verwenden. LC_ALL=C wählt eine vorhersehbare Byte-Reihenfolge; export stellt sie nachfolgenden Befehlen bereit. Diese Einstellung gehört zum aktuellen Terminal. Setze sie erneut, wenn du ein neues öffnest.
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
Sortiere die zweispaltige Zahlungstabelle nach dem ersten Feld und erhalte den Status. TAB ist eine Shell-Variable mit einem Tabulator: printf '\t' gibt ihn aus, $(...) erfasst die Ausgabe. Die Anführungszeichen in "$TAB" übergeben ihn als ein einzelnes Trennzeichenargument. -t legt das Feldtrennzeichen fest; -k1,1 wählt ausschließlich Feld 1 als Sortierschlüssel.
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
Erwarte P101 bis P105 in Reihenfolge, jeweils mit dem ursprünglichen Status. P106 hat dadurch keinen Zahlungseintrag erhalten. Nun sind sechs unterschiedliche IDs und alle fünf Zahlungen zum Zuordnen vorbereitet. Falls Kopfzeile oder Status falsch sind, erstelle nur die betreffende Arbeitsdatei neu aus ihrer Quelle; ändere nicht die Quelle passend zum Ergebnis.
Jeder Bestellung ihren Zahlungsstatus zuordnen
In diesem Schritt verbindest du die beiden vorbereiteten Eingaben und behältst Bestellungen ohne Zahlung sichtbar. Beginne in Workstation im selben Terminal wie in Schritt 1.
Die Bedeutung der Zuordnung festlegen
P101 muss paid, P102 unpaid und P106 dem ausdrücklichen Wert missing entsprechen. Namen sind an der Zuordnung nicht beteiligt. Auch eine bezahlte Bestellung kann storniert sein; die Zahlungszuordnung allein entscheidet noch nicht über die fertige Abholliste.
join verbindet standardmäßig die ersten Felder sortierter Eingaben. Ein gewöhnlicher Inner Join lässt IDs ohne Treffer weg. Hier sollen auch diese Datensätze sichtbar bleiben:
-t "$TAB"verwendet den Tabulator aus Schritt 1.-a 1behält zusätzlich unzugeordnete Datensätze aus Eingabe 1, der vollständigen ID-Liste.-e missingsetzt das Wortmissingfür ein fehlendes Ausgabefeld ein.-o 1.1,2.2gibt Feld 1 aus Eingabe 1, die Bestell-ID, und danach Feld 2 aus Eingabe 2, den Status, aus.1und2bezeichnen Eingabedateien, keine Zeilennummern.
Führe den vollständigen Befehl in einer Zeile aus. Er schreibt ein zweispaltiges Ergebnis:
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
Die sichtbaren Abstände stehen für Tabulatoren, nicht für die wörtlichen Zeichen Backslash und t. Es sollten sechs Zeilen erscheinen. P106 bleibt enthalten, weil die linke Eingabe alle IDs umfasst und -a 1 nicht zugeordnete IDs erhält.
Das Ergebnis vor dem Filtern lesen
P101 und P102 heißen in der Quelle beide Alex, haben jedoch verschiedene Statuswerte. P103 ist ebenfalls bezahlt; eine Stornierung kann es später ausschließen. P106 besitzt keine Zahlung. missing verhindert, dass dieser Fall unbemerkt aus dem Vergleich verschwindet.
Meldet join eine unsortierte Eingabe, kehre zu Schritt 1 zurück und erstelle beide sortierten Eingaben mit demselben LC_ALL=C neu. Unterdrücke die Warnung nicht und entferne keine unbequeme Bestellung. Nach einer Terminal-Neuverbindung stelle Verzeichnis und beide Shell-Einstellungen aus Schritt 1 wieder her, bevor du es erneut versuchst.
Ein erfolgreich beendeter Befehl allein reicht nicht. Vergleiche die drei wichtigen Zeilen mit ihren Quelldaten. Jetzt besitzt du eine vollständige Zahlungszuordnung für die nächste Entscheidung.
Bezahlte Bestellungen mit ihrer Identität auswählen
In diesem Schritt erstellst du die Datei bezahlter IDs und siehst dir genau an, was du gespeichert hast. Beginne in Workstation.
Einen vollständigen Status erkennen
Sowohl paid als auch unpaid enthalten die Buchstaben paid. Eine ungenaue Suche würde P102 fälschlich aufnehmen. Gesucht ist ein Tabulator mit dem vollständigen Status am Zeilenende.
grep wählt passende Zeilen. Bei $'\tpaid$' macht die äußere Schreibweise $'...' aus \t einen Tabulator; das letzte $ innerhalb des Ausdrucks steht für das Zeilenende. Das Statusfeld muss somit genau paid sein, statt nur auf das Ende von unpaid zu passen. cut -f1 behält danach die IDs. Die Ausgabe ist bereits sortiert, weil die zugeordnete Tabelle sortiert ist.
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 ist unbezahlt und P106 fehlt in den Zahlungsdaten, daher gehört keine der beiden IDs hinein. Behalte P103 vorerst: Die Datei steht für bezahlte Bestellungen, nicht für die endgültig zu packenden Bestellungen. P103 vor der Stornierungsprüfung zu entfernen, würde zwei Entscheidungen vermischen und das Zwischenergebnis irreführend machen.
Die gespeicherte Auswahl lesen
Wechsle zu Pickup Preview und wähle Payment IDs in der Navigation. Die Seite zeigt paid-order-ids.txt, ohne eine Zahlungsantwort zu berechnen. Du solltest die vier gespeicherten IDs sehen. Folge Compare with source records und prüfe die dazugehörigen Zahlungen.
Pickup list kann weiterhin melden, dass noch keine Liste zum Packen vorliegt. Das ist richtig: Du hast eine Zahlungsauswahl erstellt, noch keine endgültige Artikelliste. Das nächste unabhängige Lab nutzt sie, um Stornierungen auszuschließen und alle berechtigten Artikelmengen zu erhalten.
Ist die Datei leer oder enthält sie P102, prüfe work/payment-match.tsv und das genaue Statusmuster und führe den Filter erneut aus. Du kannst das Ergebnis ohne Änderungen an den Quelldaten korrigieren und neu erstellen.
Zusammenfassung
Du hast tabulatorgetrennte Datensätze vorbereitet, nach einem gemeinsamen Schlüssel sortiert, Zahlungen unter Erhalt fehlender Einträge zugeordnet und exakte bezahlte Statuswerte ausgewählt. Dabei hast du Bestellidentität, Kundennamen und Artikelzeilen getrennt betrachtet. Das nächste unabhängige Lab macht aus dieser Auswahl eine brauchbare Abholübergabe.


