Einführung
Im Meridian Museum finden Besucher Objekte nach Material und Geschichte. Die Startseite kann schon antworten, bevor die Sammlungssuche nutzbar ist. Jeder neue Suchcontainer importiert zwölf bereitgestellte Datensätze in einen Wortindex im Arbeitsspeicher. Die Daten werden absichtlich verzögert eingelesen, damit Sie das Laden beobachten können. Jeder Ersatzcontainer baut seinen eigenen Index von Anfang an auf.
Sie halten ladende Pods vom Besucherservice fern, geben dem Start genügend Zeit und aktualisieren den Importer, während vorhandene Replikate weiterhin korrekte Suchergebnisse liefern. Grundlegende Terminalkenntnisse und Vertrautheit mit Container-Images und laufenden Containern werden vorausgesetzt. Kubernetes-Objekte, YAML-Patches und Probe-Einstellungen werden hier eingeführt. Cluster, zwischengespeichertes Museumsimage und vollständige Website sind vorbereitet; Installation, externes Konto und Anwendungsprogrammierung sind nicht erforderlich.
Nutzen Sie Museum für den Besucherweg und Workstation für Befehle. Arbeiten Sie nur im Namespace meridian und im bereitgestellten Museumsverzeichnis. Dieser Lerncluster mit einem Knoten belegt weder Hochverfügbarkeit noch garantiert er ausschließlich erfolgreiche Anfragen. Jedes Lab beginnt unabhängig.
Besucher nur an durchsuchbare Pods weiterleiten
In diesem Schritt unterscheiden Sie einen laufenden Prozess von einem nutzbaren Suchindex und ergänzen Readiness für die tatsächliche Besucheraufgabe. Beginnen Sie in Museum.
Den normalen Besucherweg ausprobieren
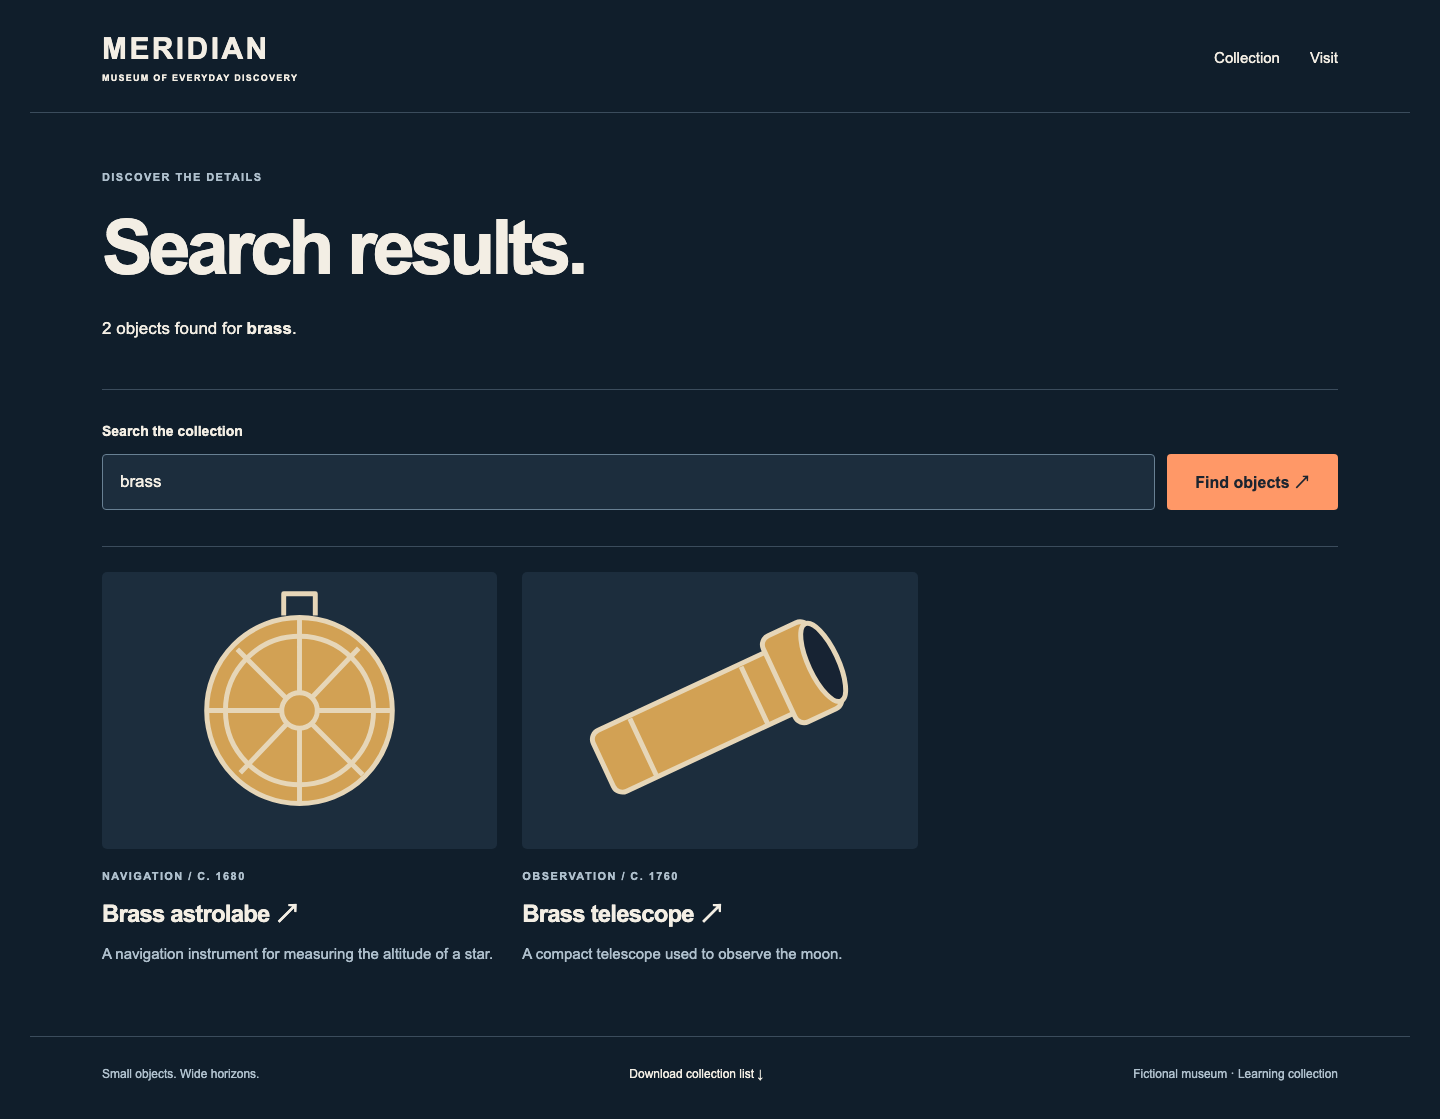
Geben Sie brass in Search the collection ein und wählen Sie Find objects ↗. Die Ergebnisse müssen Brass astrolabe und Brass telescope sowie 2 objects found zeigen. Öffnen Sie Brass astrolabe: Geschichte, Abbildung und Standort Gallery 1 erscheinen. Wählen Sie See it at the museum ↗, lesen Sie Öffnungszeiten und Hinweise zum ebenerdigen Eingang, dann Download collection list ↓. Öffnen Sie die heruntergeladene CSV: Sie enthält zwölf Objekte einschließlich beider Messinginstrumente. Über MERIDIAN gelangen Sie zur Startseite. Diese Funktionen müssen Ihre Änderungen überstehen.
Die drei Kubernetes-Objekte kennenlernen
Wechseln Sie zu Workstation. pwd zeigt das aktuelle Verzeichnis, ls dessen Dateien:
pwd
ls
Das Verzeichnis lautet /home/labex/project/museum. Ein Pod führt den Museumscontainer aus. Ein Deployment hält zwei Replikat-Pods vor und ersetzt sie, wenn sich seine Containervorlage ändert. Ein Service stellt Besuchern eine feste Adresse bereit und leitet zu ausgewählten bereiten Pods weiter. Labels verbinden diese Objekte: Der Service wählt Pods mit app: search. Ein Namespace gruppiert die Kursobjekte; alle folgenden Befehle nennen meridian ausdrücklich.
kubectl fordert den Cluster zum Lesen oder Ändern von Objekten auf. get listet sie auf, -n wählt den Namespace. cat zeigt eine Textdatei an, damit Sie den vorbereiteten Kandidaten lesen können:
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML verwendet key: value, Leerzeichen zur Einrückung und - für Listeneinträge. Unter spec.template verwendet der Container das gespeicherte Image meridian-museum:1. imagePullPolicy: Never verlangt dieses vorbereitete Image ohne Registry-Download. IMPORT_INTERVAL: "2" lässt zwei Sekunden zwischen Datensätzen: Zwölf Datensätze benötigen etwa 24 Sekunden. Die ursprünglichen Besucherreplikate nutzten ein kurzes Intervall, damit Sie zuerst die normale Suche erleben konnten.
Das vorbereitete Rolling Update behält replicas: 2, erlaubt einen zusätzlichen Kandidaten (maxSurge: 1) und kein nicht verfügbares vorhandenes Replikat (maxUnavailable: 0). Das setzt ehrliche Readiness voraus: Ohne Probe kann ein laufender Prozess bereits als geeignet gelten, bevor die Suche funktioniert. Behalten Sie Einstellungen, Images, Labels und Service unverändert bei.
Verfrühten Traffic im Lernservice beobachten
Der Browser verwendet HTTP, ein Anfrage-Antwort-Protokoll. Status 200 bedeutet Erfolg; 503 heißt, dass der Server diese Anfrage vorübergehend nicht bedienen kann. Eine funktionierende Startseite beweist nicht, dass eine andere Anfrage wie die Suche erfolgreich ist.
Dieses Museum hat keine echten Kunden. Sie demonstrieren absichtlich das unsichere Update, bevor Sie es verbessern. cp kopiert den Kandidaten in Ihre bearbeitbare Datei search.yaml. apply -f übermittelt das YAML der Datei; die geänderte Pod-Vorlage startet ein Update. python3 führt den bereitgestellten, nur lesenden Beobachter aus; --seconds 30 erfasst den echten Besucherservice 30 Sekunden lang. Er prüft beide Messingobjekte in der Suchantwort. Starten Sie Update und Beobachter gemeinsam:
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
Während ungeschützte neue Container laden, erwarten Sie einige Zeilen HTTP=503 correct_search=false. Die genaue Zahl variiert. Die Startseite funktioniert weiter; die Suchantwort mit 503 erklärt, dass die Sammlung vorbereitet wird. Das ist eine echte Antwort eines ladenden Pods, keine vorgefertigte Erfolgs- oder Fehleranimation.
rollout status wartet auf das Update dieses Deployments; --timeout begrenzt die Wartezeit:
kubectl rollout status deployment/search -n meridian --timeout=90s
Der Befehl kann Erfolg melden, obwohl keine Readiness-Probe die vorangegangene Ladephase geschützt hat. Warten Sie auf normale brass-Ergebnisse, bevor Sie fortfahren. Falls statt HTTP-Status ein Verbindungsfehler erscheint, lesen Sie die Pod-Tabelle und versuchen es erneut: Ein fehlender Server unterscheidet sich von einem Server mit Antwort 503.
Eine fachliche Readiness-Prüfung hinzufügen
Eine Readiness-Probe prüft, ob dieser Pod Service-Traffic erhalten soll. Ein Fehlschlag entzieht die Eignung, startet den Container aber nicht neu. /health/process bestätigt bei diesem Image immer den HTTP-Prozess, während /ready/search erst dann 200 liefert, wenn alle zwölf Datensätze indexiert sind und die bekannte brass-Suche funktioniert. Auch die Browser-Startseite liefert beim Import 200; weder sie noch der Prozess-Endpunkt sind hier geeignet.
patch ändert ausgewählte Felder. --patch-file liest Ihre Datei; --type=strategic führt den benannten Container search zusammen und erhält die übrigen Einstellungen. Die Probe sendet HTTP an den benannten Port http dieses Pods, prüft alle zwei Sekunden und markiert ihn nach einem Fehlschlag als nicht bereit. Schreiben Sie folgenden kleinen Patch. cat > readiness.yaml ersetzt die Datei. <<'YAML' beginnt ein wörtliches Here-Dokument: Fügen Sie den gesamten Block ein, einschließlich des abschließenden YAML allein in seiner Zeile. Behalten Sie die Einrückung:
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
Korrekte Suchen sollen über vorhandene Replikate weiterlaufen, während das neue Replikat importiert.
Ein EndpointSlice verzeichnet die tatsächlichen Pod-Adressen und deren Readiness für den Service. -l filtert nach dem Service-Namenslabel; -o jsonpath wählt nur Adresse und ready aus der strukturierten Antwort. Der bereitgestellte Ausdruck durchläuft Endpunktdatensätze und zeigt diese Felder an; er liest nur den Zustand. Prüfen Sie Pods und Service-Adressen:
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
Beim Import sehen Sie möglicherweise einen neuen Pod mit 0/1 Running und eine Adresse mit ready=false. Vorhandene bereite Endpunkte bedienen weiter Suchen. Nach dem Laden wird der Kandidat bereit und der Austausch geht weiter. Wenn Sie den kurzen Zwischenzustand verpassen, bieten die nächsten Schritte mehr Beobachtungszeit.
Schließen Sie mit genau zwei Pods 1/1 Running ab. Ein alter Pod mit Terminating kann nach erfolgreichem Rollout kurz verbleiben; warten Sie und wiederholen Sie get pods, bis er verschwunden ist. Wiederholen Sie in Museum brass-Suche und Astrolabium-Detail. Bei einem YAML-Fehler korrigieren Sie den Patch und wenden ihn erneut an. Bei einem falsch geschriebenen Probe-Pfad ersetzen Sie nur den Pfad im selben Patch und wenden ihn erneut an. Löschen Sie keine anderen Namespaces und verkürzen Sie den Import nicht, um Fehler zu verbergen.
Dem Importer genügend Startzeit geben
Sie unterscheiden Readiness-Warten von Startfehlern und bemessen das Startbudget anhand des tatsächlichen Imports. Beginnen Sie in Workstation.
Eine Startup-Probe begrenzt, wie lange ein neuer Container zur Initialisierung brauchen darf. Solange sie nicht erfolgreich war, hält Kubernetes Readiness-Prüfungen zurück. Erreichen die Startfehler den Schwellenwert, startet kubelet den Container neu. Eine Startup-Probe ist optional; eine zu knapp bemessene kann eine sonst funktionierende Anwendung dauerhaft unbereit halten. Nach erfolgreichem Start ersetzt sie Readiness nicht.
Ein zu kleines Budget beobachten
startup-short.yaml ist ein bereitgestelltes Lernbeispiel. Eine fehlgeschlagene Startup-Probe fordert einen Neustart an, doch das Beenden kann den sichtbaren Anstieg des Neustartzählers verzögern. Die nächste Client-Wartezeit dauert 60 Sekunden, um diesen Unterschied zu beobachten. Lesen Sie das Beispiel vor dem Anwenden:
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
Der Rollout-Befehl soll mit error: timed out waiting for the condition fehlschlagen. Sein tatsächlicher Exit-Status ist ungleich null. Fahren Sie im interaktiven Terminal fort. Das Beispiel prüft alle zwei Sekunden und erlaubt nur zwei Fehlschläge, also ungefähr vier Sekunden Startzeit. Das reicht nicht für den 24-sekündigen Import.
Lesen Sie die Live-Belege. logs zeigt Anwendungsausgaben; --prefix kennzeichnet jeden Pod, --tail=4 begrenzt jedes Log auf die letzten vier Zeilen. Ein Selektor fordert alle Such-Pods an. get events liest Clusterbeobachtungen; --field-selector reason=Unhealthy grenzt sie auf fehlgeschlagene Gesundheitsprüfungen ein:
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
Der neue Pod bleibt unbereit und RESTARTS sollte steigen. Möglicherweise erscheint CrashLoopBackOff: Kubernetes verzögert damit einen weiteren Neustartversuch. Zeigt die Tabelle trotz protokollierter Startfehler noch null, warten Sie und wiederholen vor einer Budgetänderung get pods: Die Tabelle ist eine Momentaufnahme, und das Beenden benötigt Zeit. Jeder Neustart verwirft den Index dieses Containers im Arbeitsspeicher; der Ersatz importiert alle Datensätze erneut.
Eine späte Zeile index_complete von einem Container mit bereits fehlgeschlagener Startup-Prüfung hebt dessen ausstehenden Neustart nicht auf und macht ihn nicht zu einem bereiten Service-Backend. Betrachten Sie Neustartzähler und Startfehler-Ereignisse gemeinsam. Ältere Pods bleiben 1/1 und bedienen ihre vollständigen Indizes.
Suchen Sie in Museum nach brass. Über den Service kommen weiter korrekte Ergebnisse von vorhandenen bereiten Replikaten. Das blockierte Update wurde nicht automatisch zurückgerollt: Das Deployment fordert weiterhin den fehlerhaften Kandidaten an. Erhaltene alte Bedienung ist kein abgeschlossenes Update.
Ein sinnvolles Budget berechnen und anwenden
Wechseln Sie zu Workstation. Zwölf Datensätze zu je zwei Sekunden benötigen etwa 24 Sekunden. Verwenden Sie hier 60 Sekunden; das deckt auch den nächsten 36-sekündigen Import und zwölf Sekunden Lehrreserve ab. periodSeconds × failureThreshold ist eine Planungsnäherung, keine Fristgarantie; Scheduling, Probe-Zeitüberschreitungen und reale Last führen zu Abweichungen. Messen Sie in Produktion den Start und wählen Sie bewusst eine Reserve.
Verwenden Sie dieselbe Patch-Dateimethode. Behalten Sie den echten fachlichen Pfad und den benannten Port:
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
Dadurch entstehen Ersatz-Pods mit korrigierten Startup-Einstellungen. Jeder soll ohne Neustart fertig laden; die finale Tabelle muss zwei Pods 1/1 Running mit RESTARTS 0 enthalten. Warten Sie, bis beendende alte Pods verschwunden sind, und wiederholen bei Bedarf die Tabelle. Readiness steuert nach erfolgreichem Start weiter den Traffic.
Wenn das Update weiter stockt, lesen Sie dieselben Logs und Events, vergleichen Pfad und Budget Ihrer Datei, korrigieren sie und wenden erneut an. Pods zu löschen korrigiert die Deployment-Vorlage nicht; sie würden mit denselben fehlerhaften Einstellungen neu erzeugt. Unterscheiden Sie das 60-sekündige Probe-Budget von --timeout=120s, das nur die Client-Wartezeit auf den Rollout begrenzt.
Die Suche bei einem langsameren Update verfügbar halten
Sie wenden einen langsameren Import an und beurteilen das Update anhand von Service-Antworten und bereiten Endpunkten. Beginnen Sie in Workstation.
kubectl set env ändert eine Umgebungsvariable in der Containervorlage des Deployments. Das startet Ersatz-Pods; die Umgebung bereits laufender Container bleibt unverändert. Stellen Sie das Intervall auf drei Sekunden. Zwölf Datensätze benötigen nun etwa 36 Sekunden und liegen weiterhin im Startbudget von 60 Sekunden:
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
Der neue Pod sollte beim Import 0/1 Running zeigen. Vorhandene bereite Adressen liefern weiterhin korrekte brass-Ergebnisse. Der Beobachter verwendet denselben NodePort-Service wie Museum; er wählt nie gezielt einen bestimmten gesunden Pod. Im beobachteten Lauf blieben geschützte Anfragen korrekt. Eine endliche Stichprobe kann für reale Netzwerk-, Anwendungs- und Clusterbedingungen keine ausschließlich erfolgreichen Anfragen versprechen.
Warten Sie auf das vollständige Update und prüfen Sie den Endzustand:
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
Sobald jeder alte Pod mit Terminating verschwunden ist, müssen genau zwei aktuelle Pods ohne Neustarts bereit sein und ihre beiden Endpunktadressen ready=true zeigen. Ein gesundes altes Replikat ist beim Import nützlich, doch ein finaler Rollout muss wirklich zur neuen Revision konvergieren.
Den gesamten Besucherservice prüfen
Kehren Sie in Museum über MERIDIAN zur Startseite zurück und suchen Sie erneut brass. Beide Instrumente müssen erscheinen; öffnen Sie das Teleskop und folgen Sie seinem Besuchslink. Suchen Sie volcano: Die Seite soll ohne Fehler melden, dass keine Objekte gefunden wurden. Öffnen Sie Collection, betrachten Sie ein Objekt ohne Messing und laden Sie die Sammlungsliste von Visit herunter. Prüfen Sie zwölf Objekte sowie erhaltene Abbildungen und Navigation.
Wechseln Sie zu Workstation. curl ruft eine URL ab; -sS unterdrückt Fortschritt, zeigt aber Verbindungsfehler. 127.0.0.1 bezeichnet diese Lerninstanz und Port 30081 gehört zum echten Museumsservice. Anführungszeichen halten die Such-URL als ein Shell-Argument zusammen:
curl -sS 'http://127.0.0.1:30081/search?q=brass'
Lesen Sie die beiden korrekten Titel im HTML, nicht nur einen HTTP-Erfolgscode. Läuft eine Prüfung während alte Pods noch beendet werden, warten Sie und wiederholen sie; entfernen Sie keine Probes und verkürzen Sie den Import nicht. Bewahren Sie Cluster, bereitgestelltes Image, Service und zwölf Quelldatensätze. Ihr Endergebnis verbindet eine ehrliche fachliche Readiness-Prüfung, ausreichende Startzeit und ein abgeschlossenes Update, das das Museumserlebnis erhält.
Zusammenfassung
Sie haben Readiness an einen echten Sammlungsindex gekoppelt, den Fehlschlag und Neustart eines Kandidaten mit zu kleiner Startup-Probe beobachtet und eine sinnvolle Startzeit berechnet. Sie haben den getakteten Importer aktualisiert, während vorhandene bereite Replikate Suchen bedienten, und anschließend aktuelle Pods, Service-Endpunkte und den vollständigen Besucherweg geprüft. Ein laufender Prozess, ein bereites Backend und ein abgeschlossenes Update sind verschiedene Tatsachen; diese Übung mit einem Knoten belegt weder Produktionshochverfügbarkeit noch Fehlerfreiheit.