Einführung
Field Notes hat eine teilweise aufbereitete Galerie. Eine Gruppe erhielt von ihrer Quelle vorübergehend HTTP 503, während die anderen Gruppen fertig wurden. Du bewahrst diese vorhandenen Fehlerbelege auf, führst einen neuen Job mit einer kleinen Anzahl erlaubter Wiederholungen aus und lieferst die vollständige Sammlung, ohne die bereits korrekten JPEGs neu zu schreiben.
Diese unabhängige VM enthält ihre eigenen zwanzig Quellfotografien, gemeinsamen Speicher, die Website, den fehlgeschlagenen Job und Teilergebnisse. Du benötigst keine Dateien aus der vorherigen VM. Schließe zuerst Die Galerie in Stapeln aufbauen ab oder sei mit dem dortigen Ablauf für Indexed Jobs, das Kopieren/Bearbeiten von YAML, die Pod-Untersuchung und Downloads vertraut. Die Dauer von 40 Minuten ist eine Schätzung des Autors.
Verwende Workspace für Befehle und Gallery für die Website. Erhalte die bereitgestellten Dateien, Quell- und Referenzbilder, das Verarbeitungsprogramm, den Plan, die Services, den PVC, den ursprünglichen Job first-try sowie dessen Pods und Logs.
Die fehlgeschlagene Fotogruppe wiederherstellen
In diesem Schritt stellst du den Zusammenhang zwischen der unvollständigen Galerie und dem nativ fehlgeschlagenen Index her, bevor du eine Wiederherstellungsrichtlinie auswählst.
Öffne Gallery, wähle Open the gallery und bestätige 14 of 20 images available. Die erste, dritte und vierte Gruppe sind fertig; die sechs Fotografien in Gruppe 1 fehlen. Öffne Reference in der Seitennavigation, um das bereitgestellte normale Beispiel zu sehen, und wechsle dann zu Workspace.
Das Terminal startet in /home/labex/project/photo-gallery. Bestätige dies mit pwd; kehre bei Bedarf mit cd /home/labex/project/photo-gallery zurück. Lies die Gruppenzuordnung und den Auftrag des Teams:
cat inputs/groups.txt
cat inputs/brief.txt
Es gibt vier bei null beginnende Gruppen. Index 1 enthält photo-07 bis photo-12. Untersuche den aufbewahrten Versuch:
kubectl describe job first-try -n photo-workshop
Suche nach Completion Mode: Indexed, Completed Indexes: 0,2,3, einem fehlgeschlagenen Pod unter Pods Statuses und der Warnung FailedIndexes unter Events. Die abgeschlossenen Indizes und die Pod-Tabelle unten identifizieren die fehlende Gruppe. Lies seine Richtlinie in der bereitgestellten Quelle:
cat starter/first-try.yaml
backoffLimitPerIndex: 0 erlaubt nach einem Fehlschlag in einem Index keinen Ersatz. backoffLimit: 6 ist ein separates globales Fehlerbudget: Es setzt eine Wiederholungsgrenze von null pro Index nicht außer Kraft. activeDeadlineSeconds: 180 ist die Grenze für die aktive Lebensdauer. Der Job bleibt fehlgeschlagen, obwohl mehrere Indizes erfolgreich waren.
Liste seine tatsächlichen Pods und deren Index-Labels auf:
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=first-try -L batch.kubernetes.io/job-completion-index
Lies die Logs aller dieser Pods:
kubectl logs -n photo-workshop job/first-try --all-pods=true --prefix=true
Der Pod für Index 1 meldet Source returned HTTP 503 und beendet sich; die anderen Gruppen melden ihre fertiggestellten Fotografien. HTTP 503 bedeutet, dass die Quelle geantwortet hat, aber vorübergehend nicht verfügbar war. Das unterscheidet sich von einem fehlenden Pod, einem Verbindungsfehler oder einem unlesbaren JPEG.
Kopiere den vollständigen Pod-Namen für Index 1 aus der Tabelle in den folgenden Befehl und ersetze POD_NAME, statt den Platzhalter wörtlich einzugeben:
kubectl describe pod POD_NAME -n photo-workshop
Sein beendeter Container zeigt Exit Code: 42. Dies ist die absichtliche Reaktion des bereitgestellten Workers auf den HTTP-Fehler der Quelle und kein allgemeiner Kubernetes-HTTP-Fehlercode. Das Szenario erzeugt für die erste Anfrage in Index 1 jedes neuen Jobs einen echten 503. Der nächste Ersatz-Pod für denselben Index kann die Quelle erfolgreich lesen. Dies ist eine kontrollierte Übung zu einem vorübergehenden Fehler und keine Behauptung, dass sich jeder 503 in der Produktion sicher durch Wiederholung behandeln lässt.
Behalte den fehlgeschlagenen Job, seine Pods und Logs sowie die vierzehn vorhandenen korrekten JPEGs. Das Verarbeitungsprogramm schreibt ein identisches JPEG nur, wenn dies nötig ist; bereits übereinstimmende Bildbytes und ihre Dateimetadaten bleiben erhalten. Bestätigungsdatensätze pro Pod und Bildindexeinträge dürfen aktualisiert werden, um den neuen erfolgreichen Versuch auszuweisen.
Die Anzahl der Wiederholungsversuche pro Index begrenzen
Erstelle nun einen neuen Job mit einer erlaubten Wiederholung pro Index. Versuche nicht, den bereits fehlgeschlagenen Job in einen neuen Lauf umzuwandeln.
Kopiere in Workspace, unter /home/labex/project/photo-gallery, den bereitgestellten Wiederherstellungsentwurf:
cp starter/recovery-job.yaml gallery-job.yaml
Wie im vorherigen Lab lässt cp die Quelle intakt. Falls die Quelle nicht gefunden wird, bestätige pwd, kehre in den Arbeitsbereich zurück und wiederhole den genauen Kopiervorgang. Lies den Entwurf:
cat gallery-job.yaml
Er fordert bereits alle vier Indizes mit Parallelität 2 an, hat aber den Entwurfsnamen gallery-draft und keine Wiederholungen pro Index. Ersetze mit sed -i jeden wörtlichen Wert in deiner kopierten Datei; einfache Anführungszeichen schützen die Ersetzungsausdrücke vor der Interpretation durch die Shell:
sed -i 's/name: gallery-draft/name: gallery-retry/' gallery-job.yaml
sed -i 's/backoffLimitPerIndex: 0/backoffLimitPerIndex: 1/' gallery-job.yaml
Lies die Datei erneut:
cat gallery-job.yaml
Bestätige name: gallery-retry, completions: 4, parallelism: 2 und backoffLimitPerIndex: 1. Behalte backoffLimit: 6, activeDeadlineSeconds: 180 sowie alle bereitgestellten Einstellungen für Verarbeitungsprogramm, Einbindungen, Identität und Ressourcen bei. Diese Aufgabe akzeptiert eine oder zwei Wiederholungen pro Index, doch eine kleine endliche Anzahl reicht aus. Das Entfernen der Frist oder das Zulassen unbegrenzter Wiederholungen würde ein anhaltendes Problem verbergen.
Ein neuer Job hat eine neue Kubernetes-Identität. Er kann Gruppen verarbeiten, die zuvor erfolgreich waren; der bereitgestellte Worker behandelt diese wiederholte Ausführung, ohne übereinstimmende JPEGs neu zu schreiben. Leite aus einem erfolgreichen Job keine genau einmalige Verarbeitung ab. Das Aufbewahren des alten fehlgeschlagenen Jobs hält außerdem den Grund für diese Wiederherstellung sichtbar. Falls eine Änderung keinen Treffer hatte, kopiere den Entwurf erneut und korrigiere ihn vor dem Anwenden. Falls du bereits einen ungeeigneten endgültigen Job angelegt hast, behalte seine Belege und bereite in der gespeicherten Datei einen anderen neuen Namen vor, statt eine unveränderliche Pod-Vorlage zu ändern oder first-try zu löschen.
Wende den gespeicherten neuen Job an:
kubectl apply -n photo-workshop -f gallery-job.yaml
Warte auf seinen erfolgreichen Abschluss:
kubectl wait -n photo-workshop --for=condition=Complete job/gallery-retry --timeout=180s
Untersuche seine Indizes und seine Richtlinie:
kubectl describe job gallery-retry -n photo-workshop
Erwarte Completed Indexes: 0-3. Der vorangehende Befehl wait hat die native Bedingung Complete bereits bestätigt. Liste die tatsächlichen Pods auf:
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=gallery-retry -L batch.kubernetes.io/job-completion-index
Index 1 hat jetzt einen fehlgeschlagenen Pod und einen anderen, abgeschlossenen Ersatz-Pod für denselben Index. Der fehlgeschlagene Pod ist ein erwarteter Beleg dieses kontrollierten Tests. Lies ihre Ausgabe:
kubectl logs -n photo-workshop job/gallery-retry --all-pods=true --prefix=true
Du solltest den echten HTTP 503 sehen, gefolgt von erfolgreicher Verarbeitung in seinem Ersatz-Pod. Andere Gruppen melden Kept für die JPEGs, die bereits übereinstimmten. Falls die Wartezeit überschritten wird, untersuche den neuen Job und die Pod-Logs; lösche weder den alten Fehler noch setze das Setup zurück oder erhöhe die Wiederholungsgrenzen blind. Die angeforderte Parallelität ist eine gewünschte Nebenläufigkeitseinstellung und keine absolute Prozessgarantie während des Ersetzens.
Die wiederhergestellte Sammlung übergeben
In diesem Schritt weist du nach, dass die Wiederholung die vollständige nutzbare Galerie erzeugt hat, und speicherst ihre aktuellen Downloads.
Wechsle zu Gallery, wähle Gallery in der Seitennavigation und aktualisiere die Seite. Bestätige 20 of 20 images available. Öffne Black-and-white blossoms (photo-07), die erste Fotografie der wiederhergestellten Gruppe, und vergleiche sie mit ihrer eigenen Quelle. Wähle Download thumbnail und Back to gallery. Öffne auch Blue and yellow flowers (photo-20) aus der kurzen letzten Gruppe.
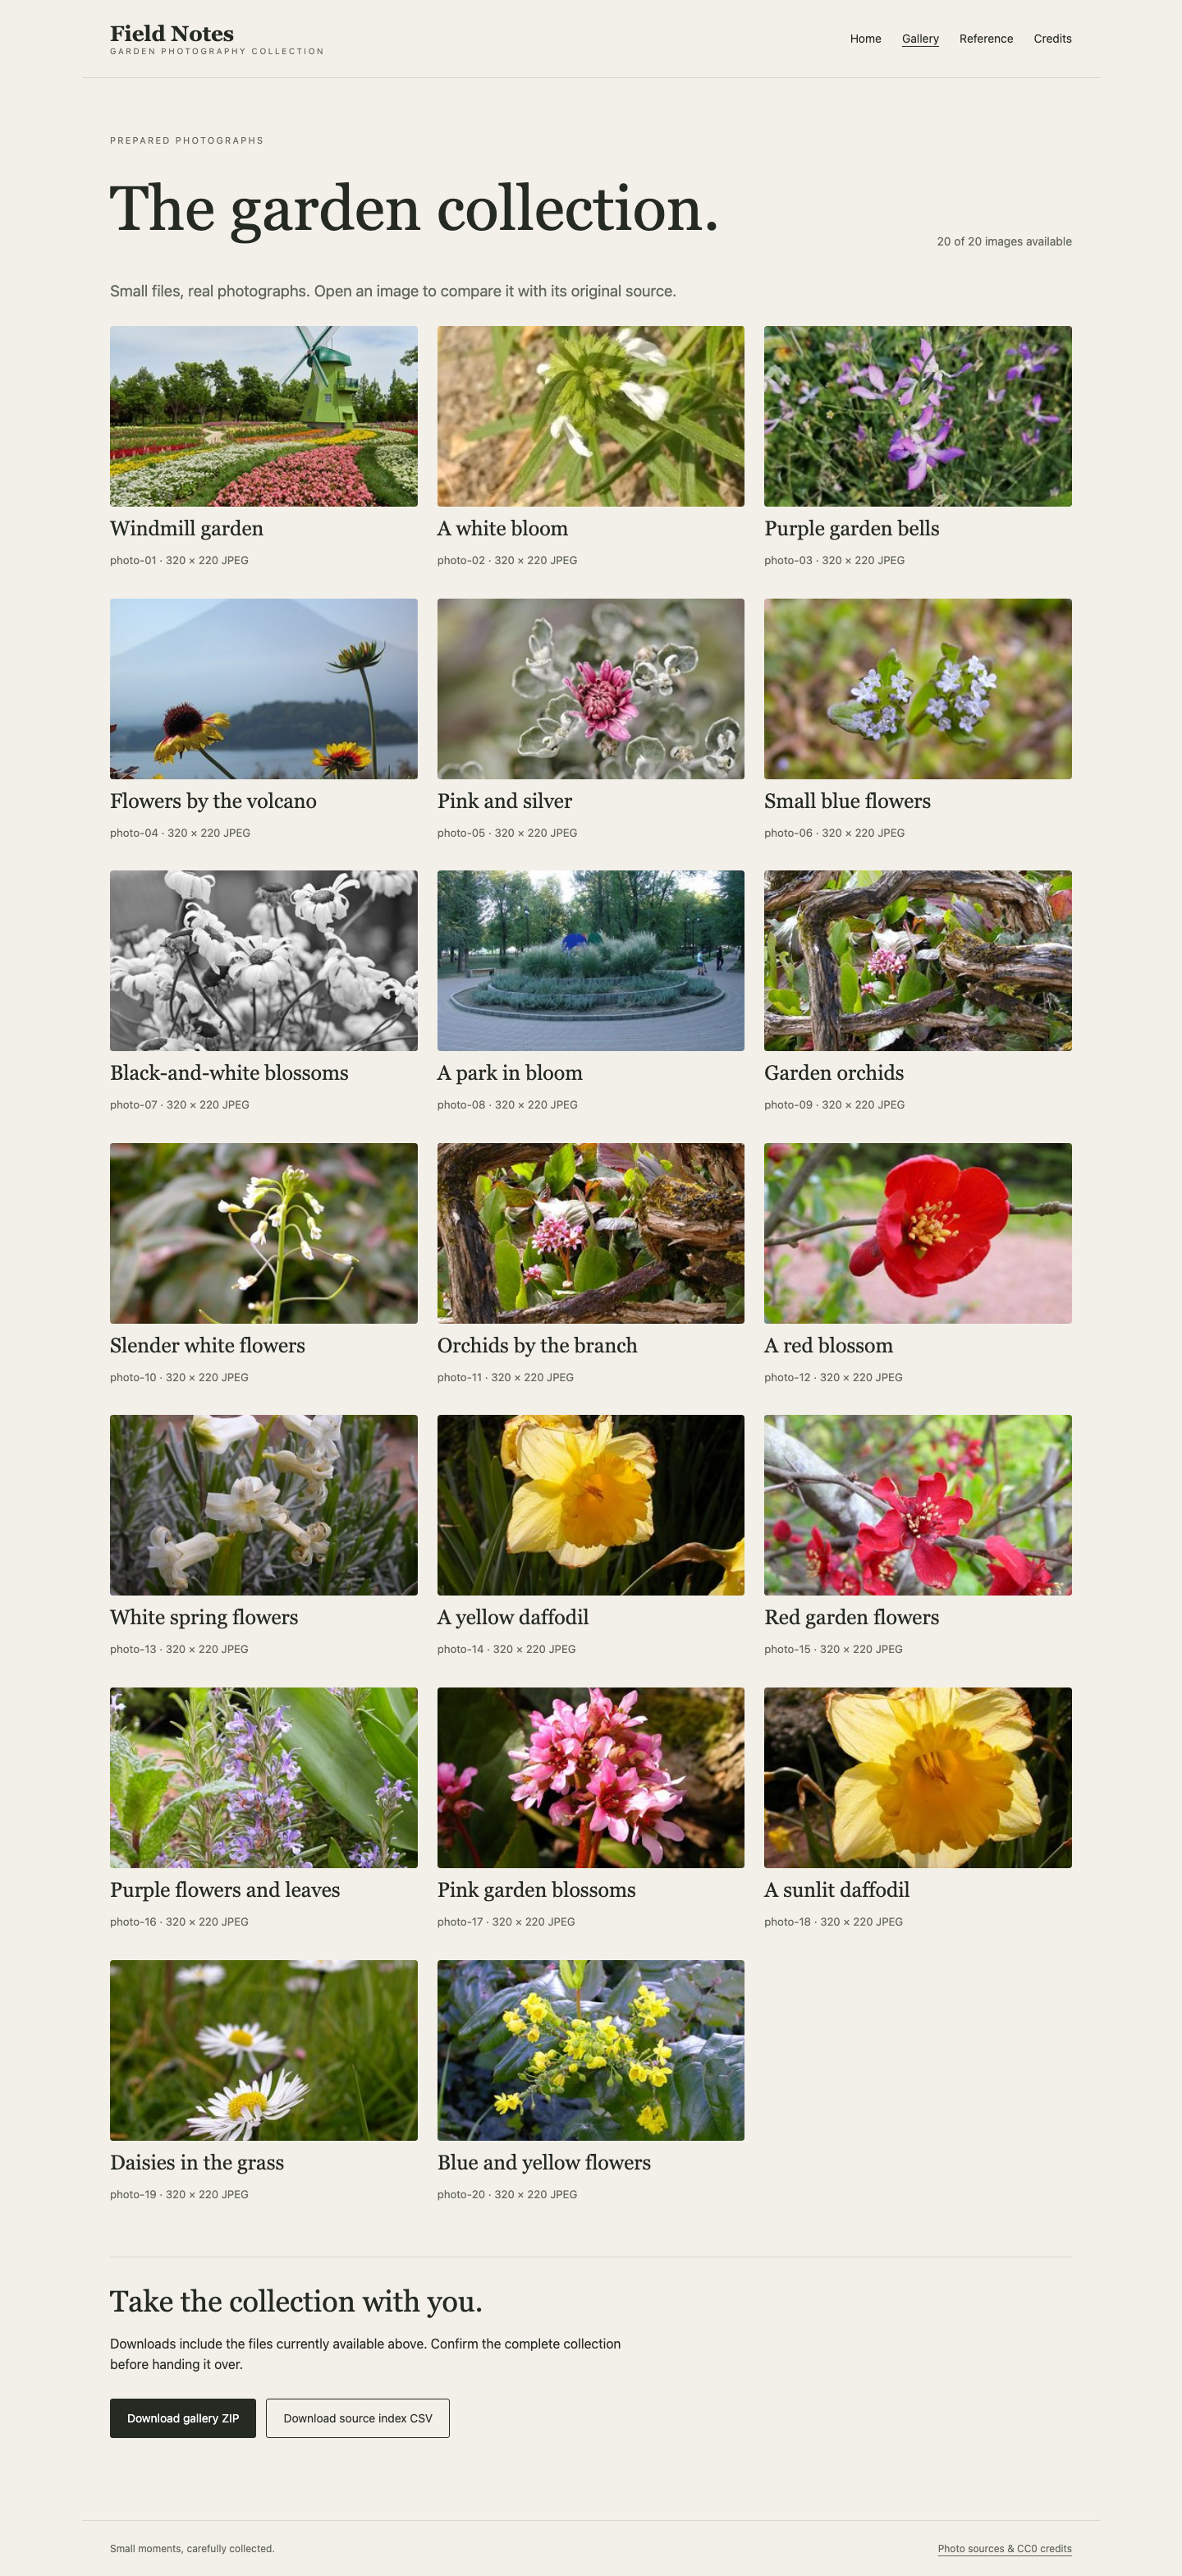
Die wiederhergestellte Sammlung enthält nun die sechs fehlenden Fotografien und die kurze letzte Gruppe. Die Seite verweist weiterhin auf die unveränderte Referenz und die lizenzierten Quellen.
Kehre zur Galerie zurück und verwende Download source index CSV und Download gallery ZIP. Wähle Reference, um zu bestätigen, dass das bereitgestellte Beispiel intakt bleibt, und Credits, um die Quellenangaben zu prüfen. Die Website zeigt nur tatsächlich lesbare Worker-Ausgaben an; sie ergänzt keine fehlenden Bilder aus der Quellsammlung.
Wechsle zu Workspace, unter /home/labex/project/photo-gallery. Speichere die aktuellen echten Übergabedateien mit denselben Optionen, die du im ersten Lab kennengelernt hast:
curl --fail --silent --show-error http://127.0.0.1:8091/download/index.csv -o gallery-index.csv
curl --fail --silent --show-error http://127.0.0.1:8091/download/gallery.zip -o gallery.zip
Prüfe die CSV-Kopfzeile und die ersten Datenzeilen:
head -n 3 gallery-index.csv
Liste das Archiv sicher auf, ohne es zu entpacken:
python3 -m zipfile -l gallery.zip
Es enthält index.csv und zwanzig tatsächliche JPEGs, einschließlich der wiederhergestellten Gruppe und photos/photo-20.jpg. Quell- und Vorschaubildhashes verbinden jede Fotografie mit ihrem eigenen Ergebnis; Dateinamen allein reichen nicht aus.
Bestätige abschließend, dass beide Versuche verfügbar bleiben:
kubectl get jobs -n photo-workshop
Das ursprüngliche first-try ist fehlgeschlagen und das neue gallery-retry ist abgeschlossen. Dies ist der beabsichtigte Endzustand. Lasse das gespeicherte Manifest, Downloads, erfolgreiche und fehlgeschlagene Pods, die ursprünglichen vierzehn JPEGs, Quellen und Referenz verfügbar. Falls ein Download fehlschlägt oder unvollständig ist, korrigiere die Verarbeitung oder den Service und lade erneut herunter; repariere die empfangenen Dateien nicht von Hand.
Zusammenfassung
Du hast einen teilweisen Fehlschlag eines Indexed Jobs diagnostiziert, seine nativen Belege erhalten und mit einem neuen Job mit endlichen Wiederholungen pro Index die echte Sammlung fertiggestellt. Die aus den Quellen abgeleiteten Dateien, die ursprünglich erfolgreichen JPEGs, die laufende Galerie, das gespeicherte Manifest und die Übergabedateien stimmen jetzt überein.