Einführung
Wenn ein KI-Modell eine längere Antwort vorbereitet, kann das Warten auf das vollständige Ergebnis eine Anwendung eingefroren wirken lassen. Streaming ermöglicht es der Anwendung, kleine Teile sofort nach ihrer Fertigstellung zu empfangen. Das ähnelt dem Lesen einer Nachricht, während der Absender noch tippt: Die vollständige Antwort erfordert im Allgemeinen denselben Arbeitsaufwand, aber nützlicher Text erscheint früher.
In diesem Lab verwenden Sie Server-Sent Events (SSE), ein Textformat zum Senden einer Folge von Ereignissen über eine einzige HTTP-Antwort. Jedes Workers-AI-Ereignis beginnt mit data:. Textevents enthalten einen Teil der generierten Antwort, und ein abschließendes data: [DONE]-Ereignis zeigt an, dass der Stream normal beendet wurde. Eine Pause zwischen Ereignissen bedeutet nur, dass das Modell noch arbeitet. Ohne ein Abschlusssignal kann eine Anwendung eine langsame Antwort nicht von einer Verbindung unterscheiden, die niemals beendet wird.
Sie erstellen POST /help, streamen eine von Cloudflare gehostete Llama-Antwort an einen bereitgestellten Befehlszeilen-Client und testen zwei Enden: den normalen Abschluss sowie einen absichtlichen Abbruch nach dem ersten nützlichen Teil. Abbruch bedeutet, dass der Client die restliche Antwort nicht mehr benötigt und die Verarbeitung beendet, anstatt eine ungenutzte Verbindung offen zu lassen. Außerdem verwenden Sie deterministische Tests, um nachzuweisen, dass ein Fehler beim Start des Modells zu einem begrenzten Fehler wird und dass ein unterbrochener Stream beendet wird, statt hängen zu bleiben.
Dies ist das zweite Lab des Kurses. Es setzt voraus, dass Sie wissen, dass ein Cloudflare Worker Anwendungscode ist, der im Cloudflare-Netzwerk ausgeführt wird, und dass ein AI-Binding Workers AI als env.AI bereitstellt. Wenn Sie direkt in diesen Kurs eingestiegen sind, absolvieren Sie zunächst Connect LabEx to Your Cloudflare Account, damit Sie wissen, wie Sie das VM-Terminal verwenden, Wrangler autorisieren, Ihr Lernkonto bestätigen und dessen Account-ID speichern.
Das Lab verwendet @cf/meta/llama-3.3-70b-instruct-fp8-fast und kleine synthetische Fragen. Kostenlose Workers-Konten erhalten derzeit gemeinsam ein tägliches Kontingent von 10.000 Neurons. Auch lokale Inferenz erreicht Cloudflare und verbraucht dieses Kontingent. Wenn das Kontingent erschöpft ist oder dem Modell keine Kapazität zur Verfügung steht, halten Sie an, statt wiederholt Anfragen zu senden. Die Anwendung sollte einen endgültigen Fehler melden, anstatt hängen zu bleiben.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 als projektspezifische Version in /home/labex/project/help-stream. Es stellt den SSE-Client, deterministische Fixtures und unabhängige Prüfungen bereit. Das Setup meldet Sie nicht an, ruft kein Modell auf, stellt keinen Worker bereit und erstellt keine Cloud-Ressource. Lassen Sie diese VM geöffnet, bis Sie den temporären Worker gelöscht und die Abmeldung überprüft haben.
VM autorisieren und den Streaming-Worker konfigurieren
In diesem Schritt autorisieren Sie diese neue VM und konfigurieren den temporären Streaming-Worker. Ihre bestehende Anmeldung im Dashboard berechtigt Terminalbefehle nicht automatisch dazu, das Lernkonto zu verwalten.
Wechseln Sie in das vorbereitete Projekt und überprüfen Sie die festgelegte Wrangler-Version:
cd /home/labex/project/help-stream
npx wrangler --version
Erwartet wird 4.132.0. Fordern Sie nur die hier benötigten Berechtigungen an. Der Schreibzugriff auf Workers Scripts verwaltet den temporären Worker, der Schreibzugriff auf Workers AI ermöglicht es seinem Binding, das Modell aufzurufen, und die beiden Leseberechtigungen identifizieren das ausgewählte Konto. Wrangler 4.132.0 prüft beim Löschen eines Workers außerdem Abhängigkeiten von KV-Bindings. Daher ermöglicht der eingeschränkte KV-Schreibzugriff, dass dieser Bereinigungsbefehl abgeschlossen wird, obwohl dieses Lab keine KV-Daten erstellt.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Öffnen Sie den angezeigten Link, geben Sie den aktuellen Gerätecode ein, prüfen Sie Konto und Berechtigungen und autorisieren Sie das Lernkonto. Möglicherweise wird auch Background Access angezeigt, weil Wrangler nach dem Schließen des Browsers fortfährt. Kehren Sie zum Terminal zurück und warten Sie auf die Erfolgsmeldung. Prüfen Sie anschließend die strukturierten Identitätsdaten:
npx wrangler whoami --json
Bestätigen Sie loggedIn: true und lesen Sie name und id des vorgesehenen Kontos ab. Erzeugen Sie einen eindeutigen Namen für den temporären Worker:
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Ersetzen Sie YOUR_ACCOUNT_ID unten durch die tatsächliche ID dieses Kontos:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
Das AI-Binding wird als env.AI verfügbar sein. remote: true bedeutet, dass die lokale Entwicklung weiterhin das echte Cloud-Modell verwendet. enable_request_signal sorgt dafür, dass request.signal eine Trennung des Clients meldet. Dadurch kann der Worker ein Abbruchsignal protokollieren und darauf reagieren. Observability speichert die Lebenszyklusereignisse, die Sie später untersuchen. Bisher wurde kein Worker bereitgestellt und keine Inferenz ausgeführt.
AI-Binding und SSE-Client untersuchen
In diesem Schritt verbinden Sie das AI-Binding mit dem bereitgestellten SSE-Client, bevor Sie den Worker schreiben. Das Modell ist der Produzent, der Worker leitet Bytes weiter, und client.mjs ist der Konsument. Die Trennung dieser Rollen macht deutlich, welche Komponente die Verarbeitung beenden sollte.
Erzeugen Sie die Umgebungstypen des Workers:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Suchen Sie nach AI: Ai. Das bedeutet, dass das konfigurierte Binding dem Handler als env.AI zur Verfügung steht. Es handelt sich nicht um einen im Quellcode gespeicherten API-Schlüssel.
Untersuchen Sie nun die vom Client bereitgestellten Endzustände im Terminal:
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
Der Client liest die Antwort Stück für Stück. Eine Zeile mit chunk: zeigt neu generierten Text. complete erscheint erst nach data: [DONE]. Im Abbruchmodus schließt der Client den Reader nach dem ersten nichtleeren Stück. stream_error bezeichnet einen endgültigen Fehler, einschließlich eines Timeouts nach 45 Sekunden. Das Timeout ist eine Sicherheitsgrenze und keine Vorhersage, dass jede Modellantwort so lange dauern sollte.
Ein SSE-Ereignis besteht aus einfachem Text und wird durch eine Leerzeile vom nächsten Ereignis getrennt. Ein typischer erfolgreicher Stream sieht so aus:
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
Chunk-Grenzen sind Transportdetails: Ein Ereignis kann ein Wort, ein Satzzeichen oder ein längeres Fragment enthalten. Die Anwendungslogik sollte die response-Zeichenfolgen zusammenfügen und auf [DONE] warten. Sie sollte keine feste Anzahl oder Größe von Chunks voraussetzen.
Einen überwachten Streaming-Endpunkt erstellen
In diesem Schritt erstellen Sie den Streaming-Endpunkt und seine Überwachung des Lebenszyklus. Der Worker fordert beim Modell einen Stream mit stream: true an und stellt dem Client anschließend dasselbe SSE-Protokoll bereit. Er sammelt nicht zuerst die gesamte Antwort im Speicher. Ein kleiner Wrapper überwacht den Lebenszyklus des Streams: Beim Abschluss wird er normal geschlossen, bei einem Abbruch wird der Upstream-Reader abgebrochen und bei einem Streamfehler wird die Antwort beendet.
Erstellen Sie den Einstiegspunkt des Workers:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Der Code protokolliert Request-IDs und Lebenszyklusereignisse, aber niemals die Frage oder die generierte Antwort. Eine Request-ID verbindet die Antwort eines Clients mit einem Protokolleintrag, ohne Supportinhalte in die Observability-Daten zu kopieren. Auch die Fehlerantwort verbirgt interne Details des Providers. Betreiber können das Lebenszyklusprotokoll verwenden, während Clients den stabilen Vertrag model_unavailable erhalten.
Führen Sie die deterministischen Tests aus. Ihre simulierte AI-Bindung erzeugt kontrollierte Ereignisse, schlägt vor dem Streaming fehl, unterstützt Abbruch und unterbricht einen Stream, ohne Neurons zu verbrauchen:
node --test test/worker.test.mjs
Erwartet werden sechs erfolgreiche Tests. Bündeln Sie anschließend den echten Worker, ohne ihn bereitzustellen:
npx wrangler deploy --dry-run
Die Tests weisen das Anwendungsverhalten unter kontrollierten Zeitbedingungen nach. Der Probelauf bestätigt, dass Quellcode und Konfiguration gemeinsam gebündelt werden können. Keiner dieser Schritte beweist, dass das Cloud-Modell derzeit verfügbar ist. Im nächsten Schritt verwenden Sie einen echten Stream.
Einen echten lokalen Stream beobachten
In diesem Schritt beobachten Sie einen echten Stream über einen Worker-Prozess, der von der VM aus ausgeführt wird. „Lokal“ beschreibt den Request-Handler. Die Modellinferenz findet weiterhin im ausgewählten Konto statt und wird auf dessen tägliches Kontingent angerechnet.
Starten Sie Wrangler im Hintergrund und speichern Sie seine Prozess-ID:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Warten Sie auf die nicht von AI abhängige Health-Route:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Verwenden Sie nun den bereitgestellten Client für eine kleine synthetische Frage:
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Sie sollten eine oder mehrere Zeilen mit chunk: sehen, gefolgt von einer abschließenden Zeile ähnlich wie:
complete chunks=18 chars=238
Ihr Text sowie die Chunk- und Zeichenanzahl werden abweichen. Entscheidend ist der Nachweis von nichtleerem, schrittweise eintreffendem Inhalt, gefolgt von [DONE], das der Client in complete umwandelt. Wenn Sie stream_error sehen, untersuchen Sie .labex/dev.log. Ein Quoten-, Autorisierungs- oder Kapazitätsfehler ist eine fehlgeschlagene Inferenz und kein Grund, unbegrenzt zu warten.
Beweisen Sie abschließend, dass die Anwendungsvalidierung weiterhin vor der Inferenz stattfindet:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
Erwartet werden {"error":"invalid_question"} und HTTP 400. Ein Stream ist erst dann sinnvoll, wenn eine gewöhnliche Anfrage ihre Grenzprüfungen bestanden hat.
Einen Stream bereitstellen, abschließen und abbrechen
In diesem Schritt stellen Sie den Worker bereit, schließen einen Stream ab und brechen einen weiteren nach seinem ersten nützlichen Teil ab. Stoppen Sie zuerst nur den gespeicherten Entwicklungsprozess und warten Sie, bis er beendet ist:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Stellen Sie denselben Worker-Code bereit:
npx wrangler deploy
Speichern Sie die von Wrangler ausgegebene exakte workers.dev-URL:
WORKER_URL="https://YOUR_WORKER_URL"
Beobachten Sie zunächst den normalen Abschluss:
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Die abschließende Zeile complete bedeutet, dass das Modell [DONE] gesendet hat. Der Empfang des ersten Teils allein würde keine vollständige Antwort nachweisen.
Starten Sie nun einen zweiten Stream und beenden Sie ihn absichtlich nach seinem ersten nichtleeren Teil:
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
Erwartet wird eine Zeile mit chunk:, gefolgt von cancelled after 1 chunk. Der Abbruch ist kein Modellfehler: Der Client hat absichtlich entschieden, dass er den Rest nicht mehr benötigt. Das Schließen des Readers überträgt den Abbruch an den Upstream-Stream, während das eingehende Request-Signal dem Worker ermöglicht, die Trennung zu protokollieren.
Öffnen Sie das Cloudflare-Dashboard und gehen Sie zu Workers & Pages → Overview → Ihr labex-c07-a02-...-Worker → Observability → Logs. Suchen Sie die aktuellen Anfragen. Die folgende Übersicht stammt aus einem temporären Akzeptanzlauf: 14 Success und 0 Errors zeigen, dass der Worker seine Health-Checks, vollständigen Streams und absichtlichen Trennungen ohne fehlgeschlagene Ausführung verarbeitet hat. Ihre Gesamtzahlen und Zeitstempel werden abweichen.
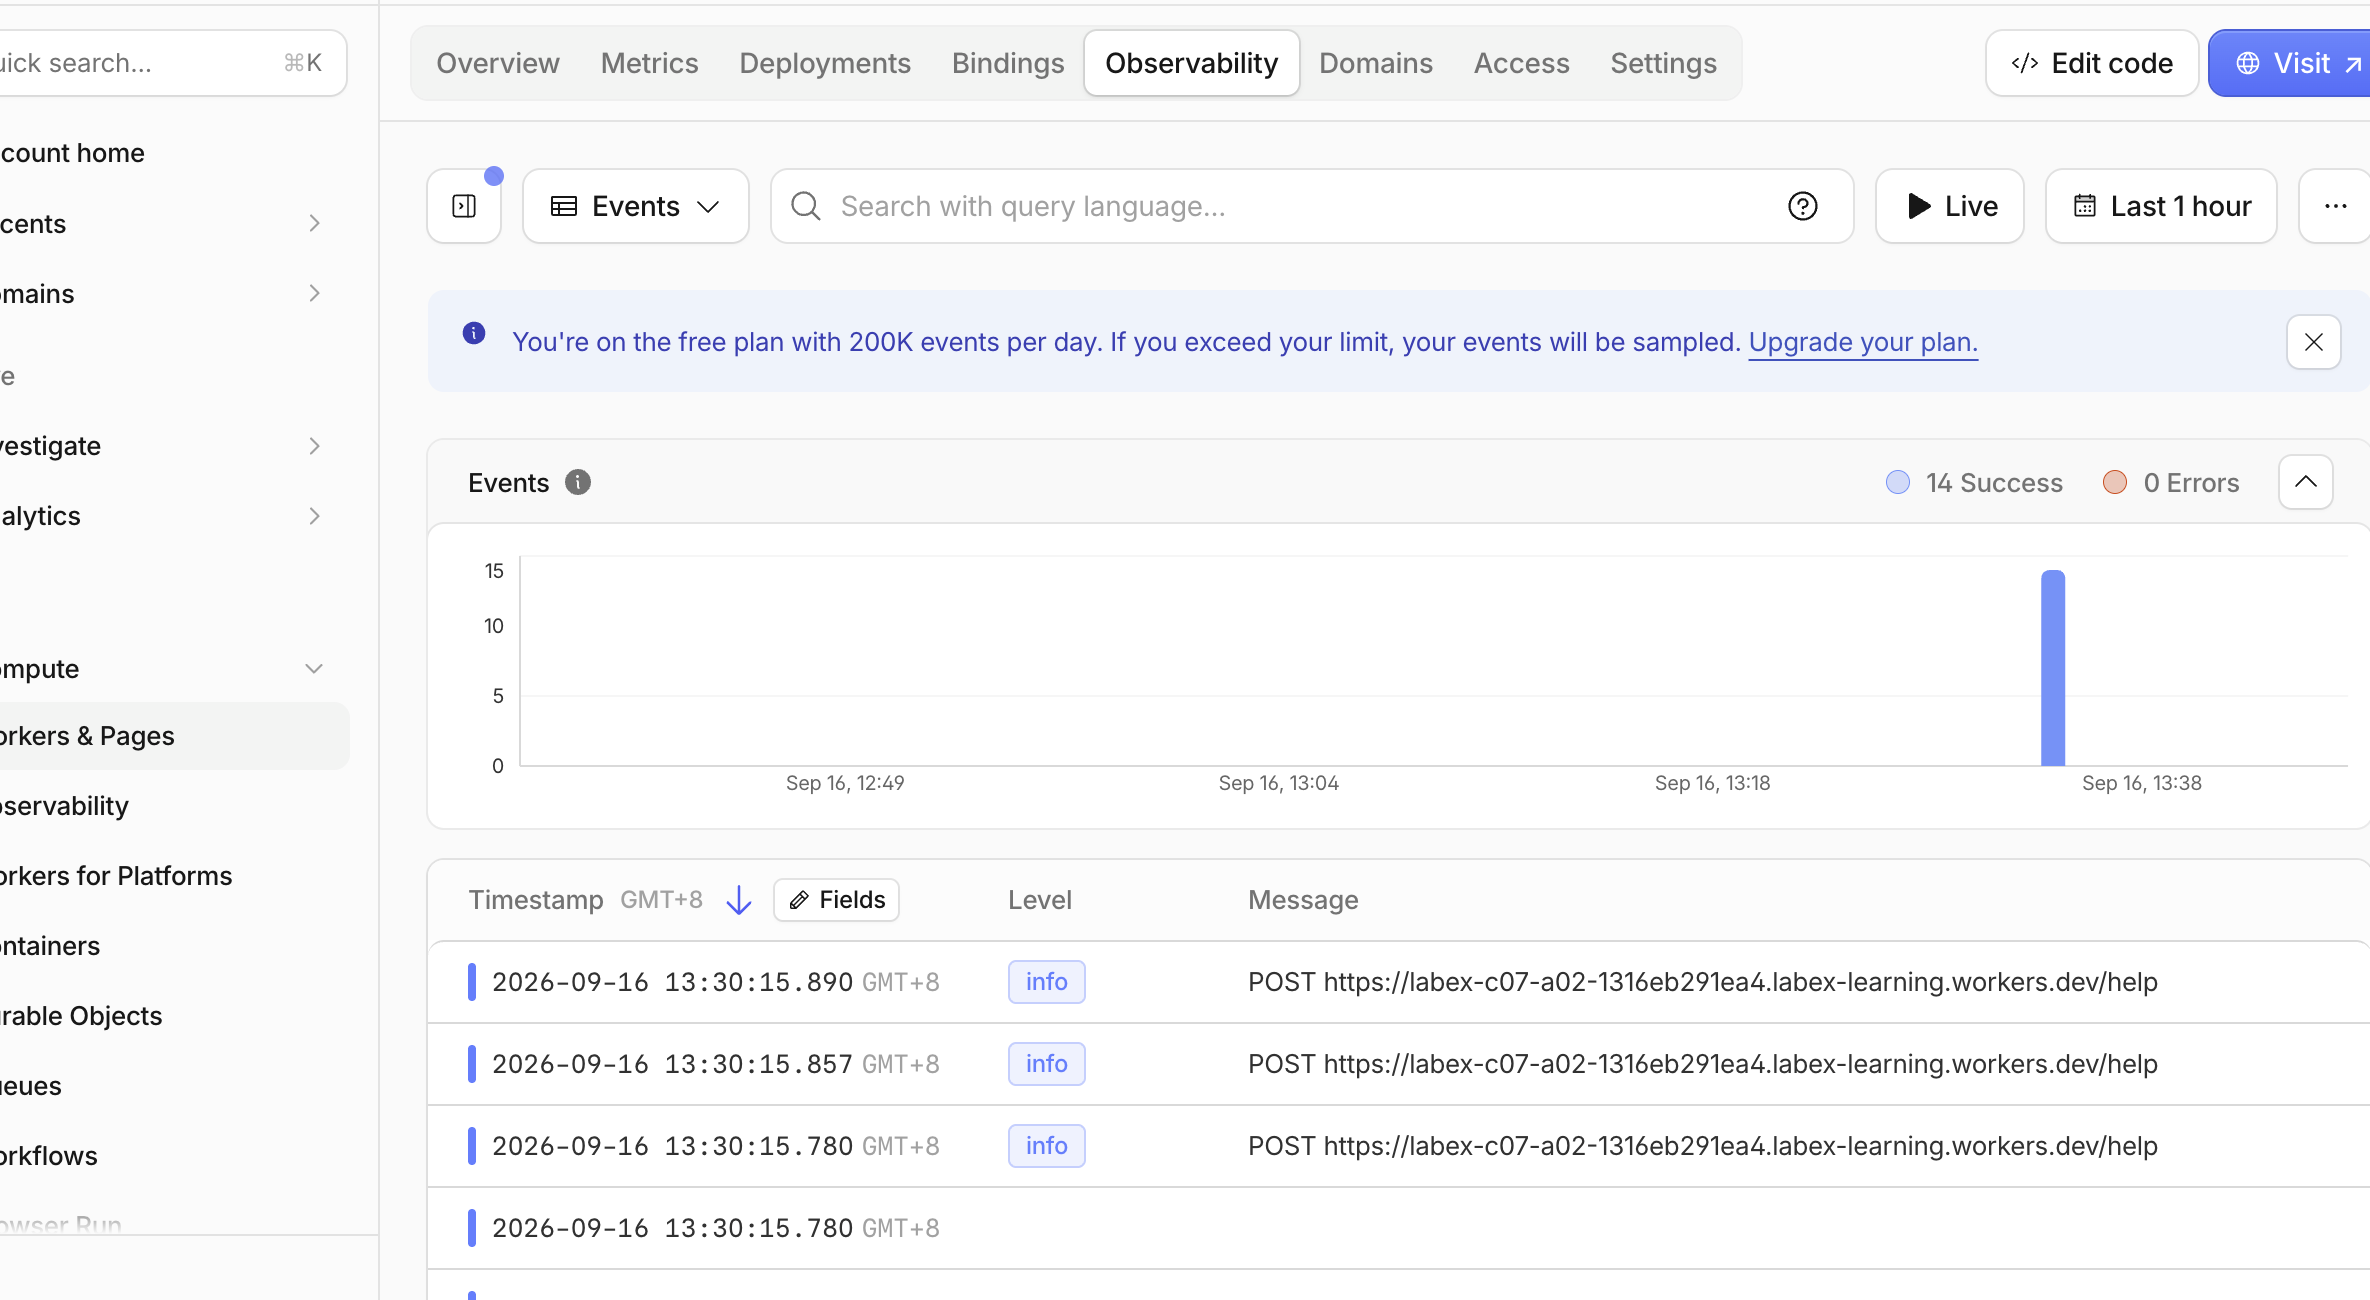
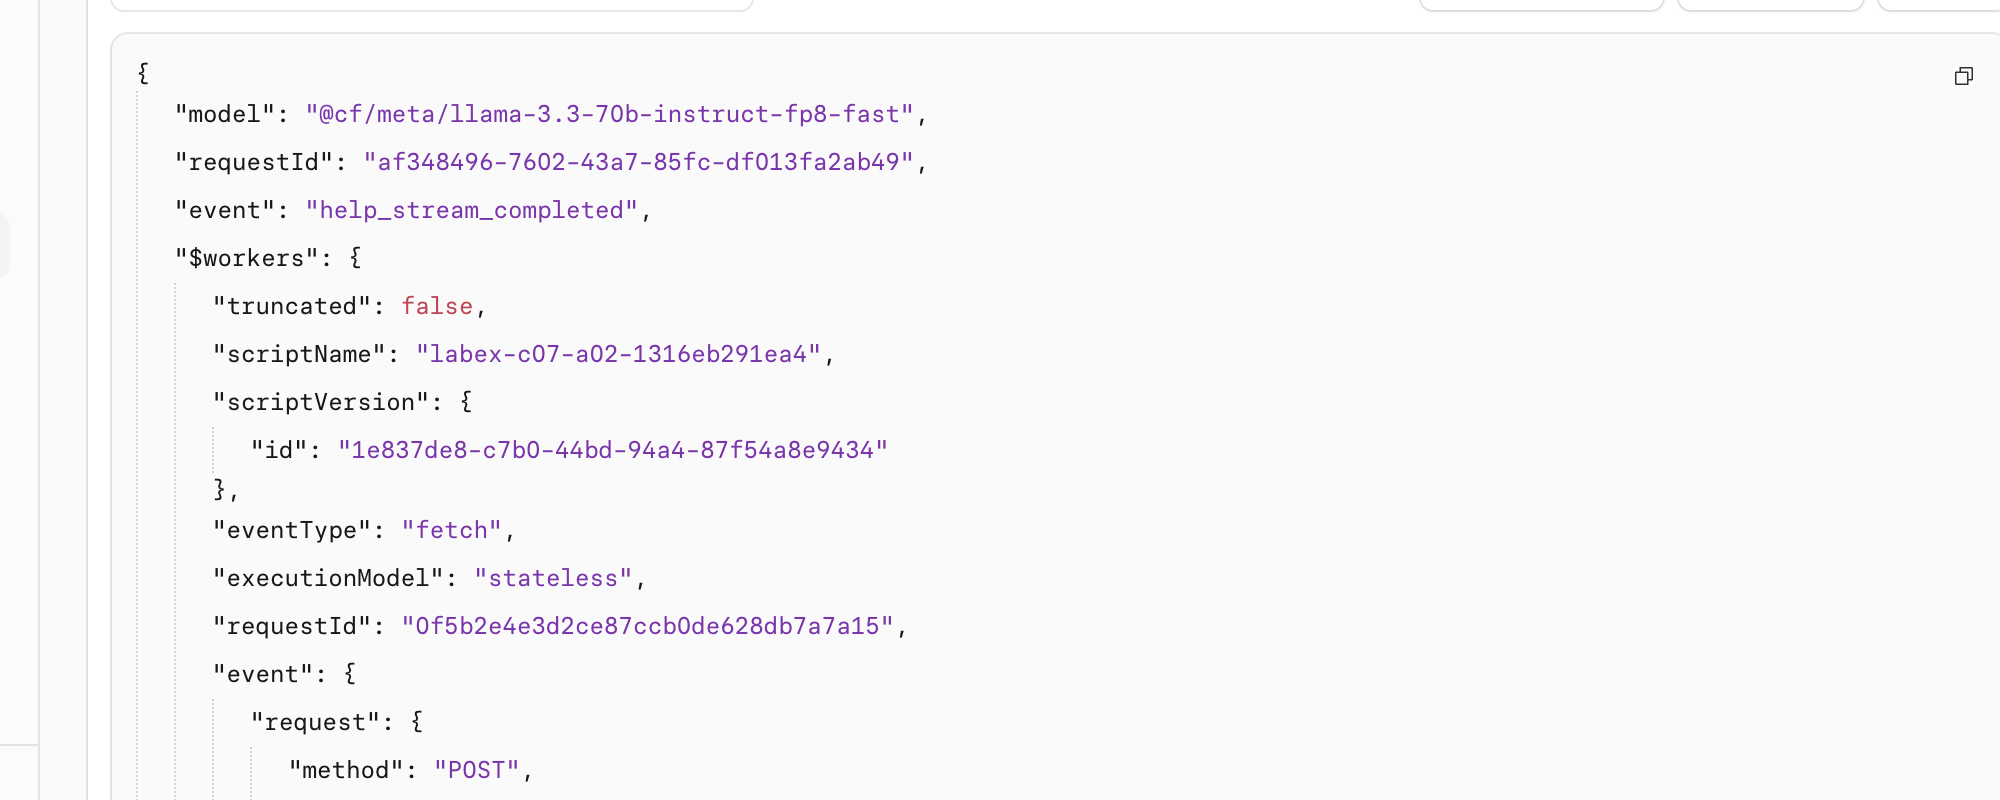
Suchen Sie nach help_stream_completed, erweitern Sie ein Ergebnis und bestätigen Sie model, requestId und event. Die Request-ID ist ein sicherer Korrelationswert: Sie hilft einem Betreiber, Lebenszyklusdatensätze miteinander zu verbinden, ohne die Frage des Lernenden oder die generierte Antwort zu speichern.
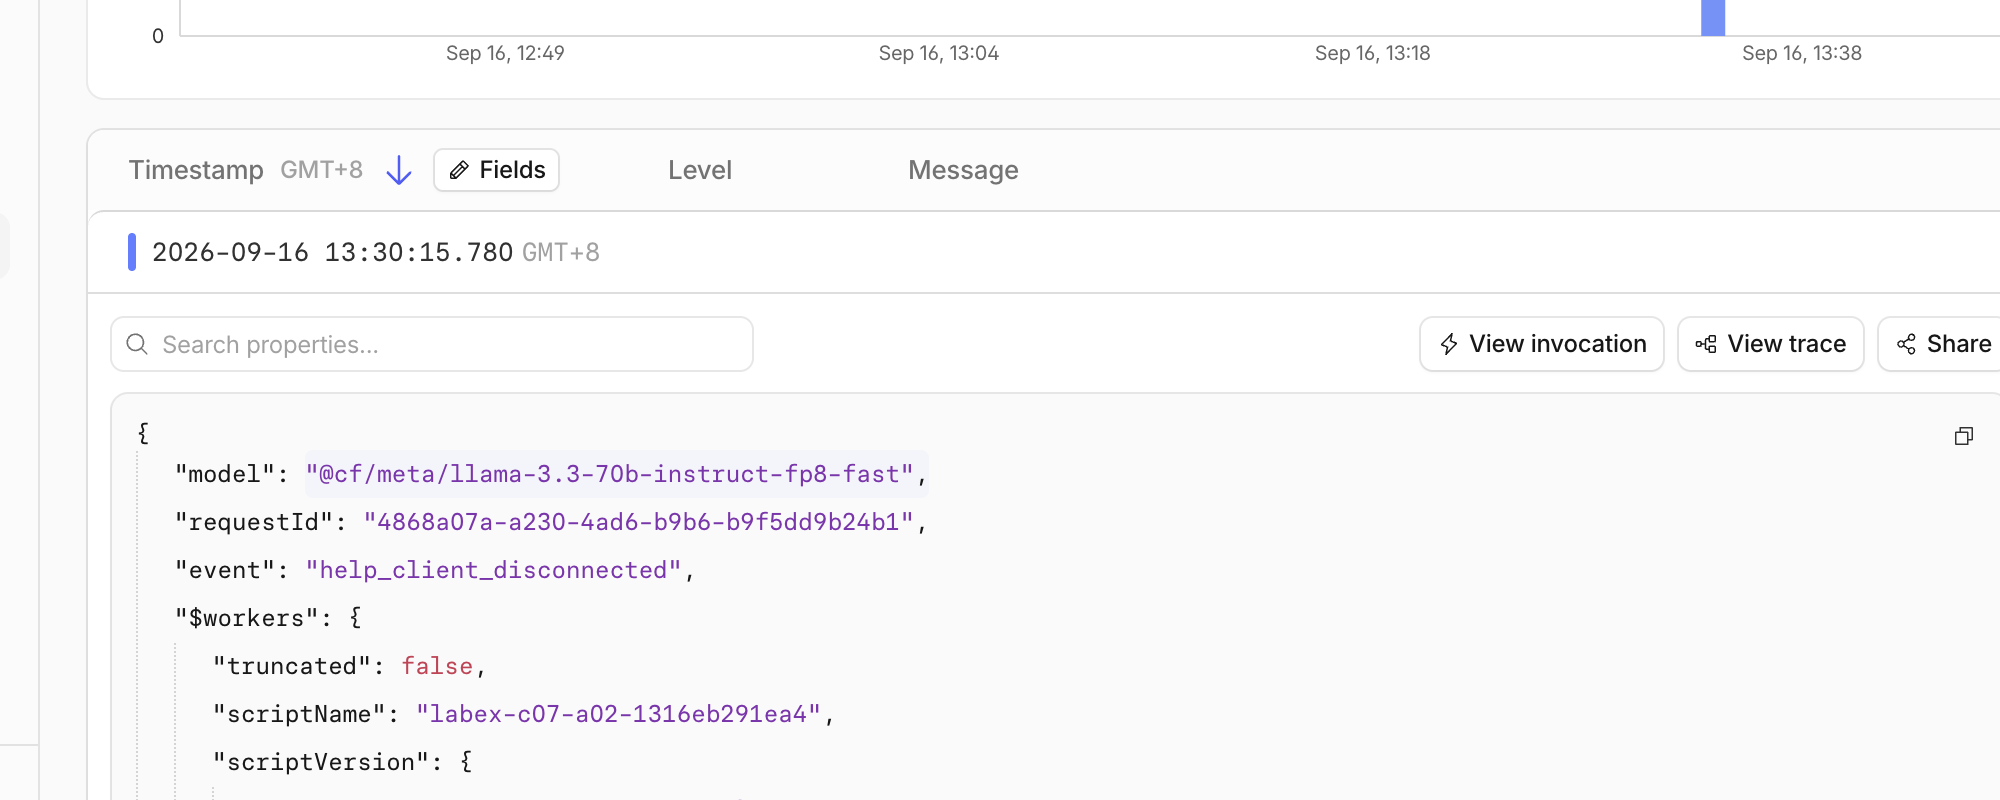
Suchen Sie bei der absichtlich abgebrochenen öffentlichen Anfrage nach help_client_disconnected. Mit enable_request_signal ist dieses Ereignis der direkte Nachweis dafür, dass der eingehende Client die Verbindung beendet hat. Der deterministische Test aus Schritt 4 weist unabhängig davon nach, dass cancel() des Downstreams das Modell-Fixture erreicht und help_stream_cancelled protokolliert. Bei echter Netzwerk-Zeitsteuerung kann stattdessen das Request-Signal-Ereignis als sichtbarer Cloud-Eintrag erscheinen. Gespeicherte Protokolle können später als die Antwort eintreffen. Warten Sie daher kurz und senden Sie höchstens eine weitere begrenzte Abbruchanfrage, falls dies erforderlich ist.
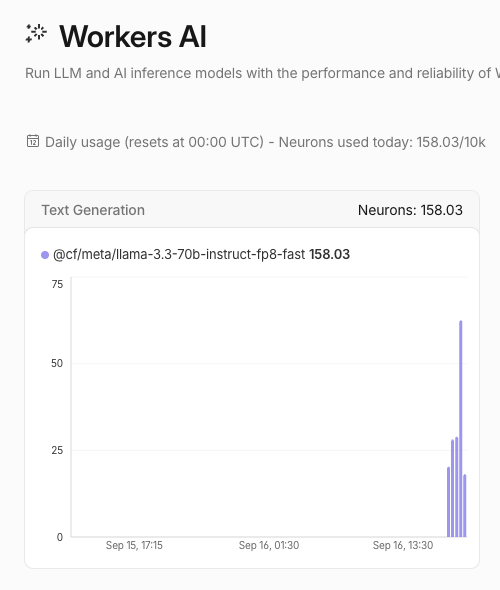
Öffnen Sie anschließend Workers AI und prüfen Sie die heutige Modellnutzung. Suchen Sie das Modell Llama 3.3 und bestätigen Sie, dass die kleinen Übungen innerhalb des kostenlosen Kontingents von 10.000 Neurons bleiben. Im folgenden Beispiel verwendete die gesamte Arbeit im Lernkonto 158.03/10k Neurons. Darin sind auch andere Übungen dieses Kontos enthalten, daher wird Ihr Wert abweichen. Ein Workers-Paid-Tarif ist für dieses Lab nicht erforderlich, solange das Konto innerhalb des kostenlosen Kontingents bleibt. Die Nutzung kann verzögert angezeigt werden. Wiederholen Sie die Inferenz daher nicht nur, um eine Aktualisierung des Diagramms zu erzwingen.
Worker-Name, Request-IDs, Zeitstempel und Nutzungsdaten in diesen Screenshots sind Beispiele aus einem temporären Lauf. Die Lernziele sind die Ereignisnamen und die Beziehung im Lebenszyklus, nicht die exakten Werte.
Worker entfernen und abmelden
In diesem Schritt entfernen Sie den temporären Worker und melden diese VM anschließend ab. Die Nutzungsdaten von Workers AI sind kontoweite Verlaufsdaten. Das Löschen des Workers entfernt daher seinen öffentlichen Endpunkt, löscht diese historischen Daten jedoch nicht und ändert auch den Kontotarif nicht.
Löschen Sie genau den in wrangler.jsonc angegebenen Worker:
npx wrangler delete
Bestätigen Sie den Vorgang nur, wenn Wrangler den eindeutigen Namen labex-c07-a02-... dieses Labs anzeigt. Der Befehl sollte mit Successfully deleted enden. Aktualisieren Sie im Dashboard Workers & Pages → Overview und bestätigen Sie, dass genau dieser Name nicht mehr vorhanden ist.
Führen Sie noch während der Autorisierung der VM die unabhängige Verwaltungsprüfung aus:
python3 .labex/verify.py deleted
Erst wenn PASS: deleted gemeldet wird, entfernen Sie die gespeicherte Autorisierung dieser VM:
npx wrangler logout
npx wrangler whoami --json
Erwartet wird loggedIn: false. Eine fehlende lokale Datei, ein geschlossener Browser-Tab oder ein Netzwerkfehler würde weder die Löschung in der Cloud noch die Abmeldung beweisen.
Zusammenfassung
Sie haben einen Workers-AI-Endpunkt erstellt, der inkrementelle SSE-Ausgabe weiterleitet, statt eine vollständige Antwort zu puffern. Sie haben gelernt, warum ein Client ein explizites [DONE]-Signal benötigt, wie ein Timeout unbegrenztes Warten verhindert, wie sich ein absichtlicher Abbruch von einem Fehler unterscheidet und wie Streamfehler sauber beendet werden. Sie haben echte lokale und bereitgestellte Inferenz überprüft, Lebenszyklusereignisse mit der Observability im Dashboard verknüpft, den temporären Worker entfernt und die neue VM abgemeldet.