Einführung
V03 hat eine Frage in ein Embedding umgewandelt und passende Hilfeartikel abgerufen. Ein echtes Supportsystem bedient jedoch normalerweise mehrere Kunden. Die semantische Ähnlichkeit allein darf niemals entscheiden, welche Dokumente eines Kunden ein Anrufer sehen darf.
In diesem Lab fügen Sie zwei Suchgrenzen hinzu. Ein Vectorize-Namespace ist eine Partition innerhalb eines Index. Bei der Suche in einem Namespace werden die Vektoren aller anderen Namespaces ausgeschlossen, bevor das Ranking nach Ähnlichkeit beginnt. Ein Metadaten-Filter schränkt diese Kundenpartition anschließend anhand eines Feldes wie category weiter ein. Sie können sich den Namespace als Auswahl des richtigen Aktenschranks vorstellen und den Kategoriefilter als Auswahl einer Schublade darin.
Keine dieser beiden Funktionen authentifiziert eine Person. Die Anwendung muss zuerst einen Login, ein Token oder ein anderes Identitätssignal validieren und den Namespace auf dem Server ableiten. Damit die Übung sicher und reproduzierbar bleibt, verwendet dieser Worker zwei öffentliche, synthetische Sitzungsbezeichnungen, die bereits validierte Sitzungen darstellen. Sie dienen als Lehrbeispiele und sind weder echte Zugangsdaten noch ein vollständiges Authentifizierungssystem. Eine Anfrage darf niemals ihren eigenen Kunden oder Namespace auswählen.
Sie stellen einen kurzlebigen Worker mit Bindings für Workers AI und Vectorize bereit. Vier synthetische Artikel enthalten absichtlich denselben Passworttext in zwei Kundennamensräumen. Live-Embeddings machen die Suche realistisch. Exakte Prüfungen von Namespace, Kategorie und ID belegen jedoch die Isolation, ohne die exakten Modellwerte bewerten zu müssen. Sie testen außerdem ein autorisiertes leeres Ergebnis und weisen einen versuchten Override des Suchbereichs zurück, bevor die Anfrage einen der beiden Cloud-Dienste aufruft.
Wenn Sie direkt in diesen Kurs eingestiegen sind, absolvieren Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden. V01–V03 sind ebenfalls Voraussetzungen. Sie führen kompatible Indizes, asynchrone Mutationen und semantischen Abruf ein.
Der kleine Index und die begrenzten BGE-Small-Anfragen passen in die dokumentierten Workers-Free-Kontingente. Workers Paid ist nicht erforderlich. Lokale oder bereitgestellte Modellaufrufe verbrauchen weiterhin das gemeinsame tägliche Workers-AI-Kontingent des Kontos. Brechen Sie daher ab, statt wiederholt zu versuchen, wenn dieses Kontingent nicht verfügbar ist.
Das Setup installiert Node.js 22.22.0 sowie Wrangler 4.132.0 lokal im Projektverzeichnis /home/labex/project/scoped-vector-search. Es stellt deterministische Tests und unabhängige schreibgeschützte Prüfungen bereit. Es autorisiert Wrangler jedoch nicht, erstellt keinen Index, stellt keinen Worker bereit, führt keine Inferenz aus und legt keine Cloud-Daten an.
Scoped-Search-Ressourcen autorisieren und benennen
In diesem Schritt autorisieren Sie die neue VM und beschreiben einen Worker sowie den zugehörigen Vectorize-Index in einer normalen Wrangler-Konfiguration.
Wechseln Sie in das vorbereitete Projekt und überprüfen Sie die festgelegte CLI-Version:
cd /home/labex/project/scoped-vector-search
npx wrangler --version
Erwarten Sie 4.132.0. Mit der Geräteautorisierung kann die VM eine temporäre OAuth-Berechtigung erhalten, ohne dass Ihr Cloudflare-Passwort übertragen wird. Die angeforderten Berechtigungen decken die Kontoidentität, den kurzlebigen Index, die Worker-Bereitstellung und das Workers-AI-Binding für Embeddings ab:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Öffnen Sie den angezeigten Link im Browser, geben Sie den aktuellen Code ein und bestätigen Sie das vorgesehene Lernkonto. Bestätigen Sie anschließend im Terminal loggedIn: true, authType: OAuth Token und den Kontonamen, bevor Sie die Konto-ID kopieren.
Erzeugen Sie ein zufälliges Suffix und leiten Sie den Indexnamen aus dem Workernamen ab. Dieses Besitzmuster ermöglicht später eine gezielte Bereinigung:
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Ersetzen Sie YOUR_ACCOUNT_ID durch die von whoami angezeigte ID. Ein Binding gibt dem Worker-Code einen lokalen Namen für einen Cloudflare-Dienst. AI erstellt Embeddings und DOCUMENTS fragt genau den unter index_name angegebenen Index ab.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
Die Datei benennt die vorgesehenen Ressourcen, erstellt sie aber noch nicht. In einem gemeinsam genutzten Lernkonto ist es besonders wichtig, Identität und Besitz vor einem Schreibvorgang ausdrücklich festzulegen.
Einen serverseitig begrenzten Such-Worker erstellen
In diesem Schritt implementieren Sie die Zugriffsschranke, bevor Sie den Worker bereitstellen.
Der Header x-lab-session verwendet zwei öffentliche Bezeichnungen nur, um das Ergebnis einer früheren Authentifizierungsschicht zu simulieren. resolveSession ordnet diesen validierten Kontext serverseitig einem Namespace zu. Der Request-Body darf eine Suchanfrage und eine zulässige Kategorie enthalten, aber keinen Kunden oder Namespace benennen. Ersetzen Sie diese Bezeichnungen in einer Produktionsanwendung durch eine ordnungsgemäß geprüfte Sitzung oder einen Identitätsanbieter. Ein Namespace organisiert Daten, authentifiziert aber niemanden.
Die vier Dokumente enthalten für die Kunden blue und green denselben Passworttext. Dadurch ist das Sicherheitsergebnis leicht erkennbar: Die Ähnlichkeit kann die Kopien nicht unterscheiden. Nur der serverseitig kontrollierte Suchbereich kann sie voneinander trennen.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Führen Sie die deterministischen Tests aus. Die In-Memory-Bindings beweisen, dass der Worker beide Suchgrenzen aus dem serverseitigen Kontext erstellt, ohne Cloud-Kontingent zu verbrauchen:
node --test test/worker.test.mjs
Erwarten Sie sechs erfolgreiche Tests. Erzeugen Sie anschließend die Binding-Typen aus der echten Konfiguration und bündeln Sie den Code, ohne ihn bereitzustellen:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
Die erzeugte Datei sollte AI: Ai und DOCUMENTS: VectorizeIndex enthalten. Der Dry Run beweist, dass Quellcode und Konfiguration gemeinsam gebündelt werden. Er erstellt oder testet jedoch keine der beiden Cloud-Ressourcen.
Einen filterbaren Index erstellen und bereitstellen
In diesem Schritt erstellen Sie den kompatiblen Index, bereiten das Feld category für Filter vor und stellen den Worker erst bereit, nachdem diese Vorbereitung verarbeitet wurde.
Ein Vektor kann Metadaten speichern, ohne dass diese durchsuchbar sind. Ein Metadatenindex teilt Vectorize mit, welches Feld für Abfragen mit Filterpriorität organisiert werden soll. Er muss vor dem Einfügen der Dokumentvektoren existieren. Andernfalls nehmen frühere Datensätze an diesem Metadatenfilter nicht teil.
Erstellen Sie einen Index mit 384 Dimensionen und Kosinusmetrik, passend zu BGE Small. --update-config=false verhindert, dass Wrangler das bereits geprüfte explizite Binding umschreibt:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Planen Sie nun die Vorbereitung des Zeichenkettenfelds category ein und speichern Sie die Mutations-ID:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Eine akzeptierte Mutation ist eine eingereihte Aufgabe, aber noch keine abgeschlossene Aufgabe. Schreiben Sie eine begrenzte, schreibgeschützte Warteschleife, die Sie nach dem Seeding erneut verwenden. Sie benötigt drei aufeinanderfolgende Lesevorgänge mit derselben Mutation und Vektoranzahl, damit ein kurzzeitig veralteter Lesevorgang nicht zum abschließenden Beleg der Übung wird:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
Die Mutation kann verarbeitet sein, bevor die separate Listenansicht aktualisiert wurde. Verwenden Sie eine begrenzte, schreibgeschützte Schleife. So warten Sie auf die sichtbare Zeile category, anstatt eine einzelne veraltete Listenantwort als Fehler zu behandeln:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Erwarten Sie category mit dem Typ String. Stellen Sie anschließend den Worker bereit, dessen DOCUMENTS-Binding auf diesen vorbereiteten Index zeigt:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Der Index ist weiterhin leer. Die Bereitstellung verbindet die Bindings, erstellt aber nicht automatisch Dokument-Embeddings.
Zwei Kundennamensräume mit Daten füllen
In diesem Schritt erstellen Sie echte Embeddings und speichern jeden Datensatz mit seinen Kategoriemetadaten genau in einem Kundennamensraum.
Ein Namespace gehört zum Vektordatensatz selbst. Die beiden Passwortdatensätze enthalten absichtlich denselben Text, befinden sich aber in unterschiedlichen Partitionen. category ist davon unabhängige Metadaten. Ein Datensatz kann daher gleichzeitig zum Namespace blue und zur Kategorie account gehören.
Rufen Sie den festen Seed-Endpunkt einmal auf. Das Korpus wird vom Server kontrolliert, daher bleibt der Request-Body leer:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
Erwarten Sie count: 4, 384 Dimensionen, cls-Pooling und eine Mutations-UUID. Warten Sie auf genau diese Mutation und Anzahl, statt die benötigte Zeit des Dienstes zu schätzen:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Das Inventar sollte blue-password, blue-invoice, green-password und green-upload enthalten. IDs verknüpfen Treffer mit den Quelldokumenten. Namespace und Kategorie bestimmen, ob ein ansonsten ähnlicher Datensatz für eine Abfrage zugelassen ist.
Isolation nach Kunde und Kategorie nachweisen
In diesem Schritt führen Sie dieselbe semantische Frage für zwei Kunden aus und testen anschließend ein autorisiertes leeres Ergebnis sowie einen unsicheren Override.
Starten Sie mit der synthetischen Sitzung blue und der Kategorie account:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
Die Antwort sollte customer: blue, namespace: customer-blue und ausschließlich blue-password melden. Senden Sie nun dieselbe Frage mit der Sitzung green:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
Diesmal ist nur green-password zugelassen. Der Dokumenttext ist identisch. Der Unterschied entsteht daher durch den Namespace, den die validierte Sitzung auswählt, nicht durch das Embedding-Modell oder einen zufälligen Score.
Fragen Sie als Nächstes mit der Sitzung blue nach der Kategorie files. Es gibt einen sehr passenden Upload-Artikel im Namespace green, aber der Namespace blue enthält keinen Dateiartikel:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
Erwarten Sie candidateCount: 0 und matches: []. Leer ist hier das korrekte autorisierte Ergebnis. Einen passenden Datensatz aus einem anderen Namespace zu übernehmen, wäre ein Datenleck.
Versuchen Sie zum Schluss, den Namespace im Request-Body zu überschreiben:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
Erwarten Sie HTTP 400 und scope_override_not_allowed. Der Worker weist das Feld zurück, bevor Embeddings erstellt oder Vectorize-Abfragen ausgeführt werden. Ein Client darf eine zulässige Kategorie anfordern. Nur vertrauenswürdige Serverlogik darf jedoch die Identität einem Kundennamespace zuordnen.
Öffnen Sie Workers & Pages → Ihren labex-c08-v04-...-Worker → Bindings. Bestätigen Sie, dass AI auf Workers AI und DOCUMENTS auf den genau passenden kurzlebigen Vectorize-Index zeigt. Diese visuelle Zuordnung erklärt, wie env.AI und env.DOCUMENTS im Code die verwalteten Dienste erreichen. Die unabhängigen Prüfungen belegen weiterhin die exakten Binding-Identitäten.
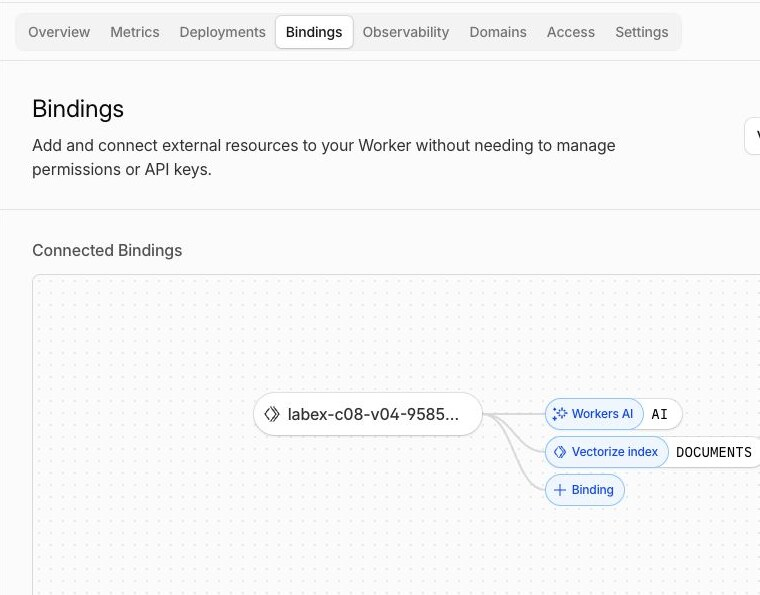
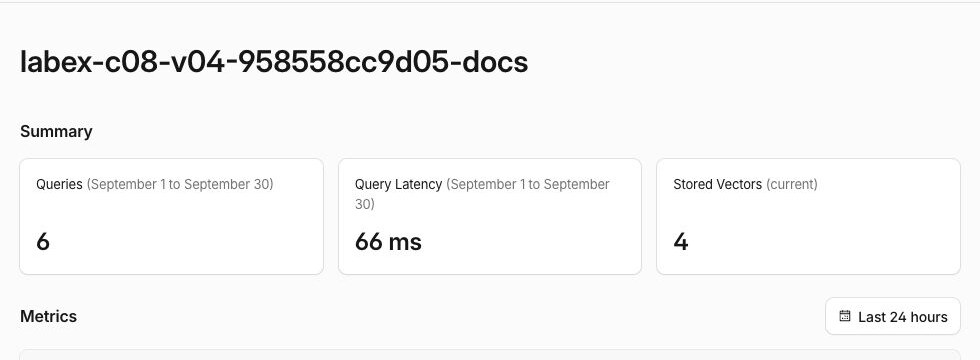
Öffnen Sie anschließend AI → Vectorize → den passenden -docs-Index. Die aktuelle Vektoranzahl sollte schließlich vier erreichen, und die Abfragemetriken sollten die begrenzten Suchvorgänge nach und nach widerspiegeln. Dashboard-Zähler können verzögert aktualisiert werden. Die authentifizierten Datensatzabfragen und HTTP-Antworten bleiben für exakte IDs, Namespaces und Kategorien maßgeblich.
Wenn Workers Logs verfügbar sind, öffnen Sie die Ansicht Observability → Logs des Workers und prüfen Sie einen Eintrag scoped_search. Er protokolliert nur die synthetische Kundenbezeichnung, den Namespace, die Kategorie und die Anzahl der zurückgegebenen Treffer, nicht den Fragetext oder die Sitzungsbezeichnung. Strukturierte Logs mit begrenztem Datenschutzumfang helfen bei der Diagnose des serverseitig ausgewählten Suchbereichs, ohne vertrauliche Request-Inhalte zu kopieren.
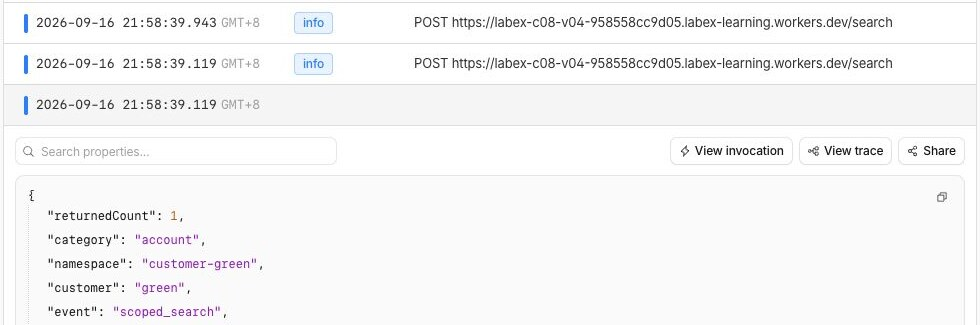
Diese Screenshots sind fokussierte Beispiele aus einem einzelnen kurzlebigen Testlauf. Ihr zufälliger Ressourcenname, die Zeitstempel, die Latenz und die Abfrageanzahl werden abweichen. Vergleichen Sie daher Binding-Namen, aktuelle Vektoranzahl und Feldbeziehungen, statt die Beispielwerte zu übernehmen.
Ressourcen der begrenzten Suche entfernen
In diesem Schritt entfernen Sie den kurzlebigen Worker und den Index. Anschließend weisen Sie deren Abwesenheit nach, solange Wrangler noch autorisiert ist.
Ermitteln Sie die exakten Namen aus wrangler.jsonc, damit die Bereinigung nicht von Variablen aus einer früheren Terminalsitzung abhängt:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Bestätigen Sie, dass beide Werte mit Ihrem eindeutigen Präfix labex-c08-v04-... beginnen. Löschen Sie zuerst den Worker, damit kein bereitgestellter Code das Binding behält. Löschen Sie anschließend nur den zugehörigen Index:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Speichern Sie ein erfolgreich authentifiziertes Inventar und prüfen Sie den exakten Namen:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Schließen Sie diesen Schritt vor dem Abmelden ab. Ein Netzwerk- oder Autorisierungsfehler ist nicht eindeutig. Die Bewertung erfordert unabhängig davon erfolgreiche Kontoabfragen und das Fehlen des exakten Namens.
Von der Lern-VM abmelden
In diesem Schritt entfernen Sie die temporäre Wrangler-Autorisierung dieser VM. Die Cloud-Ressourcen sind bereits gelöscht, und die authentifizierte Bereinigungsprüfung war erfolgreich:
npx wrangler logout
npx wrangler whoami --json
Erwarten Sie loggedIn: false. Die Browsersitzung im Cloudflare Dashboard ist davon getrennt und bleibt für Ihr Lernkonto verfügbar.
Zusammenfassung
Sie haben der semantischen Suche zwei unabhängige Zulässigkeitsprüfungen hinzugefügt. Eine validierte synthetische Sitzung wählte serverseitig einen Kundennamespace aus. Ein indiziertes Feld category schränkte diese Partition anschließend ein, bevor Vectorize die Ergebnisse bewertete. Identische Passwortdokumente zeigten, dass Ähnlichkeit allein keine Kundenisolation erzwingen kann. Die Abfrage nach Dateien für blue zeigte außerdem, dass ein autorisiertes leeres Ergebnis sicherer ist, als einen passenden Datensatz eines anderen Kunden zu übernehmen.
Außerdem haben Sie vom Client gelieferte Überschreibungen von Kunde und Namespace vor der Inferenz zurückgewiesen, die tatsächlichen Beziehungen zwischen Binding, Index und datenschutzbegrenzten Logs im Dashboard geprüft, den kurzlebigen Worker und Index mit bestehender Autorisierung entfernt und sich anschließend abgemeldet. V05 verwendet diese sichere Abrufgrenze erneut, um begrenzte Quellenbelege zusammenzustellen, bevor ein Sprachmodell antwortet.