Einführung
V01 hat identifizierte Vektoren gespeichert, und V02 hat diese Datensätze aktuell gehalten. Dieses Lab ergänzt den noch fehlenden Leseweg: Eine Person gibt eine Frage ein, die Anwendung wandelt diesen Text in einen kompatiblen Vektor um und fragt Vectorize, welche gespeicherten Dokumente in die ähnlichsten Richtungen zeigen.
Das ist semantische Suche. Dabei werden bedeutungsorientierte Embeddings verglichen, anstatt zu verlangen, dass die Abfrage exakt die Wörter eines Artikels wiederholt. Die Abfrage und die gespeicherten Dokumente müssen dasselbe Modell, 384 Dimensionen und cls-Pooling verwenden. Ein Vectorize-Ähnlichkeitsscore hilft dabei, kompatible Vektoren für eine Abfrage zu ordnen. Er ist jedoch weder eine allgemeingültige Vertrauenswahrscheinlichkeit noch ein Beweis dafür, dass ein Artikel die Frage beantwortet.
Sie erstellen einen temporären Worker mit zwei Cloudflare-Bindings. AI sendet kurze Texte an das von Cloudflare gehostete Embedding-Modell @cf/baai/bge-small-en-v1.5. DOCUMENTS schreibt in einen temporären Vectorize-Index und fragt ihn ab. Der Worker stellt eine feste /seed-Operation für drei künstliche Hilfeartikel und eine /search-Operation bereit, die eine Abfrage, topK und optional einen MindestsScore akzeptiert. topK bedeutet „höchstens diese Anzahl der nächsten Kandidaten zurückgeben“ und nicht „diese Kandidaten sind definitiv relevant“.
Dies ist das dritte Vectorize-Lab. Wenn Sie direkt hier eingestiegen sind, bearbeiten Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden und anschließend V01 und V02, damit Ihnen Index-Kompatibilität, stabile IDs und asynchrone Mutationen vertraut sind.
Für Vectorize und Workers AI gibt es kostenlose Kontingente. Dieses Lab speichert drei kleine Vektoren und führt nur wenige kurze Embedding-Anfragen aus. Workers Paid ist nicht erforderlich. Lokale oder bereitgestellte Inferenz verbraucht trotzdem das gemeinsame tägliche Workers-AI-Kontingent. Beenden Sie den Vorgang, statt wiederholt zu versuchen, wenn das Modell oder das kostenlose Kontingent nicht verfügbar ist.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 als projektlokale Version in /home/labex/project/vector-search. Es stellt deterministische Tests und unabhängige Prüfungen bereit, autorisiert Wrangler jedoch nicht, ruft kein Modell auf, erstellt keinen Index, stellt keinen Worker bereit und legt keine Cloud-Daten an.
Suchressourcen autorisieren und benennen
In diesem Schritt autorisieren Sie die neue VM und erstellen eine Konfiguration, die den Worker und den zugehörigen Vectorize-Index benennt.
Wechseln Sie in das vorbereitete Projekt und prüfen Sie die festgelegte CLI-Version:
cd /home/labex/project/vector-search
npx wrangler --version
Erwarten Sie 4.132.0. Wrangler verwendet einen Device-Flow, sodass Ihr Passwort nie in die VM eingegeben wird. Fordern Sie für diese temporäre Übung Zugriff auf die Kontoidentität, den Worker, Vectorize und Workers AI an:
Wrangler trennt die Indexoperation von der Bereitstellung des Scripts und den Prüfungen zur Bereinigung. Fordern Sie workers:write für Vectorize, workers_scripts:write für den Worker, workers_kv:write für Wranglers abhängigkeitssichere Löschprüfung und ai:write für das Model-Binding an:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Bestätigen Sie loggedIn: true und das vorgesehene Lernkonto. Erzeugen Sie ein zufälliges Suffix und leiten Sie daraus beide Ressourcennamen ab, damit die Bereinigung sie nicht mit unabhängigen Ressourcen verwechselt:
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Ersetzen Sie YOUR_ACCOUNT_ID durch die tatsächliche ID des ausgewählten Kontos. Ein Binding ist der Name, über den der Worker-Code einen verwalteten Cloudflare-Dienst erhält. AI stellt die Modellinferenz bereit; DOCUMENTS stellt genau den Vectorize-Index bereit, der mit index_name angegeben ist.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
Die Konfiguration benennt die Ressourcen, erstellt sie aber nicht. Durch diese Trennung können Sie die vorgesehene Zuständigkeitsgrenze prüfen, bevor sich etwas im Konto ändert.
Den gebundenen Such-Worker erstellen
In diesem Schritt implementieren Sie den festen Dokumentbestand und den Suchendpunkt für Lernende, bevor Sie Code bereitstellen.
Die drei Quelldokumente bleiben im Anwendungscode, weil Vectorize Vektoren und Metadaten speichert, nicht das vollständige System of Record der Artikel. /seed bettet diesen festen Bestand einmalig ein. /search bettet eine validierte Abfrage ein, fragt Vectorize nach den nächsten topK-Kandidaten und wendet anschließend minScore an. Die zurückgegebenen Metadaten helfen der Anwendung, Vektor-IDs wieder in nützliche Verweise umzuwandeln.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Führen Sie die deterministischen Tests aus. Sie ersetzen beide Bindings durch kleine In-Memory-Fixtures und prüfen daher Validierung und Kontrollfluss, ohne AI- oder Vectorize-Kontingent zu verbrauchen:
node --test test/worker.test.mjs
Erwarten Sie fünf erfolgreiche Tests. Erzeugen Sie anschließend die Binding-Typen und lassen Sie Wrangler den Worker bündeln, ohne ihn bereitzustellen:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
Die erzeugte Typdatei sollte sowohl AI: Ai als auch DOCUMENTS: VectorizeIndex enthalten. Ein Dry Run beweist, dass Modul und Konfiguration gemeinsam gebündelt werden können. Er beweist jedoch nicht, dass die Cloud-Dienste existieren.
Den Index erstellen und beide Bindings bereitstellen
In diesem Schritt erstellen Sie zunächst den leeren kompatiblen Index und stellen anschließend den Worker bereit, der beide verwalteten Bindings erhält.
Das Embedding-Modell gibt 384 Zahlen zurück. Die Kosinusdistanz vergleicht ihre Richtung. Erstellen Sie daher einen Index mit demselben unveränderlichen Vertrag:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Stellen Sie den Worker erst bereit, nachdem der Index existiert, da Cloudflare das konfigurierte DOCUMENTS-Binding einer echten Ressource zuordnen muss:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler sollte beide Bindings auflisten und die workers.dev-URL ausgeben. Speichern Sie die exakte URL, statt eine Subdomain zu erraten:
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Der Index ist zu diesem Zeitpunkt absichtlich leer. Die Bereitstellung verbindet die Dienste, bettet Dokumente aber nicht automatisch ein und legt sie nicht automatisch an.
Live-Dokument-Embeddings anlegen
In diesem Schritt rufen Sie die feste /seed-Operation einmal auf, speichern ihre Mutation und warten, bis alle drei Modell-Embeddings lesbar sind.
Der Worker sendet die drei kurzen Dokumenttexte in einem Batch an BGE Small. Er prüft die zurückgegebene Form, weist stabile IDs und nützliche Metadaten zu und führt anschließend ein Upsert der Datensätze aus. Rufen Sie die Operation mit einem leeren JSON-Objekt auf, weil die Dokumentensammlung vom Server gesteuert wird:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
Erwarten Sie HTTP 202 mit Daten, die count: 3, 384 Dimensionen, cls-Pooling und eine Mutations-UUID enthalten. Die angenommene Mutation ist asynchron. Erstellen Sie daher dieselbe begrenzte Stabilitätsprüfung wie in den vorherigen Labs. execFileSync führt den festgelegten Wrangler-Prozess aus, während readFileSync die gespeicherte Seed-Antwort liest. Beide stammen aus unterschiedlichen integrierten Node.js-Modulen:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
Die drei übereinstimmenden Lesevorgänge schützen das sichtbare Ergebnis vor einem kurzzeitig veralteten Replikat. Listen Sie nach erfolgreichem Abschluss der Warteprüfung die stabilen Anwendungs-IDs auf:
npx wrangler vectorize list-vectors "$INDEX" --count=10
Das Inventar sollte password-reset, upload-pdf und billing-receipt enthalten. Ihre tatsächlichen Werte stammen vom live von Cloudflare gehosteten Modell und nicht von den deterministischen Lehrvektoren aus V01 und V02.
Ähnliche Artikel abrufen und interpretieren
In diesem Schritt senden Sie eine aussagekräftige Passwortfrage, prüfen die zwei nächsten Kandidaten und unterscheiden zwischen Rangfolge und einem ausdrücklich leeren Ergebnis.
Fordern Sie topK: 2 an. Vectorize kann den gesamten kleinen Index untersuchen, gibt aber höchstens die zwei nächsten Kandidaten zurück. Das erste Ergebnis sollte der Passwortartikel sein, weil Abfrage und Artikel trotz unterschiedlicher exakter Formulierung eine starke Bedeutungsübereinstimmung haben:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
Erwarten Sie zwei Zeilen, absteigend nach Score sortiert, mit password-reset an erster Stelle. Lesen Sie Scores vergleichend: Ein größerer Wert bedeutet für diese kompatible Abfrage und diesen Index eine größere Nähe. 0.8 bedeutet jedoch nicht „zu 80 % korrekt“. topK legt außerdem keinen Relevanzgrenzwert fest.
Stellen Sie nun eine themenfremde Frage und setzen Sie minScore: 1. Vectorize gibt weiterhin drei Kandidaten an die Anwendung zurück, aber die Anwendung entfernt jeden Kandidaten unterhalb des Grenzwerts:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
Erwarten Sie candidateCount: 3 und matches: []. Eine leere Trefferliste ist eine ausdrückliche Entscheidung der Anwendung und kein Beweis dafür, dass der Index keine Vektoren enthält.
Senden Sie abschließend eine leere Eingabe:
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
Erwarten Sie HTTP 400 und query_required. Die Validierung erfolgt vor dem Aufruf des Modells oder der Datenbank. Ungültige Eingaben verbrauchen daher weder Inferenz- noch Abfragekapazität.
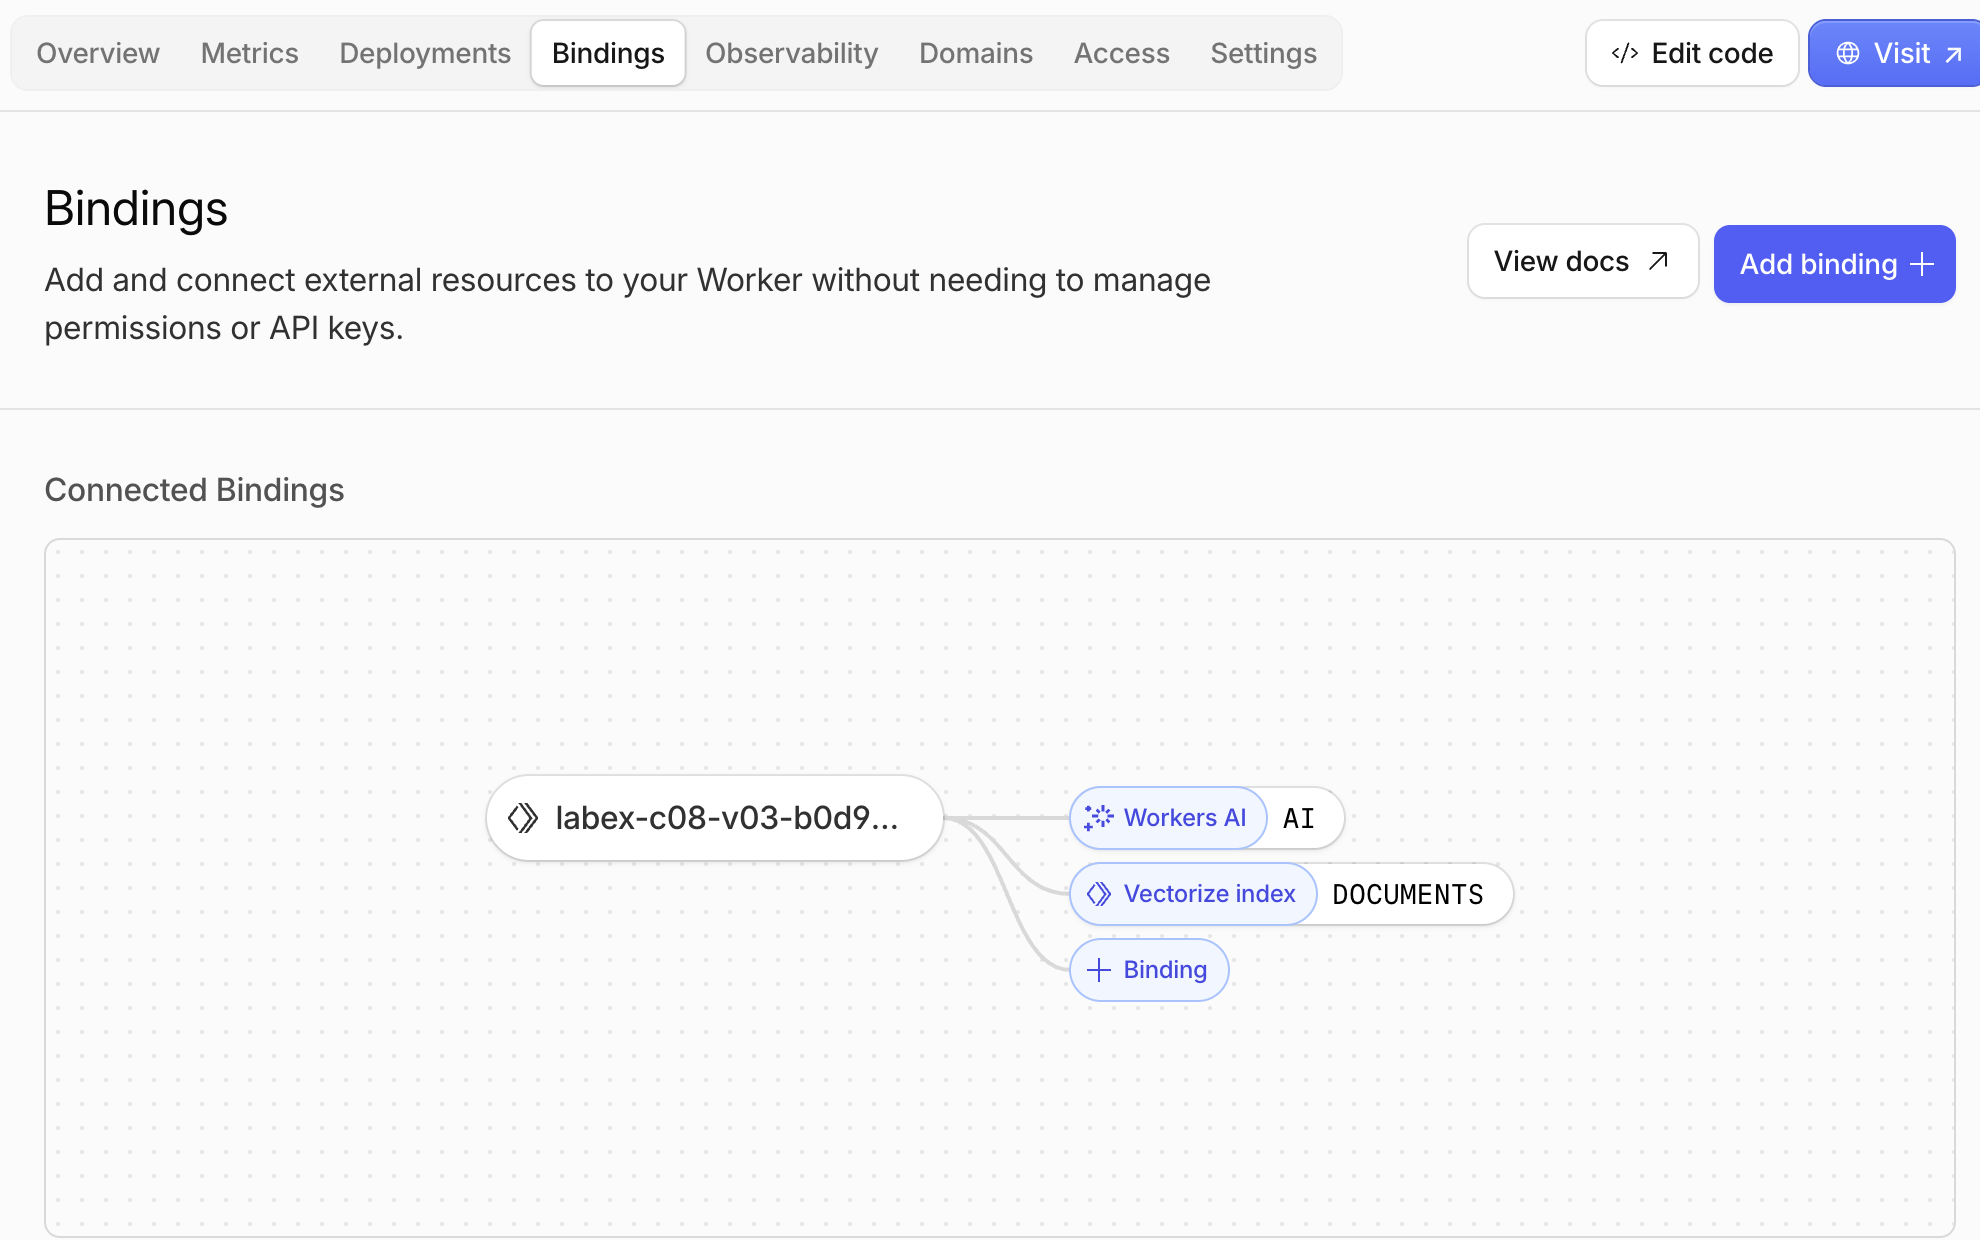
Öffnen Sie Workers & Pages → Ihren labex-c08-v03-...-Worker → Bindings. Ein Binding gibt dem Worker-Code einen sicheren Namen für einen anderen Cloudflare-Dienst. Hier ist AI der Name, den env.AI zum Ausführen des Embedding-Modells verwendet. DOCUMENTS ist der Name, den env.DOCUMENTS zur Abfrage genau dieses Vectorize-Index verwendet.
Öffnen Sie anschließend AI → Vectorize → den passenden -docs-Index. Die Zusammenfassung sollte drei aktuelle Vektoren anzeigen, je einen für jeden von Ihnen angelegten Hilfeartikel. Die Gesamtzahl der Abfragen kann vom Beispiel abweichen, weil jede erfolgreiche Suche eine weitere Abfrage hinzufügt, auch wiederholte Prüfungen.
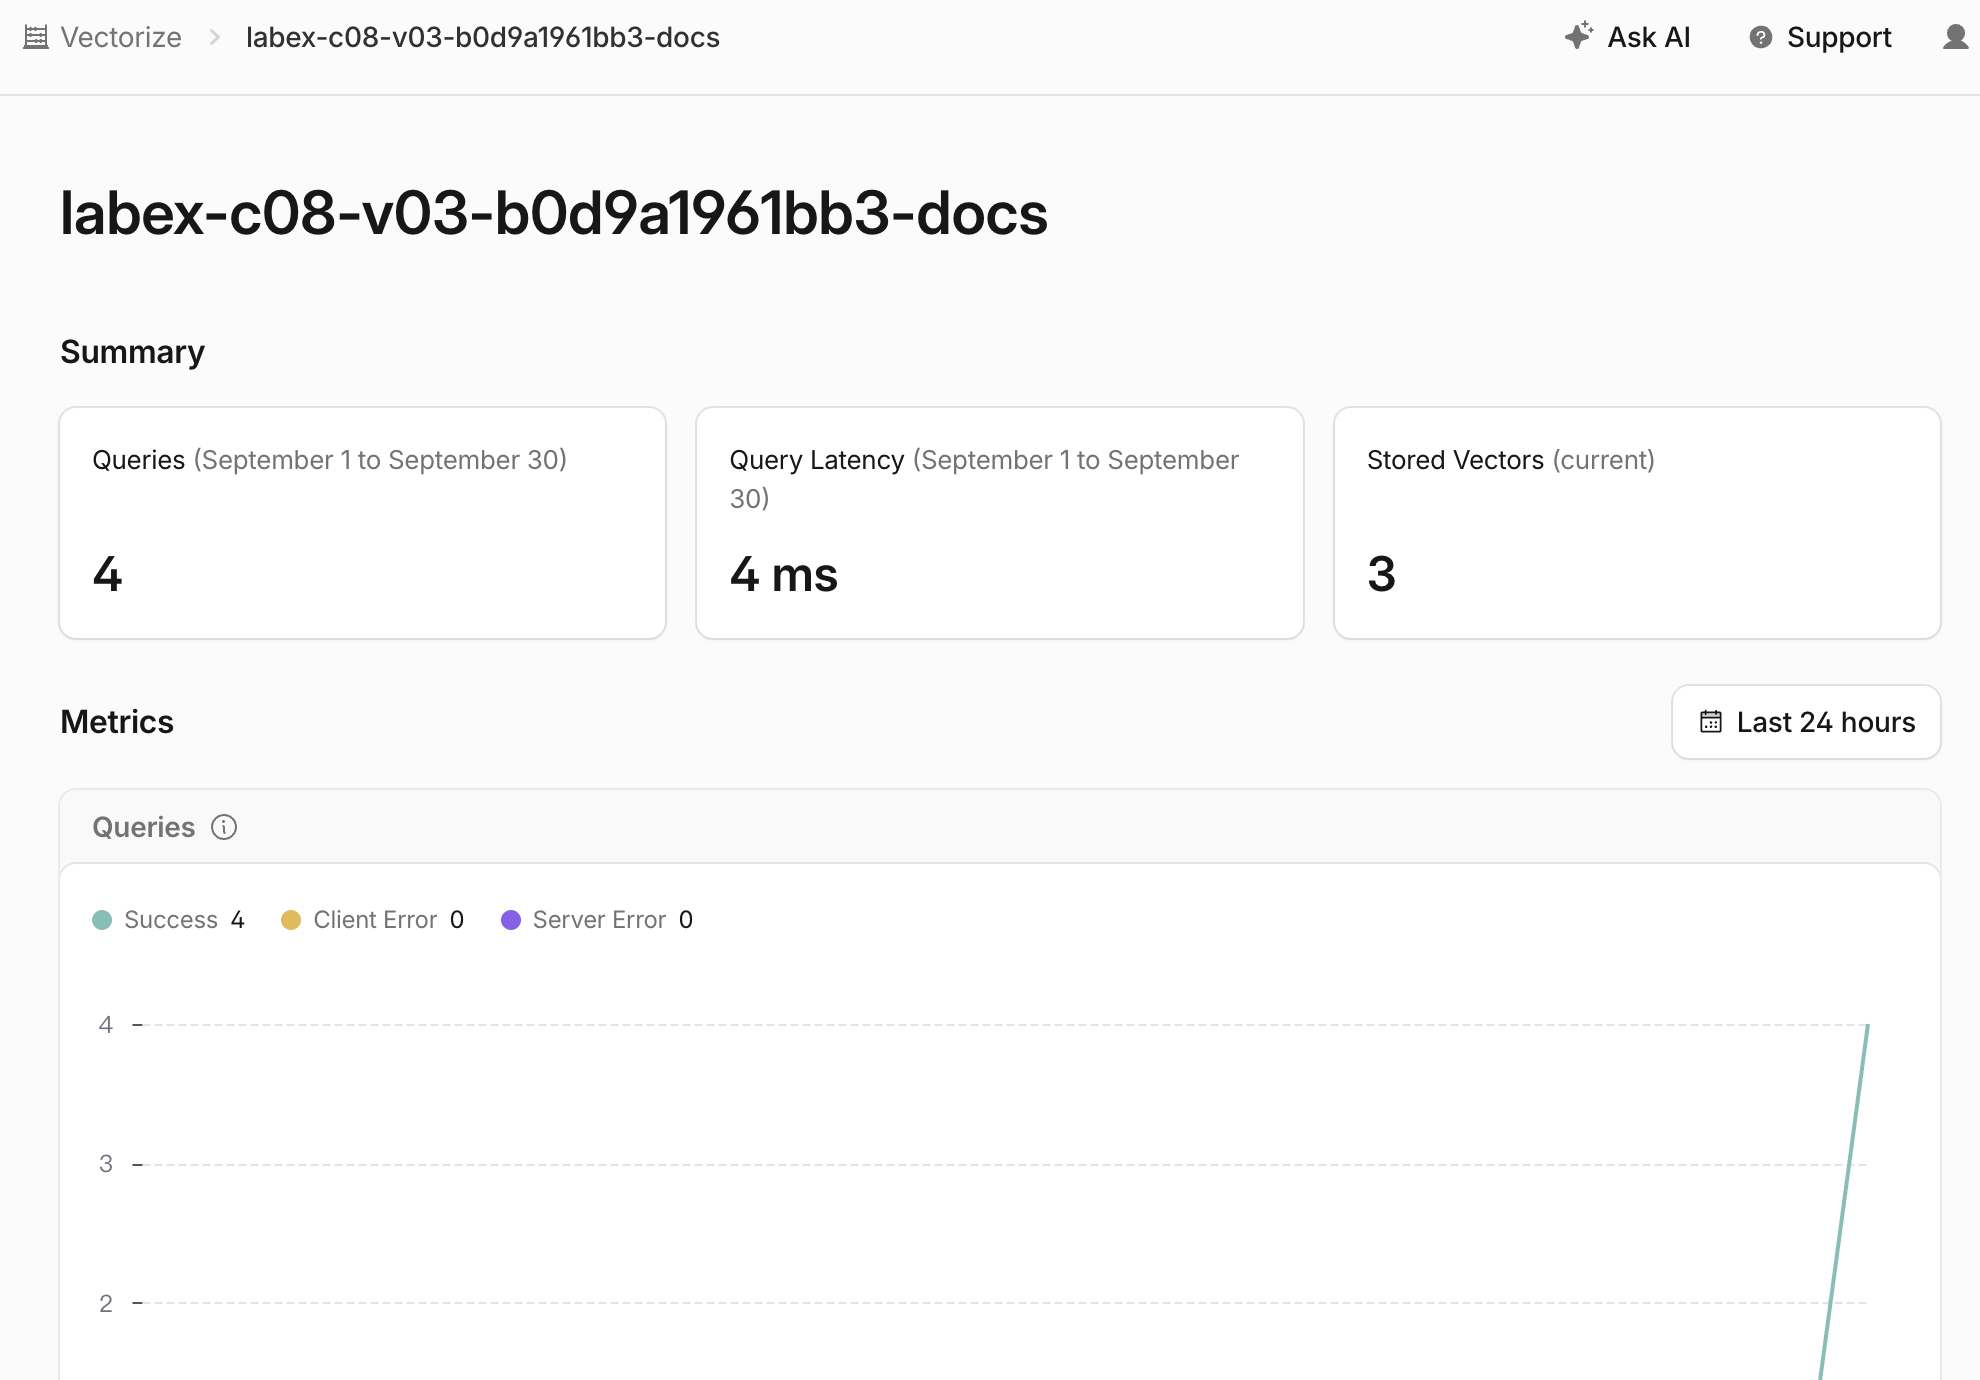
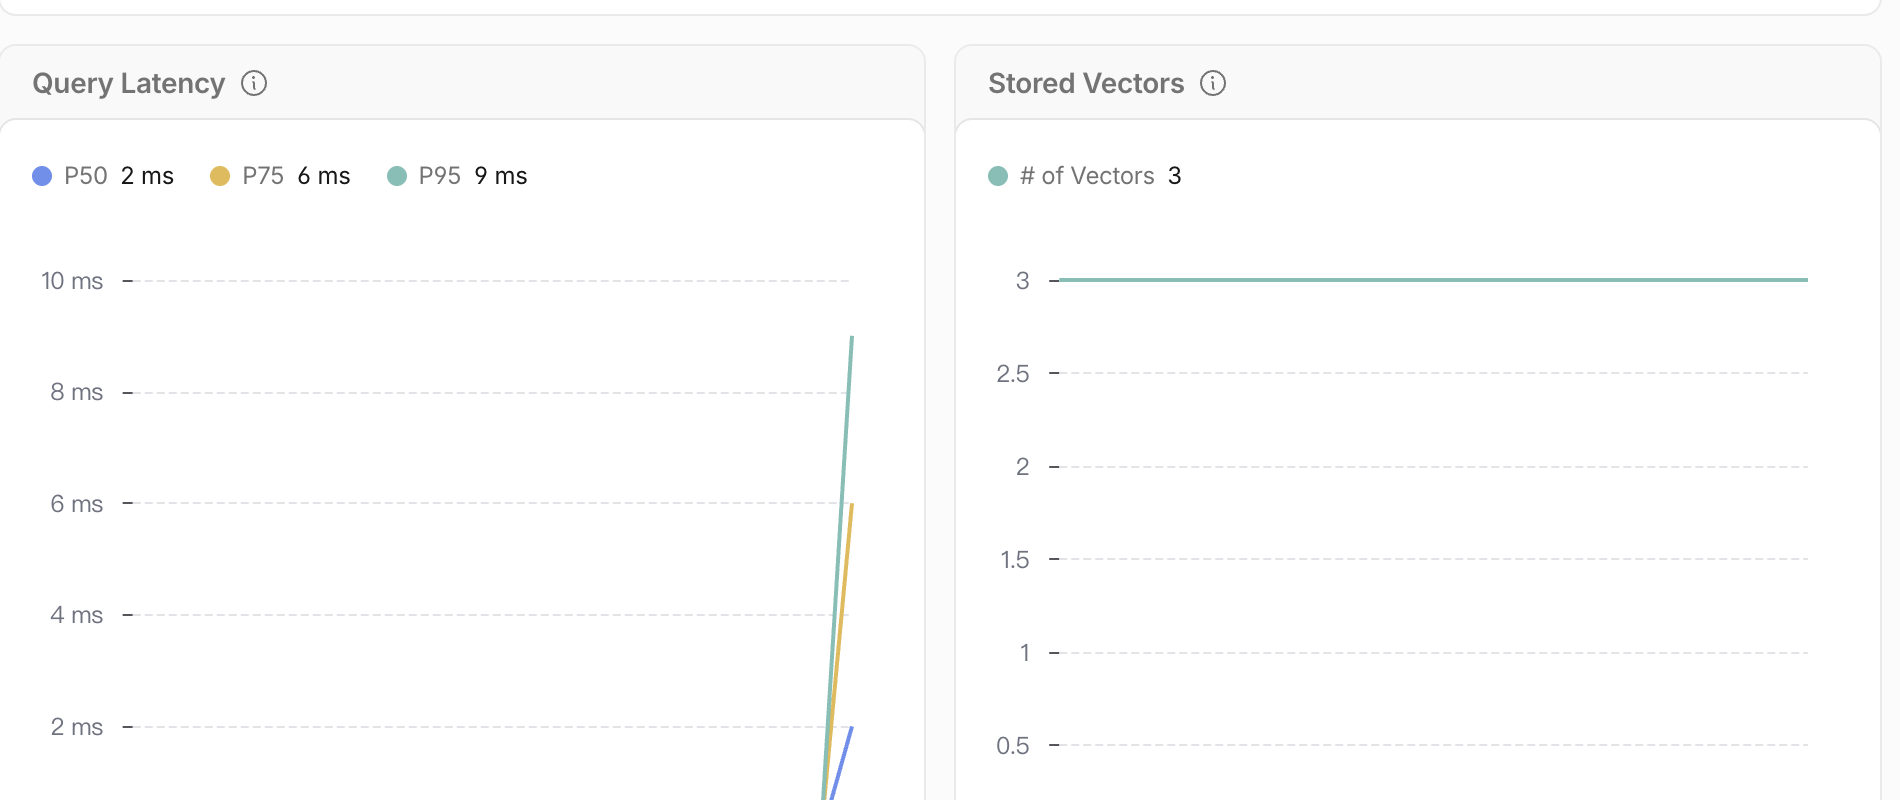
Scrollen Sie zu Metrics. P50, P75 und P95 sind Latenz-Perzentile. P95 bedeutet beispielsweise, dass 95 % der erfolgreichen Abfragen in dieser Zeit oder schneller abgeschlossen wurden. Diese Zahlen beschreiben die Geschwindigkeit, nicht die Relevanz eines Treffers. Das Diagramm „Stored Vectors“ sollte bei drei bleiben, solange Sie nur suchen und keine Dokumente hinzufügen oder entfernen.
Dashboard-Zähler können einige Augenblicke hinter dem Terminal zurückbleiben. Behandeln Sie die API-Antworten, die zurückgegebenen IDs und die unabhängigen Prüfungen als maßgebliches Ergebnis. Verwenden Sie das Dashboard, um diese Ergebnisse den Ressourcen zuzuordnen, die Sie sehen und verwalten können.
Such-Worker und Index entfernen
In diesem Schritt löschen Sie beide temporären Cloud-Ressourcen und weisen ihre Abwesenheit nach, während Wrangler noch autorisiert ist. Die Abmeldung erfolgt separat als letzter Schritt, weil die Bereinigungsprüfung Lesezugriff auf Cloudflare benötigt.
Lesen Sie zunächst die exakten Namen aus wrangler.jsonc aus. Dadurch bleibt die Bereinigung sicher, auch wenn Sie ein neues Terminal geöffnet haben und die früheren Variablen RUN und INDEX nicht mehr existieren:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Bestätigen Sie, dass beide Werte mit Ihrem eindeutigen Präfix labex-c08-v03-... beginnen, bevor Sie etwas löschen.
Löschen Sie zuerst den Worker, damit kein bereitgestellter Code mehr ein Binding auf den Index besitzt:
npx wrangler delete --name "$RUN" --force
Löschen Sie nur den zugehörigen Index und speichern Sie anschließend ein erfolgreich authentifiziertes Inventar für die Bereinigungsbewertung:
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Schließen Sie diesen Schritt jetzt und vor der Abmeldung ab. Die Bewertung liest Cloudflare unabhängig aus und wertet Authentifizierungs- oder Netzwerkfehler nicht als Beleg für eine Löschung.
Von der Lern-VM abmelden
In diesem Schritt entfernen Sie die temporäre Wrangler-Autorisierung dieser VM. Die Cloud-Ressourcen sind bereits gelöscht und die authentifizierte Bereinigungsprüfung war erfolgreich. Daher können Sie sich jetzt sicher abmelden:
npx wrangler logout
npx wrangler whoami --json
Erwarten Sie loggedIn: false. Die Browser-Sitzung im Cloudflare-Dashboard ist davon getrennt und bleibt für Ihr Lernkonto verfügbar.
Zusammenfassung
Sie haben einen Worker erstellt, der für gespeicherte Dokument-Embeddings und Live-Embeddings von Abfragen denselben Modellvertrag verwendet, drei stabile IDs in Vectorize angelegt und auf die tatsächliche asynchrone Mutation gewartet. Sie haben topK verwendet, um die Anzahl der Kandidaten zu begrenzen, Scores als relative Rangsignale interpretiert, Metadaten statt roher Vektoren zurückgegeben und nach der Schwellenwertprüfung der Anwendung ein ausdrücklich leeres Ergebnis erzeugt. Abschließend haben Sie beide Cloud-Bindings im Dashboard bestätigt, den temporären Worker und Index während bestehender Autorisierung entfernt und sich anschließend von der VM abgemeldet.
V04 ergänzt servergesteuerte Kundennamespaces und Metadatenfilter, sodass ein semantisch ähnlicher Datensatz nur dann zurückgegeben wird, wenn er ebenfalls zum autorisierten Suchbereich gehört.