Einführung
V01 hat für jeden Hilfeartikel einen Vektor gespeichert. Reale Artikel bleiben jedoch nicht unverändert: Anleitungen ändern sich, Titel werden korrigiert und veraltete Seiten werden außer Betrieb genommen. Ein Suchindex muss diesen Lebenszyklus abbilden. Andernfalls kann er veraltete Antworten liefern, obwohl die Quellwebsite bereits korrekt ist.
Cloudflare Vectorize stellt drei miteinander verbundene Schreiboperationen bereit:
- insert fügt eine neue Vektor-ID hinzu und sollte eine vorhandene ID nicht stillschweigend ersetzen;
- upsert bedeutet „aktualisieren oder einfügen“ und ersetzt den Vektor sowie die Metadaten für diese ID;
- delete by ID nimmt ausgewählte Datensätze außer Betrieb, ohne den gesamten Index neu aufzubauen.
Sie legen drei synthetische Dokumente an, führen für einen überarbeiteten Passwortartikel ein Upsert aus, löschen einen außer Betrieb genommenen Abrechnungsartikel und weisen nach, dass sich der unabhängige Uploadartikel nie ändert. Jede Schreiboperation gibt eine asynchrone Mutations-ID zurück. Deshalb warten Sie auf den exakt erwarteten Zustand, statt davon auszugehen, dass ein akzeptierter Schreibvorgang sofort lesbar ist.
Dies ist das zweite Vectorize-Lab. Wenn Sie direkt hier eingestiegen sind, bearbeiten Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden und anschließend V01. Dort machen Sie sich mit Indexkompatibilität, Dokument-IDs und der Sichtbarkeit von Mutationen vertraut.
Vectorize ist in Workers Free verfügbar. In diesem Lab speichern Sie höchstens drei kleine Vektoren mit 384 Dimensionen, führen begrenzte Lesevorgänge aus und rufen kein KI-Modell auf. Workers Paid und Workers AI Neurons sind daher nicht erforderlich.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 lokal im Projektverzeichnis /home/labex/project/document-lifecycle-index. Es stellt unabhängige Prüfungen mit Lesezugriff bereit, autorisiert Wrangler jedoch nicht, erstellt keinen Index, schreibt keine Vektoren und verändert Ihr Cloudflare-Konto nicht.
Einen neuen Dokumentlebenszyklus-Index autorisieren
In diesem Schritt autorisieren Sie die neue VM, halten das vorgesehene Konto fest und erstellen eine eindeutige lokale Konfiguration für einen temporären Index.
Wechseln Sie in das vorbereitete Projekt und prüfen Sie die festgelegte CLI-Version:
cd /home/labex/project/document-lifecycle-index
npx wrangler --version
Erwartet wird 4.132.0. Autorisieren Sie dasselbe Konto mit dem eingeschränkten Konto- und Workers-Ressourcenzugriff wie in V01:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
npx wrangler whoami --json
Bestätigen Sie loggedIn: true, ermitteln Sie Ihr Lernkonto und erzeugen Sie einen eindeutigen Namen:
RUN="labex-c08-v02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Ersetzen Sie YOUR_ACCOUNT_ID durch die tatsächliche ID dieses Kontos:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
Der neue Index ist unabhängig von V01. Dass Sie auf vorhandenes Wissen zurückgreifen, bedeutet nicht, dass dieser Index von der VM oder der Cloud-Ressource eines früheren Labs abhängt.
Den aktuellen Dokumentbestand anlegen
In diesem Schritt erstellen Sie den Index und fügen die drei Datensätze ein, die das aktuelle Hilfezentrum vor einer Änderung oder Stilllegung darstellen.
Erstellen Sie denselben Vertrag mit 384 Dimensionen und der Kosinusmetrik, den das BGE-Small-Embedding-Modell verwendet:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Erstellen Sie einen wiederverwendbaren Begrenzer für Wartezeiten. Drei übereinstimmende Lesevorgänge schützen das für Lernende sichtbare Ergebnis vor einer kurzzeitig veralteten Replik:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
Erzeugen Sie drei deterministische Dokumentvektoren. Das Feld revision macht eine spätere Ersetzung leicht erkennbar. Das vollständige Metadatenobjekt stellt dar, welche Informationen die Suchanwendung nach einer Aktualisierung der Quelle benötigen würde.
cat > scripts/create-seed.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const documents = [
  { id: "password-reset", axis: 0, category: "account", title: "Reset your password" },
  { id: "upload-pdf", axis: 1, category: "files", title: "Upload a PDF" },
  { id: "billing-receipt", axis: 2, category: "billing", title: "Download a billing receipt" }
];

const rows = documents.map((document) => {
  const values = Array(DIMENSIONS).fill(0);
  values[document.axis] = 1;
  return {
    id: document.id,
    values,
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      revision: 1,
      model: "@cf/baai/bge-small-en-v1.5",
      pooling: "cls"
    }
  };
});

writeFileSync("vectors/seed.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`prepared ${rows.length} current documents`);
JS
node scripts/create-seed.mjs
Fügen Sie nur neue IDs ein, bewahren Sie die vollständige Ausgabe auf und warten Sie auf die tatsächliche Mutation:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/seed.ndjson 2>&1 | tee .labex/seed-output.txt
Fahren Sie erst fort, wenn Wrangler drei eingereihten Vektoren und eine Mutations-ID meldet. Ein Authentifizierungs- oder Netzwerkfehler liefert kein eindeutiges Ergebnis. Beheben Sie den Fehler, bevor Sie warten.
SEED_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/seed-output.txt | tail -n 1)
if [ -z "$SEED_MUTATION_ID" ]; then
  printf '%s\n' 'No seed mutation ID was returned; fix the insert error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$SEED_MUTATION_ID" 3
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
Das Inventar sollte die drei stabilen Anwendungs-IDs enthalten. insert ist hier geeignet, weil es sich um neue IDs handelt. Im nächsten Schritt ersetzen Sie absichtlich eine bereits vorhandene ID.
Einen überarbeiteten Passwortartikel per Upsert ersetzen
In diesem Schritt ersetzen Sie den Vektor und die Metadaten für password-reset, behalten aber dessen stabile ID bei.
Ein upsert fügt eine fehlende ID ein oder ersetzt eine vorhandene ID. Das Ersetzen ist sinnvoll, wenn sich ein Quelldokument ändert. Sie müssen dabei jedoch die vollständigen gewünschten Metadaten senden. Es darf nicht vorausgesetzt werden, dass Felder, die im neuen Datensatz fehlen, erhalten bleiben.
Erstellen Sie Revision 2 mit einer anderen deterministischen Achse und einem aktualisierten Titel. Behalten Sie dabei alle weiterhin gültigen Metadatenfelder bei:
cat > scripts/create-update.mjs <<'JS'
import { writeFileSync } from "node:fs";

const values = Array(384).fill(0);
values[3] = 1;
const updated = {
  id: "password-reset",
  values,
  metadata: {
    category: "account",
    published: true,
    title: "Reset an expired password",
    revision: 2,
    model: "@cf/baai/bge-small-en-v1.5",
    pooling: "cls"
  }
};

writeFileSync("vectors/password-update.ndjson", JSON.stringify(updated) + "\n");
console.log("prepared password-reset revision 2");
JS
node scripts/create-update.mjs
Übermitteln Sie die Ersetzung und bewahren Sie die zugehörige Mutations-ID auf:
set -o pipefail
npx wrangler vectorize upsert "$RUN" --file=vectors/password-update.ndjson 2>&1 | tee .labex/upsert-output.txt
UPSERT_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/upsert-output.txt | tail -n 1)
if [ -z "$UPSERT_MUTATION_ID" ]; then
  printf '%s\n' 'No upsert mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$UPSERT_MUTATION_ID" 3
fi
npx wrangler vectorize get-vectors "$RUN" --ids password-reset > .labex/password-after-upsert.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/password-after-upsert.txt", "utf8");
const [row] = JSON.parse(text.slice(text.indexOf("[")));
console.table([{ id: row.id, dimensions: row.values.length, changedAxis: row.values[3], title: row.metadata.title, revision: row.metadata.revision }]);
JS
Erwartet werden dieselbe ID, 384 Dimensionen, der Wert 1 an Achse 3, der überarbeitete Titel und Revision 2. Die Gesamtzahl bleibt bei drei, weil das Upsert eine Identität ersetzt und kein viertes Dokument hinzufügt.
Ein Dokument außer Betrieb nehmen, ohne den Index neu aufzubauen
In diesem Schritt löschen Sie den außer Betrieb genommenen Abrechnungsartikel anhand seiner stabilen ID. Anschließend weisen Sie nach, dass der aktualisierte Passwortartikel und der unveränderte Uploadartikel erhalten bleiben.
Das Löschen anhand einer ID ist gezielter als das Entfernen eines Index: Der Indexvertrag und alle unabhängigen Datensätze bleiben bestehen. Übermitteln Sie nur die ID des außer Betrieb genommenen Dokuments:
set -o pipefail
npx wrangler vectorize delete-vectors "$RUN" --ids billing-receipt 2>&1 | tee .labex/delete-output.txt
Warten Sie auf die Löschmutation und eine Anzahl von zwei Vektoren:
DELETE_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/delete-output.txt | tail -n 1)
if [ -z "$DELETE_MUTATION_ID" ]; then
  printf '%s\n' 'No delete mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$DELETE_MUTATION_ID" 2
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/documents-after-retirement.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/documents-after-retirement.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map((row) => ({ id: row.id, title: row.metadata.title, revision: row.metadata.revision })));
JS
Es sollten nur password-reset mit Revision 2 und upload-pdf mit Revision 1 verbleiben. Dass billing-receipt fehlt, ist aussagekräftig, weil derselbe authentifizierte Lesevorgang auch die beiden Datensätze zurückgegeben hat, die erhalten bleiben müssen.
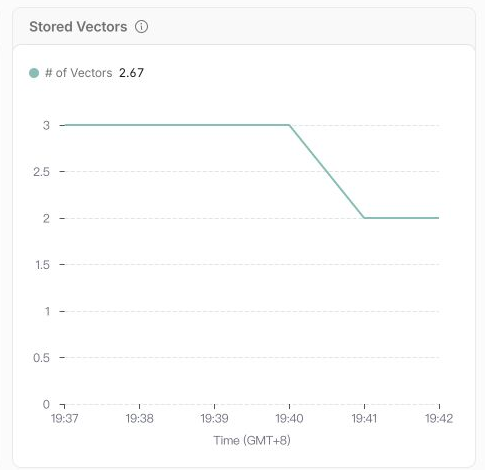
Öffnen Sie im Cloudflare-Dashboard das ausgewählte Konto und wechseln Sie zu AI → Vectorize. Öffnen Sie anschließend den unter $RUN benannten Index. Prüfen Sie, ob die Zusammenfassung zwei gespeicherte Vektoren meldet. Stellen Sie im Diagramm Stored Vectors den sichtbaren Lebenszyklus den Befehlen gegenüber: Nach der Seed-Mutation steigt die Anzahl auf drei und nach dem gezielten Löschen fällt sie auf zwei. Das Dashboard zeigt nicht, welche ID entfernt wurde. Daher bleiben die Wrangler-Ausgabe und die unabhängigen API-Lesevorgänge der maßgebliche Nachweis für die Identität.
Die Zusammenfassung zeigt den aktuellen Zustand auf einen Blick: Nach dem Außerbetriebnehmen eines Datensatzes sind weiterhin zwei Dokumente durchsuchbar.
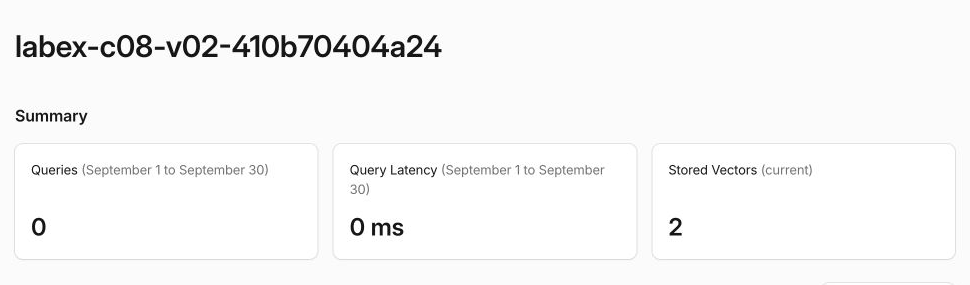
Das Diagramm stellt den Lebenszyklus bildlich dar. Der Durchschnitt kann kurzzeitig eine Dezimalzahl anzeigen, weil die Linie mehrere Ein-Minuten-Messwerte umfasst. Entscheidend ist der sichtbare Übergang von drei auf zwei gespeicherte Vektoren.
Den Lebenszyklus-Index entfernen und abmelden
In diesem Schritt entfernen Sie den gesamten temporären Index erst, nachdem Sie den gezielten Dokumentlebenszyklus nachgewiesen haben.
Das Löschen eines einzelnen Vektors im vorherigen Schritt hat den Index erhalten. Der folgende letzte Befehl entfernt absichtlich die vollständige Lab-Ressource:
npx wrangler vectorize delete "$RUN" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Führen Sie die Bereinigungsprüfung des Labs durch, solange das erfolgreiche authentifizierte Inventar noch verfügbar ist. Lassen Sie Wrangler autorisiert, bis diese Prüfung bestanden ist. Wenn Sie sich vorher abmelden, lässt sich ein Authentifizierungsfehler nicht von einer erfolgreichen Löschung unterscheiden.
Entfernen Sie anschließend die Autorisierung dieser VM und prüfen Sie das strukturierte Ergebnis:
npx wrangler logout
npx wrangler whoami --json
Erwartet wird loggedIn: false. Die separate Dashboard-Browsersitzung bleibt für Ihr Lernkonto verfügbar.
Zusammenfassung
Sie starteten mit drei aktuellen Dokument-IDs, verwendeten upsert, um den vollständigen Vektor und die Metadaten eines überarbeiteten Artikels zu ersetzen, und nahmen einen veralteten Artikel durch gezieltes Löschen außer Betrieb. Exakte Mutations-IDs und begrenzte aufeinanderfolgende Lesevorgänge unterschieden akzeptierte Schreibvorgänge von einem tatsächlich lesbaren Zustand.
Außerdem wiesen Sie die beiden Sicherheitsmerkmale nach, die in einer realen Indexierungspipeline entscheidend sind: Eine Aktualisierung erzeugte keine doppelte Identität, und das Außerbetriebnehmen entfernte keine unabhängigen Dokumente. Zum Schluss verknüpften Sie den Zustand mit zwei Datensätzen mit dem Dashboard, löschten den temporären Index, bestätigten sein authentifiziertes Fehlen und meldeten die neue VM ab.
In V03 erzeugen Sie mit demselben Modellvertrag ein Live-Query-Embedding und verwenden den gepflegten Index, um ähnliche Hilfeartikel abzurufen.