Einführung
Im vorherigen Workers-AI-Embedding-Lab wurde Text zu einem Embedding: einer geordneten Zahlenliste, die nützliche Beziehungen zwischen Bedeutungen erfasst. Ein Embedding ist weder der ursprüngliche Artikel noch eine generierte Antwort. Für die Suche wird es erst dann nützlich, wenn eine Anwendung es zusammen mit einer stabilen Dokument-ID speichern und später nahegelegene Vektoren finden kann.
Cloudflare Vectorize ist eine Vektordatenbank. Im Gegensatz zu einer Tabelle, die auf Zeilen und Spalten ausgelegt ist, ist ein Vektorindex dafür optimiert, numerische Vektoren effizient miteinander zu vergleichen. Beim Erstellen eines Index werden zwei Kompatibilitätsentscheidungen festgelegt:
- dimensions — wie viele Zahlen jeder Vektor enthält;
- distance metric — wie Vectorize entscheidet, welche Vektoren am nächsten liegen.
Sie erstellen einen Index mit 384 Dimensionen für die von Cloudflare bereitgestellten @cf/baai/bge-small-en-v1.5-Embeddings und wählen die Kosinusdistanz, also denselben richtungsbasierten Vergleich, der in A04 eingeführt wurde. Sie fügen Metadatenindizes für category und published hinzu, speichern drei kleine synthetische Vektoren von Hilfeartikeln, warten, bis die asynchrone Änderung lesbar ist, und bestätigen, dass ein dreidimensionaler Vektor abgelehnt wird.
Dies ist das erste Lab im Vectorize-Kurs. Wenn Sie direkt hier eingestiegen sind, bearbeiten Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden, damit Sie wissen, wie Sie das Terminal der LabEx-VM verwenden, Wrangler autorisieren, Ihr Lernkonto bestätigen und dessen Account-ID konfigurieren. Bearbeiten Sie zuerst Workers AI A04, wenn Vektoren, Dimensionen oder Kosinusähnlichkeit für Sie noch ungewohnt sind.
Vectorize ist im Workers-Free-Tarif verfügbar. Das aktuell enthaltene Kontingent ist deutlich größer als die drei 384-dimensionalen Vektoren und die schreibgeschützten Prüfungen dieses Labs. Workers Paid ist daher nicht erforderlich. Dieses Lab ruft Workers AI nicht auf und verbraucht keine Neurons.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 als lokale Projektabhängigkeit unter /home/labex/project/document-vector-index. Außerdem stellt es unabhängige schreibgeschützte Prüfungen bereit. Das Setup autorisiert Wrangler nicht, erstellt keinen Index, schreibt keine Vektoren und verändert Ihr Cloudflare-Konto nicht.
Die VM autorisieren und den Index benennen
In diesem Schritt autorisieren Sie die neue VM, wählen das vorgesehene Lernkonto aus und speichern einen eindeutigen Namen für den temporären Index.
Eine Anmeldung im Cloudflare Dashboard gehört zu Ihrem Browser. Wrangler in dieser neuen VM ist ein davon unabhängiger Client. Deshalb benötigt Wrangler eine eingeschränkte Autorisierung, bevor es Vectorize-Ressourcen verwalten kann.
Wechseln Sie in das vorbereitete Projekt und bestätigen Sie die festgelegte CLI-Version:
cd /home/labex/project/document-vector-index
npx wrangler --version
Erwartet wird 4.132.0. Fordern Sie die Kontoidentität und die Verwaltung von Workers-Ressourcen an. In dieser Wrangler-Version umfasst der OAuth-Scope workers:write die hier verwendeten Vectorize-Verwaltungsoperationen. Einen AI-Scope fordert das Lab nicht an, da es keine Inferenz ausführt.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
Öffnen Sie den angezeigten Link, geben Sie den aktuellen Code ein, prüfen Sie Konto und Berechtigungen und autorisieren Sie Ihr Lernkonto. Lesen Sie anschließend strukturierte Identitätsdaten aus:
npx wrangler whoami --json
Bestätigen Sie loggedIn: true und ermitteln Sie das vorgesehene Lernkonto. Erzeugen Sie einen eindeutigen Namen für den temporären Index:
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Ersetzen Sie YOUR_ACCOUNT_ID durch die tatsächliche ID dieses Kontos:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
Das Binding speichert die Beziehung, die die nächsten Labs aus dem Worker-Code verwenden werden: DOCUMENTS ist der anwendungsseitige Name, während index_name die verwaltete Cloud-Ressource bezeichnet. remote: true bedeutet, dass ein lokaler Worker eine Verbindung zum echten entfernten Index herstellt und keine isolierte lokale Simulation verwendet.
Den Index und seine filterbaren Felder erstellen
In diesem Schritt erstellen Sie den festen Vektorvertrag und bereiten zwei Metadatenfelder für spätere Filter vor.
Die Dimensionen und die Distanzmetrik eines Index sind festgelegt, weil jeder Vergleich demselben numerischen Vertrag folgen muss. BGE Small erzeugt 384 Zahlen. Die Kosinusdistanz vergleicht die Richtung von Vektoren und eignet sich daher für die bedeutungsorientierten Embeddings aus A04.
Erstellen Sie den V2-Index:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Vektoren können außerdem kleine Metadaten enthalten, etwa eine Dokumentkategorie. Das Speichern von Metadaten macht ein Feld jedoch nicht automatisch filterbar. Ein Metadatenindex teilt Vectorize mit, für welches Feld es Filter vorbereiten soll. Erstellen Sie diese Felder, bevor Sie Vektoren einfügen:
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false verhindert, dass Wrangler anbietet, das bereits geschriebene Binding zu ersetzen. Das Erstellen eines Metadatenindex erfolgt asynchron. Jeder Befehl stellt eine Änderung in die Warteschlange. Eine Erfolgsmeldung bedeutet daher, dass Cloudflare die Änderung angenommen hat, nicht dass sie bereits in jeder Lesekopie sichtbar ist.
Erstellen Sie ein kleines wiederverwendbares Warteprogramm. Es führt ausschließlich den schreibgeschützten Befehl vectorize info aus, vergleicht die exakte Änderungs-ID und verlangt drei aufeinanderfolgende übereinstimmende Lesevorgänge, bevor es dem Ergebnis vertraut. Diese zusätzliche Bestätigung verhindert, dass eine kurzzeitig veraltete Lesereplik als endgültiger Zustand angezeigt wird. Nach vier Minuten bricht das Warteprogramm mit einem Fehler ab, statt unbegrenzt zu warten:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
Die abschließenden Tabellen sollten 384 Dimensionen und die Kosinusdistanz anzeigen sowie category als String und published als Bool. Bool ist die aktuelle API-Anzeige für das mit --type=boolean erstellte Feld. Durch das Warten auf die zweite Metadatenänderung verhindern Sie, dass das Einfügen der nächsten Vektoren hinter einer noch nicht abgeschlossenen Indexvorbereitung zurückbleibt.
Identifizierte Dokumentvektoren erstellen
In diesem Schritt erzeugen Sie einen kleinen, transparenten Vektordatensatz, dessen IDs und Metadaten unabhängig geprüft werden können.
Eine Vektordatenbank ersetzt das Quelldokument nicht. Jeder Vektor benötigt eine stabile ID, über die Ihre Anwendung auf den tatsächlichen Inhalt zurückverweisen kann. Dieses Lab verwendet drei synthetische IDs von Hilfeartikeln und speichert deren Kategorie, Veröffentlichungsstatus, Embedding-Modell und Pooling-Auswahl als Metadaten.
Live-Embeddings werden in V03 verwendet. Hier sorgen deterministische Vektoren für ein reproduzierbares und kostenloses Speicherverhalten: Jedes Dokument zeigt entlang einer anderen Achse; anschließend folgen Nullen, bis 384 Positionen erreicht sind.
Erstellen Sie den transparenten Generator für den Testdatensatz:
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON bedeutet „Newline-Delimited JSON“, also durch Zeilenumbrüche getrenntes JSON: Pro Zeile steht ein vollständiges Vektorobjekt statt eines einzelnen umschließenden JSON-Arrays. Wrangler kann dieses Format in Batches verarbeiten. Prüfen Sie IDs und Strukturen, ohne alle 1.152 Zahlen auszugeben:
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Alle drei Zeilen sollten 384 Dimensionen melden. Die Metadaten zu Modell und cls-Pooling dokumentieren die Kompatibilität. Vectorize leitet diese semantische Bedeutung jedoch nicht selbst her und validiert sie auch nicht.
Die Vektoren einfügen und auf ihre Änderung warten
In diesem Schritt fügen Sie einen Batch ein und warten, bis genau diese asynchrone Änderung für Lesevorgänge sichtbar ist.
Schreibvorgänge in Vectorize erfolgen asynchron. Ein Insert erreicht zunächst ein dauerhaftes Write-Ahead-Log und gibt eine Änderungs-ID zurück. Die Hintergrundverarbeitung macht diese Änderung anschließend für Lesevorgänge sichtbar. Dieses Design hält Schreibvorgänge effizient, bedeutet aber, dass „angenommen“ und „lesbar“ zwei verschiedene Zeitpunkte sind.
Fügen Sie den Batch mit drei Vektoren ein und speichern Sie das vollständige Ergebnis. pipefail verhindert, dass ein Wrangler-Fehler durch den erfolgreichen tee-Befehl danach verborgen wird:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Fahren Sie erst fort, wenn Wrangler meldet, dass drei Vektoren in die Warteschlange gestellt wurden, und eine Änderungs-ID ausgibt. Falls die API stattdessen einen Authentifizierungs- oder Netzwerkfehler zurückgibt, ist das Ergebnis nicht eindeutig: Bestätigen Sie npx wrangler whoami --json und führen Sie anschließend genau diesen Insert-Block einmal erneut aus. Starten Sie das Warteprogramm nicht ohne eine echte Änderungs-ID.
Extrahieren Sie die angenommene Änderung und warten Sie nur, wenn sie vorhanden ist:
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
Das abschließende JSON des Warteprogramms sollte vectorCount mit dem Wert 3 und die aufgezeichnete Änderungs-ID anzeigen. Drei übereinstimmende Lesevorgänge machen das für Lernende sichtbare Ergebnis unempfindlicher gegenüber einer kurzzeitigen Verzögerung der Replikate. Begrenztes Polling ist sicherer als eine feste Wartezeit: Eine schnelle Änderung wird sofort abgeschlossen, während eine langsamere, aber fehlerfreie Änderung genügend Zeit erhält, ohne doppelte Schreibvorgänge zu erzeugen.
Die Dokumente lesen und die Kompatibilität prüfen
In diesem Schritt lesen Sie die angenommenen Datensätze, beobachten, wie ein inkompatibler Schreibvorgang abgelehnt wird, und verbinden den CLI-Zustand mit dem Dashboard.
Lesen Sie die gespeicherten Datensätze anhand ihrer Anwendungs-IDs:
Speichern Sie die vollständigen Datensätze und geben Sie anschließend eine kompakte Tabelle aus, statt das Terminal mit 1.152 Zahlen zu überfluten:
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Jede Zusammenfassungszeile sollte ihre ID, die Struktur mit 384 Werten und ihre Metadaten behalten. Die Rohdatei enthält die vollständigen Werte für eine unabhängige Prüfung. get-vectors liest bekannte Datensätze; es handelt sich nicht um eine Ähnlichkeitssuche. Ähnlichkeitsabfragen folgen in V03.
Erstellen Sie nun absichtlich einen inkompatiblen Datensatz mit nur drei Werten:
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
Die Ablehnung schützt den Indexvertrag: Ein Vektor mit drei Positionen kann nicht sinnvoll mit Vektoren mit 384 Positionen verglichen werden. Bestätigen Sie, dass die angenommenen Datensätze weiterhin vorhanden sind und die abgelehnte ID nicht erscheint:
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
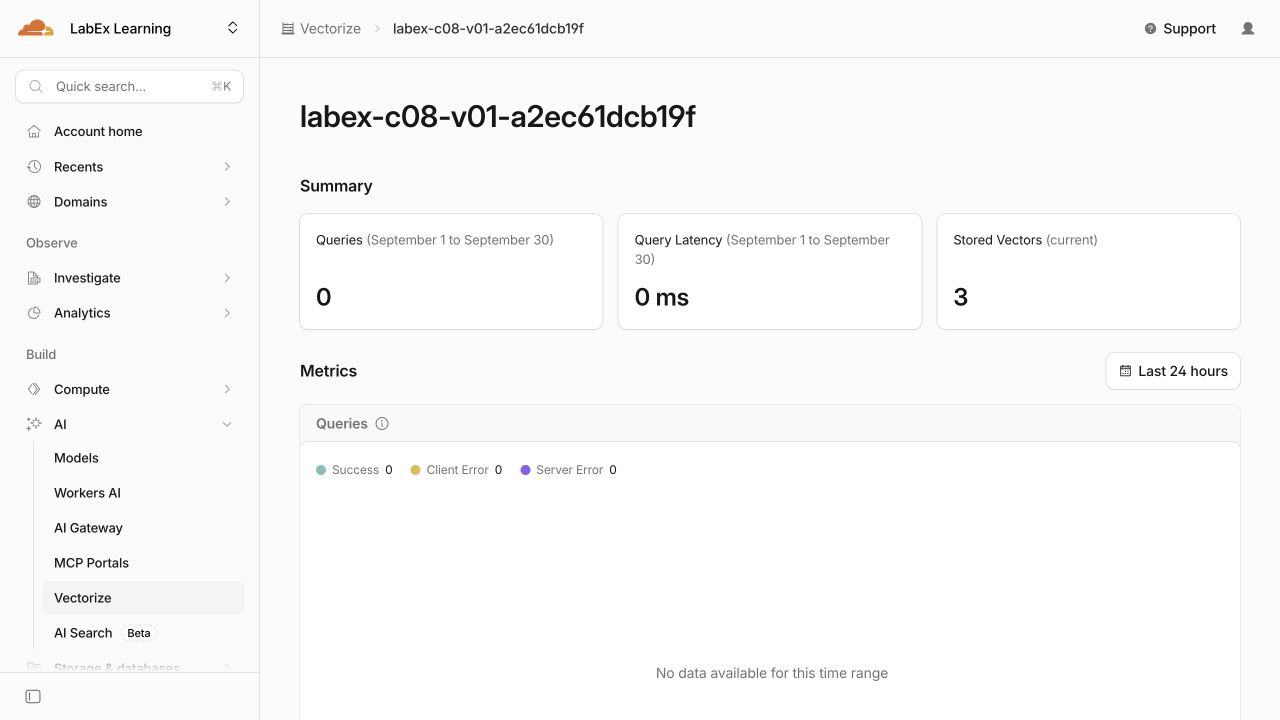
Öffnen Sie das Cloudflare Dashboard für das ausgewählte Konto und gehen Sie zu AI → Vectorize. Die Übersicht verbindet den CLI-Namen mit dem tatsächlichen Index, zeigt 384 Dimensionen und die Kosinusdistanz und meldet in diesem kleinen Beispiel insgesamt drei Vektoren ohne abrechenbare Nutzung.
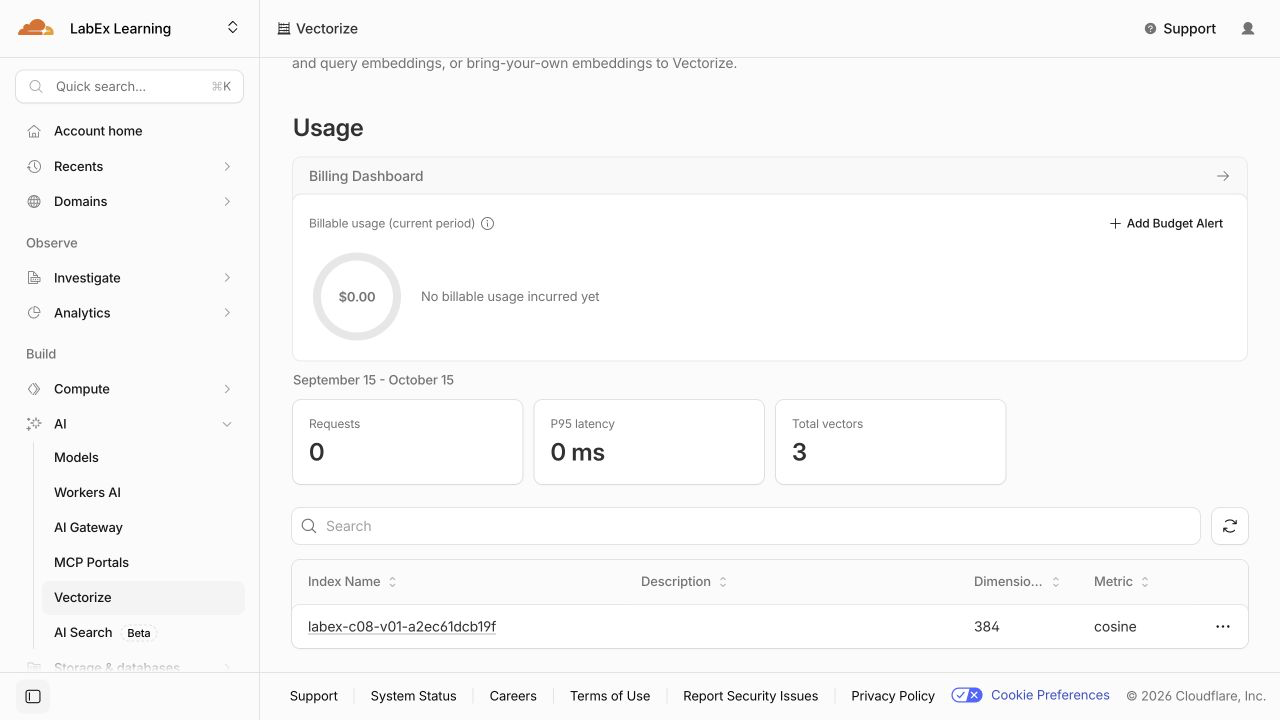
Öffnen Sie den unter $RUN benannten Index. Seine Zusammenfassung zeigt drei derzeit gespeicherte Vektoren. Die Anzahl der Abfragen bleibt null, weil dieses erste Lab ID-Lesevorgänge verwendet. Ähnlichkeitsabfragen beginnen in V03.
Scrollen Sie zu Stored Vectors. Das Diagramm macht die asynchrone Sichtbarkeit greifbar: Die Anzahl bleibt zunächst null und ändert sich dann auf drei, sobald die Einfügeänderung verarbeitet wurde.
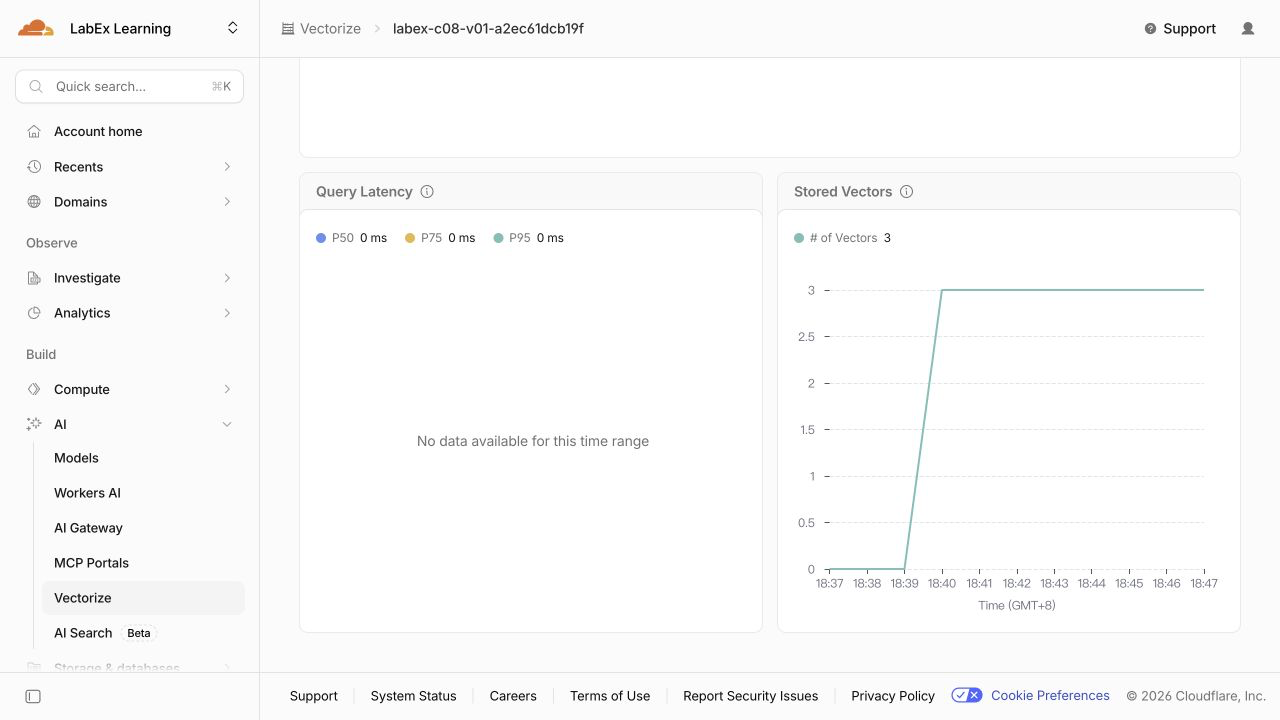
Das aktuelle Dashboard führt weder einzelne Vektor-IDs noch Definitionen von Metadatenindizes auf. Verwenden Sie die vorherigen Wrangler-Lesevorgänge für password-reset, upload-pdf, billing-receipt, category und published. Leiten Sie diese Details nicht aus einem Diagramm ab, das nur die Anzahl zeigt. Dashboard-Seiten dienen der Orientierung, während die unabhängigen Prüfungen autoritative API-Lesevorgänge verwenden.
Die hier gezeigten Screenshots stammen nach der Cloud-Akzeptanz des Labs aus einem einzelnen temporären Durchlauf und dienen als Beispiele. Ihr zufällig erzeugter Indexname und Ihre Zeitstempel werden abweichen. Vergleichen Sie die Konfiguration und die verwalteten IDs, statt Beispielwerte zu kopieren.
Den temporären Index löschen und sich abmelden
In diesem Schritt löschen Sie genau den verwalteten Index, weisen seine authentifizierte Abwesenheit nach und entfernen anschließend die Autorisierung der VM.
Der Index, seine Metadatenindizes und seine Vektoren bilden eine gemeinsame temporäre Ressource. Löschen Sie den exakten Namen, der in wrangler.jsonc gespeichert ist, solange die Autorisierung noch verfügbar ist:
npx wrangler vectorize delete "$RUN" --force
Bestätigen Sie seine Abwesenheit durch einen authentifizierten Lesevorgang der Inventarliste:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Diese erfolgreiche Inventarprüfung ist wichtig: Ein Netzwerk- oder Autorisierungsfehler würde die Löschung nicht beweisen. Führen Sie die Bereinigungskontrolle aus, bevor Sie die Autorisierung der VM widerrufen:
bash verify6-1.sh
Entfernen Sie abschließend die Wrangler-Anmeldung der VM und prüfen Sie das strukturierte Ergebnis:
npx wrangler logout
npx wrangler whoami --json
Erwartet wird loggedIn: false. Die Browser-Anmeldung im Dashboard ist davon unabhängig und bleibt für Ihr Lernkonto verfügbar.
Zusammenfassung
Sie haben einen Vectorize-V2-Index mit demselben 384-dimensionalen Vertrag wie das ausgewählte Embedding-Modell erstellt, die Kosinusdistanz gewählt und zwei Metadatenfelder für spätere Filter vorbereitet. Sie haben identifizierte deterministische Vektoren erzeugt, sie als NDJSON eingefügt, eine angenommene asynchrone Änderung von einer verarbeiteten Änderung unterschieden und die gespeicherten Datensätze per ID gelesen.
Außerdem haben Sie nachgewiesen, dass Vectorize einen Vektor mit falscher Dimension ablehnt und kompatible Datensätze beibehält. Abschließend haben Sie die tatsächliche Ressource im Dashboard geprüft, den exakten temporären Index gelöscht, seine authentifizierte Abwesenheit bestätigt und die Wrangler-Autorisierung der neuen VM entfernt.
Das nächste Lab baut auf diesem Lebenszyklus mit upsert und dem Löschen von Vektoren auf, damit geänderte und ausgemusterte Dokumente einen Index nicht veralten lassen.