Einführung
V03 wandelte Fragen in Embeddings um und rief passende Hilfeartikel ab. V04 hielt diese Ergebnisse innerhalb einer serverseitig kontrollierten Grenze für Kunden und Kategorien. Retrieval ist bereits für sich nützlich. Viele Supportanwendungen benötigen jedoch noch einen weiteren Schritt: Aus den freigegebenen Passagen soll eine kurze Antwort in natürlicher Sprache entstehen.
Dieses Muster heißt Retrieval-Augmented Generation, meist kurz RAG genannt. Die Anwendung ruft zuerst Belege ab, erstellt ausschließlich aus diesen Datensätzen einen kleinen Kontext und fordert anschließend ein Sprachmodell auf, aus diesem Kontext zu antworten. Retrieval macht ein Modell nicht automatisch wahrheitsgetreu. Die Anwendung muss weiterhin kontrollieren, welche Quellen zulässig sind, die Textmenge im Prompt begrenzen, die Identität der Quellen bewahren und abbrechen, wenn keine freigegebene Evidenz vorhanden ist.
Sie erstellen einen nicht dauerhaft benötigten Worker mit zwei Cloudflare-Bindings. DOCUMENTS durchsucht einen Vectorize-Index, während AI sowohl das BGE-Small-Embedding-Modell als auch ein von Cloudflare gehostetes Llama-Modell zur Textgenerierung ausführt. Der Worker löst die zurückgegebenen Vektor-IDs über ein im Code bereitgestelltes Korpus auf. Vektormetadaten sind für die Suche nützlich, gelten aber nicht als kanonischer Inhalt des Artikels.
Der Endpoint gibt neben der generierten Antwort ein von der Anwendung kontrolliertes Array sources zurück. Wenn das Retrieval innerhalb des ausgewählten Namespace und der ausgewählten Kategorie nichts findet, gibt der Endpoint eine feste Antwort no_evidence zurück, ohne das Textgenerierungsmodell aufzurufen. Dieser explizite Zweig ist sicherer, als ein Modell zum Improvisieren aufzufordern.
Wenn Sie diesen Kurs direkt aufgerufen haben, absolvieren Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden. V01–V04 sind Voraussetzungen. Dort werden kompatible Indizes, asynchrone Mutationen, semantisches Retrieval und serverseitig kontrollierte Gültigkeitsbereiche eingeführt.
Dieses Lab verwendet das von Cloudflare gehostete Modell @cf/meta/llama-3.3-70b-instruct-fp8-fast, da es im vorangegangenen Workers-AI-Kurs bereits mit Workers Free getestet wurde. DeepSeek V4 Flash wird zwar von Cloudflare gehostet, erfordert derzeit aber kostenpflichtigen Zugriff und ist daher keine notwendige Voraussetzung für Lernende. Das Lab sendet nur begrenzte Embedding- und Generierungsanfragen. Workers Paid ist nicht erforderlich, solange das gemeinsame kostenlose Workers-AI-Kontingent des Kontos verfügbar ist.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 lokal im Projektverzeichnis /home/labex/project/grounded-answer. Es stellt deterministische Tests und unabhängige schreibgeschützte Prüfungen bereit, autorisiert Wrangler jedoch nicht, erstellt keinen Index, stellt keinen Worker bereit, führt keine Inferenz aus und schreibt keine Cloud-Daten.
Die RAG-Ressourcen autorisieren und benennen
In diesem Schritt autorisieren Sie die neue VM, bestätigen das Lernkonto und legen vor der Erstellung ein zusammengehöriges Worker- und Vectorize-Index-Paar fest.
Wechseln Sie in das vorbereitete Projekt und prüfen Sie die festgelegten Tool-Versionen:
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Erwartet werden Node.js v22.22.0 und Wrangler 4.132.0. Die Dashboard-Anmeldung in Ihrem Browser autorisiert diese VM nicht automatisch. Verwenden Sie deshalb Wranglers Geräte-Flow mit den Berechtigungen für Kontoidentität, den temporären Worker, Vectorize und Workers AI:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Öffnen Sie den angezeigten Autorisierungslink, prüfen Sie, ob der Code übereinstimmt, und genehmigen Sie das vorgesehene Konto LabEx Learning. Senden Sie den Code, das Passwort oder das Token an niemanden. Prüfen Sie im JSON-Ergebnis, ob loggedIn: true angezeigt wird, und notieren Sie anschließend den Kontonamen und die Konto-ID.
Erzeugen Sie ein zufälliges Suffix. Beide Ressourcennamen verwenden dieses Suffix, damit Sie später genau dieses Paar löschen können:
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Erstellen Sie wrangler.jsonc. Ein Here-Dokument schreibt den Block zwischen den Markierungen JSON in die Datei. $RUN und $INDEX werden dabei durch die eindeutigen Namen dieser VM ersetzt. Ersetzen Sie YOUR_ACCOUNT_ID durch die von whoami angezeigte ID:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI ist ein einzelnes Binding, obwohl der Code darüber zwei Modelle aufrufen wird. DOCUMENTS verweist auf den zugehörigen Index. Die Datei benennt die vorgesehenen Ressourcen, erstellt sie aber noch nicht.
Den Worker für Retrieve-Then-Generate erstellen
In diesem Schritt implementieren Sie die vollständige RAG-Abfolge und überprüfen ihre Entscheidungen mit deterministischen In-Memory-Bindings, bevor Sie das Cloud-Kontingent verwenden.
Das bereitgestellte CORPUS ist die kanonische Zuordnung von IDs zu Texten. Vectorize speichert Embeddings und durchsuchbare Metadaten. Nach einer Abfrage akzeptiert der Worker jedoch nur IDs, die über diese Zuordnung aufgelöst werden können. Anschließend nimmt er höchstens zwei Passagen in den Prompt auf. Dadurch kann ein unerwarteter Indexeintrag nicht allein wegen eines hohen Scores zum Modellkontext werden.
Erstellen Sie die Worker-Quelldatei:
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Beachten Sie die Reihenfolge in answer(): Zuerst wird der serverseitig verwaltete Gültigkeitsbereich geprüft. Dann wird die Frage eingebettet, es werden höchstens zwei zulässige Treffer abgerufen, jede ID wird über CORPUS aufgelöst, der begrenzte Kontext wird erstellt und anschließend die Antwort generiert. Die öffentliche Antwort enthält weder den vollständigen Kontexttext noch die Vektorwerte, bewahrt aber auflösbare Quellenverweise.
Führen Sie die deterministische Testsuite aus:
node --test test/worker.test.mjs
Erwarten Sie sieben erfolgreich ausgeführte Tests. Die simulierten Bindings zeigen, dass unbekannte IDs und ein leeres Retrieval nie die Textgenerierung erreichen. Erzeugen Sie die Binding-Typen und bündeln Sie das Projekt, ohne es bereitzustellen:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
Die erzeugten Typen sollten AI: Ai und DOCUMENTS: VectorizeIndex enthalten. Ein Dry Run bestätigt, dass die Dateien gemeinsam gebündelt werden können. Er erstellt keine Cloud-Ressourcen und führt keines der beiden Modelle aus.
Den vorbereiteten Index erstellen und den Worker bereitstellen
In diesem Schritt erstellen Sie einen kompatiblen Vectorize-Index, bereiten category für Filtervorgänge vor und stellen den Worker bereit, sobald diese Vorbereitung stabil ist.
Erstellen Sie den 384-dimensionalen Cosine-Index für BGE Small. --update-config=false verhindert, dass Wrangler das bereits geprüfte explizite Binding überschreibt:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Erstellen Sie den String-Metadatenindex für category und speichern Sie die zurückgegebene Mutations-ID. set -o pipefail sorgt dafür, dass die Pipeline fehlschlägt, wenn Wrangler fehlschlägt, obwohl tee zusätzlich eine Kopie der Ausgabe schreibt:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Eine akzeptierte Mutation wird als ausstehende Arbeit eingeplant. Erstellen Sie einen begrenzten schreibgeschützten Wartevorgang, der genau diese Mutation und die Vektoranzahl bei drei aufeinanderfolgenden Abfragen verlangt:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
Die separate Listenansicht kann gegenüber dem Status der verarbeiteten Mutation verzögert sein. Warten Sie deshalb kurz, bis die Zeile ebenfalls sichtbar ist:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Stellen Sie den Worker abschließend bereit und speichern Sie die öffentliche Worker-URL:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Der Index ist weiterhin leer. Durch die Bereitstellung werden die Bindings verbunden. Embeddings oder Quelldatensätze werden dadurch nicht automatisch erstellt.
Das freigegebene Quellenkorpus einfügen
In diesem Schritt erstellen Sie Live-Embeddings für die drei bereitgestellten Artikel und warten, bis jede Quellen-ID lesbar ist.
Der Quelltext bleibt in CORPUS. Die Vektordatensätze enthalten das kompatible Embedding sowie wenige Suchmetadaten. Durch diese Trennung kann die Anwendung eine ID zu einem freigegebenen Artikelinhalt auflösen, statt beliebigem Text zu vertrauen, der aus Vektormetadaten kopiert wurde.
Rufen Sie den festen Seed-Endpoint einmal auf:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
Erwarten Sie drei Datensätze, 384 Dimensionen, cls-Pooling und eine Mutations-UUID. Warten Sie auf genau diesen Status und anschließend kurz darauf, dass alle drei IDs in der separaten Bestandsansicht erscheinen:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Nun verweist jede ID der Suchergebnisse auf genau einen Eintrag im Korpus. Der Index enthält absichtlich keinen Artikel der Kategorie files. Dadurch wird der Zweig ohne Evidenz sichtbar, ohne von einem Ähnlichkeitsschwellenwert abzuhängen.
Antworten mit Evidenz und ohne Evidenz vergleichen
In diesem Schritt senden Sie eine unterstützte Frage und eine Frage, für deren autorisierte Kategorie keine Quellen existieren. Der Unterschied macht den RAG-Kontrollfluss sichtbar.
Fragen Sie, wie ein abgelaufenes Passwort im Gültigkeitsbereich des blauen Kontos zurückgesetzt wird:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
Erwarten Sie mode: grounded, generated: true, eine nicht leere Antwort und ein sources-Array, das von password-reset angeführt wird. Die Formulierung Ihres Modells kann abweichen. Entscheidend ist, dass jede zurückgegebene ID, jeder Titel und jede URL über das bereitgestellte Korpus aufgelöst wird und nur freigegebene Passagen der Kategorie account in den Prompt gelangen.
Fragen Sie nun nach dem Hochladen einer Datei, behalten Sie aber denselben serverseitig kontrollierten Kundenbereich bei. files ist eine zulässige Kategorie, doch dieses Korpus enthält keinen geeigneten Dateieintrag:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
Erwarten Sie mode: no_evidence, generated: false, die feste Meldung I don't have enough approved evidence to answer that question. und sources: []. Der Worker hat die Frage weiterhin eingebettet, um danach zu suchen. Die Textgenerierung wurde jedoch übersprungen, weil kein freigegebener Kontext vorhanden war.
Testen Sie eine unsichere Anfrage, die einen eigenen Namespace übermittelt:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
Erwarten Sie HTTP 400 und scope_override_not_allowed. RAG ersetzt nicht die in V04 gelernte Autorisierungsgrenze. Das Retrieval muss sicher sein, bevor sein Text zum Modellkontext wird.
Öffnen Sie Workers & Pages → Ihren labex-c08-v05-... Worker → Bindings. Bestätigen Sie, dass AI auf Workers AI und DOCUMENTS auf den zugehörigen Vectorize-Index verweist. Diese Ansicht verbindet die beiden Dienstnamen im Code mit den tatsächlichen verwalteten Ressourcen.
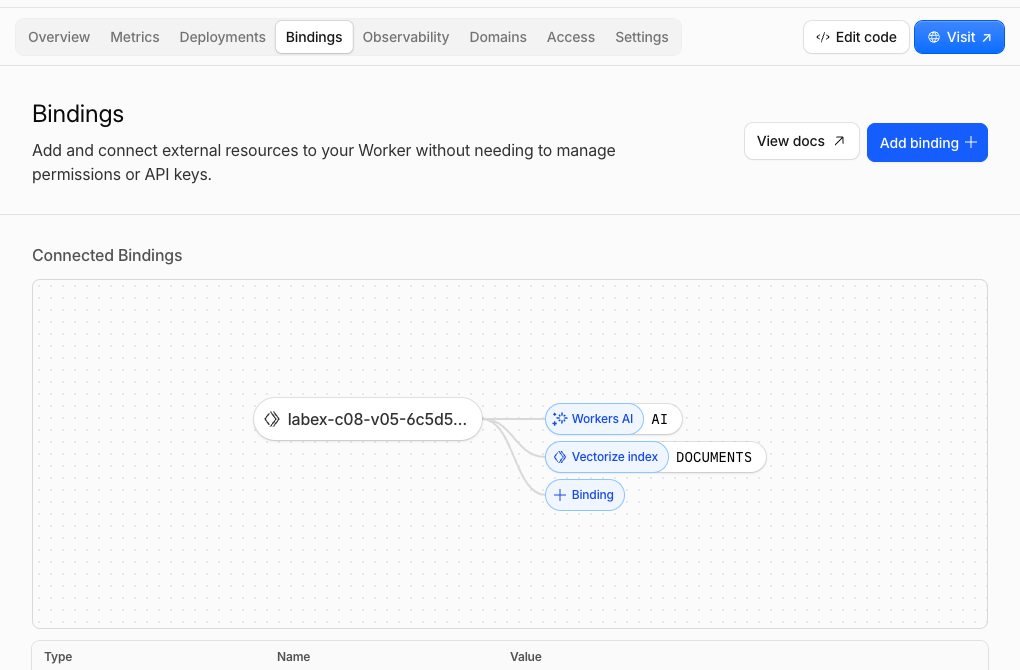
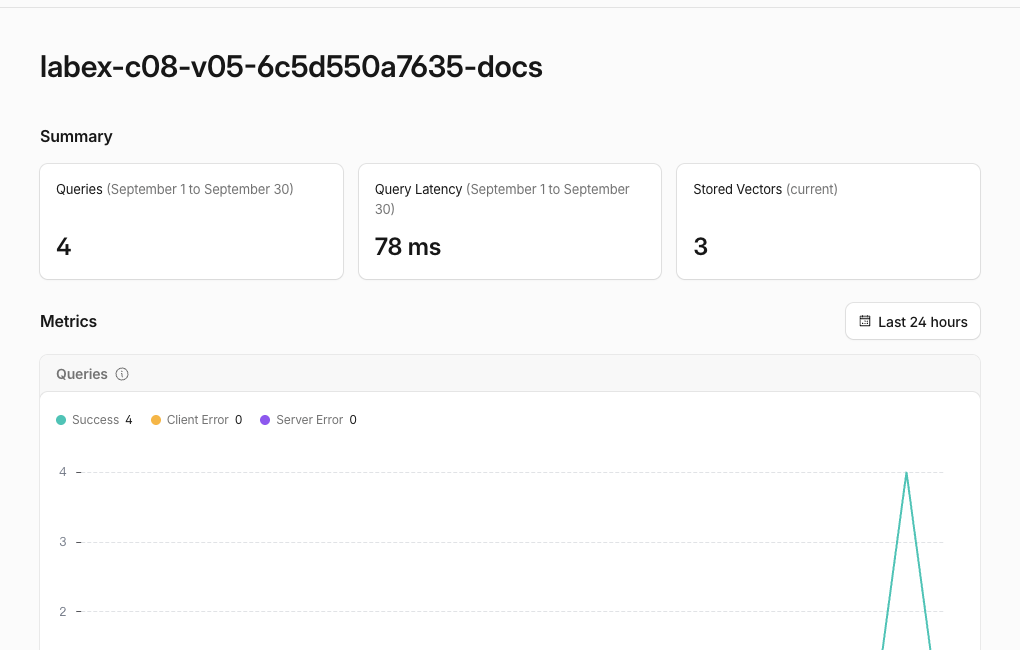
Öffnen Sie anschließend AI → Vectorize → den passenden -docs-Index. Die aktuelle Anzahl sollte schließlich drei Vektoren anzeigen, und die Abfrageaktivität sollte die Suchen mit und ohne Evidenz widerspiegeln. Dashboard-Metriken können verzögert erscheinen. Die authentifizierten ID-Abfragen und die Antworten des Endpoints bleiben daher maßgeblich.
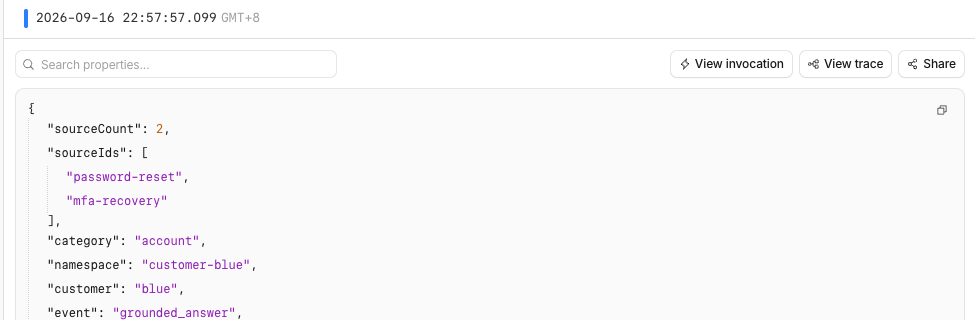
Wenn Workers Logs verfügbar sind, öffnen Sie Observability → Logs und prüfen Sie die Einträge grounded_answer und grounded_no_evidence. Die Logs enthalten Kategorie, Quellen-IDs und Anzahlen, aber weder Frage, Antwort, Passagentext, Sitzungsbezeichnung noch Vektorwerte. So erhalten Betreiber nützliche Hinweise zum Kontrollfluss, ohne den Prompt in die Logs zu kopieren.
Die Ressourcen für evidenzbasierte Antworten entfernen
In diesem Schritt löschen Sie den temporären Worker und den Vectorize-Index und weisen anschließend nach, dass beide Ressourcen nicht mehr vorhanden sind, während Wrangler weiterhin autorisiert ist.
Lesen Sie beide exakten Namen aus wrangler.jsonc, damit die Bereinigung nicht von Variablen aus einer früheren Terminalsitzung abhängt:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Bestätigen Sie, dass beide Werte das eindeutige Präfix labex-c08-v05-... verwenden. Löschen Sie zuerst den Worker, damit kein bereitgestellter Code das Binding weiter verwendet. Löschen Sie anschließend nur den zugehörigen Index:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Speichern Sie eine erfolgreiche authentifizierte Indexinventur und prüfen Sie, dass der exakte Name nicht vorhanden ist:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Führen Sie diese Prüfung vor der Abmeldung durch. Ein Netzwerk- oder Autorisierungsfehler ist nicht eindeutig. Die Bewertung verlangt unabhängig davon erfolgreiche Kontoabfragen und das Fehlen des exakten Namens.
Von der Lern-VM abmelden
In diesem Schritt entfernen Sie die temporäre Wrangler-Autorisierung dieser VM. Die Cloud-Ressourcen sind bereits nicht mehr vorhanden, und die authentifizierte Bereinigungsprüfung war erfolgreich:
npx wrangler logout
npx wrangler whoami --json
Erwarten Sie loggedIn: false. Die Cloudflare-Dashboard-Sitzung im Browser ist davon getrennt und bleibt für Ihr Lernkonto verfügbar.
Zusammenfassung
Sie haben einen kleinen Retrieval-Augmented-Generation-Endpoint erstellt: Ein serverseitig kontrollierter Gültigkeitsbereich schränkte die Vectorize-Suche ein, zurückgegebene IDs wurden über ein freigegebenes Korpus aufgelöst, höchstens zwei Passagen wurden zum Modellkontext und die Anwendung gab neben der variablen generierten Formulierung stabile Quellenverweise zurück.
Außerdem haben Sie nachgewiesen, dass eine zulässige leere Suche ohne Textgenerierung in einen festen Zweig ohne Evidenz führt. Sie haben clientseitige Überschreibungen des Gültigkeitsbereichs vor dem Retrieval abgelehnt, die Beziehungen zwischen Worker, Vectorize und datenschutzbegrenzter Beobachtbarkeit geprüft, beide temporären Ressourcen mit bestehender Autorisierung gelöscht und sich anschließend abgemeldet. Die Kursaufgabe fordert Sie auf, einen fehlerhaften Endpoint zu reparieren, der dieselbe Gültigkeitsbereichsgrenze verletzt.