Einführung
Die Riverside-Sammlung benötigt einen durchsuchbaren Index von sechs HTML-Oral-History-Dokumenten. Das bereitgestellte Containerwerkzeug parst ihr HTML tatsächlich und zählt Unicode-Wörter, aber sein Batch mit vier Workern überschreitet ein Speicherbudget von 160 MiB. Diagnostiziere diesen Fehler mit Nachweisen für den genauen Container und erstelle danach den vollständigen Index, ohne das Limit zu erhöhen oder Dokumente zu entfernen.
Du solltest grundlegendes Docker run, Terminalpfade und den Zweck von Bind-Mounts kennen. Dieses Lab erklärt Speicheroptionen, tatsächliche Benutzer-IDs, Pfade in Anführungszeichen, Befehlssubstitution und die kleine Pipeline zum Lesen der Nachweise vor der Verwendung. Python-Programmierung, HTML-Autorenschaft und Implementierung von Suchalgorithmen sind nicht erforderlich. Docker, das Indexierungs-Image und der schreibgeschützte Search Desk sind vorbereitet.
Der Korpus ist ausdrücklich synthetisch: Jedes Dokument enthält 10.000 erweiterte Unterrichtsauszüge, um tatsächlichen Parser-Speicherdruck beobachtbar zu machen. Das Ergebnis ist ein echter Index über diese Bytes, keine simulierte Allokation oder Produktionskapazitätsgarantie. Plane etwa 60 Minuten einschließlich Lesen und gewöhnlicher Fehler ein; dies ist eine Schätzung des Autors.
Den vollständigen Index innerhalb seines Budgets bauen
In diesem Schritt stellst du ein normales Suchergebnis fest, reproduzierst einen Fehler bei begrenztem Speicher, verknüpfst native Nachweise und vervollständigst die gesamte Sammlung mit einem begrenzten Batch.
Zuerst einen kleinen normalen Index nutzen
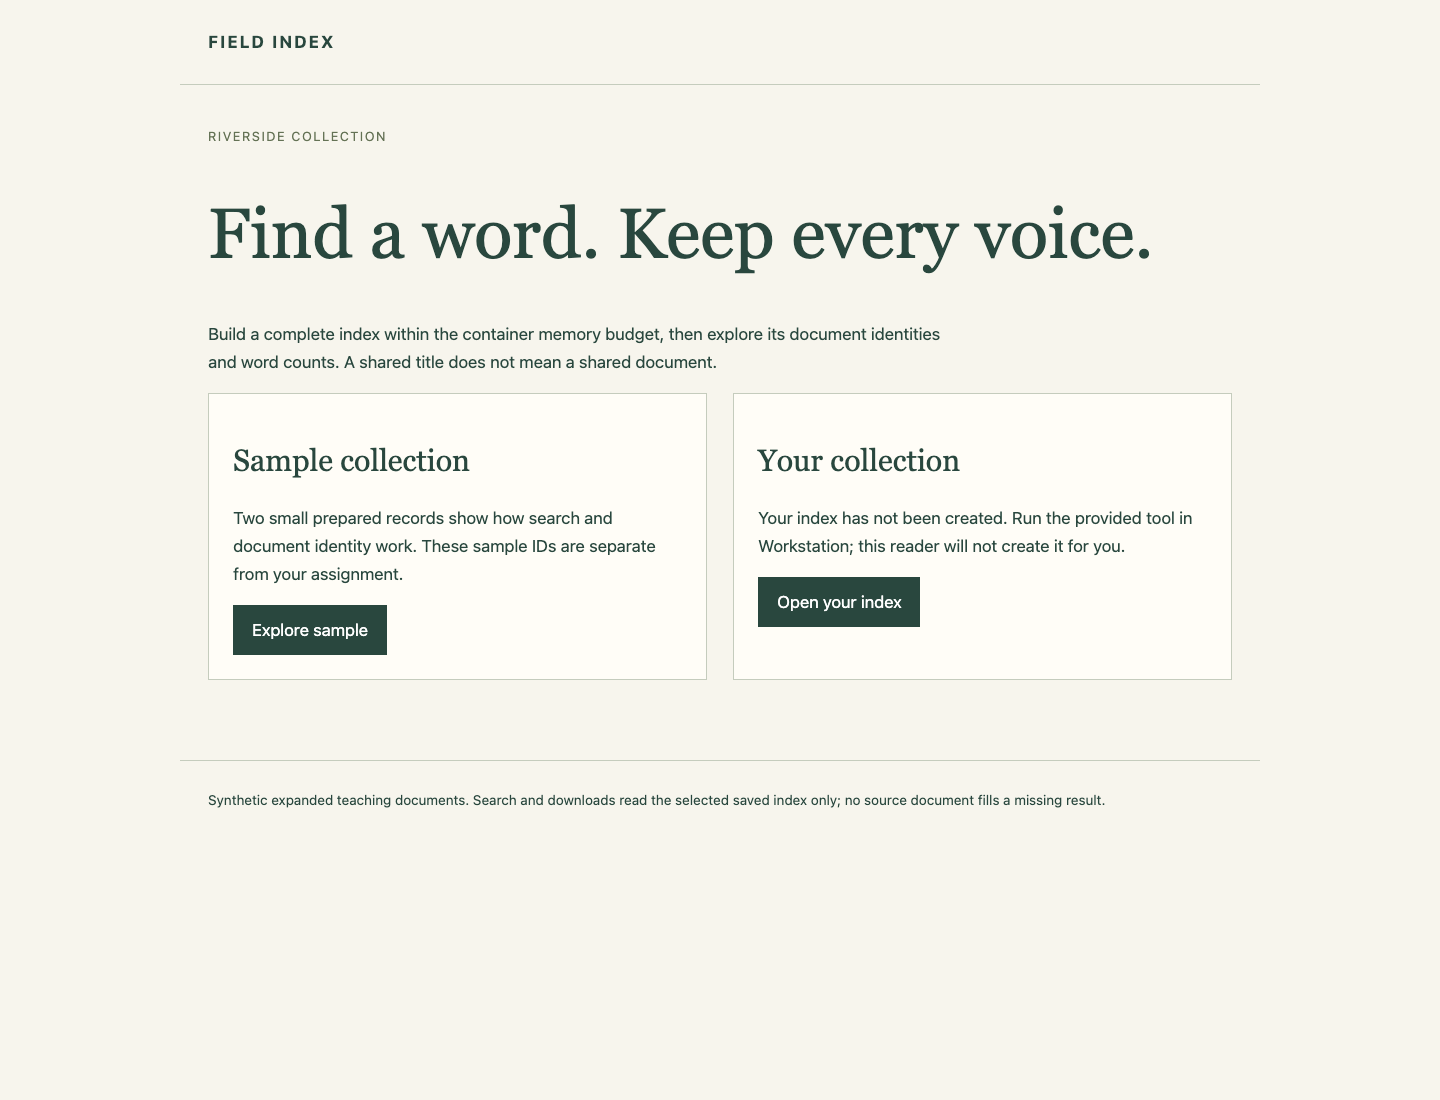
Beginne in Search Desk und wähle Explore sample. Dieses getrennte vorbereitete Beispiel enthält zwei kleine Dokumente. Suche mit Search one word und Search nach café. Beide Datensätze tragen den Titel Riverside memories, haben aber unterschiedliche IDs, die mit sample-oral- beginnen. Öffne jeden Datensatz und untersuche seinen Quellhash und ausgewählte Wortzähler; nutze dann Back to collection. Nutze Download index, um die tatsächliche Beispiel-JSON-Datei zu untersuchen, und dann Back to Search Desk.
Die beiden Bereiche trennen das vorbereitete Beispiel von deiner zugewiesenen Sammlung. Dein Index ist anfangs nicht verfügbar:
Ein invertierter Index verbindet ein Wort mit Dokument-IDs und Vorkommenszahlen. Seine documents-Metadaten erfassen jede ID, jeden Titel und Quell-SHA-256, einen Fingerabdruck der Originalbytes. Zwei Datensätze mit gleichem Titel dürfen nicht zu einer Identität zusammenfallen. Der Leser nutzt ausschließlich den ausgewählten gespeicherten Index; er ergänzt fehlende Arbeit niemals aus Quell-HTML.
Wähle Open your index. Derzeit erscheint Collection not indexed mit HTTP 503. Das kleine Beispiel ist nicht dein Ergebnis mit sechs Dokumenten.
Die Pfade und die Speichergrenze verstehen
Wechsle zu Workstation, das in /home/labex/project/collection-index startet. cd führt dorthin zurück und ls listet Dateien auf:
cd /home/labex/project/collection-index
ls source output
source/ enthält sechs originale HTML-Dateien. output/ ist dein beschreibbares Lieferverzeichnis. Erhalte die Originale, das vorbereitete Image dk06-indexer:1 und den getrennten Beispielleser. Du erstellst ausschließlich Kurscontainer und Indexausgabe.
Der Entrypoint des Images startet bereits sein Indexierungsprogramm. --source /input, --output /output/attempt.json und --workers 4 nach dem Image-Namen sind Programmargumente, keine Docker-Flags. Worker parsen tatsächliches HTML in Dokumentbäume. Ein Batch hält seine ausgewählten Bäume während der Wortextraktion und gibt sie danach frei. Mehr Worker können mehr Speicher benötigen; sie versprechen keine höhere Geschwindigkeit.
Die Docker-Optionen vor dem Image-Namen setzen die Betriebsgrenze:
| Option | Bedeutung hier |
|---|---|
--name |
Einen eindeutig benannten Container zur nativen Inspektion erhalten |
--memory 160m |
Ein RAM-Budget von 160 MiB erzwingen |
--memory-swap 160m |
RAM plus Swap auf denselben Gesamtbetrag setzen, ohne zusätzliches Swap-Budget |
--network none |
Der Dateiverarbeitungsauftrag benötigt kein Netzwerk |
--user |
Ausgabe unter deinem tatsächlichen normalen Konto schreiben |
Zwei --mount-Optionen |
Originaleingabe nur lesen; in den getrennten Ausgabeordner schreiben |
id -u und id -g zeigen deine tatsächlichen numerischen Benutzer- und Gruppen-IDs; setze nicht 1000 voraus. $(...) setzt die Ausgabe eines Befehls in diesen Befehl ein. Doppelte Anführungszeichen halten die kombinierte Benutzer-/Gruppenangabe und jeden vollständigen Mount-Wert als ein Argument zusammen und erlauben zugleich die Ersetzung von $PWD, dem aktuellen Verzeichnis. Ein abschließender Backslash verbindet die nächste physische Zeile mit demselben Befehl.
Die Host-Eingabe source/ erscheint im Container als /input; Host-output/ als /output. readonly schützt die Eingabe über diesen Mount. Ergänze keinen weiteren beschreibbaren Alias der Quelle. Lasse beide Speicheroptionen unverändert und deaktiviere weder OOM-Killer noch ändere Plattformeinstellungen.
Den Fehler reproduzieren und zuordnen
Starte den bereitgestellten Versuch mit vier Workern. Er soll ausdrücklich vor Fertigstellung seines Index mit nativem Status 137 enden:
docker run --name index-attempt \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/attempt.json --workers 4
Möglicherweise siehst du vor dem Stopp nur eine frühe Zeile Parsing batch. Behalte den gestoppten Container: Es gibt kein --rm, weil seine Identität und wirksamen Einstellungen wichtig sind.
docker inspect liest native Containerfelder. Einfache Anführungszeichen erhalten jede kleine Formatvorlage wörtlich. Lies zuerst Exit-Code und Dockers OOM-Flag, dann beide Limits in Byte:
docker inspect index-attempt --format '{{.State.ExitCode}} {{.State.OOMKilled}}'
docker inspect index-attempt --format '{{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}'
docker logs index-attempt
Die konfigurierten Limitwerte sind beide 167772160, also 160 × 1024 × 1024 Byte. Exit 137 allein unterscheidet diesen Speicherfehler nicht von einer erzwungenen Beendigung. Dockers Flag OOMKilled sollte erfasst werden, aber die in diesem Lab getestete Engine kann es manchmal false lassen, obwohl der Kernel einen echten Memory-Cgroup-Kill meldet. Prüfe den tatsächlichen Kernel-Nachweis gegen, statt ein einzelnes Feld als Erklärung zu behandeln.
Lies die vollständige Container-ID in eine Shell-Variable. Die Zuweisung hat keine Leerzeichen um =; die Befehlssubstitution erfasst das inspect-Ergebnis:
container_id=$(docker inspect --format '{{.Id}}' index-attempt)
Die Variable gehört zu dieser Workstation-Shell. Browser-Tab-Wechsel ändern sie nicht; öffnest du eine neue Shell, wiederhole die Zuweisung. sudo dmesg liest das geschützte Kernel-Log, ohne es zu löschen. Eine Pipe | führt diese Ausgabe grep zu; -F wählt Zeilen mit der genauen ID als gewöhnlichem Text, und Anführungszeichen erhalten ihren Wert als ein Argument:
sudo dmesg | grep -F "$container_id"
Suche die Zeile mit CONSTRAINT_MEMCG und einem oom_memcg-Pfad, der diese vollständige Docker-Container-ID nennt. Sie identifiziert eine Speicherknappheitsaktion in der Speicher-Kontrollgruppe dieses Containers statt eines fremden Prozesses oder plattformweiten Engpasses. Vergleiche sie mit dem gestoppten Versuch und seinen tatsächlichen Limits. Erstelle keine falschen Logs und ersetze diesen Versuch nicht durch einen manuell beendeten Prozess.
Den Batch reduzieren und die vollständige Arbeit erhalten
Das Budget ist fest. Den Batch auf einen Worker zu reduzieren hält jeweils einen echten geparsten Dokumentbaum im Speicher und erhält alle sechs Dokumente und denselben Wortzählalgorithmus. Dies ist eine machbare Wahl für diesen Korpus, keine Behauptung, dass ein Worker immer optimal ist. Andere machbare Worker-Werte werden akzeptiert, wenn der vollständige Auftrag unter denselben Limits tatsächlich fertig wird.
Erstelle einen getrennten, erhalten bleibenden Liefercontainer. Behalte beide Mounts, vorbereiteten Entrypoint und Speicheroptionen; ändere Ausgabedateinamen und Worker-Anzahl:
docker run --name index-delivery \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/index.json --workers 1
Erwarte alle Batches gefolgt von Indexed 6 documents and ... terms und normalem Exit-Status 0. Die Begriffsanzahl ist eine Beobachtung, allein kein Beweis:
docker inspect index-delivery --format '{{.State.ExitCode}}'
ls -l output/index.json
Die Ausgabe gehört deinem normalen Benutzer/deiner Gruppe und bleibt nach Containerende bearbeitbar. Behalte beide gestoppten Container. Ist ein Eingabepfad falsch geschrieben, meldet Docker vor der Verarbeitung eine fehlende Bind-Quelle: Kehre ins angegebene Arbeitsverzeichnis zurück, prüfe ls source output, korrigiere den Pfad in Anführungszeichen und wiederhole. Erstelle keine Ersatzeingabe, um den Fehler zu verbergen.
Den tatsächlich gelieferten Index nutzen
Wechsle zu Search Desk, wähle bei Bedarf Back to Search Desk und dann Open your index. Es muss sechs indexierte Dokumente zeigen, nicht die beiden Beispiel-IDs. Suche café: Alle sechs Dokumente sollten mit je 10.000 Vorkommen erscheinen. Öffne beide Riverside memories-Datensätze anhand ihrer unterschiedlichen IDs oral-0 und oral-1. Quellhashes und Wortbeziehungen müssen getrennt bleiben.
Die gelieferte Sammlung enthält alle sechs Original-IDs, einschließlich beider Datensätze mit gleichem Titel:
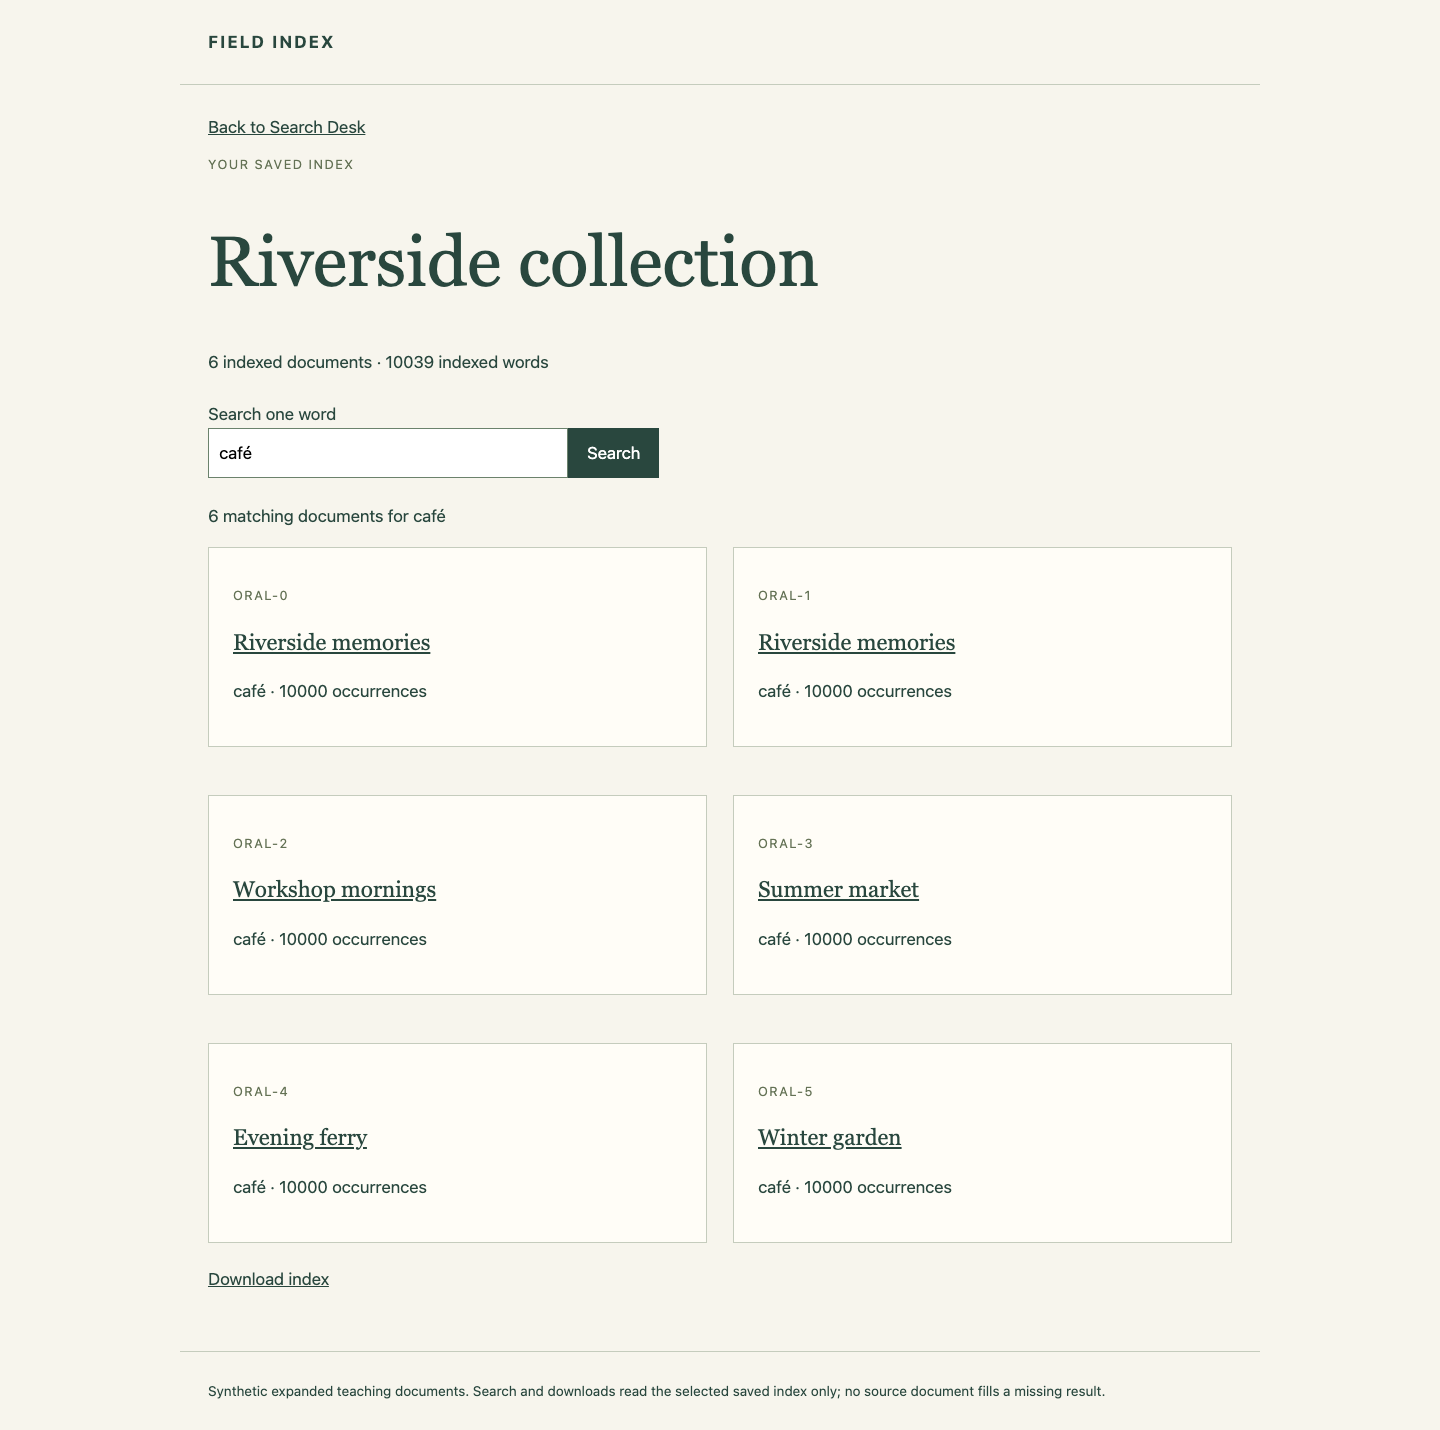
Kehre mit Back to collection zurück, suche résumé und dann naïve und bestätige, dass alle sechs Datensätze mit ihren tatsächlichen Zählern durchsuchbar bleiben. Suche notawordinthiscollection: Kein Dokument sollte passen. Nutze Download index und untersuche das echte gelieferte JSON; seine Dokumente, Quellhashes und Postings gehören zu allen Originaleingaben. Der Leser erzeugt fehlende Ergebnisse nicht neu.
Die Prüfungen ordnen das genaue Memory-Cgroup-Ereignis dieses Laufs seinem Container zu, untersuchen wirksames Budget und Mounts der erfolgreichen Lieferung und lesen unabhängig jedes originale HTML-Byte als Stream, um alle Unicode-Wort-/Dokumentzähler zu prüfen. Sie wiederholen deinen tatsächlichen Auftrag nicht und schreiben den Index nicht für dich.
Nur eine erfolglose Lieferung wiederherstellen
Wenn auch dein Lieferversuch an Speicherknappheit scheitert, untersuche gestoppten Zustand und Logs, wähle einen machbaren Batch und entferne nur diesen erfolglosen Container index-delivery mit docker rm index-delivery, bevor du den gezeigten Lieferbefehl wiederholst. Behalte index-attempt und alle originalen HTML-Dateien als Nachweis. Ein erfolgreicher erneuter Lauf überschreibt seine eigene Ausgabe mit einem vollständigen Index; bearbeite Zähler nicht von Hand und kopiere nicht das kleine Beispiel in die Lieferung.
Zusammenfassung
Du hast eine echte Memory-Cgroup-OOM-Aktion ihrem genauen Container und seinen wirksamen Limits zugeordnet und anschließend die tatsächliche HTML-Batch-Parallelität reduziert, um den gesamten Index im selben 160-MiB-Budget fertigzustellen. Der gespeicherte Index erhält alle sechs Identitäten, doppelte Titel, originale Quellhashes und Unicode-Wortzähler und bleibt nach Containerende nutzbar.