



Einführung
Eine Support-API gibt eine wenig hilfreiche Exception zurück, wenn eine Abhängigkeit langsam reagiert. Sie reproduzieren das Symptom, ordnen es einer Request-ID zu und reparieren den Handler so, dass Aufrufer einen begrenzten, aussagekräftigen Fehler erhalten, während erfolgreiche Requests weiterhin funktionieren. Anschließend überprüfen Sie die tatsächlichen Cloud-Antworten und einen separaten Live-Logstream.
Beginnen Sie in dieser frischen VM mit Ihrem eigenen Lernkonto. Voraussetzungen sind eine gewöhnliche Wrangler-Bereitstellung, Service Bindings und lokales Testen; kein früherer Worker und keine frühere VM werden wiederverwendet. Das Setup installiert Node.js 22.22.0, Wrangler 4.131.1 und Miniflare 4.20260730.0 und stellt den fehlerhaften Aufrufer sowie ein synthetisches Upstream bereit. Das Upstream liefert synthetische Daten, einen kontrollierten 503-Fehler oder eine Verzögerung von 2,5 Sekunden. Eine Datenbank, eine gekaufte Domain und ein Hochlast-Experiment sind nicht erforderlich.
Eine Laufzeit-Exception, ein absichtlich erzeugter HTTP-504-Fehler und ein Fehler durch ein Ausführungslimit sind unterschiedliche Beobachtungen. Sie untersuchen jede Art von Beleg, ohne jede 5xx-Antwort als Plattformfehler zu behandeln.
Timeout reproduzieren und zuordnen
Reproduzieren Sie in diesem Schritt lokal eine Exception durch eine langsame Abhängigkeit. Lesen Sie den Aufrufer und das bereitgestellte Upstream. Der Aufrufer hat ein Zeitlimit von 400 ms, fängt aber einen abgelehnten Fetch nicht ab. Der langsame Modus des Upstreams wartet 2,5 Sekunden.
cd /home/labex/project/failure-diagnostics
cat src/index.js
cat upstream/index.js
Erzeugen Sie eine eindeutige Ressourcenbasis. Das erste nicht in Anführungszeichen gesetzte EOF ersetzt diese Variable in beiden Konfigurationen. Das UPSTREAM-Service-Binding hält das Fixture privat; ein Hostname in der Request-URL wählt keinen öffentlichen Service aus.
WORKER_NAME="labex-diagnose-$(node -p "require('node:crypto').randomBytes(6).toString('hex')")"
cat > wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [{"binding": "UPSTREAM", "service": "$WORKER_NAME-upstream"}]
}
EOF
cat > upstream/wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME-upstream",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
EOF
Starten Sie beide Konfigurationen in einem lokalen Dev-Prozess. Der Hintergrundprozess hält das Terminal verfügbar; > und 2>&1 leiten Ausgabe und Fehler nach dev.log um. Warten Sie vor den Requests auf Ready.
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Verwenden Sie -H, um eine kleine synthetische Request-ID anzuhängen. Der Handler akzeptiert nur ein eingeschränktes ID-Format und erzeugt andernfalls selbst eine ID. --max-time begrenzt den curl-Client; dieses Limit ist unabhängig vom Zeitlimit des Handlers.
curl -i --max-time 6 -H "X-Request-ID: healthy-one" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-one" "http://127.0.0.1:8080/api/check?mode=slow"
cat dev.log
Der erfolgreiche Request liefert 200 mit synthetischen Upstream-Daten zurück. Der langsame Modus sollte lokal einen 500-Fehler zurückgeben und zuerst den Datensatz request_started für slow-one, danach eine nicht abgefangene Timeout-Exception anzeigen. Die genaue lokale Fehlerseite und der Stack können variieren. Dies zeigt, dass das Zeitlimit die Anfrage ablehnt; es zeigt nicht, dass eine hilfreiche Fehlerantwort vorhanden ist. Führen Sie die Überprüfung aus, bevor Sie den Aufrufer ändern.
Fehlerantwort und Diagnosen reparieren
Fangen Sie in diesem Schritt den begrenzten Upstream-Fehler ab und halten Sie die Diagnosen nützlich, ohne Header oder Zugangsdaten zu protokollieren. Beenden Sie den aktuellen Prozess anhand seiner tatsächlichen Nummer.
jobs
kill %1
Ersetzen Sie den Aufrufer durch den folgenden vollständig reparierten Handler. Das in Anführungszeichen gesetzte Trennzeichen bewahrt den JavaScript-Code unverändert. Ein 504 kennzeichnet das Zeitlimit des Aufrufers für die Abhängigkeit; ein 502 kennzeichnet eine fehlgeschlagene Upstream-Antwort oder ein Protokollproblem. Erfolgreiche Aufrufe behalten das Upstream-Ergebnis. elapsed_ms ist die verstrichene Wanduhrzeit, nicht die CPU-Auslastung. Log und Antwort verwenden dieselbe Request-ID, damit Sie einen einzelnen Request durch das System verfolgen können.
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === '/health') return Response.json({status: 'ok'});
    if (url.pathname !== '/api/check') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'GET') return Response.json({error: 'method_not_allowed'}, {status: 405});
    const mode = url.searchParams.get('mode') || 'healthy';
    if (!['healthy', 'slow', 'fail'].includes(mode)) {
      return Response.json({error: 'invalid_mode'}, {status: 400});
    }
    const suppliedId = request.headers.get('X-Request-ID') || '';
    const requestId = /^[a-z0-9-]{1,64}$/.test(suppliedId) ? suppliedId : crypto.randomUUID();
    const headers = {'X-Request-ID': requestId, 'Cache-Control': 'no-store'};
    const started = Date.now();
    console.log(JSON.stringify({event: 'request_started', request_id: requestId, mode}));
    const upstreamUrl = new URL('https://diagnostic.internal/check');
    upstreamUrl.searchParams.set('mode', mode);
    upstreamUrl.searchParams.set('probe', requestId);
    const signal = AbortSignal.timeout(400);
    const failure = (event, status, detail = {}) => {
      console.error(JSON.stringify({event, request_id: requestId, mode, status,
        elapsed_ms: Date.now() - started, ...detail}));
      return Response.json({error: event, requestId}, {status, headers});
    };
    try {
      const response = await env.UPSTREAM.fetch(upstreamUrl, {signal});
      if (!response.ok) return failure('upstream_status', 502, {upstream_status: response.status});
      const data = await response.json();
      if (data.service !== 'labex-diagnostic-fixture' || data.status !== 'ok' || data.probe !== requestId) {
        return failure('upstream_protocol', 502);
      }
      console.log(JSON.stringify({event: 'request_complete', request_id: requestId,
        mode, status: 200, elapsed_ms: Date.now() - started}));
      return Response.json({status: 'ok', requestId, upstream: data}, {headers});
    } catch {
      return signal.aborted ? failure('upstream_timeout', 504) : failure('upstream_exception', 502);
    }
  }
};
JS
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Vergleichen Sie nach Ready alle drei Modi und die unveränderte Health-Route. Jeder Fehler muss umgehend beendet werden. Im langsamen Modus länger zu warten, ist keine Reparatur.
curl -i --max-time 6 -H "X-Request-ID: healthy-two" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-two" "http://127.0.0.1:8080/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: fail-two" "http://127.0.0.1:8080/api/check?mode=fail"
curl -i http://127.0.0.1:8080/health
cat dev.log
Erwarten Sie für healthy/slow/fail die Statuscodes 200/504/502. Jede Antwort enthält ihre Request-ID sowohl im JSON als auch in X-Request-ID. In den Logs werden request_started jeweils mit request_complete, upstream_timeout oder upstream_status verknüpft. Die letzte Kategorie zeichnet den 503-Fehler des Upstreams getrennt vom 502-Fehler des Aufrufers auf. Ein abgefangener Fehler kann zu einem erfolgreichen Laufzeitergebnis führen, weil der Handler normal beendet wurde, obwohl sein HTTP-Status 504 oder 502 lautet.
Vergleichen Sie dieses Ergebnis mit dem bereitgestellten Beispiel für ein Ausführungslimit:
cat evidence/execution-limit.json
Diese Datei enthält ausdrücklich synthetische Lehrdaten und stammt nicht aus einer Aufzeichnung Ihres Workers. Das Ergebnis exceededCpu kennzeichnet einen Fehler durch ein Ausführungslimit; nachdem die Laufzeit die Ausführung beendet hat, wird nicht garantiert, dass ein Anwendungshandler noch einen Fehler abfangen kann. Auf das asynchrone Upstream dieses Labs zu warten, ist nicht dasselbe wie CPU-Zeit zu verbrauchen. Untersuchen Sie rechenintensive Verarbeitung oder Request-Arbeit, bevor Sie Limits in Betracht ziehen. Entfernen Sie nicht das Zeitlimit und erzeugen Sie keine Last, um dieses Beispiel nachzuahmen. Die offizielle Fehlerreferenz erläutert Exception- und Limitkategorien. Die Dokumentation zu Laufzeitergebnissen unterscheidet Laufzeitergebnis und HTTP-Status.
Führen Sie die Überprüfung aus. Sie startet eine isolierte Laufzeit mit einem eigenen Fixture und eigenen Request-IDs, prüft die Verträge für erfolgreiche und fehlerhafte Requests und bestätigt, dass ein synthetischer Authorization-Header nicht in den erfassten Anwendungslogs erscheint. Die Logdateien der Lernenden sind kein unabhängiger Beleg.
Live-Requests, Logs und Metriken überprüfen
Überprüfen Sie in diesem Schritt das reparierte Verhalten in Ihrem Lernkonto. Beenden Sie die lokale Entwicklung und autorisieren Sie diese frische VM mit demselben eingeschränkten Geräte-Flow, der zuvor vermittelt wurde.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Öffnen Sie den ausgegebenen Link, geben Sie den Code ein und genehmigen Sie das gewünschte Lernkonto im Browser. Bestätigen Sie den tatsächlichen Kontonamen und die ID in der normalen Wrangler-Ausgabe.
npx wrangler whoami --json
Ersetzen Sie YOUR_ACCOUNT_ID durch diese tatsächliche ID. Dieser normale Node-Befehl speichert sie in beiden Projektkonfigurationen, damit jede Bereitstellung den Besitz ausdrücklich festlegt.
node -e 'const fs=require("node:fs");for(const p of ["wrangler.jsonc","upstream/wrangler.jsonc"]){const c=JSON.parse(fs.readFileSync(p));c.account_id="YOUR_ACCOUNT_ID";fs.writeFileSync(p,JSON.stringify(c,null,2)+"\n");}'
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler deploy -c upstream/wrangler.jsonc
npx wrangler deploy
Das Fixture besitzt keinen öffentlichen Endpunkt. Kopieren Sie unten die tatsächliche workers.dev-URL des Aufrufers. Wenn das Konto erstmals eine Subdomain-Registrierung benötigt, verwenden Sie vor dem Fortfahren das Verfahren aus „Deploy Your First Cloudflare Worker“.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
Starten Sie einen gut lesbaren Live-Stream. Warten Sie, bis events.log Connected meldet, bevor Sie Requests senden. Dass die Datei existiert, allein bedeutet nicht, dass der Stream bereit ist.
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
cat events.log
curl -i --max-time 6 -H "X-Request-ID: cloud-healthy" "$APP_URL/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: cloud-slow" "$APP_URL/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: cloud-fail" "$APP_URL/api/check?mode=fail"
cat events.log
Suchen Sie in den Live-Anwendungslogs nach den erwarteten Antworten 200/504/502 und den passenden IDs. Wenn ein Ereignis noch nicht eingetroffen ist, prüfen Sie dasselbe Log nach einigen Sekunden erneut. Ändern Sie die Anwendung nicht, um das Ereignis künstlich zu erzeugen. Wenn der Stream beendet wurde, stoppen Sie ihn und untersuchen Sie tail-errors.log. In der lesbaren Ausgabe kann der abgefangene 504-Aufruf als Ok erscheinen: Das bedeutet, dass die Laufzeit abgeschlossen wurde, nicht dass das Upstream fehlerfrei war.
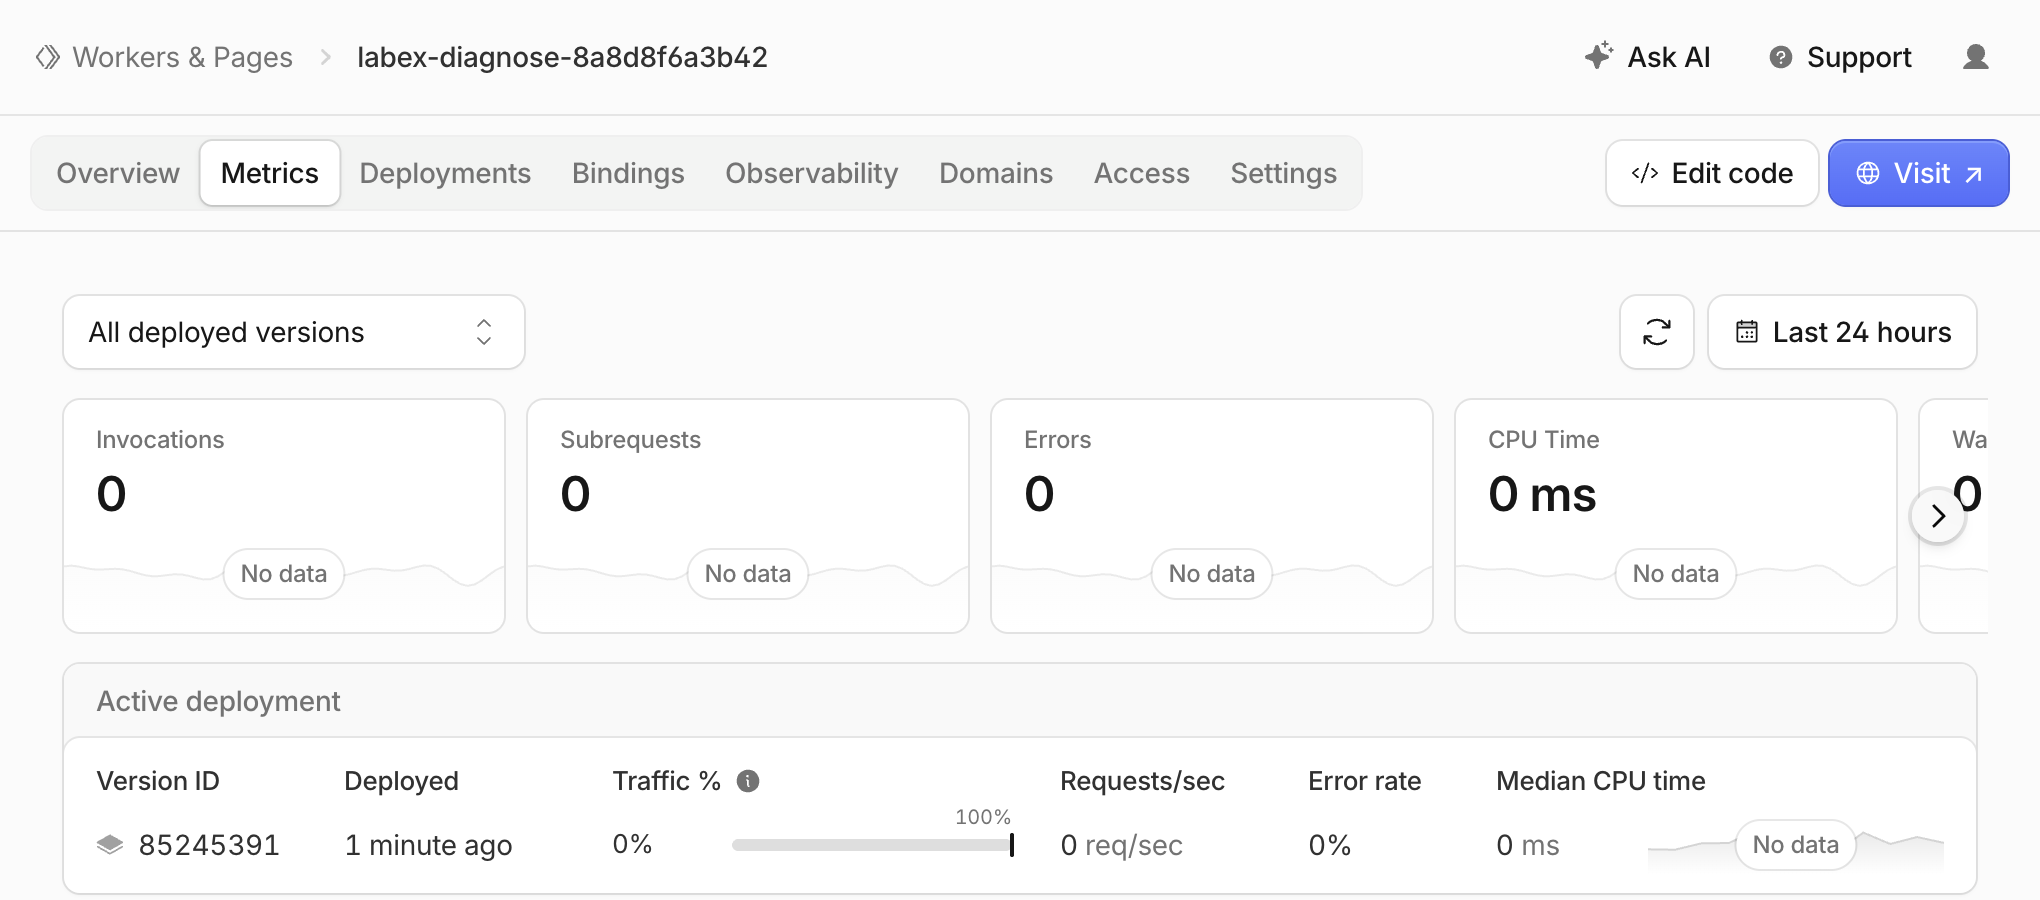
Öffnen Sie im Dashboard den genauen Aufrufer im ausgewählten Konto, bestätigen Sie, dass sein UPSTREAM-Binding auf dieses Fixture zeigt, und untersuchen Sie Metrics. Die verfügbaren Diagramme aggregieren Requests und Aufruffehler und können hinter einem kurzen Test zurückbleiben. Halten Sie fest, was tatsächlich sichtbar ist, statt sofort eine Summe ungleich null zu erwarten. Verwenden Sie Live-Logs und HTTP-Antworten als Beleg für einzelne Requests. Ein abgefangener 504 kann in den HTTP-Statusdaten erscheinen, ohne als nicht abgefangene Laufzeit-Exception gezählt zu werden. Die Metrikreferenz erläutert Aggregation und Aufrufkategorien.
Öffnen Sie unter Compute → Workers & Pages Ihren genauen Aufrufer und wählen Sie Metrics. Prüfen Sie den Worker-Breadcrumb, den Filter für die bereitgestellte Version und einen Zeitraum, der Ihre Requests abdeckt. Die Schaltfläche zum Aktualisieren befindet sich neben der Zeitraum-Auswahl. Der folgende Screenshot wurde kurz nach den synthetischen erfolgreichen, langsamen und fehlgeschlagenen Upstream-Requests aufgenommen; die Karten zeigten weiterhin No data. Dies ist eine gültige Beobachtung verzögerter Analysedaten und kein Beleg dafür, dass keine Requests ausgeführt wurden oder die Reparatur fehlgeschlagen ist. Ihr Name, Ihre Versions-ID und Ihre Summen werden abweichen. Erzeugen Sie keine zusätzliche Last, nur um das Bild nachzustellen.
Führen Sie die Überprüfung mit bestehender Autorisierung aus. Sie fragt Besitz- und Binding-Status ab, sendet neue unabhängige Requests und zeichnet einen separaten Live-Stream auf. Warten Sie ungefähr eine Minute. Ein nicht verfügbarer oder unvollständiger Stream ist nicht schlüssig. Prüfen Sie die Verbindungsbereitschaft und versuchen Sie es erneut. Behandeln Sie fehlende Logs niemals als Erfolg. Stoppen Sie nach erfolgreicher Überprüfung den Lernenden-Tail anhand seiner aktuellen Jobnummer.
jobs
kill %1
Diagnose-Worker löschen
Entfernen Sie in diesem Schritt nur den Aufrufer und das Fixture dieses Labs, während Sie weiterhin autorisiert sind. Prüfen Sie vor dem Löschen des Aufrufers beide Namen und ihr Konto.
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c upstream/wrangler.jsonc
Drücken Sie bei jeder passenden Namensabfrage genau die einzelne Taste y. Die angeheftete CLI kann nach dem Löschen eines Workers eine Authentifizierungsdiagnose zur Bereinigung eines veralteten KV-Eintrags melden. Erweitern Sie dafür nicht die Berechtigungen und nehmen Sie nicht an, dass beliebige Fehler den Löschvorgang beweisen. Aktualisieren Sie das Dashboard und führen Sie die Überprüfung aus. Beide Namen müssen in einer erfolgreichen authentifizierten Inventarliste fehlen. Lassen Sie das Konto, die Subdomain und nicht zugehörige Ressourcen bestehen.
VM trennen
Trennen Sie in diesem Schritt die VM, nachdem die Löschung der Ressourcen überprüft wurde. Das Schließen des Terminals oder das Abmelden entfernt keine Cloud-Ressourcen.
npx wrangler logout
npx wrangler whoami --json
Erwarten Sie loggedIn=false. Für diesen nicht authentifizierten Zustand kann der Befehl mit einem Status ungleich null beendet werden. Führen Sie die abschließende Überprüfung aus. Ihre Browser-Anmeldung und Ihr Lernkonto können in einem späteren frischen Lab wiederverwendet werden.
Zusammenfassung
Sie haben ein nicht abgefangenes Timeout reproduziert, begrenzte Abhängigkeitsfehler repariert und Request-IDs über Antworten und strukturierte Logs hinweg zugeordnet. Das erfolgreiche Verhalten blieb erhalten. Sie haben Anwendungs-HTTP-Fehler von Laufzeitergebnissen und synthetischen CPU-Limit-Belegen unterschieden, das tatsächliche Verhalten in der Cloud überprüft, anschließend beide Worker entfernt und die Verbindung getrennt.
