



Einführung
Die Bestellanwendung sendet Lese- und Schreibanfragen an dieselbe primäre Datenbank. Du erstellst eine PostgreSQL-Lesereplik, leitest Abfragen dorthin und belegst, dass neue primäre Schreibvorgänge auf der Replik lesbar werden, während direkte Schreibzugriffe scheitern.
Dies ist eine optionale Erweiterung nach den Verbindungs-, SQL- und Wiederherstellungs-Labs. Die Umgebung startet unabhängig mit einer primären Datenbank und drei Beispielbestellungen. Am Ende entfernst du Replik und Quelle.
Bezug zu Zertifizierungen
Dieses Lab bietet einführende praktische Übungen zu folgenden Prüfungsthemen.
- Cloud Practitioner (CLF-C02) · Aufgabe 3.4: Einen Anwendungsfall relationaler Leserepliken erkennen.
- Solutions Architect – Associate (SAA-C03) · Aufgabe 3.3: Leserepliken für das Lesezugriffsmuster einer Anwendung konfigurieren.
Eine Lesereplik erstellen und prüfen
In diesem Schritt erstellst du eine zweite PostgreSQL-Instanz, die Änderungen der primären Instanz empfängt.
Eine Lesereplik beantwortet Abfragen aus kopierten Daten. PostgreSQL überträgt Änderungen der Quelle über das Write-Ahead Log, kurz WAL. Die Standby-Instanz spielt diese Änderungen nach. Sie ist eine separate Engine, und die Replikation kann hinter einem gerade bestätigten Schreibvorgang zurückliegen.
Eine Lesereplik und eine Multi-AZ-Standby-Instanz haben unterschiedliche Zwecke. Die Replik liefert einen Endpoint für Anwendungsabfragen. Die Standby-Instanz einer standardmäßigen Multi-AZ-DB-Instanzbereitstellung dient Verfügbarkeit und Failover und beantwortet keine Anwendungsabfragen. Dieses Lab implementiert eine Lesereplik, keinen Multi-AZ-Failover.
Lade die vorbereiteten Verbindungseinstellungen:
cd /home/labex/project
source database.env
Prüfe die Quelle:
aws rds \
  describe-db-instances \
  --db-instance-identifier orders-db \
  --query 'DBInstances[0].{Identifier:DBInstanceIdentifier,Status:DBInstanceStatus,BackupRetention:BackupRetentionPeriod,Endpoint:Endpoint}'
RDS verlangt eine Backup-Aufbewahrungsdauer größer als null für die Quelle einer Lesereplik. Dieses Lab liefert eine primäre Instanz mit Aufbewahrung 1. Du nutzt diese vorbereitete Konfiguration; automatische Backup-Planung wird nicht getestet.
Erstelle die Replik:
aws rds \
  create-db-instance-read-replica \
  --db-instance-identifier orders-reader \
  --source-db-instance-identifier orders-db \
  --db-instance-class db.t3.micro \
  --no-publicly-accessible \
  --query 'DBInstance.{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Status:DBInstanceStatus,Endpoint:Endpoint}'
aws rds \
  wait db-instance-available \
  --db-instance-identifier orders-reader
Prüfe beide Ressourcen:
aws rds \
  describe-db-instances \
  --query 'DBInstances[].{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Endpoint:Endpoint.Address}' \
  --output table
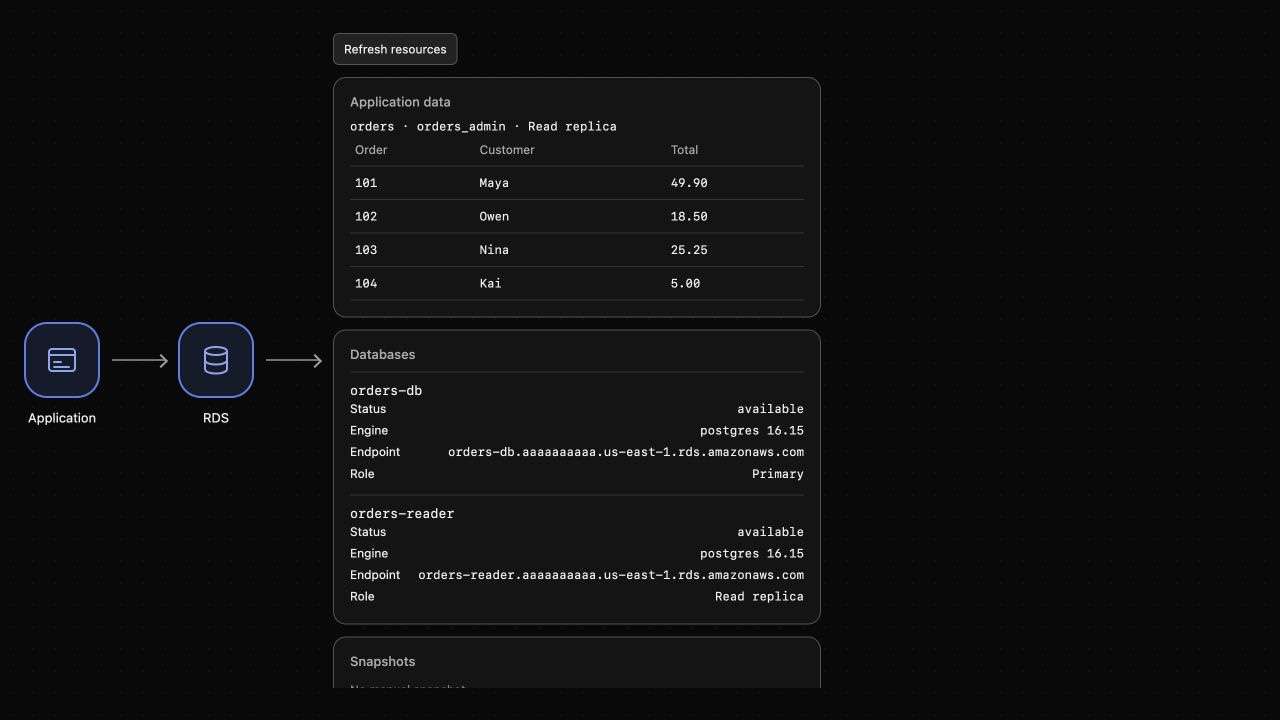
Du solltest einen eigenen Endpoint für orders-reader und eine Quellbeziehung zu orders-db sehen. AWS View sollte Quelle und Lesereplik auflisten.
Frage die tatsächliche Replik-Engine ab:
psql \
  "service=orders-reader" \
  --command 'SELECT current_database(), pg_is_in_recovery();'
Du solltest die Datenbank orders und pg_is_in_recovery gleich t (true) erhalten. PostgreSQL läuft tatsächlich im Standby-Wiederherstellungsmodus; die RDS-Ressource trägt nicht nur eine Replik-Kennzeichnung.
Lese- und Schreib-Endpoints der Anwendung trennen
In diesem Schritt bleiben Schreibvorgänge auf der Quelle, während Abfragen die Replik verwenden.
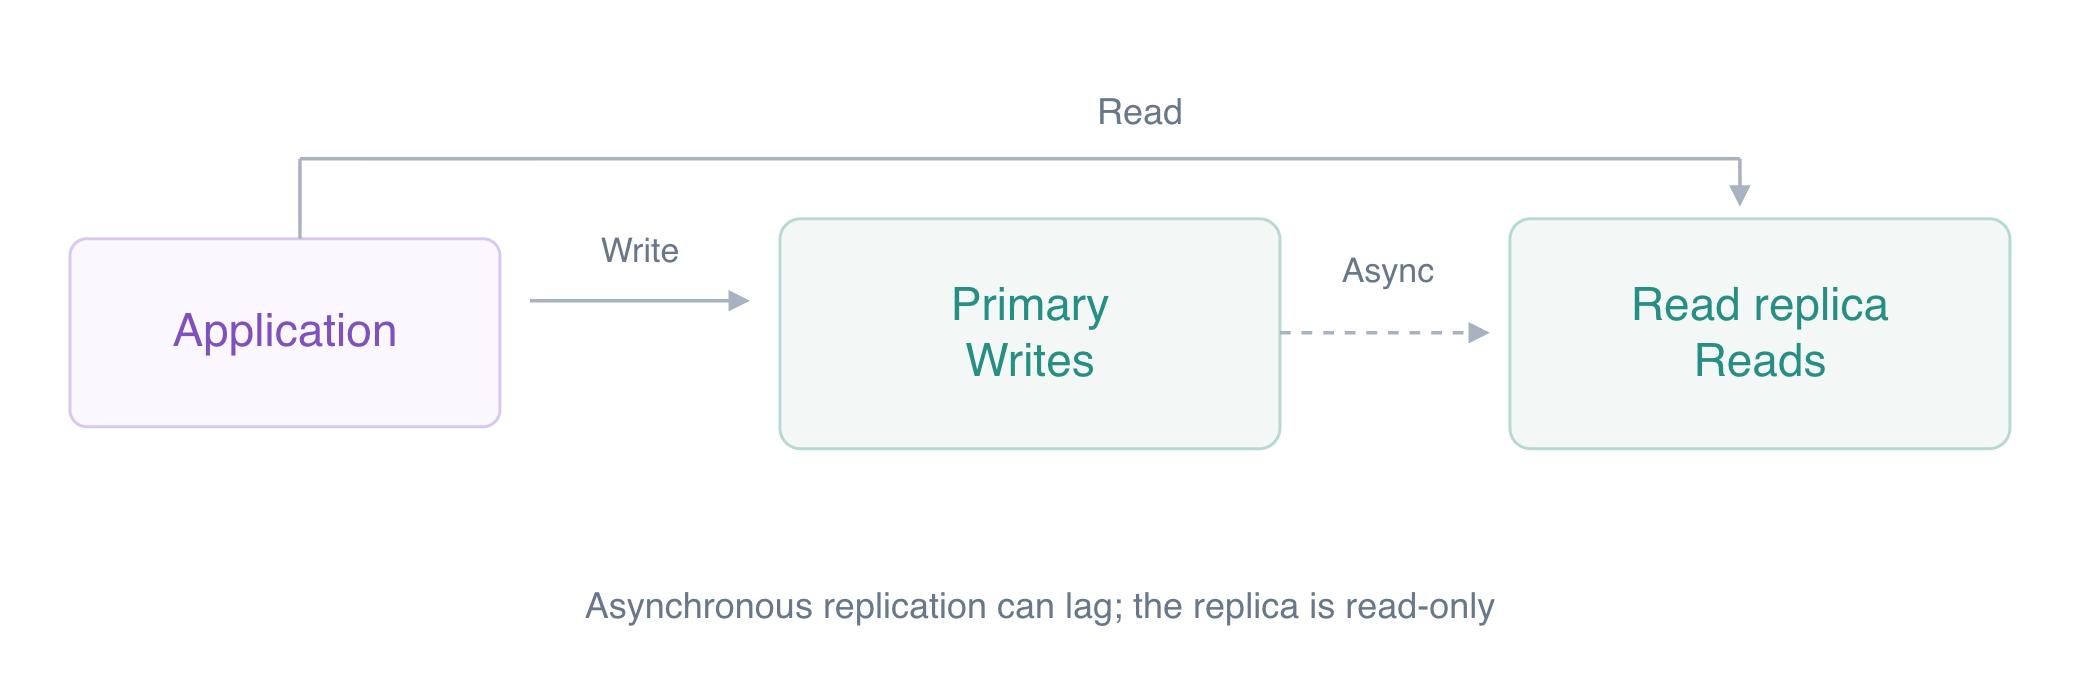
Konzeptdiagramm: Schreibzugriffe gehen an den Primärserver; Lesezugriffe können die asynchron aktualisierte Replik nutzen.
Prüfe die Anwendungskonfiguration:
cat app-config.json
Beide Host-Felder nennen die Quelle. Erfasse den Replik-Endpoint:
READER_ENDPOINT=$(aws rds \
  describe-db-instances \
  --db-instance-identifier orders-reader \
  --query 'DBInstances[0].Endpoint.Address' \
  --output text)
Ändere nur read_host:
jq \
  --arg host "$READER_ENDPOINT" \
  '.read_host = $host' \
  app-config.json > app-config.new
mv app-config.new app-config.json
Lies über die Anwendung:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Du solltest die ursprünglichen drei Bestellungen und read_only: true erhalten. Die Antwort stammt aus der tatsächlichen SQL-Verbindung zur Standby-Instanz. AWS View sollte die Anwendungsdatenquelle als Lesereplik erkennen.
Die Replik nutzt die von der Quelle kopierten Datenbankidentitäten. Die Endpoint-Auswahl bestimmt die erreichte Instanz; Datenbankauthentifizierung und SQL-Rechte gelten weiterhin.
Replikation und abgewiesene Schreibzugriffe beobachten
In diesem Schritt speicherst du eine neue Bestellung über die Quelle und liest sie aus der Replik.
Füge über die Anwendung eine Bestellung hinzu. Ihr POST-Handler nutzt write_host, das weiterhin auf die Quelle zeigt:
curl \
  --silent \
  --show-error \
  --fail \
  --request POST \
  --header 'Content-Type: application/json' \
  --data '{"order_id":104,"customer":"Kai","total":"5.00"}' \
  http://127.0.0.1:8080/application/orders
Du solltest saved: true erhalten. Frage Quelle und Replik unabhängig ab:
psql \
  "service=orders-db" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
psql \
  "service=orders-reader" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
Du solltest Kais Bestellung über 5.00 auf beiden erhalten. Fehlt sie bei der ersten Replik-Abfrage, wiederhole dieselbe Abfrage nach einem Moment: Asynchrone Replikation erlaubt eine Verzögerung. Eine Lesereplik eignet sich für viele Lesezugriffe; bei sofortiger Konsistenz muss ein gerade geschriebener Wert möglicherweise von der Quelle gelesen werden.
Lies die Anwendungsliste erneut:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Du solltest vier Bestellungen und read_only: true erhalten.
Versuche eine tatsächliche Einfügung auf der Replik:
psql \
  "service=orders-reader" \
  --set=ON_ERROR_STOP=1 \
  --command "INSERT INTO orders (order_id, customer, total) VALUES (105, 'Lena', 9.00);"
Du solltest einen Fehler erhalten, dass INSERT in einer schreibgeschützten Transaktion nicht möglich ist. Der Wiederherstellungsmodus lehnt die Änderung auch für die Hauptidentität der Datenbank ab. Bestätige, dass die versuchte Bestellung in keiner Engine existiert:
psql \
  "service=orders-db" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
psql \
  "service=orders-reader" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
Du solltest jeweils 0 erhalten. Schreibvorgänge gehören auf die Quelle; Abfragen können die Replik verwenden, wenn ihre Konsistenzanforderungen es erlauben.
Replik und Quelle entfernen
In diesem Schritt entfernst du beide Übungsdatenbankinstanzen.
Lösche zuerst die Replik, dann die Quelle:
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-reader \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-reader
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-db \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-db
aws rds \
  describe-db-instances \
  --query 'DBInstances[].DBInstanceIdentifier'
Du solltest [] und keine Datenbank in AWS View sehen. Behalte die vorbereitete Anwendung und die Netzwerkressourcen.
Zusammenfassung
Du hast eine PostgreSQL-Lesereplik erstellt und den tatsächlichen Standby-Wiederherstellungsmodus geprüft. Du hast die Endpoints getrennt, eine neue Änderung der Quelle auf der Replik beobachtet und abgewiesene direkte Schreibzugriffe bestätigt. Abschließend hast du beide Instanzen entfernt.
Eine Lesereplik unterstützt Lesezugriffsmuster. Verhalten und Zweck unterscheiden sich von der Standby-Instanz einer standardmäßigen Multi-AZ-DB-Instanzbereitstellung. Die abschließende Challenge verwendet die erlernten Verbindungs- und Diagnosefähigkeiten.


