Einführung
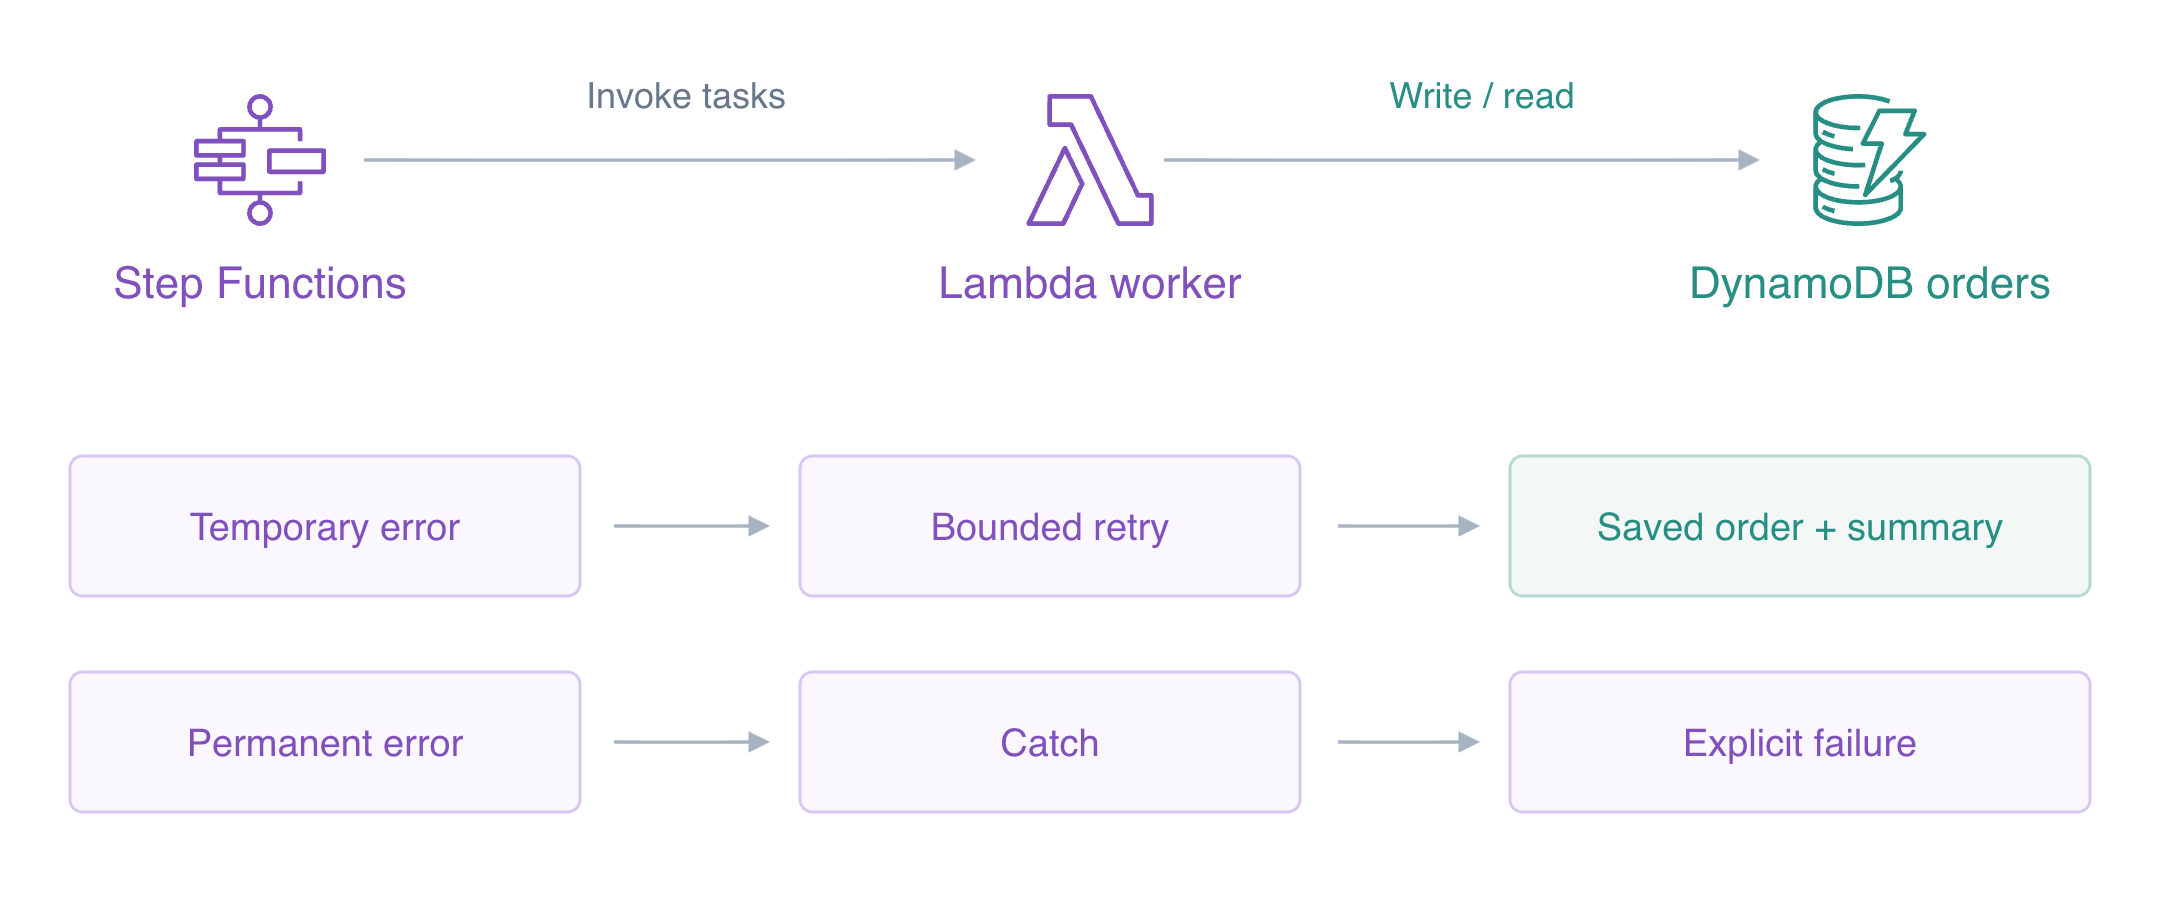
Ein temporärer Fehler einer Abhängigkeit kann sich beheben, während eine ungültige Bestellung fehlgeschlagen bleiben sollte. Du konfigurierst gezielte Wiederholungen und einen Pfad für dauerhafte Fehler und beobachtest dann tatsächliche Versuche und gespeicherte Ergebnisse.
Step Functions koordiniert Lambda-Aufgaben; der bereitgestellte Worker speichert Bestellungen in DynamoDB und liest ihre Zusammenfassungen. Der CLI-Zugriff ist bereits eingerichtet; ein persönliches AWS-Konto oder Zugriffsschlüssel sind nicht erforderlich.
Schließe zuerst Einen mehrstufigen Bestellworkflow erstellen ab. Diese neue VM stellt ihren eigenen Worker und leere Tabellen bereit; frühere Maschinen, Rollen und Ausführungen werden nicht wiederverwendet.
Bezug zu Zertifizierungen
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| Solutions Architect – Associate (SAA-C03) | Aufgabe 2.1 | Workflow-Fehlerbehandlung, begrenzte Wiederholungen und Fehlerergebnisse. |
| Developer – Associate (DVA-C02) | Aufgabe 1.1 | Workflow-Fehlerbehandlung, begrenzte Wiederholungen und Fehlerergebnisse. |
| DevOps Engineer – Professional (DOP-C02) | Aufgabe 5.1 | Grundlagenübung: Workflow-Fehlerbehandlung, begrenzte Wiederholungen und Fehlerergebnisse. |
| Solutions Architect – Professional (SAP-C02) | Aufgabe 2.4 | Grundlagenübung: Workflow-Fehlerbehandlung, begrenzte Wiederholungen und Fehlerergebnisse. |
Laborübersicht
Den Workflow zum Aufrufen seines Workers autorisieren
Untersuche in diesem Schritt den bereitgestellten Geschäftsworker und erstelle eine separate Ausführungsrolle für Step Functions.
Verwende AWS View oben, um die CLI-Abfragen mit den tatsächlichen Ressourcen und Ergebnissen dieses Labs zu vergleichen. Erhalte die bereitgestellten Referenzdaten.
Diese neue VM stellt eine Worker-Funktion und unabhängige Bestell-, Diagnose- und Referenztabellen bereit. Es gibt noch keine Zustandsmaschine oder Workflow-Rolle. Der Worker nimmt eine Bestellung an, schreibt ihre Menge und ihren Gesamtbetrag und kann später ihre Zusammenfassung lesen. Für fiktive Fehlertests löst der Modus flaky beim ersten Versuch vor jedem geschäftlichen Schreibvorgang TransientOrderError aus; der Modus permanent löst vor dem Schreiben InvalidOrder aus. Diagnoseversuche sind von geschäftlichen Bestellungen getrennt. Seine Lambda-Ausführungsrolle autorisiert diese separaten Tabellenoperationen bereits.
Beginne im Projektverzeichnis. Shellzuweisungen speichern zurückgegebene Kennungen; --query wählt ein Antwortfeld aus, und --output text liefert eine wiederverwendbare Zeichenfolge.
cd /home/labex/project
WORKER_NAME=labex-ev04-worker
Speichere den zurückgegebenen Wert in WORKER_ARN:
WORKER_ARN=$(aws lambda get-function-configuration \
  --function-name labex-ev04-worker \
  --query FunctionArn \
  --output text)
echo "$WORKER_ARN"
Prüfe die Rolle und Umgebungskonfiguration der Funktion:
aws lambda get-function-configuration \
  --function-name labex-ev04-worker \
  --query '{Name:FunctionName,Role:Role,Runtime:Runtime,Timeout:Timeout}'
Prüfe die verbleibenden Zustandsmaschinen:
aws stepfunctions list-state-machines
Der Worker verwendet Python3.12 und seine eigene Lambda-Rolle; die Maschinenliste ist leer. Step Functions benötigt seine eigene Ausführungsrolle. Eine Vertrauensrichtlinie erlaubt dem Step-Functions-Dienst, diese Rolle anzunehmen; eine Berechtigungsrichtlinie erlaubt der daraus entstehenden Sitzung, genau diesen Worker aufzurufen. Ein Here-Dokument mit einer in Anführungszeichen gesetzten Markierung schreibt wörtliches JSON, und file:// liest es in die Anfrage ein.
cat > workflow-trust.json <<'JSON'
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "states.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}
JSON
Speichere den zurückgegebenen Wert in ROLE_ARN:
ROLE_ARN=$(aws iam create-role \
  --role-name labex-ev04-workflow-role \
  --assume-role-policy-document file://workflow-trust.json \
  --query Role.Arn \
  --output text)
echo "$ROLE_ARN"
Schreibe ein gewöhnliches Berechtigungsdokument. Die Shell setzt $WORKER_ARN ein und begrenzt diese Berechtigung auf den bereitgestellten Worker.
cat > workflow-invoke.json <<EOF
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "lambda:InvokeFunction",
      "Resource": "$WORKER_ARN"
    }
  ]
}
EOF
Wende die Berechtigungsrichtlinie der Anwendungsrolle an:
aws iam put-role-policy \
  --role-name labex-ev04-workflow-role \
  --policy-name InvokeWorker \
  --policy-document file://workflow-invoke.json
Prüfe die Berechtigungsrichtlinie der Anwendungsrolle:
aws iam get-role-policy --role-name labex-ev04-workflow-role --policy-name InvokeWorker
Die Richtlinie enthält eine genaue Funktions-ARN. Step Functions erhält nicht die DynamoDB-Berechtigungen des Workers: Der Worker führt diese Aufrufe mit seiner separaten Lambda-Rolle aus. Führe die Autorisierungsprüfung aus.
Begrenzte Wiederholungen und einen Pfad für dauerhafte Fehler konfigurieren
Erstelle in diesem Schritt einen tatsächlichen Workflow mit zwei Aufgaben und gezieltem Wiederherstellungsverhalten.
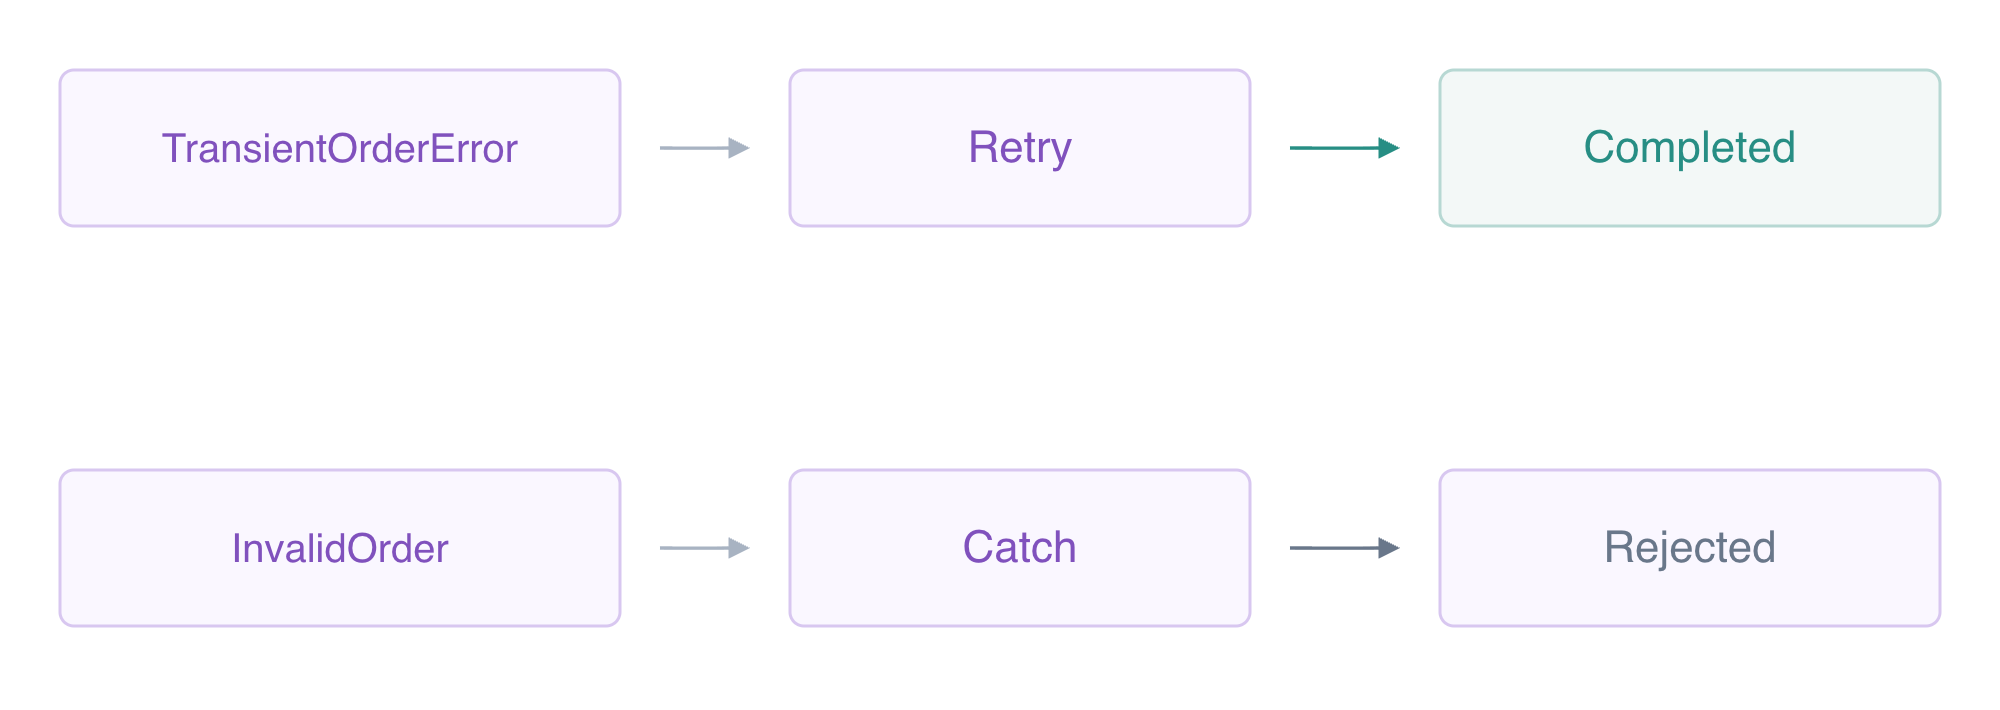
ASL-Retry listet auf, welche Aufgabenfehler wiederholt werden können. ErrorEquals muss dem Fehlertyp der Funktion entsprechen. IntervalSeconds:1 beginnt mit einer Verzögerung von einer Sekunde; BackoffRate:2 vervielfacht die nächste Verzögerung. MaxAttempts:2 erlaubt bis zu zwei Wiederholungen nach dem ersten Versuch. Diese Wiederholung behandelt nur TransientOrderError, nicht jeden möglichen Fehler.
Catch wählt einen anderen Zustand für einen Fehler, von dem sich die Aufgabe nicht erholt hat. ResultPath speichert den Fehler unter failure; Next erreicht einen ausdrücklichen Fail-Zustand. Die Behandlung eines Fehlers bedeutet nicht, dass der geschäftliche Auftrag erfolgreich war. Ein dauerhafter InvalidOrder endet mit FAILED und OrderRejected, statt vorzugeben, eine Bestellung abgeschlossen zu haben.
Ein Here-Dokument mit einer in Anführungszeichen gesetzten Markierung schreibt wörtliches JSON. Die vorhandene Choice weist eine nicht positive Menge zurück; die beiden Tasks speichern die Bestellung und lesen dann die Zusammenfassung. Payload.$ übergibt die aktuelle Eingabe, ResultSelector behält die tatsächliche Funktionsnutzlast bei, ResultPath erhält sie unter saved, und OutputPath gibt die tatsächliche Zusammenfassung zurück.
cat > workflow-template.json <<'JSON'
{
  "StartAt": "CheckQuantity",
  "States": {
    "CheckQuantity": {
      "Type": "Choice",
      "Choices": [
        {
          "Variable": "$.quantity",
          "NumericGreaterThan": 0,
          "Next": "StoreOrder"
        }
      ],
      "Default": "Rejected"
    },
    "StoreOrder": {
      "Type": "Task",
      "Resource": "arn:aws:states:::lambda:invoke",
      "Parameters": {
        "FunctionName": "WORKER_NAME",
        "Payload.$": "$"
      },
      "ResultSelector": {
        "result.$": "$.Payload"
      },
      "ResultPath": "$.saved",
      "Retry": [
        {
          "ErrorEquals": [
            "TransientOrderError"
          ],
          "IntervalSeconds": 1,
          "BackoffRate": 2,
          "MaxAttempts": 2
        }
      ],
      "Catch": [
        {
          "ErrorEquals": [
            "InvalidOrder"
          ],
          "Next": "Rejected",
          "ResultPath": "$.failure"
        }
      ],
      "Next": "ReadSummary"
    },
    "ReadSummary": {
      "Type": "Task",
      "Resource": "arn:aws:states:::lambda:invoke",
      "Parameters": {
        "FunctionName": "WORKER_NAME",
        "Payload": {
          "stage": "summary",
          "id.$": "$.saved.result.id"
        }
      },
      "OutputPath": "$.Payload",
      "End": true
    },
    "Rejected": {
      "Type": "Fail",
      "Error": "OrderRejected",
      "Cause": "Order could not be completed"
    }
  }
}
JSON
Schreibe die Konfiguration in workflow.json:
jq --arg worker "$WORKER_NAME" '.States.StoreOrder.Parameters.FunctionName=$worker | .States.ReadSummary.Parameters.FunctionName=$worker' workflow-template.json > workflow.json
Speichere den zurückgegebenen Wert in MACHINE_ARN:
MACHINE_ARN=$(aws stepfunctions create-state-machine \
  --name labex-ev04-orders \
  --type STANDARD \
  --role-arn "$ROLE_ARN" \
  --definition file://workflow.json \
  --query stateMachineArn \
  --output text)
echo "$MACHINE_ARN"
Prüfe die Zustandsmaschinendefinition und Rolle:
aws stepfunctions describe-state-machine \
  --state-machine-arn "$MACHINE_ARN" \
  --query '{Name:name,Definition:definition}'
Die Definition enthält die gezielten Retry- und Catch-Blöcke. AWS View zeigt dieselbe Konfiguration; es gibt noch keine Ausführungen oder geschäftlichen Bestellungen. Führe die Prüfung der Wiederherstellungsdefinition aus.
Tatsächliche Ergebnisse von Retry, Catch und Berechtigungen beobachten
Führe in diesem Schritt einen temporären Fehler, einen dauerhaften Fehler und einen verweigerten Aufruf aus.
Der erste flaky-Versuch des Workers aktualisiert einen Diagnoseversuchszähler und löst vor dem Schreiben einer Bestellung einen Fehler aus. Sein nächster Versuch kann erfolgreich sein. Eine begrenzte Shellschleife liest den Ausführungsstatus alle zwei Sekunden, bis die Ausführung nicht mehr läuft; $(...) erfasst die Ausgabe, und break verlässt die Schleife. Wenn die Ausführung nach der Schleife weiterhin RUNNING ist, untersuche sie, bevor du fortfährst.
Wähle die Abhilfe anhand des Fehlertyps: Ein vorübergehender Worker-Fehler kann einen weiteren Versuch rechtfertigen, ein dauerhafter Bestellfehler erfordert einen ausdrücklichen Fehlschlag, und bei einer Aufrufverweigerung muss die begrenzte Berechtigung wiederhergestellt werden. Verlauf und Bestell-/Versuchstabellen zeigen, ob der Worker lief und Daten schrieb.
RETRY_ARN=$(aws stepfunctions start-execution \
  --state-machine-arn "$MACHINE_ARN" \
  --name retry-order \
  --input '{"id":"retry-order","quantity":2,"mode":"flaky"}' \
  --query executionArn \
  --output text)
echo "$RETRY_ARN"
Frage diese Ausführung ab, bis sie RUNNING verlässt:
for attempt in $(seq 1 60); do
  STATUS=$(aws stepfunctions describe-execution \
    --execution-arn "$RETRY_ARN" \
    --query status \
    --output text)
  if test "$STATUS" != RUNNING; then break; fi
  sleep 2
done
Prüfe den Ausführungsstatus, die Ausgabe und Fehlerdetails:
aws stepfunctions describe-execution \
  --execution-arn "$RETRY_ARN" \
  --query '{Status:status,Output:output}'
Prüfe den tatsächlichen Workflow-Ausführungsverlauf:
aws stepfunctions get-execution-history \
  --execution-arn "$RETRY_ARN" \
  --query 'events[?type==`TaskFailed` || type==`TaskSucceeded`].{Type:type,Error:taskFailedEventDetails.error}'
Prüfe den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb get-item \
  --table-name labex-ev04-orders \
  --key '{"id":{"S":"retry-order"}}' \
  --query Item
Prüfe den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb get-item \
  --table-name labex-ev04-attempts \
  --key '{"id":{"S":"retry-order"}}' \
  --query Item
Der Endstatus ist SUCCEEDED mit der abgeschlossenen Zusammenfassung 2/600. Der Verlauf hat ein TaskFailed-Ereignis mit TransientOrderError, gefolgt von zwei TaskSucceeded-Ereignissen: erfolgreiches Speichern und Lesen der Zusammenfassung. Die Bestellung beim Dienst hat die Menge 2 und den Gesamtbetrag 600, und die Diagnoseversuche betragen 2. Ein Wiederholungsversuch und ein geschäftlicher Schreibvorgang sind unterschiedliche Zählungen.
Verwende jetzt den Modus für dauerhafte Fehler des Workers:
PERMANENT_ARN=$(aws stepfunctions start-execution \
  --state-machine-arn "$MACHINE_ARN" \
  --name permanent-order \
  --input '{"id":"permanent-order","quantity":2,"mode":"permanent"}' \
  --query executionArn \
  --output text)
echo "$PERMANENT_ARN"
Frage diese Ausführung ab, bis sie RUNNING verlässt:
for attempt in $(seq 1 30); do
  STATUS=$(aws stepfunctions describe-execution \
    --execution-arn "$PERMANENT_ARN" \
    --query status \
    --output text)
  if test "$STATUS" != RUNNING; then break; fi
  sleep 2
done
Prüfe den Ausführungsstatus, die Ausgabe und Fehlerdetails:
aws stepfunctions describe-execution \
  --execution-arn "$PERMANENT_ARN" \
  --query '{Status:status,Error:error}'
Prüfe den tatsächlichen Workflow-Ausführungsverlauf:
aws stepfunctions get-execution-history \
  --execution-arn "$PERMANENT_ARN" \
  --query 'events[?type==`TaskFailed` || type==`FailStateEntered`].{Type:type,Error:taskFailedEventDetails.error,State:stateEnteredEventDetails.name}'
Prüfe den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb get-item \
  --table-name labex-ev04-orders \
  --key '{"id":{"S":"permanent-order"}}' \
  --query Item
Ein tatsächlicher Worker-Aufruf schlägt mit InvalidOrder fehl; Catch erreicht Rejected, und die Ausführung endet mit FAILED und OrderRejected. Die Wiederholung für temporäre Fehler passt nicht auf diesen dauerhaften Fehler. Es gibt kein geschäftliches permanent-order-Element.
Entferne schließlich nur die Aufrufberechtigung des Workflows. Dein Operator kann Ausführungen starten, aber die Workflow-Rolle kann den Worker nicht aufrufen:
aws iam delete-role-policy --role-name labex-ev04-workflow-role --policy-name InvokeWorker
Speichere den zurückgegebenen Wert in DENIED_ARN:
DENIED_ARN=$(aws stepfunctions start-execution \
  --state-machine-arn "$MACHINE_ARN" \
  --name denied-order \
  --input '{"id":"denied-order","quantity":2,"mode":"flaky"}' \
  --query executionArn \
  --output text)
echo "$DENIED_ARN"
Frage diese Ausführung ab, bis sie RUNNING verlässt:
for attempt in $(seq 1 30); do
  STATUS=$(aws stepfunctions describe-execution \
    --execution-arn "$DENIED_ARN" \
    --query status \
    --output text)
  if test "$STATUS" != RUNNING; then break; fi
  sleep 2
done
Prüfe den Ausführungsstatus, die Ausgabe und Fehlerdetails:
aws stepfunctions describe-execution \
  --execution-arn "$DENIED_ARN" \
  --query '{Status:status,Error:error}'
Prüfe den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb get-item \
  --table-name labex-ev04-orders \
  --key '{"id":{"S":"denied-order"}}' \
  --query Item
Wende die Berechtigungsrichtlinie der Anwendungsrolle an:
aws iam put-role-policy \
  --role-name labex-ev04-workflow-role \
  --policy-name InvokeWorker \
  --policy-document file://workflow-invoke.json
Diese Ausführung mit verweigertem Zugriff schlägt fehl, ohne den Worker aufzurufen oder Diagnose- beziehungsweise Geschäftsdaten zu erstellen. Das Wiederholen des angegebenen Anwendungsfehlers repariert keine fehlende Autorisierung. Die vorgesehene Berechtigung ist wiederhergestellt. AWS View zeigt die erfolgreiche Zusammenfassung nach Wiederholung und zwei Fehler neben der einzigen Bestellung.
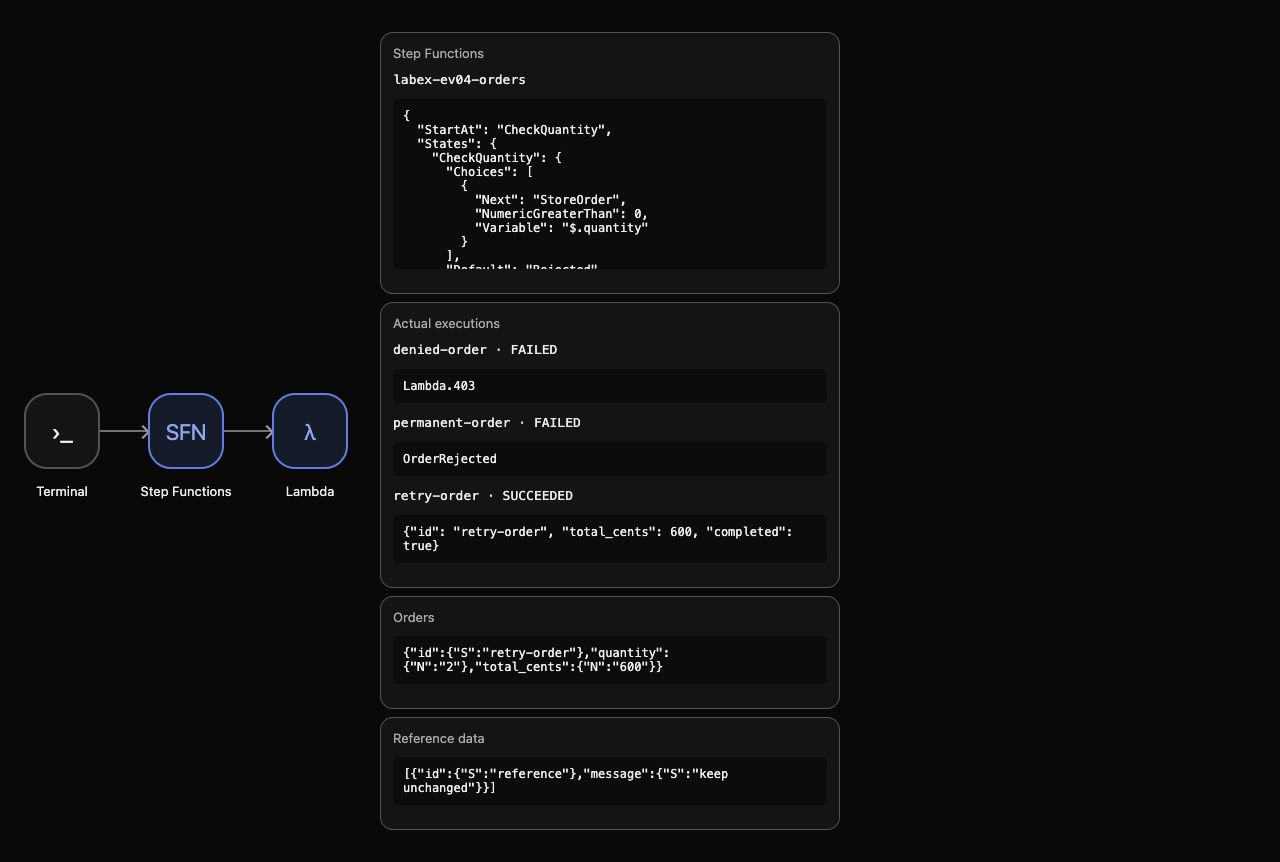
Führe die Prüfung der tatsächlichen Wiederherstellung aus.
Workflow-Ressourcen und fiktive Ergebnisse entfernen
Lösche in diesem Schritt deine abgeschlossene Maschine, Workflow-Rolle, Bestellung und Logs und erhalte dabei die vorbereiteten Ressourcen.
Alle drei Ausführungen sind beendet. Das Löschen der Maschine entfernt sie aus der Liste aktiver Maschinen. Entferne die eigene Rollenrichtlinie, bevor du die Rolle löschst, und entferne dann die fiktive Bestellung und die Worker-Log-Gruppe, die durch deine Ausführung erstellt wurden.
aws stepfunctions delete-state-machine --state-machine-arn "$MACHINE_ARN"
Lösche nur die Berechtigungsrichtlinie der Anwendungsrolle:
aws iam delete-role-policy --role-name labex-ev04-workflow-role --policy-name InvokeWorker
Lösche nur die Workflow-Ausführungsrolle der Übung:
aws iam delete-role --role-name labex-ev04-workflow-role
Lösche nur den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb delete-item --table-name labex-ev04-orders --key '{"id":{"S":"retry-order"}}'
Lösche nur den tatsächlich gespeicherten Datenbankeintrag:
aws dynamodb delete-item \
  --table-name labex-ev04-attempts \
  --key '{"id":{"S":"retry-order"}}'
Lösche nur die angegebene Anwendungsprotokollgruppe:
aws logs delete-log-group --log-group-name /aws/lambda/labex-ev04-worker
Lies erfolgreiche Bestandsabfragen, um zu belegen, was erhalten bleibt:
aws stepfunctions list-state-machines
Prüfe die verbleibenden IAM-Rollen:
aws iam list-roles --query 'Roles[].RoleName'
Prüfe die tatsächlich gespeicherten Bestellungen:
aws dynamodb scan --table-name labex-ev04-orders --query Items
Prüfe die verbleibenden Protokollgruppen:
aws logs describe-log-groups --query logGroups
Prüfe den nicht betroffenen Referenzdatensatz:
aws dynamodb scan --table-name labex-ev04-reference --query Items
Es gibt keine aktiven Maschinen, Bestellungen oder Log-Gruppen. Nur die bereitgestellte Worker-Rolle bleibt erhalten, und das Referenzelement ist unverändert. Behalte den bereitgestellten Worker und die Tabellen bei: Ihre Zugehörigkeit zum Setup unterscheidet sich von deinem erstellten Workflow und deinen Ressourcen. Netzwerk- oder Authentifizierungsfehler belegen niemals eine Löschung.
Entferne die gewöhnlichen Dateien, die in diesem Lab erstellt wurden:
rm -f workflow-trust.json workflow-invoke.json workflow-template.json workflow.json
AWS View zeigt leere Maschinen-, Ausführungs- und Bestelllisten und die erhaltene Referenz. Führe die Bereinigungsprüfung aus, bevor du die VM beendest.
Zusammenfassung
Du hast begrenzte Wiederholungen für einen bestimmten temporären Fehler und Catch zu einem ausdrücklichen dauerhaften Fehler konfiguriert. Verlauf beim Dienst und tatsächliche Bestellungen unterschieden Versuche von geschäftlichen Schreibvorgängen; die Berechtigungsverweigerung erzeugte weder eine Worker-Ausführung noch geschäftliche Auswirkungen. Du hast eigene Workflow-Ressourcen und Ergebnisse entfernt und dabei vorbereitete Ressourcen erhalten.
Die nächste Einheit behandelt einen Fehler, der nach dem geschäftlichen Schreibvorgang auftritt, wenn eine Wiederholung dessen Auswirkungen wiederholen könnte.
Weitere Informationen bietet die AWS-Dokumentation: Retry, Backoff und Catch-Fehlerbehandlung.