Einführung
Das Geschäft speichert Verkäufe je Monat. September ist registriert; die neue October-Datei liegt lokal. Lade sie unter ihrem S3-Monatspräfix hoch, registriere die Glue-Partition und frage den neuen Monat sowie beide Monate mit Athena ab.
Schließe zuerst Query S3 Data with Athena ab. Diese unabhängige Umgebung enthält die partitionierte Tabelle sales, September samt Registrierung, eine neue lokale CSV und AWS-Identität. Persönliche Konten oder frühere VM-Ressourcen sind nicht nötig. Nutze gewöhnliche S3/Glue/Athena-Befehle in Terminal und vergleiche Dateien, Partitionen und echte Ergebnisse in AWS View.
Zertifizierungsbezug
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Erklären, wie Glue-Metadaten partitionierte S3-Daten für Athena zugänglich machen. |
Die neue Monatsdatei hinzufügen
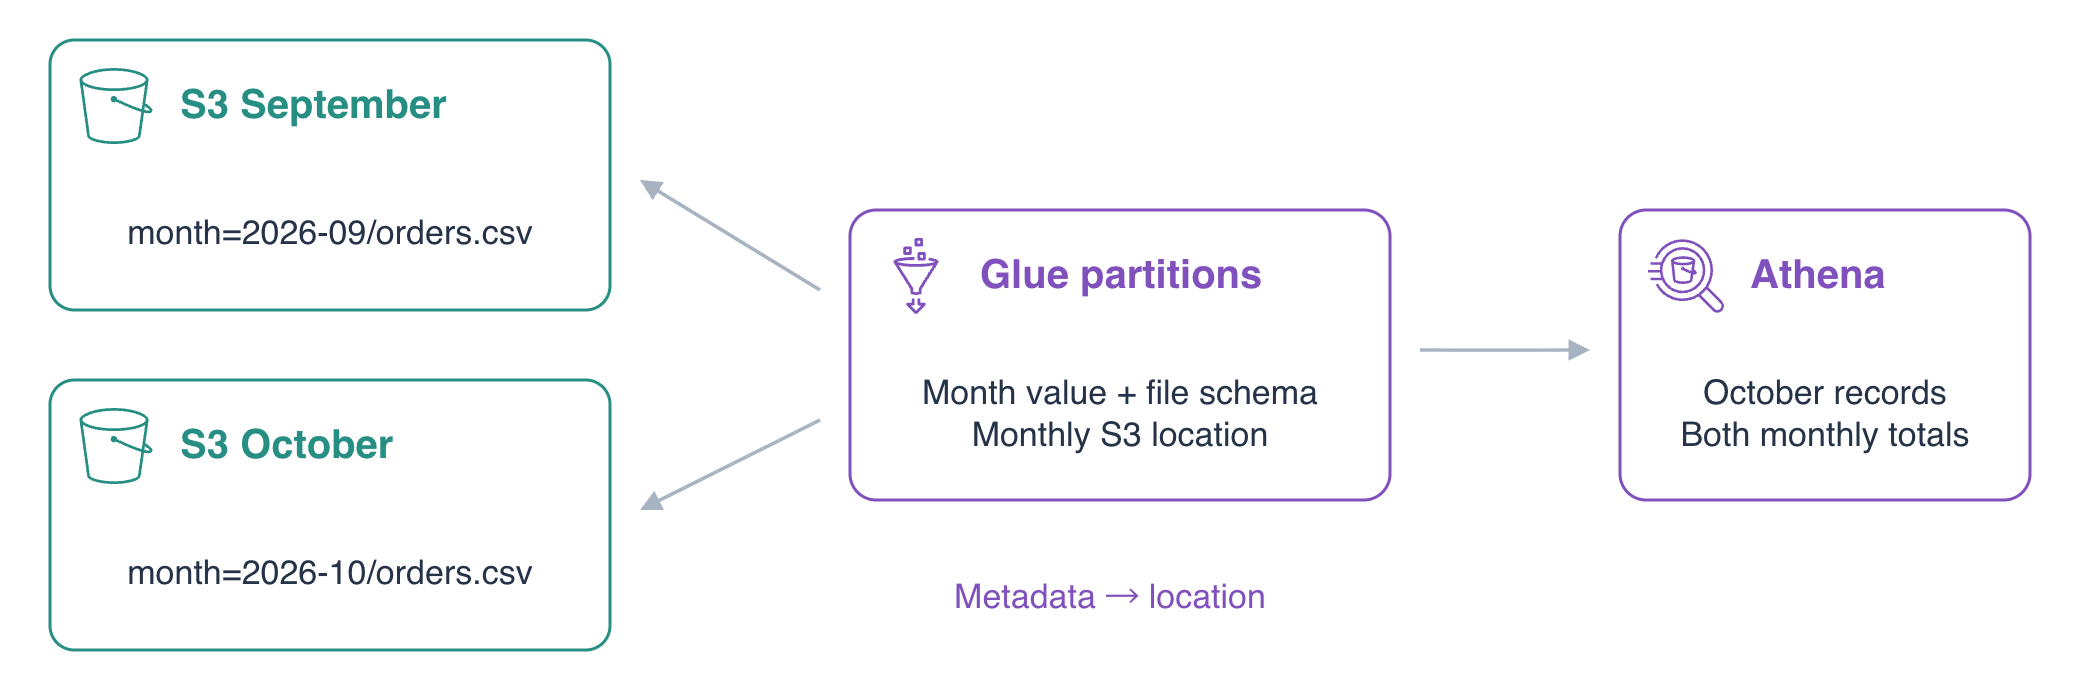
In diesem Schritt lädst du October hoch und bewahrst September. Eine Partition gruppiert Tabellendaten nach einem Schlüssel wie Monat. sales/month=2026-09/ enthält September, sales/month=2026-10/ nimmt October auf. key=value zeigt die Gruppe; Hochladen registriert keine Katalogpartition automatisch.
Prüfe im Projekt die Identität:
cd /home/labex/project
aws sts \
  get-caller-identity
Die ARN endet auf labex-an03-operator. jq -r liest JSON-Text, $(...) speichert ihn in Variablen:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive zeigt auch verschachtelte Präfixe:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
Du siehst sales/month=2026-09/orders.csv. September enthält 1000, 2000 und 500 Cent, insgesamt 3500. Bewahre diese Datei und reference/notes.txt. Prüfe October:
cat october.csv
O01/east/700, O02/west/900 und O03/east/400 sind drei neue Bestellungen mit zusammen 2000 Cent und denselben drei Spalten. Lade sie separat hoch:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
Lies das tatsächliche Objekt zurück:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
Das abschließende - gibt den Inhalt aus. AWS View zeigt zwei S3-Dateien, aber nur September in Glue. Dateiankunft und Registrierung sind getrennt.
October im Katalog registrieren
In diesem Schritt zeigst du, weshalb Hochladen nicht genügt, und ergänzt Metadaten. Eine Partition verbindet Schlüsselwert, S3-Ort und Schema. month ist ein Partitionsschlüssel vom Typ string. Die CSV hat nur order_id, region, total_cents; der Abfragewert month stammt aus der Definition.
Prüfe den Schlüssel:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
Er heißt month, Typ string. Frage vor der Registrierung ab. COUNT(*) zählt passende Zeilen; der zitierte Heredoc-Begrenzer bewahrt SQL:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
Sende mit vorbereiteter Datenbank und Ausgabepräfix und zeige die ID:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
Wiederhole bei QUEUED oder RUNNING, fahre bei SUCCEEDED fort und lies bei Fehlern Reason:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lies das Ergebnis:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Trotz S3-Datei ist die Anzahl 0. Diese Tabelle liest registrierte Orte; der Verzeichnisname erzeugt keine Metadaten.
Nutze den vorhandenen Speicherdeskriptor für gleiche Spalten und CSV-Format. > schreibt JSON in eine Datei:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg übergibt den echten Ort als Text. .Location = $location ersetzt ihn durch October; Values enthält den Wert des einzigen Schlüssels:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
Prüfe die gewöhnliche JSON-Definition:
cat october-partition.json
Bestätige 2026-10 in Values, passende Spalten und das Ende /sales/month=2026-10/. Die Klammern in ${SALES_LOCATION} trennen Variablenname und Zusatz. file:// liest die lokale JSON zur Registrierung:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
Liste beide Partitionen auf:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Jeder Monat zeigt auf sein Präfix, auch in AWS View. Registrierung ändert nur Metadaten, kopiert oder überschreibt keine CSV.
Den neuen Monat und beide Summen abfragen
In diesem Schritt beweist du, dass October verfügbar und September korrekt ist. WHERE auf dem Schlüssel wählt den Monat. Hier werden Datensätze geprüft, keine Scanpreise oder Produktionsgeschwindigkeit gemessen.
Schreibe die October-Abfrage:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
Sende eine neue Ausführung. Registrierung schreibt das frühere Null-Ergebnis nicht um:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
Prüfe den Status, wiederhole bei Bedarf, fahre nach Erfolg fort und lies Fehlergründe:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lies die Zeilen:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Nach dem Header kommen O01/700, O02/900, O03/400. Dieselbe zuvor unsichtbare Datei liefert jetzt drei Datensätze.
SUM addiert Cent und COUNT(*) zählt Bestellungen in jeder GROUP BY month-Gruppe:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Sende die Zusammenfassung und zeige ihre eigene ID:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
Bestätige Erfolg, wiederhole bei wartender Ausführung und prüfe Fehlergründe:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lies die Gruppen:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September hat 3500 Cent/3 Bestellungen, October 2000/3. September wurde nicht verändert. Vergleiche Glue-Orte, SQL und Zeilen in AWS View.
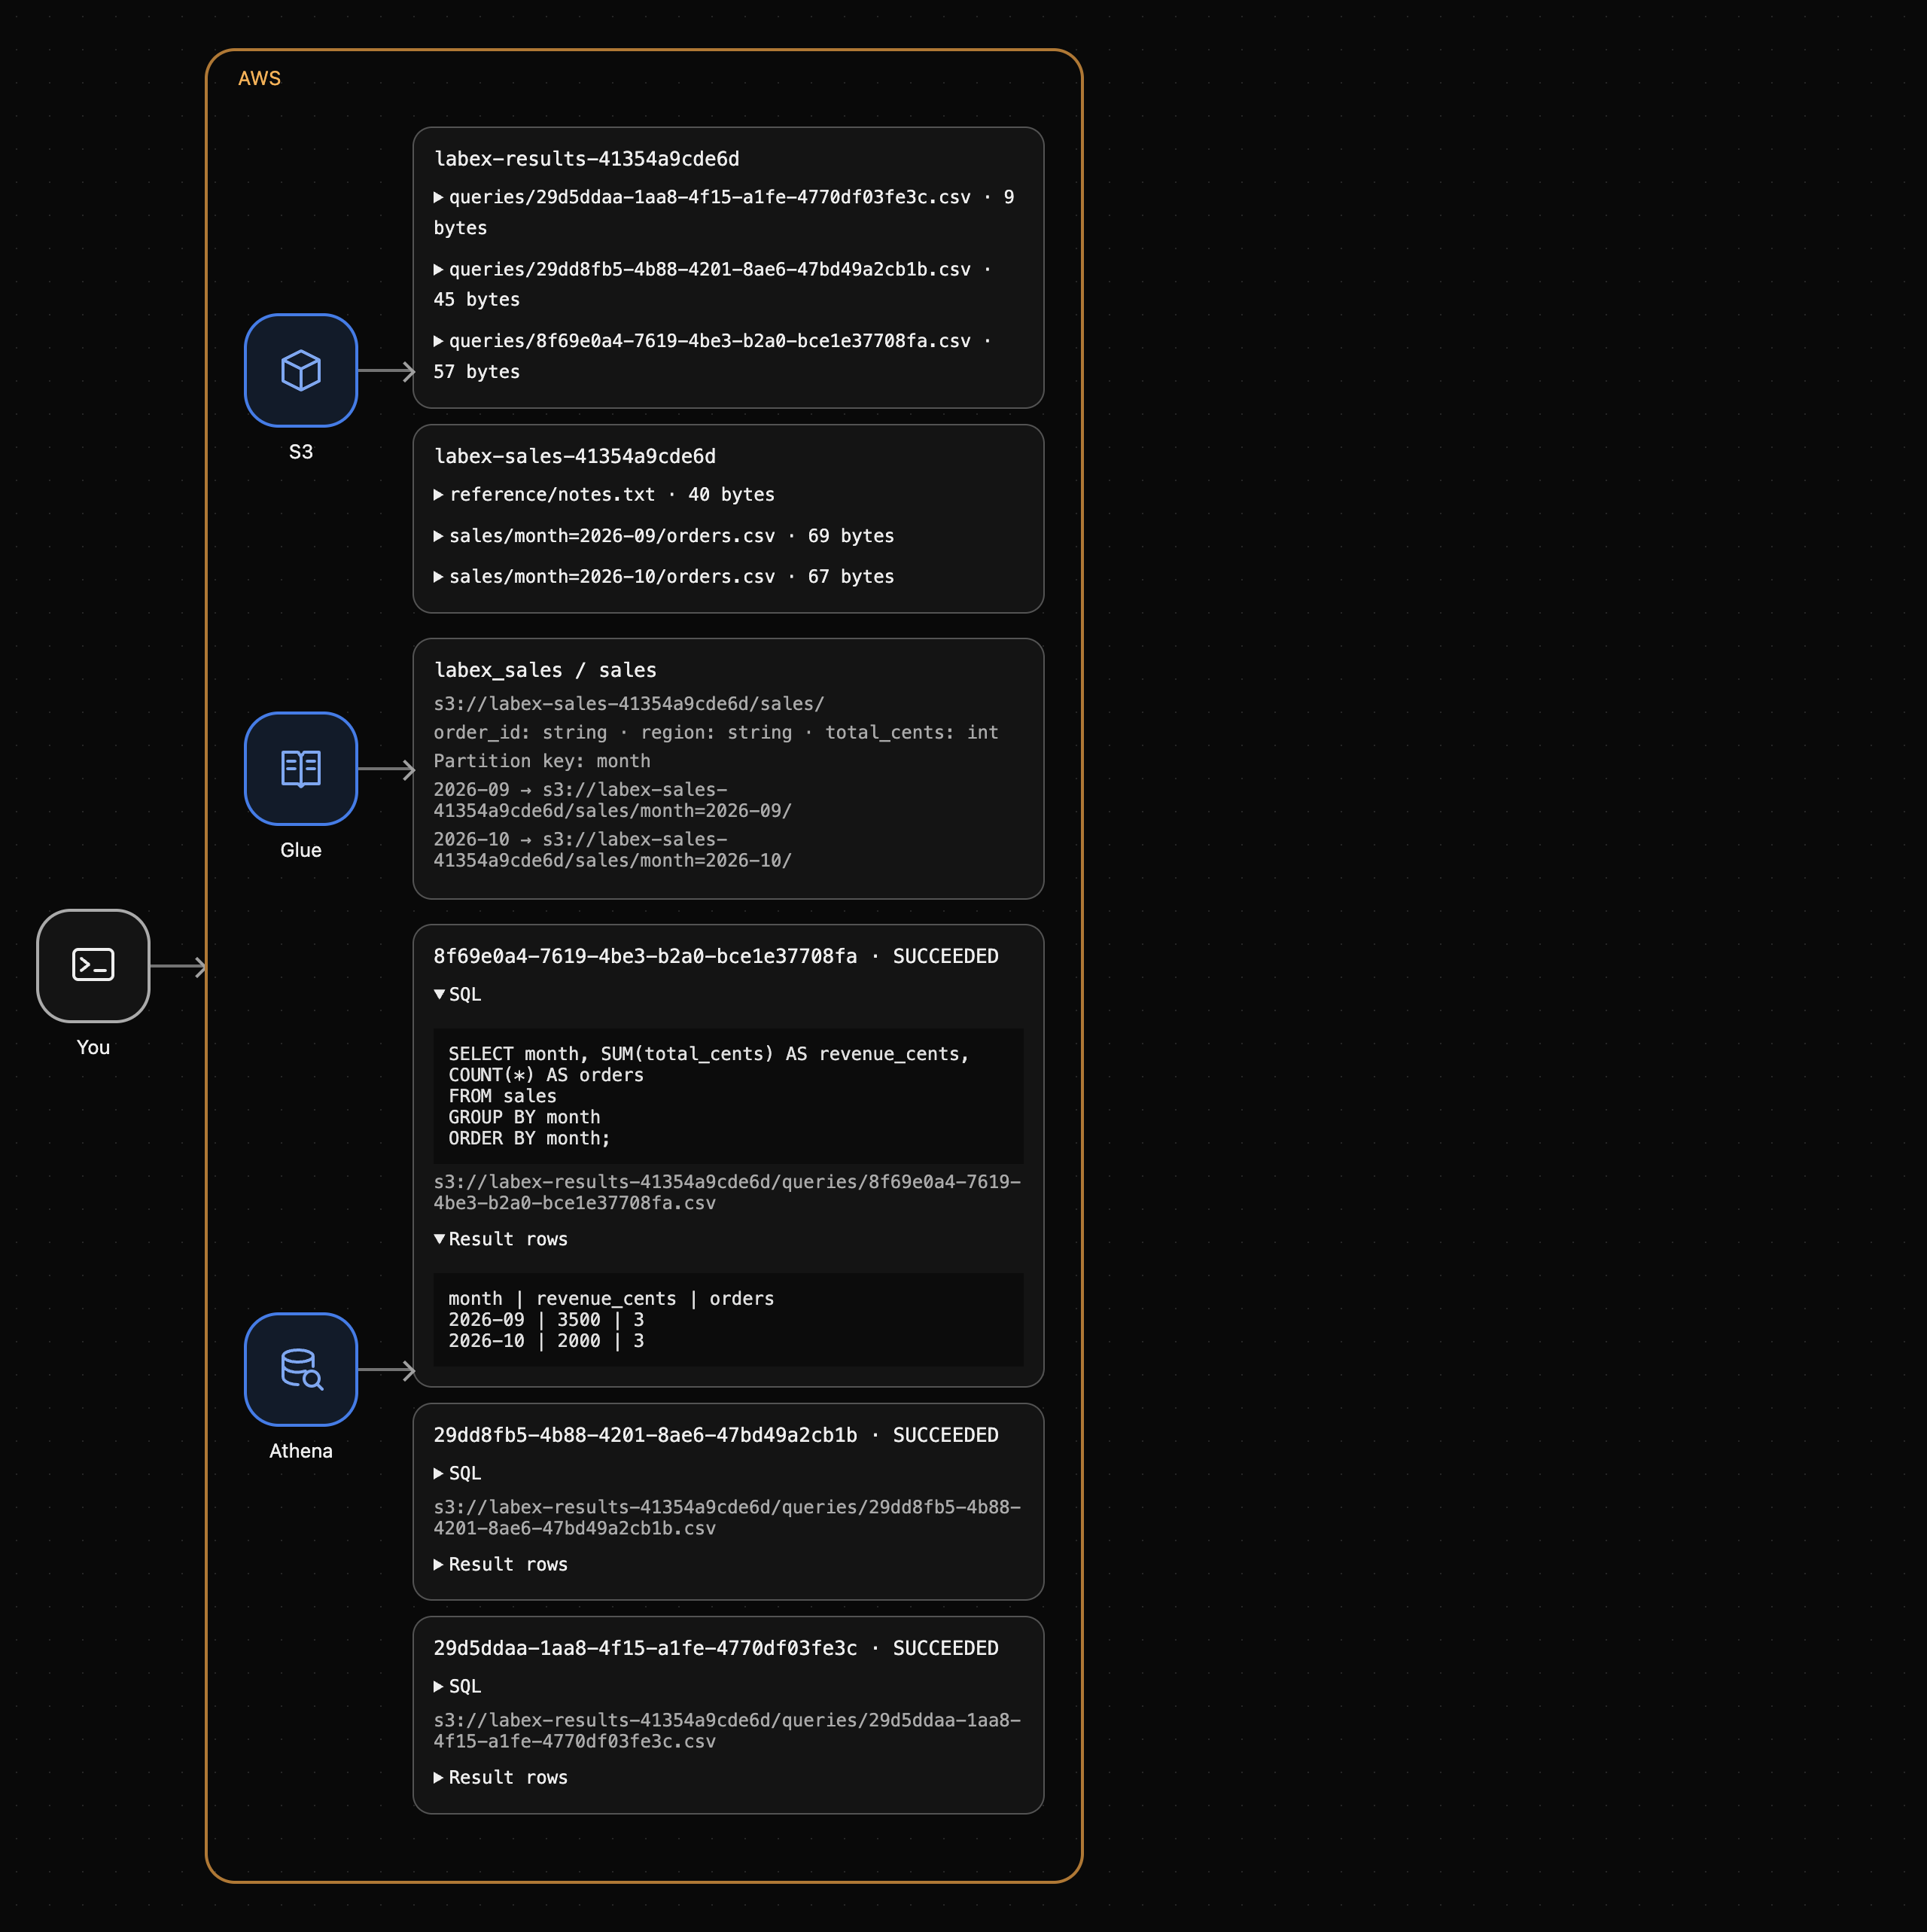
Das frühere Null-Ergebnis bleibt als getrennte Ausgabe des alten Katalogzustands bestehen.
Zusammenfassung
Du hast eine Monats-CSV hochgeladen, fehlende Zeilen ohne Registrierung beobachtet, Glue-Ort und Schema registriert und October sowie beide Monatssummen geprüft. Dateien und Metadaten sind getrennt; diese Tabelle benötigt eine passende Registrierung neuer Präfixe. Im nächsten Lab erstellst du aus echten Ergebnissen eine wiederverwendbare Zusammenfassungsdatei.
Weitere Informationen bietet die AWS-Dokumentation: Partitionsschlüssel, Speicherorte und Registrierung.