



Einführung
Deine Anwendung hat zwei Server hinter einem Application Load Balancer. Eine Anwendung kann ausfallen, obwohl ihre EC2-Instanz weiterläuft. Du konfigurierst Gesundheitsprüfungen, erzeugst einen echten Anwendungsfehler und prüfst, dass der gesunde Server weiter antwortet. Danach stellst du die Anwendung wieder her und entfernst die Ressourcen.
Du solltest ALB-Listener, Zielgruppen und SSH-Verbindungen zu EC2 kennen. Diese neue Umgebung stellt Netzwerk, zwei laufende Server, deren Registrierung und einen ALB-Listener bereit. Sie ist vom vorigen Lab unabhängig; AWS CLI und Verbindungsdateien sind vorbereitet.
Bezug zu Zertifizierungen
Dieses Lab bietet Grundlagenpraxis für folgende Prüfungsthemen.
- Solutions Architect – Associate (SAA-C03) · Aufgabe 2.2: Verstehen, wie Anwendungsgesundheit und Lastausgleich bei einem Serverausfall die Verfügbarkeit unterstützen.
- CloudOps Engineer – Associate (SOA-C03) · Aufgabe 2.2: ELB-Gesundheitsprüfungen konfigurieren und ein ungesundes Ziel diagnostizieren.
Die Gesundheitsprüfungen konfigurieren
Du untersuchst den bereitgestellten Dienst und legst fest, wie ALB die Anwendungsbereitschaft prüft.
Wechsle in das vorbereitete Verzeichnis und lade die Netzwerkvariablen:
cd /home/labex/project
source launch.env
Suche den bereitgestellten Load Balancer und die Zielgruppe nach Namen. Speichere ihre ARNs für weitere Befehle und den DNS-Namen für HTTP:
LB_ARN=$(aws elbv2 \
  describe-load-balancers \
  --names application-alb \
  --query 'LoadBalancers[0].LoadBalancerArn' \
  --output text)

TG_ARN=$(aws elbv2 \
  describe-target-groups \
  --names application-targets \
  --query 'TargetGroups[0].TargetGroupArn' \
  --output text)

LB_DNS=$(aws elbv2 \
  describe-load-balancers \
  --load-balancer-arns "$LB_ARN" \
  --query 'LoadBalancers[0].DNSName' \
  --output text)
Eine Gesundheitsprüfung untersucht jedes Ziel unabhängig von Clientanfragen. Der Pfad muss anzeigen, ob die Anwendung Verkehr bedienen kann. Untersuche die aktuellen Einstellungen:
aws elbv2 \
  describe-target-groups \
  --target-group-arns "$TG_ARN" \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Timeout:HealthCheckTimeoutSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount,Matcher:Matcher}'
Die bereitgestellte Gruppe prüft /health alle 30 Sekunden. Setze für diese Übung fünf Sekunden Intervall und zwei Sekunden Timeout. Zwei aufeinanderfolgende Fehler schließen ein Ziel aus; zwei Erfolge nehmen ein ungesundes Ziel wieder auf. Der Matcher akzeptiert HTTP 200 als Erfolg:
aws elbv2 \
  modify-target-group \
  --target-group-arn "$TG_ARN" \
  --health-check-protocol HTTP \
  --health-check-path /health \
  --health-check-interval-seconds 5 \
  --health-check-timeout-seconds 2 \
  --healthy-threshold-count 2 \
  --unhealthy-threshold-count 2 \
  --matcher HttpCode=200 \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount}'
Das Intervall bestimmt die Häufigkeit, das Timeout begrenzt jede Prüfung. Schwellenwerte verhindern Reaktionen auf kurze Fehler. Produktionswerte müssen zu Start- und Fehlerverhalten passen; kurze Werte machen diese Übung beobachtbar.
Warte auf beide gesunden Ziele und untersuche ihre tatsächlichen Zustände:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Port:Target.Port,Health:TargetHealth.State}' \
  --output table
Öffne AWS View. Bestätige zwei healthy-Ziele und klicke auf Send request für eine echte HTTP-200-Antwort. Zustände und Antwort zeigen die Ausgangslage.
Einen echten Anwendungsfehler beobachten
Du lässt den Gesundheitsendpunkt von app-a fehlschlagen, während dessen EC2-Instanz weiterläuft.
Ermittle die IDs anhand ihrer Namenstags und die Adresse für SSH:
APP_A=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-a \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_B=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-b \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_A_IP=$(aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" \
  --query 'Reservations[0].Instances[0].PublicIpAddress' \
  --output text)
Die Anwendung liest /etc/report-app/config.json bei jeder Anfrage. healthy bestimmt, ob /health mit 200 oder 503 antwortet. Nutze SSH mit dem bereitgestellten Schlüssel und den Einstellungen. jq ändert nur dieses Feld; eine temporäre Datei verhindert Überschreiben beim Lesen, und install ersetzt die Datei mit Leserechten:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = false" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Prüfe die Anwendung direkt innerhalb des Servers. -o /dev/null verwirft den Inhalt, -w zeigt den HTTP-Status:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
Erwarte 503. Das ist ein Anwendungsfehler, kein EC2-Stopp. Lasse Zeit für zwei Prüfungen und untersuche die Ursache:
sleep 12

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State,Reason:TargetHealth.Reason}' \
  --output table
APP_A sollte unhealthy mit Target.ResponseCodeMismatch sein, weil 503 nicht zu 200 passt. APP_B bleibt healthy. Prüfungen sind asynchron; warte bei einer laufenden Umstellung kurz und wiederhole die Abfrage.
Prüfe, dass die EC2-Instanzen weiterlaufen:
aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" "$APP_B" \
  --query 'Reservations[].Instances[].{Instance:InstanceId,State:State.Name}' \
  --output table
Sende sechs einzelne Anfragen über den ALB:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Jede Antwort sollte APP_B identifizieren. Bestätige in AWS View ein ungesundes und ein gesundes Ziel. Klicke mehrfach auf Send request; erfolgreiche Antworten sollten vom gesunden Server stammen. ALB schließt das fehlerhafte Ziel aus, solange ein gesundes verfügbar ist.
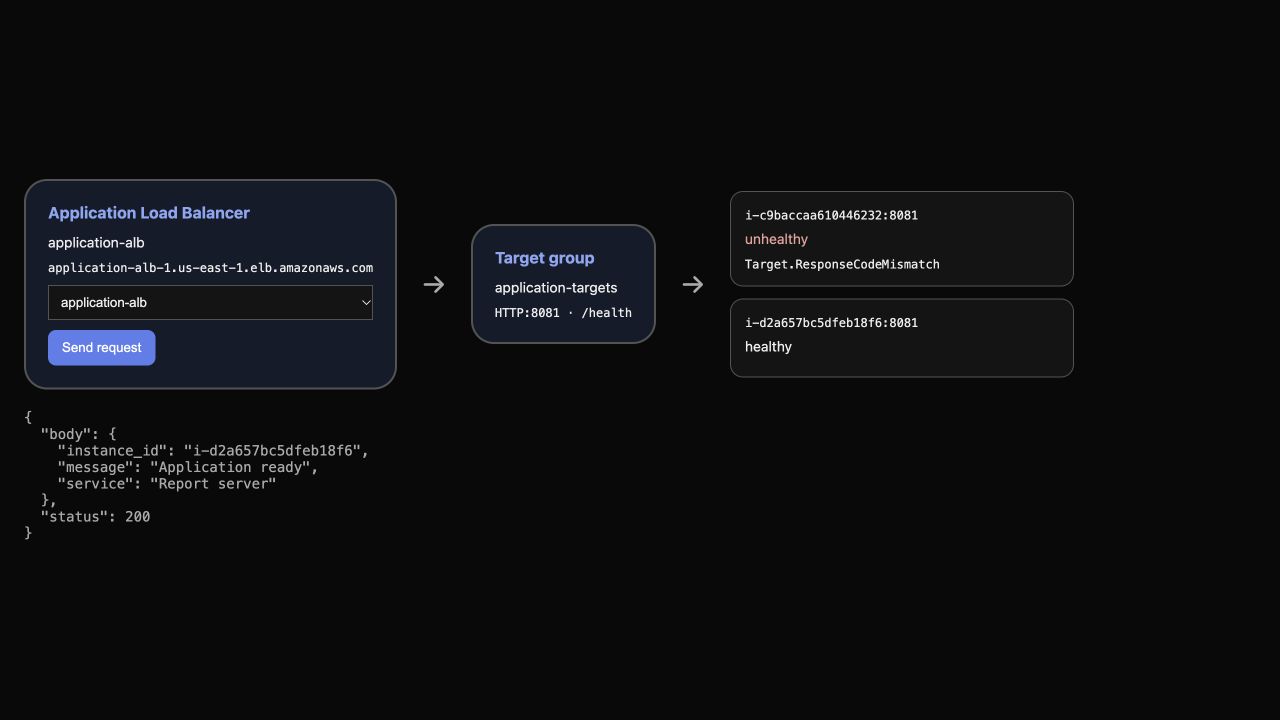
Das Beispiel zeigt echte HTTP 200 vom gesunden Ziel, während das andere Target.ResponseCodeMismatch meldet. Deine IDs unterscheiden sich; vergleiche die Antwort mit deinem gesunden Ziel.
Sind alle Ziele ungesund, kann ALB Fail Open verwenden und zu ungesunden Zielen weiterleiten. app-b muss gesund bleiben; eine vollständig ungesunde Gruppe beweist nicht, dass ALB alle Anfragen blockiert.
Das Ziel wiederherstellen und aufnehmen
Du stellst app-a wieder her und beobachtest seine Rückkehr nach erfolgreichen Prüfungen.
Stelle nur healthy mit derselben sicheren Dateiersetzung wieder her:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = true" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Prüfe, dass der direkte Endpunkt nun 200 liefert:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
Die Anwendung ist wiederhergestellt, aber ALB muss die konfigurierten aufeinanderfolgenden Erfolge beobachten. Warte auf den gesunden Zustand und prüfe beide Ziele:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State}' \
  --output table
Beide sollten healthy sein. Sende nochmals sechs Anfragen:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Suche beide IDs. Bestätige in AWS View zwei gesunde Karten und beobachte mit Send request beide Server. Du hast die Anwendung repariert und erfolgreiche Prüfungen ermöglicht; die Instanz wurde weder ersetzt noch abgemeldet.
Die Ressourcen entfernen
Du entfernst die bereitgestellte Lastausgleichskonfiguration und bewahrst die wiederhergestellten Server und das Netzwerk.
Ermittle den Listener-ARN, lösche zuerst den Listener, danach ALB und Zielgruppe:
LISTENER_ARN=$(aws elbv2 \
  describe-listeners \
  --load-balancer-arn "$LB_ARN" \
  --query 'Listeners[0].ListenerArn' \
  --output text)

aws elbv2 \
  delete-listener \
  --listener-arn "$LISTENER_ARN"

aws elbv2 \
  delete-load-balancer \
  --load-balancer-arn "$LB_ARN"

aws elbv2 \
  delete-target-group \
  --target-group-arn "$TG_ARN"
Bestätige, dass beide Listen leer sind:
aws elbv2 \
  describe-load-balancers \
  --query 'LoadBalancers[].LoadBalancerName'

aws elbv2 \
  describe-target-groups \
  --query 'TargetGroups[].TargetGroupName'
Erwarte [] für beide Abfragen und leere Bereiche in AWS View. Bewahre die bereitgestellten EC2-Server und das Netzwerk.
Zusammenfassung
Du hast ALB-Prüfungen konfiguriert, einen echten Fehler erzeugt und ihn von einem EC2-Stopp unterschieden. Du hast Verkehr am gesunden Server beobachtet, die Anwendung wiederhergestellt und Antworten beider Server bestätigt. Zuletzt hast du die Ressourcen entfernt und Server sowie Netzwerk bewahrt.
Das nächste Lab verwendet eine Auto-Scaling-Gruppe, um fehlerhafte Instanzen zu ersetzen, statt einen vorhandenen Server manuell zu reparieren.


