Einführung
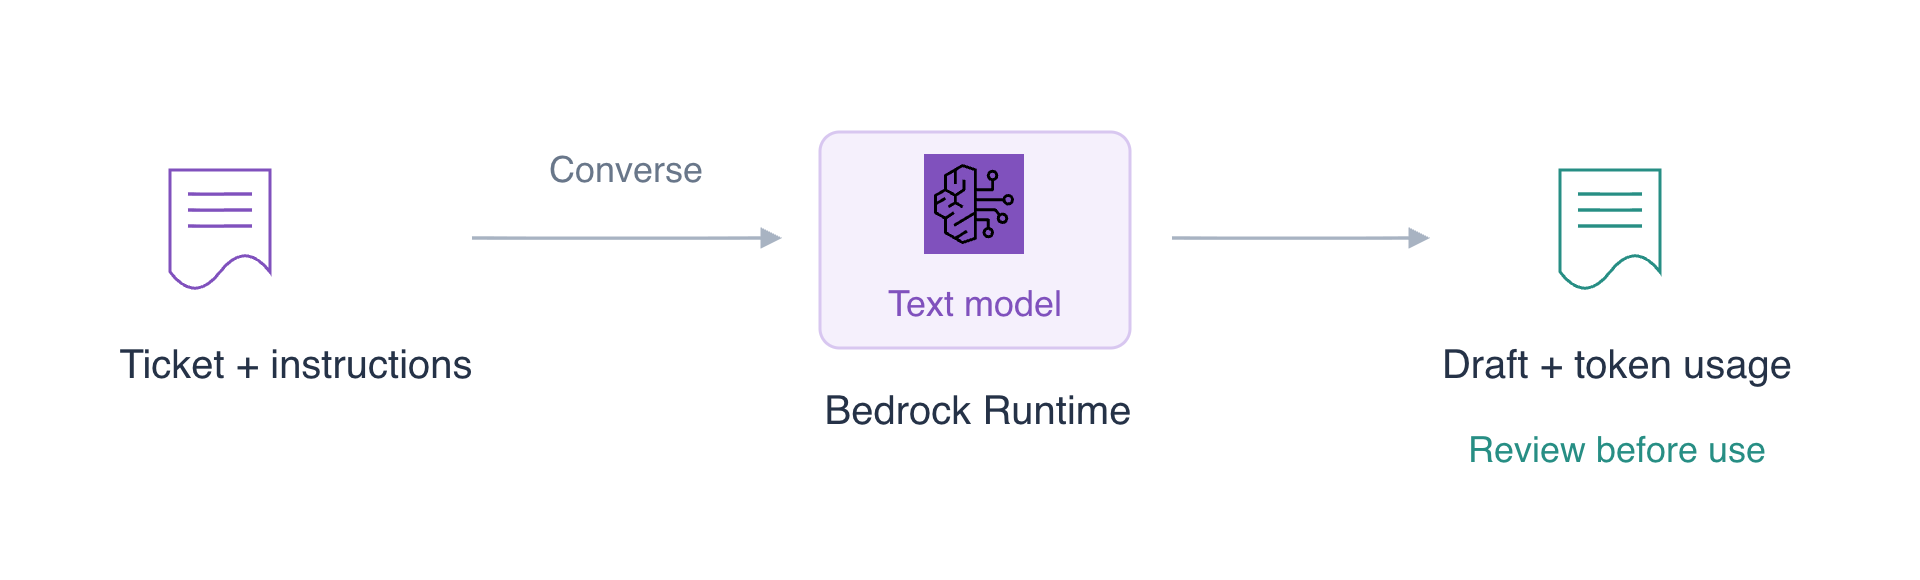
Ein Supportteam benötigt einen Antwortentwurf auf eine gemeldete doppelte Abbuchung. Du sendest das Ticket an Bedrock Runtime, präzisierst die Anweisungen, prüfst die erzeugte Antwort und vergleichst den Tokenverbrauch mit einem Ausgabelimit. Die AWS CLI ist in deiner neuen LabEx-VM bereits eingerichtet; verwende nur das bereitgestellte synthetische Ticket.
Du solltest Befehle ausführen und Textdateien lesen können. Die Aufgabe ist, einen Entwurf zu erzeugen und zu prüfen, nicht eine Kundennachricht zu senden oder Abrechnungsdaten zu ändern.
Bezug zur Zertifizierung
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| AI Practitioner (AIF-C01) | Aufgaben 3.1, 3.2 | Ausgabelänge anpassen, klare Schreibanweisungen geben und erzeugten Text prüfen. |
Eine Supportantwort entwerfen
In diesem Schritt wählst du ein verfügbares Textmodell und sendest ein Supportticket an Bedrock Runtime.
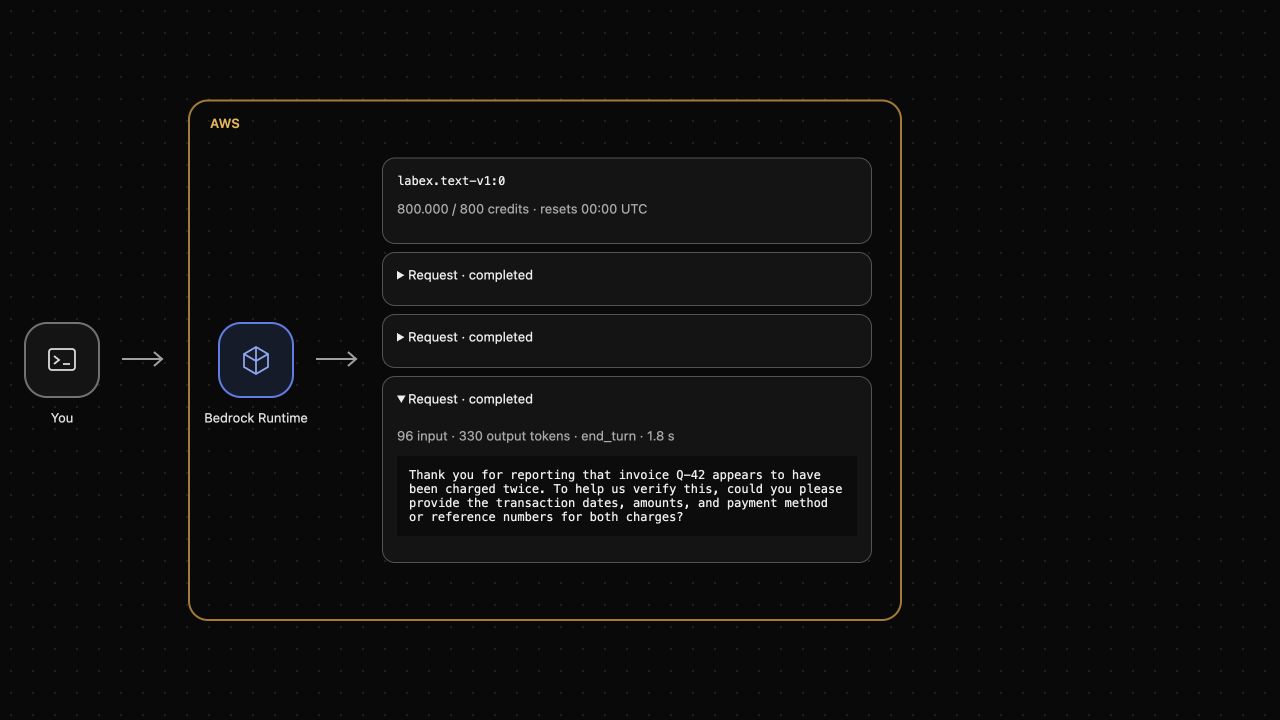
Oben zeigt AWS View das Modell und tatsächliche Anfrageergebnisse. Unten gibst du Befehle in Terminal ein. Vor der ersten Anfrage gibt es keine Antworten. Die Ansicht zeigt eine laufende Anfrage und danach Antwort, Verbrauch und Restkontingent.
Bedrock ermöglicht Zugriff auf Foundation Models, die Text für viele Aufgaben erzeugen können. Eine Modellkennung wählt das Modell; Converse ist ein gemeinsames Anfrageformat für unterstützte Konversationsmodelle. Hier arbeitest du mit dem in dieser Umgebung verfügbaren Textmodell.
Beginne im Übungsverzeichnis. cd ändert das aktuelle Verzeichnis von Terminal:
cd /home/labex/project
Liste Modelle auf, die Text erzeugen. --by-output-modality TEXT filtert den Katalog. --query wählt Kennung und lesbaren Namen, und --output table zeigt diese Felder als Tabelle:
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
Die Tabelle enthält labex.text-v1:0, das du gleich nutzt. Ein Katalogeintrag beschreibt ein Modell; er bedeutet nicht, dass bereits eine Inferenzanfrage ausgeführt wurde.
Eine Converse-Anfrage enthält eine modelId, eine Liste von messages und optionale Inferenzeinstellungen. Jede Nachricht hat eine role und Inhaltsblöcke. Eine user-Nachricht enthält Frage oder Aufgabe; ein Textblock verwendet das Feld text. maxTokens begrenzt die erzeugte Ausgabe, temperature die Variation beim Sampling. Ein niedriger Wert kann Variation verringern, garantiert aber keine richtigen oder identischen Antworten.
Erstelle die Anfrage als JSON. cat > request.json schreibt eine Datei; <<'EOF' beginnt eine wörtliche mehrzeilige Eingabe und das letzte EOF beendet sie. Nur die benannte Übungsdatei wird ersetzt:
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Sende die Anfrage mit bedrock-runtime converse. --cli-input-json file://request.json liest die Felder aus der Datei. Das abschließende > reply.json speichert die JSON-Antwort, statt sie auszugeben:
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
Warte, bis die Terminal-Eingabeaufforderung zurückkehrt. Texterzeugung dauert meist einige Sekunden. Sende keine weitere Anfrage, solange die erste läuft.
Lies die Antwort:
cat reply.json
Suche output.message.role: "assistant" und einen nicht leeren text-Block. usage meldet verarbeitete Tokens und metrics.latencyMs die Antwortzeit in Millisekunden. Klappe die abgeschlossene Anfrage in AWS View oberhalb von Terminal auf und vergleiche die Antwort mit der Datei.
Lies den Entwurf sorgfältig. Behauptet er, dass eine Untersuchung begann, eine Erstattung erfolgte oder eine Abbuchung bestätigt wurde? Das Ticket enthält keine dieser Fakten. Flüssige Antworten können Details erfinden; als Nächstes präzisierst du die Anweisungen. Ein erzeugter Satz ist keine ausgeführte Abrechnungsaktion.
Die Schreibanweisungen präzisieren
In diesem Schritt ergänzt du klare Anweisungen und erzeugst einen neuen Entwurf mit denselben gemeldeten Fakten.
Das Feld system gibt Aufgaben- und Stilvorgaben. Belasse das Ticket in der Benutzernachricht und die Schreibvorgaben in der Systemnachricht. Genauere Anweisungen können unerwünschte Details verringern, doch die Antwort muss weiterhin geprüft werden.
Erstelle eine separate Anfrage, damit der ursprüngliche Entwurf zum Vergleich erhalten bleibt:
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Erzeuge den überarbeiteten Entwurf:
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
Prüfe die gespeicherte Antwort mit Pythons standardmäßigem JSON-Formatierer. Er prüft gültiges JSON und bereitet es lesbar auf:
python3 -m json.tool revised-reply.json
Klappe die neue abgeschlossene Anfrage in AWS View auf. Vergleiche beide Entwürfe mit dem Ticket. Die überarbeitete Anfrage soll Erwartungen klären; ob diese konkrete Antwort ihnen entspricht, erfordert weiterhin menschliches Urteil. Verwendest du eine Kundennachricht, übernimm keinen Satz mit einer erfundenen Aktion.
Die Anfragen sind unabhängig. Dasselbe Modell übermittelt die frühere Antwort nicht automatisch als Gesprächsverlauf. Ein späteres Gespräch müsste frühere Benutzer- und Assistentennachrichten ausdrücklich in messages einschließen.
Tokenverbrauch und Ausgabelimits prüfen
In diesem Schritt sendest du dieselbe Aufgabe mit kleinerem Ausgabelimit und prüfst den tatsächlichen Verbrauch.
Ein Token ist eine vom Modell verarbeitete Texteinheit, nicht zwingend ein Wort. Eingabetokens umfassen Aufgabe, Systemanweisungen und übergebenen Verlauf. Ausgabetokens umfassen die vom Modell gemeldeten erzeugten Tokens, möglicherweise einschließlich interner Denkprozesse. Das zurückgegebene totalTokens summiert Eingabe und Ausgabe.
maxTokens ist eine Obergrenze, keine Vorgabe für genau diese Anzahl. Das Modell kann früher fertig sein. Erstelle eine Anfrage mit 384 statt 512 Tokens als Grenze:
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
Sende sie und speichere die Antwort:
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
Prüfe das Ergebnis:
python3 -m json.tool bounded-reply.json
Vergleiche usage.outputTokens mit der Grenze von 384. stopReason: "end_turn" bedeutet normalen Abschluss; "max_tokens" bedeutet, dass die Grenze erreicht wurde und der Text unvollständig sein kann. Eine Teilantwort ist nicht automatisch ein fertiges Dokument.
AWS View zeigt denselben Verbrauch und die restlichen Credits. Credits folgen modellabhängigem Eingabe-/Ausgabeverbrauch; Tokenzahlen ergeben keinen universellen Preis für verschiedene Modelle. Wiederholte Anfragen können gespeicherte Modellergebnisse nutzen: Tokens können angezeigt werden, ohne dass Credits sinken. Ein kleineres Limit garantiert nicht, dass diese kurze Antwort weniger Tokens als jede frühere verbraucht.
Scheitert eine Anfrage oder ist ihr Verbrauch ungewiss, prüfe den Fehler vor einem neuen Versuch. Eine ungewisse Anfrage kann reserviertes Kontingent behalten; eine weitere kann mehr verbrauchen. Die Behandlung in Anwendungen folgt später im Kurs.
Die Übungsdateien entfernen
In diesem Schritt entfernst du nach Prüfung der Entwürfe lokale Anfrage- und Antwortdateien.
Converse sendet eine Inferenzanfrage und erstellt keinen Server oder eine Datenbank zum Löschen. Die sechs JSON-Dateien sind lokale Übungsartefakte. Ihre Löschung macht Tokenverbrauch nicht rückgängig und erstattet keine verbrauchten Credits.
rm entfernt die genannten Dateien. Verwende genau die folgenden Namen und behalte andere Projektdateien:
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
Liste die verbleibenden sichtbaren Einträge auf:
ls
Die sechs Dateien sollten fehlen. AWS View behält die tatsächlichen Ergebnisse abgeschlossener Anfragen dieser VM, einschließlich Verbrauch. Das Löschen einer Datei macht aus einem Fehlschlag keinen Erfolg und entfernt keinen Verbrauch.
Zusammenfassung
Du hast tatsächliche Textanfragen mit Bedrock Converse gesendet, Systemanweisungen präzisiert, Antworten und Tokens geprüft, die Ausgabe begrenzt und lokale Übungsdateien entfernt. Du hast auch einen plausiblen Entwurf von einer bestätigten Geschäftstatsache unterschieden: Vor Verwendung muss jede Antwort geprüft werden.
Weitere Informationen bietet die AWS-Dokumentation: Converse-Nachrichten, Anweisungen und Inferenzparameter; Converse-Antwortinhalt, Stoppgründe und Nutzung.