Einführung
Das Geschäft braucht eine teilbare Monatsübersicht als CSV. Berechne mit Athena, lade die echte S3-Ausgabe, korrigiere einen Betrag und erstelle eine neue Übersicht. Vergleiche beide Ausgaben mit der Eingabe zum Ausführungszeitpunkt.
Schließe Query Partitioned Sales Data ab. Die unabhängige Umgebung liefert zwei Monatsdateien, registrierte Glue-Partitionen, AWS-Identität und eine lokale September-Korrektur. Persönliches Konto und frühere VM-Ressourcen sind nicht nötig. Nutze die offizielle CLI in Terminal und prüfe Dateien, Katalog und Ergebnisse in AWS View.
Zertifizierungsbezug
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | S3 mit Athena und Glue analysieren und berechnete Ergebnisse abrufen. |
Die Monatsübersicht berechnen
In diesem Schritt berechnest du aus aktuellen Dateien. Glue beschreibt Schema und Monatsorte, Athena liest und gruppiert. Jede Ausführung hat eine eigene ID und Ergebnisdatei.
Prüfe im Projekt deine Identität:
cd /home/labex/project
aws sts \
  get-caller-identity
Die ARN endet auf labex-an04-operator. jq -r liest JSON-Zeichenketten, $(...) speichert die Ausgabe in Variablen:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
Prüfe die registrierten Orte:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Beide Monate sind registriert. Ganze Cent in total_cents vermeiden Währungsrundung. COUNT(*) zählt Bestellungen, GROUP BY month gruppiert, ORDER BY month erleichtert Vergleiche. Ein zitierter Heredoc schreibt SQL unverändert:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Sende mit Datenbank und S3-Präfix. file:// liest SQL; CLI---query und --output text wählen die ID:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
Wiederhole bei QUEUED/RUNNING, fahre bei SUCCEEDED fort und prüfe Reason bei FAILED:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Die verschachtelte Projektion [*] erhält die Spalten je Zeile:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
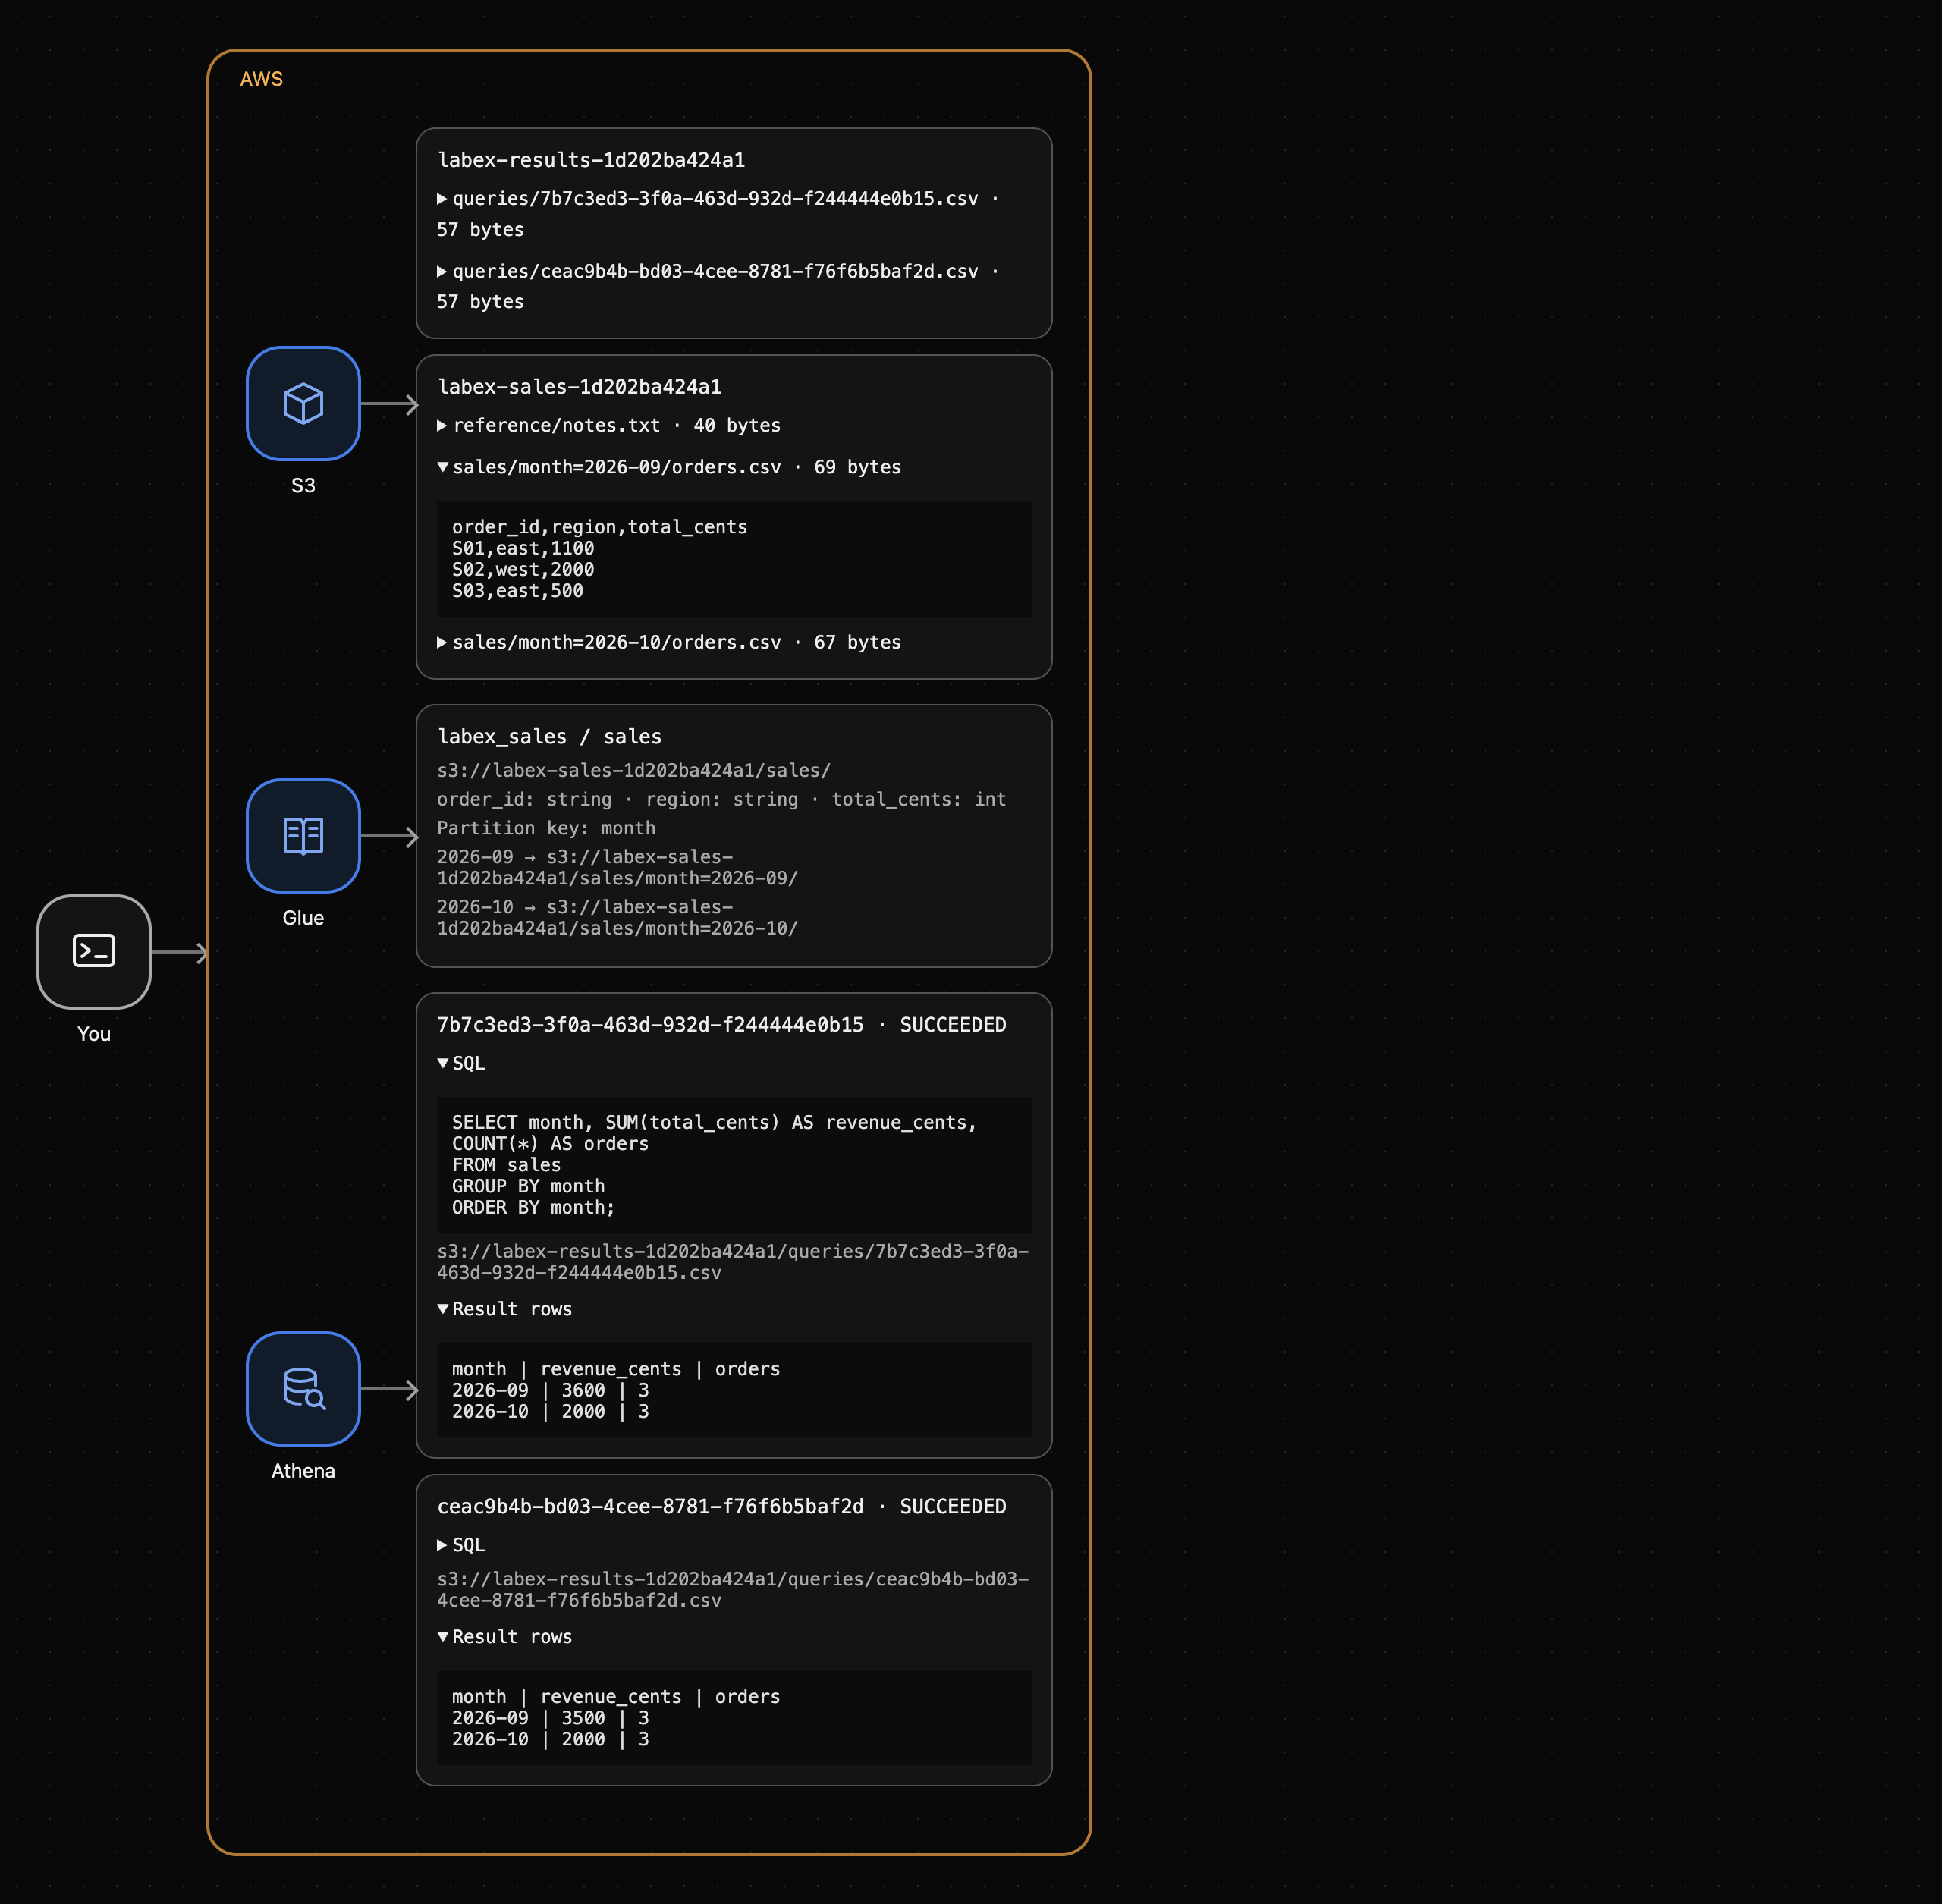
September hat 3500 Cent/3 Bestellungen, October 2000/3. Vergleiche SQL und Zeilen in AWS View mit den Monatsorten.
Die echte S3-Ergebnisdatei herunterladen
In diesem Schritt holst du die CSV dieser Ausführung. Die Ergebnis-API zeigt Zeilen; Metadaten liefern den exakten S3-Ort. Rate weder Bucket noch ID.
Lies und zeige die URI:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
Sie endet auf /queries/<your-execution-id>.csv. Die ID verbindet Datei und Abfrage. Lade nach summary.csv:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
Prüfe den Inhalt:
cat summary.csv
Header und zwei Datensätze:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
Die Werte entsprechen der API. Es ist eine echte heruntergeladene Datei, kein manuell geschriebener Bericht. Bewahre summary.csv und die ursprüngliche S3-Ausgabe zum Vergleich.
Nach einer Eingabekorrektur neu berechnen
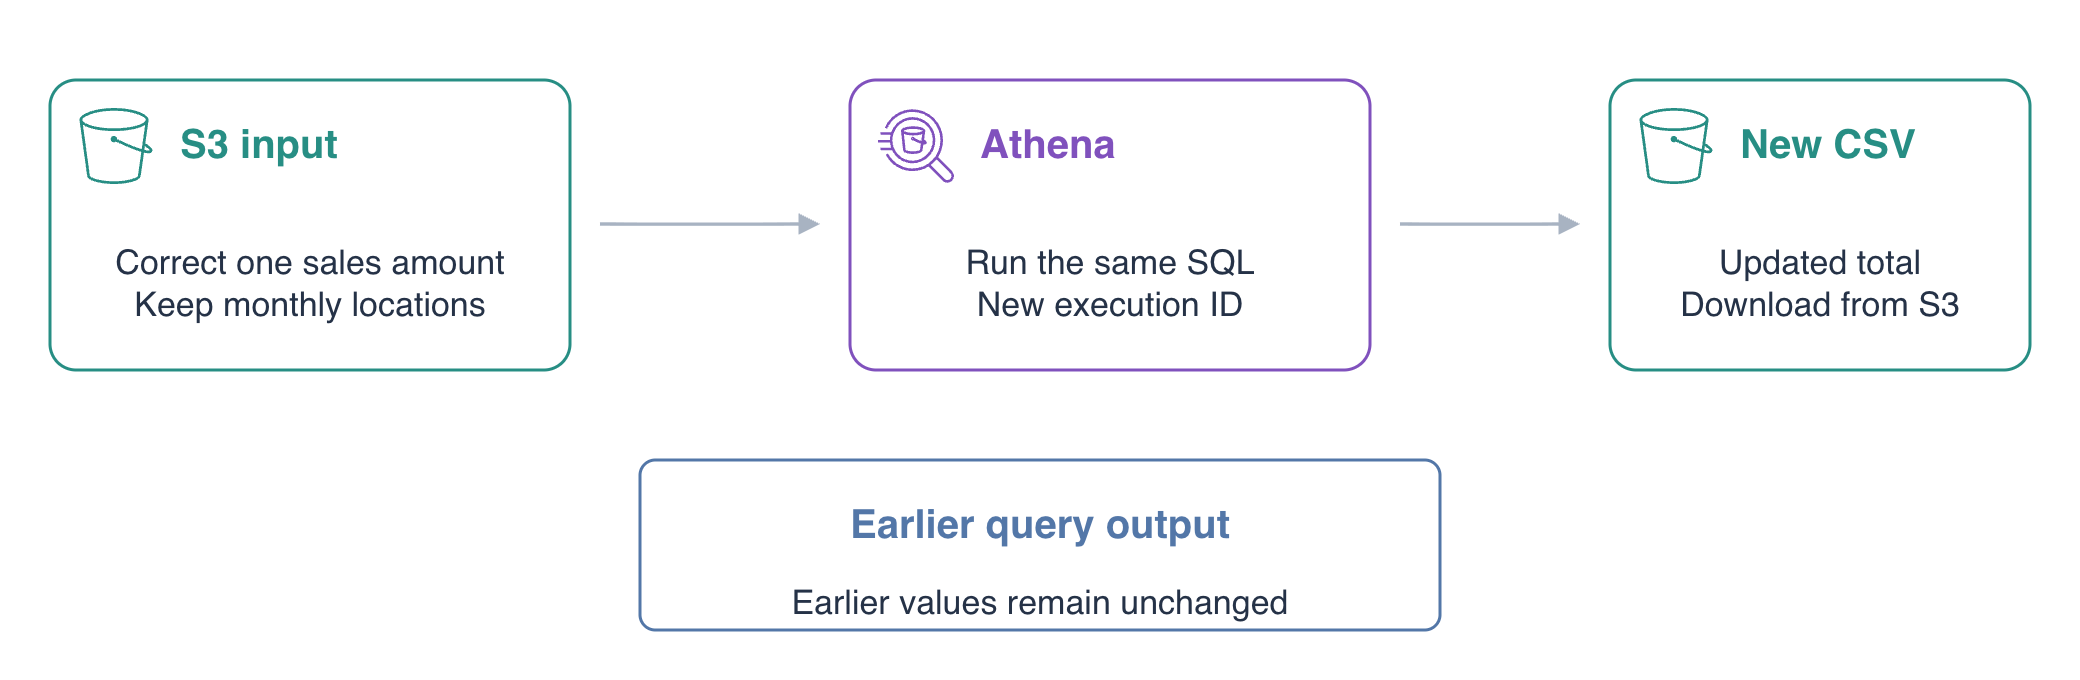
In diesem Schritt korrigierst du einen September-Betrag und führst dieselbe SQL erneut aus. Alte Ergebnisse aktualisieren sich nicht automatisch; eine neue Ausführung muss aktuelle Eingaben lesen.
Prüfe die Korrektur:
cat september-revised.csv
S01 steigt von 1000 auf 1100 Cent, sonst bleibt September gleich: erwartete Summe 3600. Ersetze das bestehende Objekt; bewahre October und reference/notes.txt:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
Lies zur Bestätigung zurück:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
Das letzte - zeigt den Inhalt. Schema und Ort bleiben gleich, also gilt die Glue-Partition weiter. Starte dieselbe SQL neu:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
Bestätige Erfolg, wiederhole wartende Zustände und lies Fehlergründe:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lies die Zeilen:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September ist 3600/3, October bleibt 2000/3. Die Eingabeänderung beeinflusst das Ergebnis.
Hole den eigenen Ausgabeort der neuen Ausführung:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
Lade ohne Überschreiben der alten lokalen Übersicht:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
Prüfe die neue CSV:
cat summary-revised.csv
Vergleiche die alte S3-Ausgabe:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
Sie enthält weiter September=3500. Zwei IDs zeigen auf getrennte Dateien für alte und korrigierte Daten. AWS View zeigt aktuelle Quelle und echte Ergebnisse. Dies prüft Korrektheit, keine Produktionskosten oder Leistung.
Zusammenfassung
Du hast Monatssummen berechnet, die genaue CSV geladen, eine Eingabe korrigiert und neu berechnet. September steigt von 3500 auf 3600 Cent; October bleibt 2000. Frühere Dateien behalten Werte, daher musst du bei Eingabeänderungen erneut abfragen.
Weitere Informationen bietet die AWS-Dokumentation: Ausgabedateien einer Abfrageausführung finden; SELECT-Filter, Gruppierung und Sortierung.