Einführung
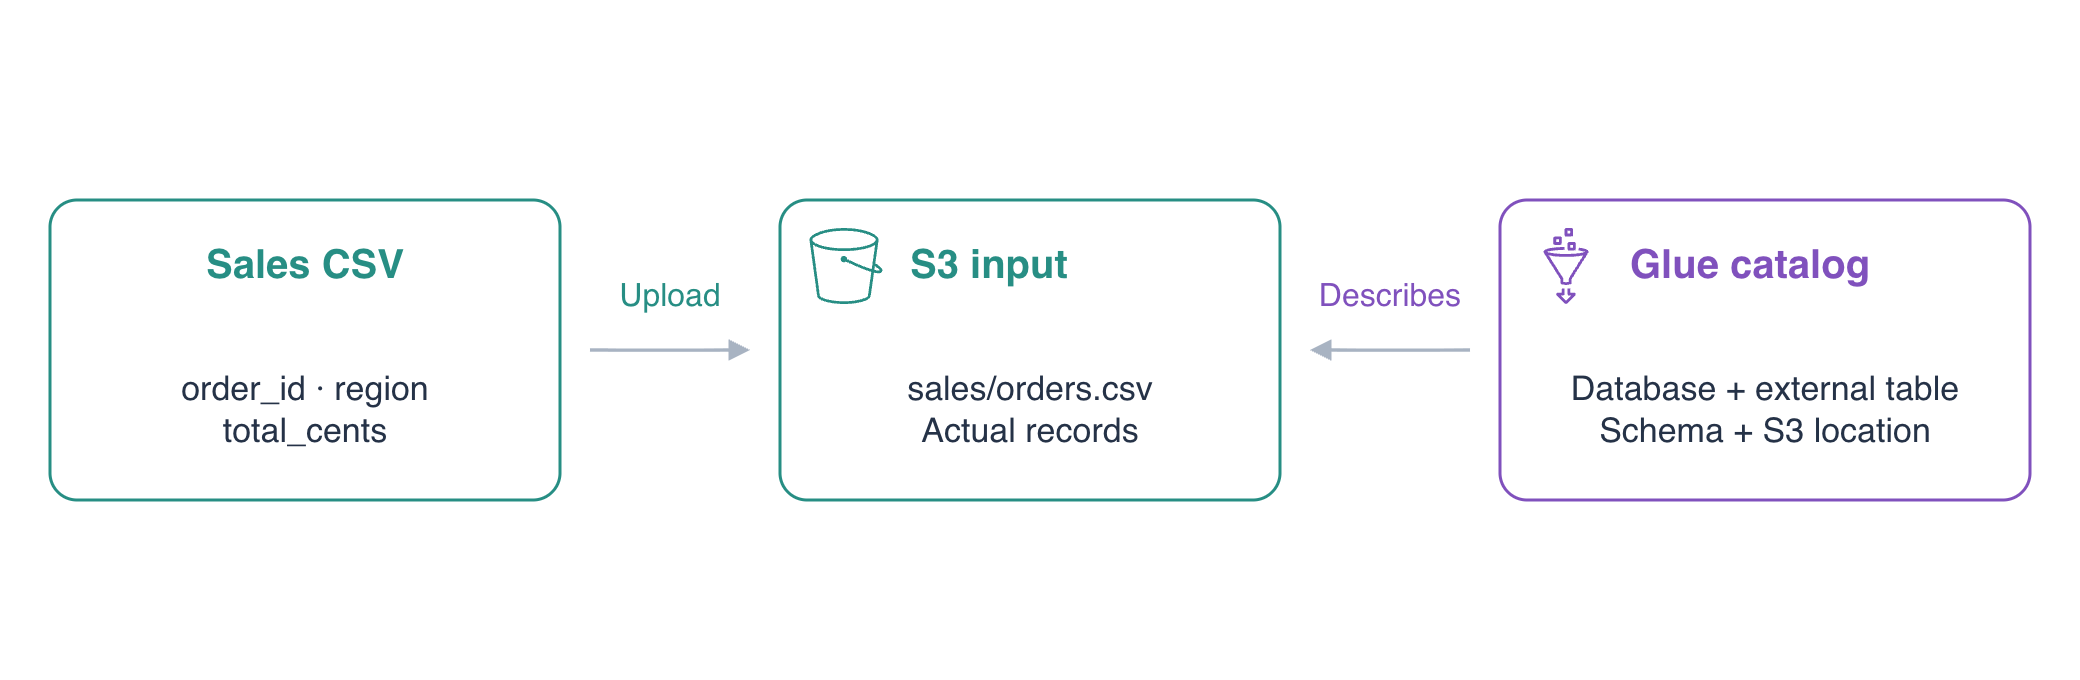
Ein kleiner Laden exportiert Verkäufe als CSV. Ein Analyst möchte die Dateien abfragen, ohne sie auf einen Datenbankserver zu kopieren. Speichere die Datei in Amazon S3 und beschreibe sie im AWS Glue Data Catalog. Dieses Metadatenverzeichnis zeigt Abfragediensten den Speicherort und die Leseregeln.
Absolviere AWS Foundations for Beginners sowie S3-Objektoperationen und IAM-Identitätsgrundlagen. Diese unabhängige Umgebung bietet leere Buckets, CSV-Dateien und eine konfigurierte AWS-CLI-Identität. Du brauchst kein persönliches Konto und keine Ressourcen anderer Labs. Nutze Terminal für Befehle und AWS View für echte Objekte und Katalogeinträge. Der Katalog beschreibt Dateien; er kopiert, transformiert und durchsucht ihren Inhalt nicht. Athena folgt im nächsten Lab.
Zertifizierungsbezug
| Zertifizierung | Prüfungsaufgabe | Praxis |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Die Katalogrolle von Glue bei dateibasierter Analyse von der Datenspeicherung in S3 unterscheiden. |
Verkaufsdatei hochladen
In diesem Schritt prüfst du die bereitgestellten Daten und lädst sie nach S3. Eine CSV enthält einen Datensatz pro Zeile und durch Kommas getrennte Felder. Die erste Zeile nennt die Felder. Ein Schema definiert Namen, Reihenfolge und Typen, damit Abfragen Datensätze richtig interpretieren.
Wechsle ins Projekt und prüfe die konfigurierte Identität:
cd /home/labex/project
aws sts \
  get-caller-identity
Die ARN endet auf labex-an01-operator. Du verwendest die S3- und Glue-Ressourcen dieser Identität. Lies die September-Datei:
cat september.csv
Die drei Verkäufe enthalten order_id, region und total_cents. Die ersten beiden sind Zeichenketten, der Betrag ist eine ganze Zahl in Cent. 1000, 2000 und 500 ergeben 3500. Die Werte stehen ohne Anführungszeichen; es gibt eine Kopfzeile.
Die neue Umgebung besitzt einen eindeutig benannten Eingabe-Bucket. jq -r liest einen JSON-Wert als Text, $(...) speichert die Ausgabe in einer Variablen. Speichere und zeige den Namen:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
Lade nach sales/orders.csv. Das Präfix sales/ gruppiert die Daten für die Tabelle:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
Lies das hochgeladene Objekt direkt zurück:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
Das abschließende - gibt das S3-Objekt im Terminal aus. Kopfzeile und drei Datensätze müssen september.csv entsprechen. Öffne das Objekt in AWS View und vergleiche den Inhalt. Das fremde Objekt reference/notes.txt liegt außerhalb von sales/ und bleibt unverändert.
Katalogdatenbank erstellen
In diesem Schritt erstellst du den Namensraum für die Tabelle. Eine Glue-Datenbank gruppiert Katalogtabellen und speichert Metadaten. Sie betreibt keinen Datenbankserver; ihre Erstellung verschiebt keine S3-Datei.
Lies den Namen aus dem Ressourceninventar:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input nimmt die normale JSON-Definition für Namen und Beschreibung an:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
Bei erfolgreicher Erstellung wird kein Inhalt ausgegeben. Frage die Datenbank ab, um ihre Existenz zu bestätigen:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
Der Name ist labex_sales, die Beschreibung entspricht deiner Eingabe. AWS View zeigt die Datenbank noch ohne Tabelle. Die S3-Datei bleibt am bisherigen Ort.
Datei mit einer externen Tabelle beschreiben
In diesem Schritt ordnest du CSV-Felder benannten Typen zu und verweist auf das echte S3-Präfix. Eine externe Tabelle beschreibt Daten außerhalb des Katalogs. Das Löschen ihrer Definition löscht die S3-Objekte selbst nicht.
Der Speicherdeskriptor enthält Spalten, Speicherort und Lesekonfiguration. Ein SerDe ist ein Serialisierer/Deserialisierer und interpretiert Dateizeilen als Tabellenfelder. LazySimpleSerDe liest hier Werte ohne Anführungszeichen mit Komma als Trennzeichen. Die Kopfzeile ist kein Verkauf; skip.header.line.count überspringt sie.
Speichere und zeige das Tabellenpräfix:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF schreibt den folgenden Text bis zum abschließenden EOF in die Datei. Der nicht zitierte Begrenzer ersetzt $SALES_LOCATION durch dein tatsächliches Präfix:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys ist leer, weil diese erste Tabelle ein unpartitioniertes Präfix liest. Monatspartitionen folgen später. Die beiden Formatklassen beschreiben Texteingabe und gewöhnliche Hive-kompatible Ausgabe; du musst sie nicht selbst installieren oder ausführen.
Erstelle die Tabelle aus JSON. Mit file:// liest die CLI eine lokale Eingabedatei:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Lies die Definition aus Glue zurück:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
Prüfe die Spaltenreihenfolge, int für total_cents, /sales/ am Ende des Speicherorts und den Kopfzeilenwert 1. AWS View zeigt S3-Objekt und Glue-Definition nebeneinander.
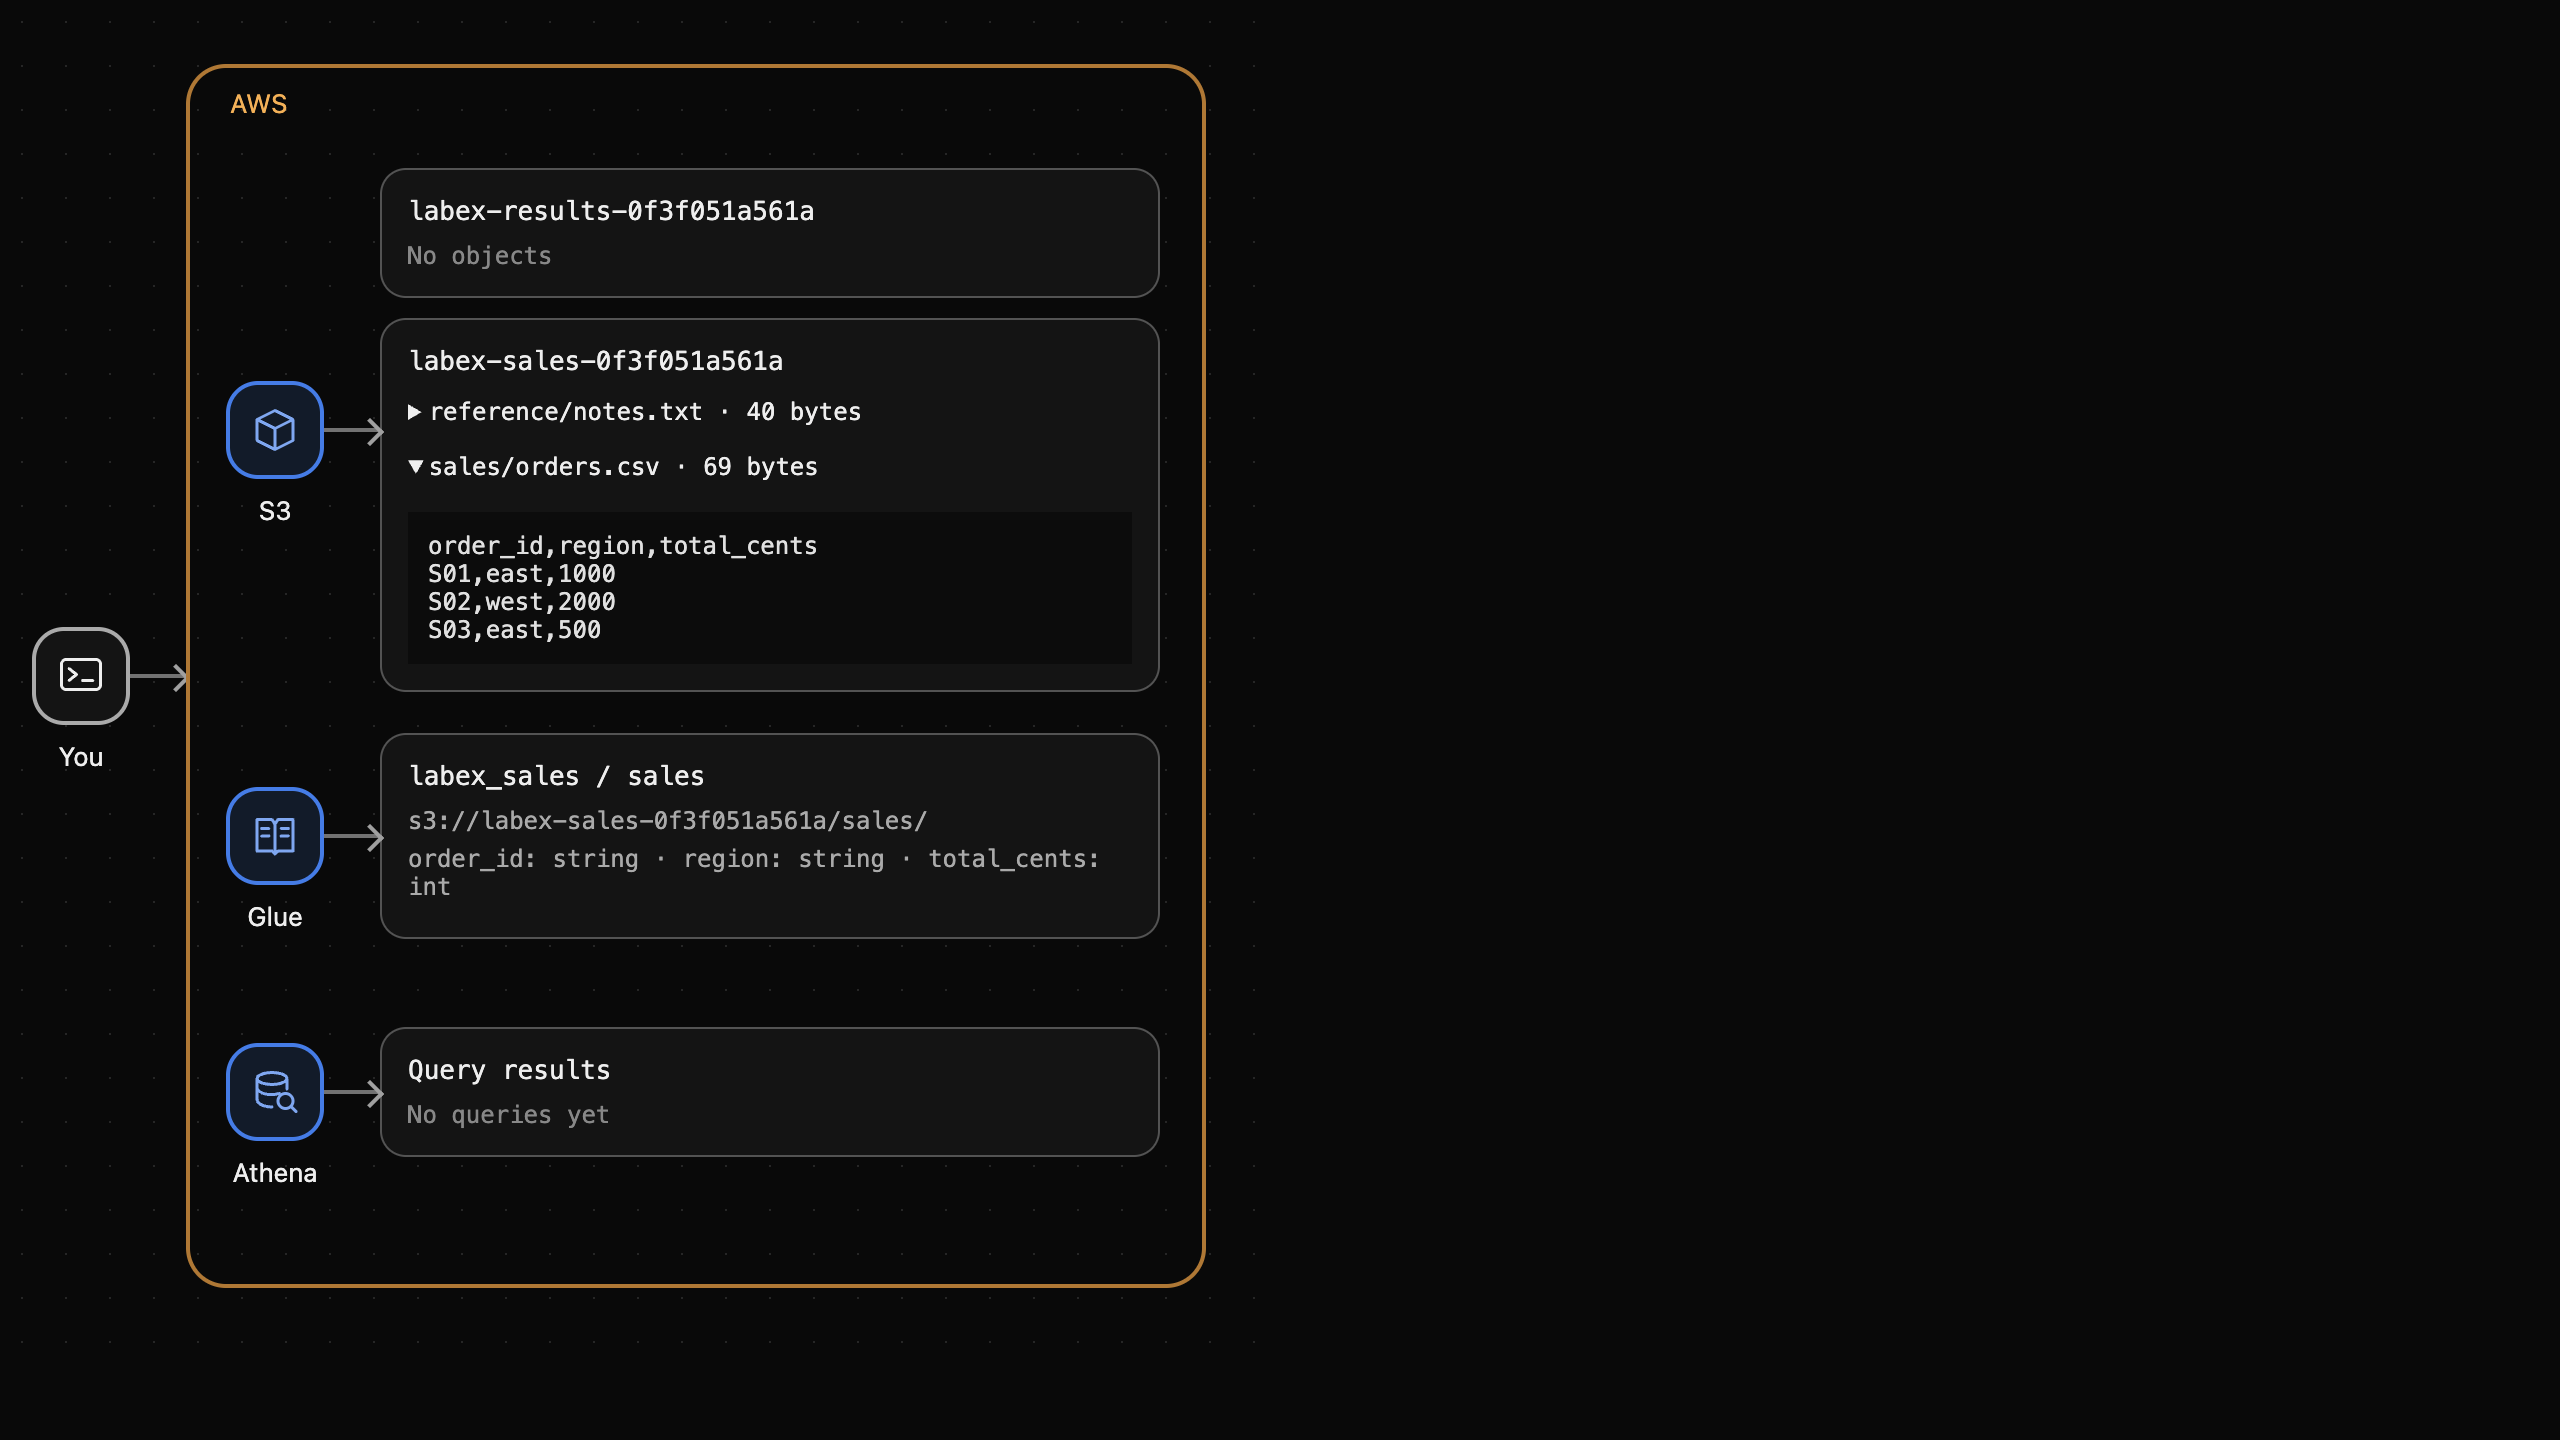
Der Katalog hat weder die CSV verändert noch ein Athena-Ergebnis erzeugt. Ein falsches Schema oder ein falscher Ort lässt spätere Abfragen fehlschlagen oder andere Datensätze lesen. Passende Metadaten schaffen die richtige Grundlage.
Zusammenfassung
Du hast echte Verkaufsdaten in S3 hochgeladen, eine Glue-Datenbank erstellt und eine externe Tabelle mit passenden Spalten, CSV-Format und Speicherort definiert. S3 hält Daten, Glue Metadaten. Das nächste Lab fragt unabhängig vorbereitete Daten mit Athena über dieses Modell ab.
Weitere Informationen bietet die AWS-Dokumentation: Katalogmetadaten manuell definieren; CSV-Felder ohne Anführungszeichen und Kopfzeilenbehandlung.