Einführung
Ein Betriebsteam benötigt ein Fehlersignal, das bei fehlgeschlagenen Anfragen aktiv wird und nach fehlerfreiem Datenverkehr wieder zurückgesetzt wird. Du konfigurierst einen Metrikalarm, beobachtest beide Zustandswechsel anhand tatsächlicher Anfragen, vergleichst null mit fehlenden Daten und entfernst deine Alarme.
Schließe zuerst Den Anwendungszustand mit CloudWatch-Metriken messen ab, einschließlich Metrikdimensionen und Sum. Dieses Lab stellt eine neue Anwendung und neue Metrikreihen bereit.
Bezug zu Zertifizierungen
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Aufgabe 1.1 | CloudWatch-Alarmauswertung, Erholung und fehlende Daten. |
| DevOps Engineer – Professional (DOP-C02) | Aufgabe 4.2 | Grundlagenübung: CloudWatch-Alarmauswertung, Erholung und fehlende Daten. |
| Solutions Architect – Professional (SAP-C02) | Aufgabe 3.1 | Grundlagenübung: CloudWatch-Alarmauswertung, Erholung und fehlende Daten. |
Lab-Überblick
Einen Metrikalarm konfigurieren
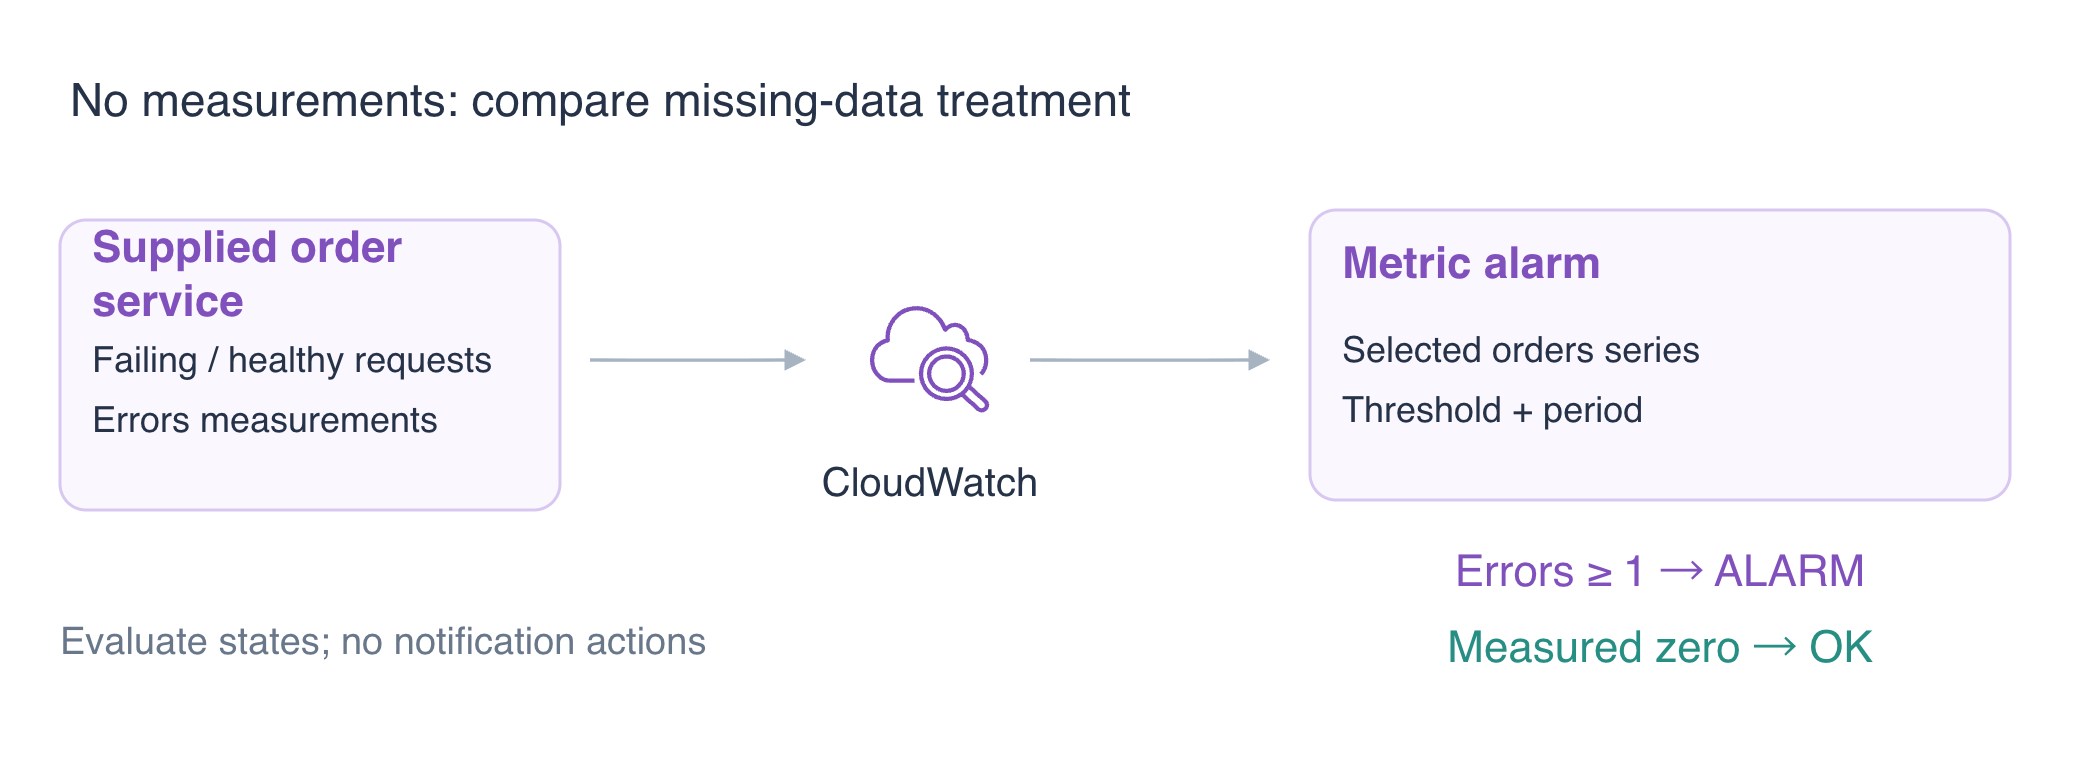
In diesem Schritt überwachst du die Serverfehleranzahl der Anwendung orders. Ein Alarm bewertet eine Metrik anhand eines Schwellenwerts und meldet OK, ALARM oder INSUFFICIENT_DATA. Er sendet keine Benachrichtigung, solange keine Aktion konfiguriert ist; diese Übung konzentriert sich auf die Auswertung.
Die unabhängig vorbereitete Anwendung veröffentlicht echte Anfragemetriken. Ihre Metrik Errors ist bei HTTP 5xx eins und bei einer fehlerfreien Anfrage null. Die hochauflösende Veröffentlichung ermöglicht eine 10-Sekunden-Periode, damit du mehrere Perioden schnell beobachten kannst. Perioden und Schwellenwerte im Produktivbetrieb hängen von Arbeitslast und Kosten ab.
cd /home/labex/project
Erstelle einen Alarm für eine einzelne Metrik. Namespace, Name und Dimensionen wählen die Reihe aus; Sum zählt Fehler in jeder abgeschlossenen Periode.
Der Alarm bewertet eine abgeschlossene 10-Sekunden-Periode (--period 10, --evaluation-periods 1). Ein Sum-Wert von mindestens 1 erreicht den Schwellenwert; GreaterThanOrEqualToThreshold bedeutet „größer als oder gleich“. notBreaching behandelt eine Periode ohne Messungen so, als würde sie den Schwellenwert nicht überschreiten. Dadurch bleiben inaktive Perioden OK, aber der Anwendungszustand wird damit nicht nachgewiesen.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
Lies den Alarm mit dem folgenden Befehl. Falls die Auswertung noch aussteht, warte einige Sekunden und wiederhole diesen Lesebefehl, bis er OK meldet.
Das anfängliche OK wird durch die Behandlung fehlender Daten verursacht, nicht durch eine erfolgreiche Zustandsprüfung. Prüfe die ausgewertete Begründung:
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
Lasse /labex/o03-reference unverändert. Jedes Lab startet unabhängig; vorherige Metrikdaten sind nicht erforderlich.
Den Alarm mit echten Fehlern auslösen
In diesem Schritt erzeugst du tatsächliche fehlgeschlagene Anfragen und wartest auf die automatische Auswertung. Eine abgeschlossene Periode schließt Punkte der aktuellen unvollständigen Periode aus; die HTTP-Antwort und den Alarmzustand zu sehen sind getrennte Beobachtungen.
pear ist im bereitgestellten Dienst nicht verfügbar. Die Schleife sendet neun Anfragen im Abstand von zwei Sekunden, um mehrere 10-Sekunden-Perioden abzudecken. for wiederholt die Befehle; sleep 2 pausiert zwischen den Anfragen. curl ohne -f gibt den Antwortinhalt auch bei HTTP 503 zurück, wodurch der Fehler beobachtbar wird.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lies den ausgewerteten Zustand. Falls er noch nicht ALARM erreicht hat, warte einige Sekunden und wiederhole diesen Befehl. StateReasonData ist als Zeichenkette gespeichertes JSON, daher erscheinen seine Anführungszeichen in der Antwort maskiert; recentDatapoints listet die ausgewerteten Periodensummen auf.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Erwarte ALARM und einen Wert von mindestens 1 in recentDatapoints innerhalb von StateReasonData. Falls die Auswertung noch die frühere Periode zeigt, warte einige Sekunden und wiederhole den Lesebefehl. Der Zustand folgt tatsächlichen Datenpunkten aus Anfragen; setze den Alarmzustand nicht manuell. Der Alarm überwacht nur orders, sodass die Reihe einer anderen Anwendung nicht in diese Auswertung eingeht.
Für das Bestellteam zeigt ALARM, ob im ausgewählten Zeitraum Serverfehler aufgetreten sind. Es erklärt weder die betroffene Anfrage noch den Grund für den fehlenden Bestand. Die HTTP-Antwort belegt den fehlgeschlagenen Geschäftsvorgang, der ausgewertete Datenpunkt den Alarmwechsel und die Anfrageprotokolle liefern Diagnosedetails. Unterscheide diese Beobachtungen, wenn du den nächsten Untersuchungsschritt festlegst.
Erholung und fehlende Daten beobachten
In diesem Schritt unterscheidest du eine echte null von fehlender Telemetrie. Sende fehlerfreie apple-Anfragen, damit abgeschlossene Perioden gemessene Errors=0 enthalten. Durch die Wiederholung über mehrere Perioden hinweg vermeidest du es, das aktuelle unvollständige Intervall mit einer Erholung zu verwechseln.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lies den ausgewerteten Zustand. Falls er noch nicht OK erreicht hat, warte einige Sekunden und wiederhole diesen Befehl.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
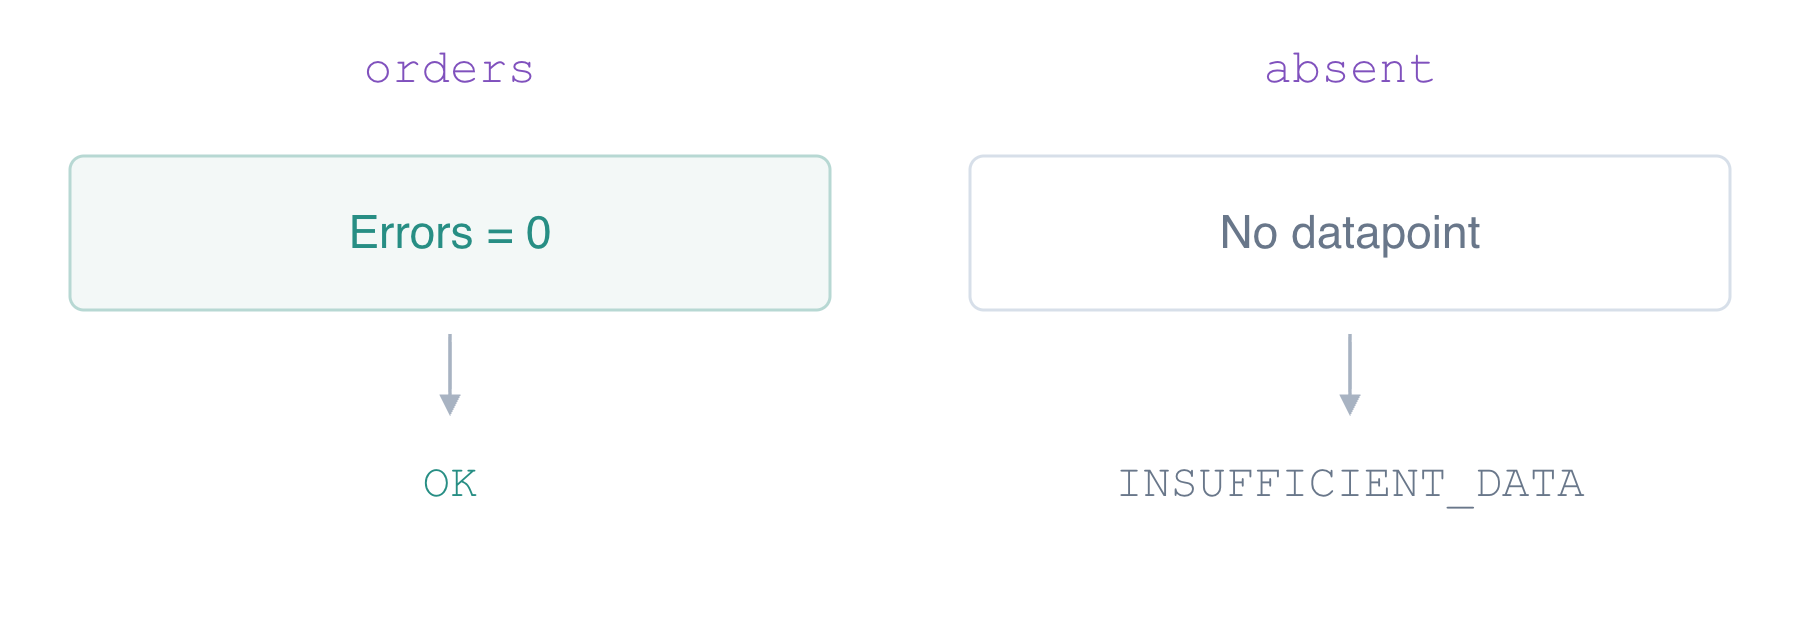
Erwarte OK mit recentDatapoints: [0]. Eine leere Liste bedeutet fehlende Telemetrie; bestätige deshalb die gemessene null, bevor du fortfährst.
Erstelle einen separaten Alarm für Application=absent, eine Reihe, die die Anwendung nie veröffentlicht. Behandle fehlende Daten als fehlend statt als fehlerfrei.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
Der neue Alarm sollte INSUFFICIENT_DATA bleiben, weil seine ausgewählte Reihe keine Messungen enthält.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
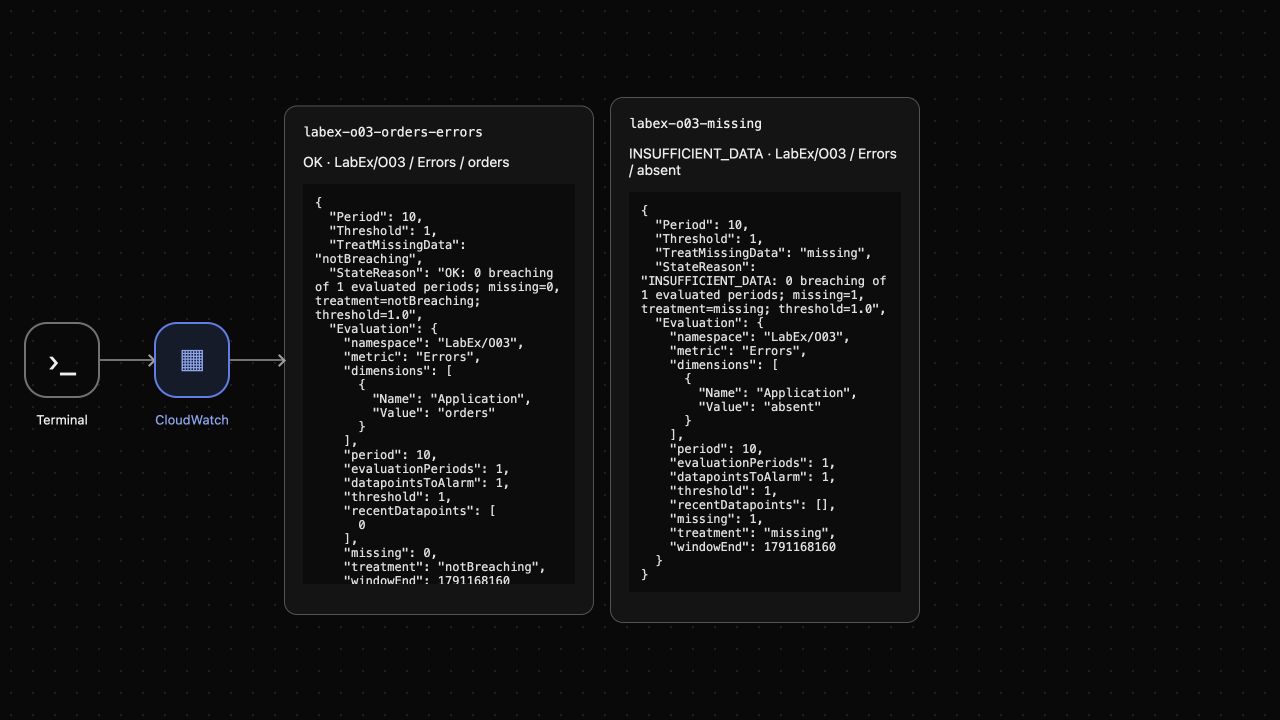
Erwarte für orders OK aufgrund der gemessenen null und für absent INSUFFICIENT_DATA. Verwende die ausgewertete Begründung, um gemessene null von fehlender Telemetrie zu unterscheiden.
AWS View zeigt den tatsächlichen Dienstzustand und die ausgewerteten Datenpunkte. Vergleiche die Begründungen, statt jedes OK als Nachweis eines fehlerfreien Anwendungszustands zu behandeln.
Eigene Alarme entfernen und die Veröffentlichung stoppen
In diesem Schritt entfernst du nur die Alarme dieses Labs und erhältst unbeteiligte Daten. Deaktiviere die Instrumentierung vor der Bereinigung, damit die Anwendung keine neuen Punkte mehr veröffentlicht.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
Erwarte einen leeren Alarmbestand und INFO platform reference keep unchanged. Bestehende Metrikpunkte bleiben erhalten; CloudWatch hat keine explizite API zum Löschen einer einzelnen Metrik. Die Bereinigung durch Autor oder Plattform entfernt anschließend diese temporäre Umgebung.
Zusammenfassung
Du hast einen Fehleralarm konfiguriert, seine automatische Auslösung und Erholung anhand echter Anfragen beobachtet, gemessene null von fehlenden Daten unterschieden und eigene Alarme entfernt, während die Referenz-Logs erhalten geblieben sind.
Weitere Informationen bietet die AWS-Dokumentation: Metrikalarme und Aktionen; Alarmauswertung bei fehlenden Daten.