



Einführung
Ein Befehl zur Dokumentzusammenfassung braucht vorhersehbare Grenzen für seine KI-Abhängigkeit. Du ergänzt die bereitgestellte Anwendung um einen begrenzten Bedrock-Client, lehnst zu lange Eingaben vor der Inferenz ab und behandelst Dienstfehler oder langsame Antworten ohne rohe Exceptions offenzulegen.
Du solltest Python-Grundlagen und die Validierung strukturierter Ausgabe aus dem vorigen Lab kennen. Schnittstelle und Antwortparser sind bereitgestellt, damit du dich auf Anfragegrenzen konzentrierst. Diese neue VM hat eigenes Dokument, konfigurierte Identität und Inferenzkontingent.
Bezug zur Zertifizierung
| Zertifizierung | Prüfungsaufgabe | Übung |
|---|---|---|
| AI Practitioner (AIF-C01) | Aufgaben 3.1, 3.2 | Inferenzausgabe begrenzen und erzeugte Antworten in einer Anwendung behandeln. |
Einen begrenzten Bedrock-Client anbinden
In diesem Schritt implementierst du den Client des bereitgestellten Befehls und erzeugst eine tatsächliche strukturierte Zusammenfassung.
Beginne im Arbeitsverzeichnis:
cd /home/labex/project
Lies Quelldokument und Befehlsoptionen:
cat incident.txt
/opt/labex/aws/venv/bin/python application.py --help
Der Vorfall ist INC-204. application.py liest ein Dokument und gibt JSON aus. Es ruft client.request_summary auf; das bereitgestellte response_parser.py prüft Abschlussgrund und die drei bereits geübten Zeichenkettenfelder. Das anfängliche client.py meldet unvollständige Arbeit und sendet keine Anfrage.
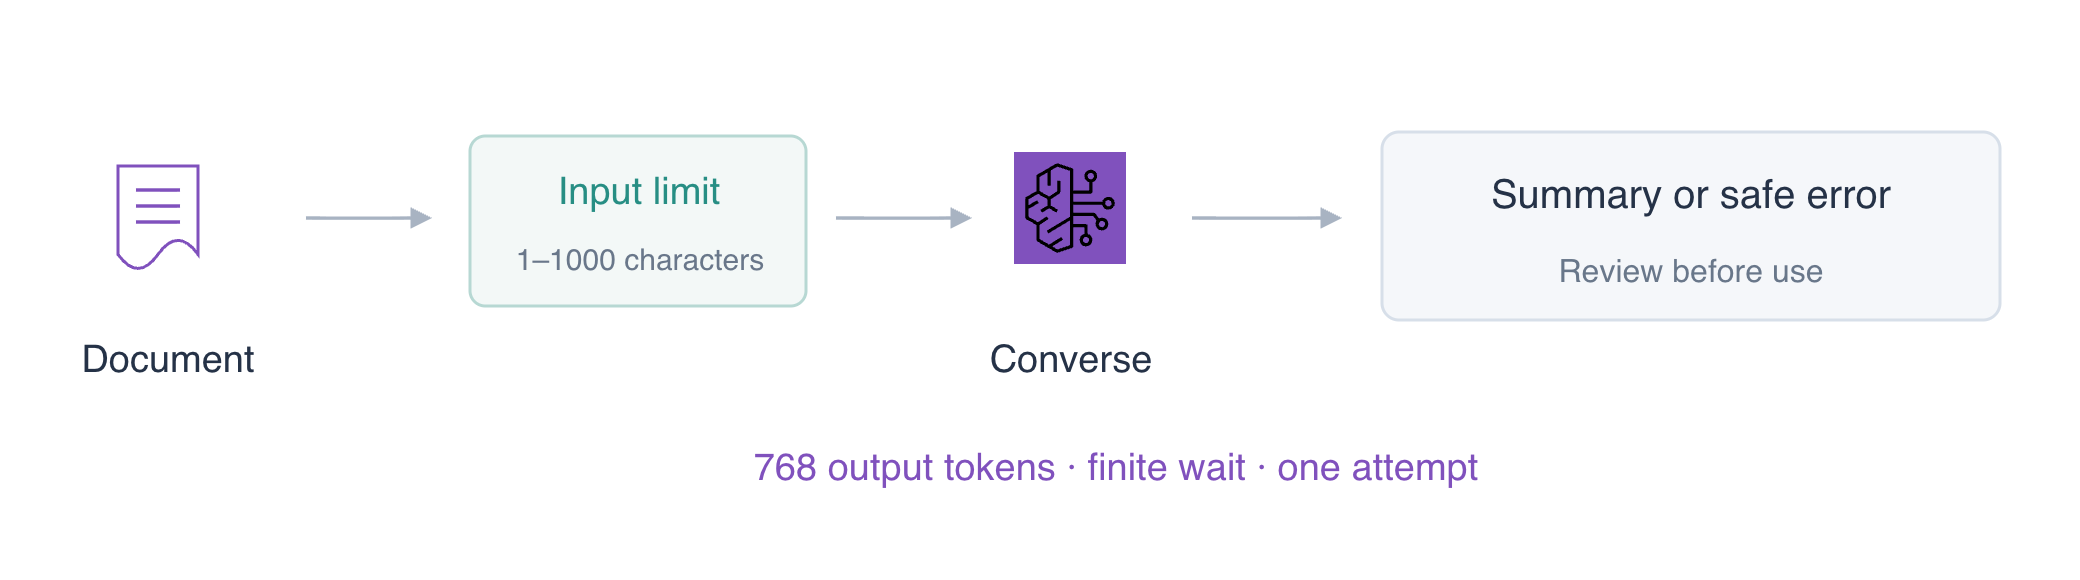
Ein Eingabelimit schützt die Anwendung vor Kontingentverbrauch. Dieses Beispiel akzeptiert 1–1000 nicht leere Zeichen, begrenzt die Ausgabe auf 768 Tokens und setzt explizite Verbindungs- und Lesezeitlimits. total_max_attempts: 1 bedeutet eine erste Anfrage ohne automatische Wiederholung. Das Leselimit begrenzt das Warten auf der Verbindung; es verspricht nicht, dass jede Anwendungsaktion genau zu diesem Zeitpunkt endet.
Ersetze den anfänglichen Client durch diese Implementierung. ClientError bezeichnet eine Dienstfehlerantwort, ReadTimeoutError ein abgelaufenes Lesewarten. Beide werden zu kleinen JSON-Diagnosen. Rohe Exceptions, Anfrageheader und Zugangsdaten erscheinen nie im Ergebnis:
cat > client.py <<'EOF'
import boto3
from botocore.config import Config
from botocore.exceptions import BotoCoreError, ClientError, ReadTimeoutError
from response_parser import summarize_response


def request_summary(document, endpoint_url, read_timeout):
    if not document.strip() or len(document) > 1000:
        return {'status': 'rejected', 'reason': 'input_limit'}
    client = boto3.client('bedrock-runtime', endpoint_url=endpoint_url,
        config=Config(proxies={}, connect_timeout=3, read_timeout=read_timeout,
                      retries={'total_max_attempts': 1}))
    try:
        response = client.converse(
            modelId='labex.text-v1:0',
            system=[{'text': 'Summarize only facts supplied in the incident document. Return exactly one JSON object with string fields incident_id, impact and next_action. No Markdown fences, extra keys or surrounding prose. Do not turn planned work into completed work.'}],
            messages=[{'role': 'user', 'content': [{'text': document}]}],
            inferenceConfig={'maxTokens': 768, 'temperature': 0})
    except ReadTimeoutError:
        return {'status': 'unavailable', 'reason': 'read_timeout'}
    except ClientError as error:
        code = error.response.get('Error', {}).get('Code')
        reason = 'busy' if code == 'ThrottlingException' else 'service_unavailable'
        return {'status': 'unavailable', 'reason': reason}
    except BotoCoreError:
        return {'status': 'unavailable', 'reason': 'connection_failed'}
    return summarize_response(response)
EOF
Führe die Anwendung gegen ihren normal konfigurierten Bedrock-Endpunkt aus. > accepted.json speichert die Ausgabe:
/opt/labex/aws/venv/bin/python application.py > accepted.json
Lies sie:
cat accepted.json
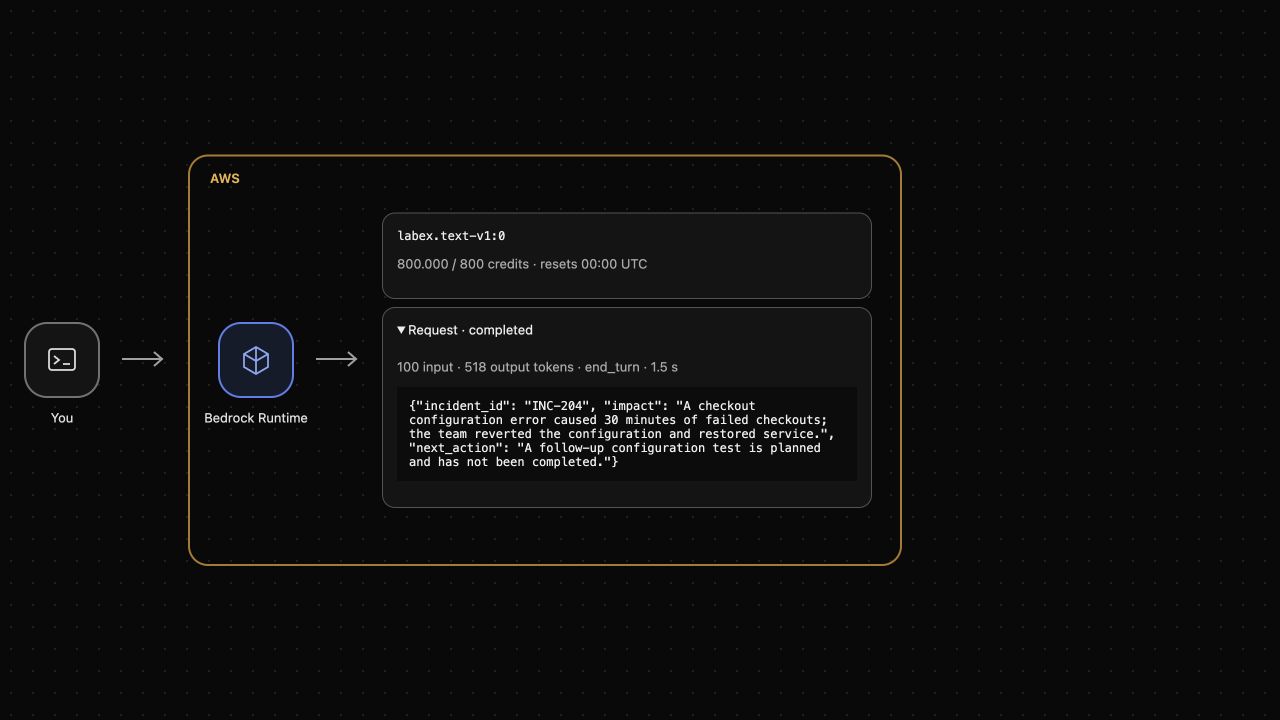
Erwarte status: ok mit den drei Feldern. Vergleiche ihre Bedeutung mit dem Dokument. Klappe die tatsächliche abgeschlossene Anfrage in AWS View auf und vergleiche den Text. Das Ausgabelimit begrenzt erzeugte Tokens; die Zeichengrenze ist eine getrennte Anwendungsregel. Eine Cacheantwort kann tatsächliche Modellausgabe ohne neue Creditbelastung nutzen.
Zu lange Eingaben vor der Inferenz ablehnen
In diesem Schritt bestätigst du die Ablehnung eines Dokuments außerhalb des Eingabebudgets.
Das bereitgestellte oversized.txt enthält mehr als 1000 Zeichen. wc -m zählt Zeichen:
wc -m oversized.txt
Verarbeite die Datei mit derselben Anwendung:
/opt/labex/aws/venv/bin/python application.py --document oversized.txt > too-long.json
Diese beabsichtigte Ablehnung endet mit Exitcode 2. echo $? zeigt den Exitcode des vorigen Befehls:
echo $?
Lies das sichere Ergebnis:
cat too-long.json
Erwarte status: rejected und reason: input_limit. Der Client prüft vor dem Aufbau einer Inferenzanfrage, daher sollte AWS View nur die frühere abgeschlossene Anfrage enthalten. Ablehnung verhindert neuen Modellverbrauch; Löschen einer Ergebnisdatei würde keine frühere Belastung rückgängig machen.
Dienstfehler und Lesezeitüberschreitung behandeln
In diesem Schritt testest du Fehlergrenzen mit zwei ausdrücklich lokalen Transport-Testdiensten.
Die folgenden Endpunkte geben absichtlich Fehler zurück oder verzögern eine Antwort. Sie senden keine Modellanfrage und verbrauchen keine Inferenzcredits. Es sind Testabhängigkeiten, keine alternativen Anbieter erfolgreicher Inferenz.
Nutze den Test für Dienstunverfügbarkeit auf Port 5001:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5001 > unavailable.json
Dieser erwartete Fehler endet mit Exitcode 3. Prüfe die Diagnose:
cat unavailable.json
Erwarte status: unavailable und reason: service_unavailable, ohne Stacktrace, SDK-Exceptiontext oder Zugangsdaten.
Der Testdienst auf Port 5002 wartet drei Sekunden. Setze für diesen Test das Leselimit auf eine Sekunde:
/opt/labex/aws/venv/bin/python application.py --endpoint-url http://127.0.0.1:5002 --read-timeout 1 > timed-out.json
Lies das Ergebnis:
cat timed-out.json
Erwarte status: unavailable und reason: read_timeout. Das SDK sendet einen Versuch. Ein Timeout beweist nicht, dass eine vorgelagerte Modellanfrage abgebrochen oder kostenlos war: Ein tatsächlicher vorgelagerter Dienst kann nach dem Ende der Clientwartezeit fertig werden. Prüfe laufende/fehlgeschlagene Anfragen und Kontingent vor Wiederholung; füge keine bedingungslose Wiederholungsschleife hinzu.
AWS View sollte weiterhin nur die tatsächliche Anfrage aus Schritt 1 enthalten. Das normale Leselimit von 150 Sekunden ist eine endliche Wahl für die Übung; reale Anwendungen wählen Limits, Wiederholungspolitik und Benutzerfeedback nach ihrem Latenzbudget. Die offizielle Config-Referenz erläutert getrennte Verbindungs-/Leselimits und Versuchskontrolle.
Testausgaben entfernen und die funktionierende Anwendung behalten
In diesem Schritt entfernst du vier lokale Ergebnisse und behältst den funktionierenden Client und die bereitgestellte Anwendung.
Funktions- und Fehlertests sollten vor dem Aufräumen bestehen. Entferne nur die benannten Ausgaben:
rm accepted.json too-long.json unavailable.json timed-out.json
Liste verbleibende Dateien auf:
ls
Behalte application.py, client.py, response_parser.py, Dokument und Testfälle. Converse erzeugte keine dauerhafte Cloudarbeitslast; das Löschen lokaler Ausgaben stellt keine Credits wieder her. Der Quellcode bleibt bis zum Ende dieser VM für weitere Übungen verfügbar.
Zusammenfassung
Du hast eine tatsächliche Bedrock-Anfrage angebunden, Eingabe und Ausgabe begrenzt, automatische Wiederholungen deaktiviert und endliche Verbindungs-/Lesezeiten gesetzt. Du hast Dienstfehler und Timeout ohne vorgefertigte erfolgreiche Inferenz getestet, sichere Diagnosen zurückgegeben und nur lokale Testausgaben entfernt.


