はじめに
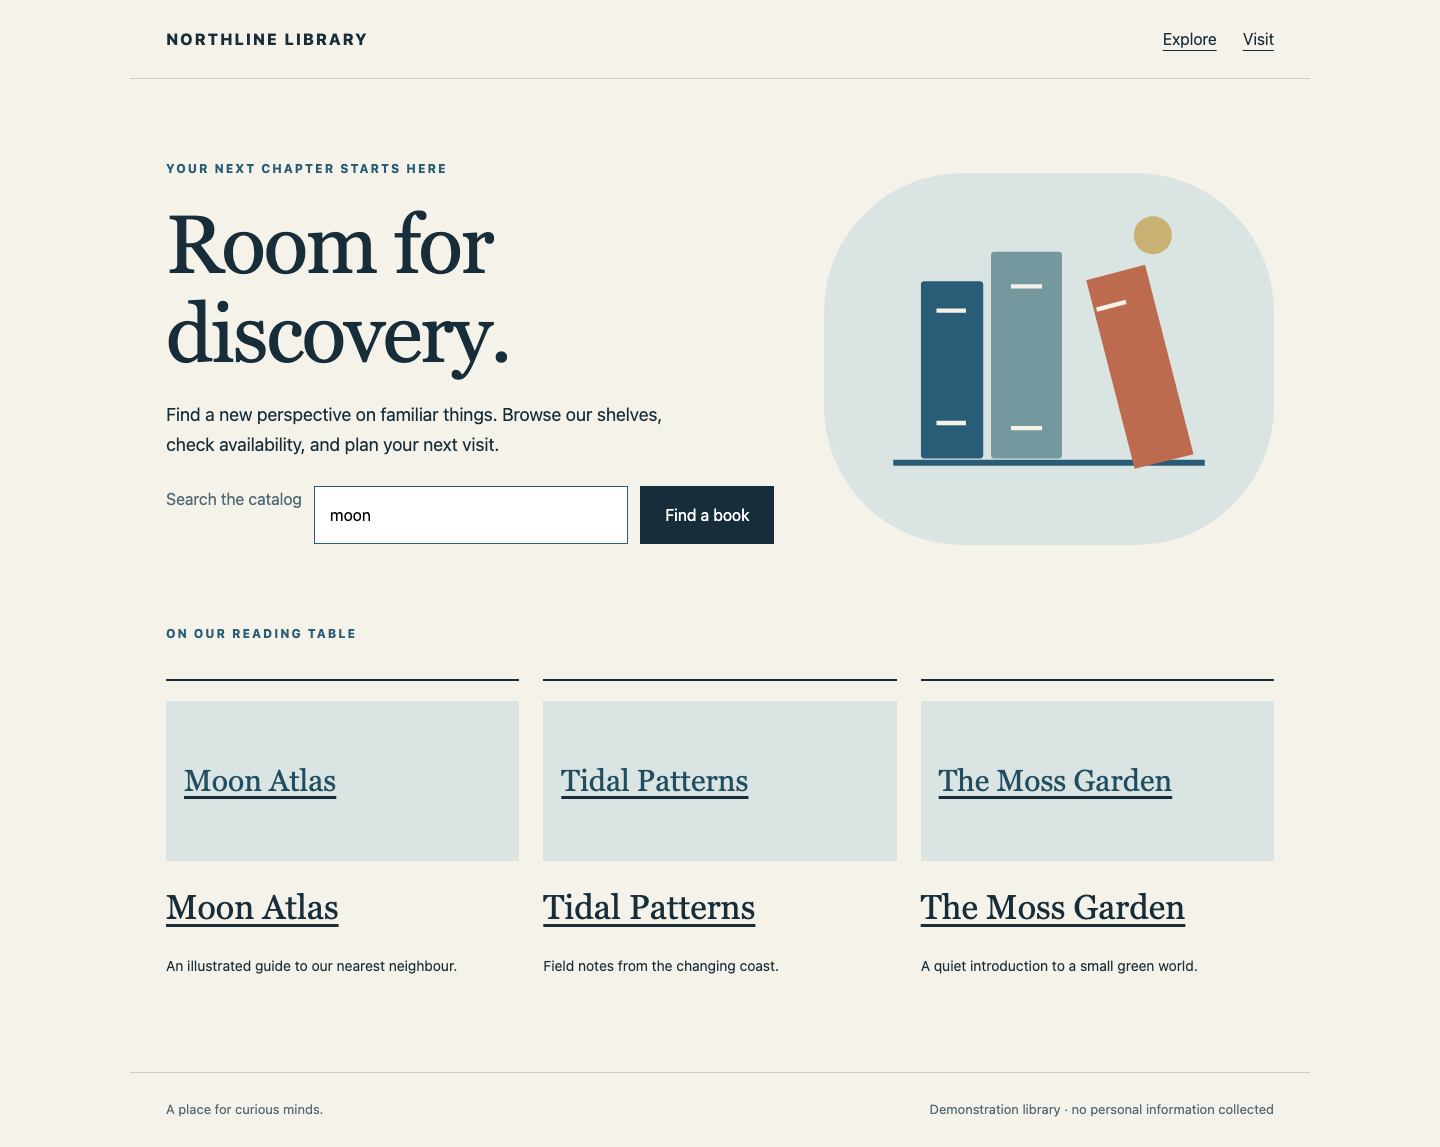
Northline Library では本の発見、貸出可否の確認、予約のプレビューができます。ホームページが正常に見えても、検索できない場合があります。利用者の結果を監視し、障害が継続した場合だけ担当チームに通知するのが今回の仕事です。
基本的なターミナル操作ができれば十分です。図書館、Prometheus(サンプルとルール)、Blackbox Exporter(実際の HTTP プローブ)、Alertmanager(通知配信)、ローカル受信箱は準備済みです。短い YAML 設定を 2 つ編集します。アプリ開発、インストール、メールアカウント、外部への送信は不要です。1 台の実習環境で架空の本と読み取り専用の予約プレビューを使います。
読者の操作は Library、コマンドは Workstation、実際の観測と webhook 受信は Monitoring を使います。サイトと画面ラベルは英語のままです。各単元は独立して開始します。
読者の検索を監視する
このステップでは利用者向けのプローブを選びます。Library から始め、正常な業務を使ってから、読者の実際の要求を検証するプローブを選びます。
読者の経路を試す
Search the catalog の moon を残して Find a book を選びます。検索結果には Moon Atlas、Available、棚の位置が表示されます。Moon Atlas、続いて Check reservation を開くと、読み取り専用のプレビューに Ready to collect: Moon Atlas と表示されます。予約は作成されません。Back to book、NORTHLINE LIBRARY の順に選びます。Visit を開いて開館時間を読み、ブランドリンクで戻ります。
プローブを理解する
Workstation に切り替えます。すでに /home/labex/project/library-watch にいます。パスはファイルやディレクトリを指します。この絶対パスはシステムのルートから始まります。pwd は現在位置、ls は名前の一覧、cat はファイルの内容を表示します。
pwd
ls
cat prometheus.yml
prometheus.yml、alerts.yml、watch.sh があります。設定はプログラムがどう動くかを記述します。YAML では空白による字下げ、key: value の組、リスト項目を表すハイフンを使います。以下の空白を維持してください。エディターは不要です。小さな設定を完全なテキストブロックで置き換えます。
HTTP はブラウザーの要求と応答のプロトコルです。URL にはアドレス、サービスを識別するポート、パスがあります。Workstation で使う 127.0.0.1 はこの実習インスタンスを指します。ポート 8081 は図書館です。/search?q=moon はクエリーパラメーター q を moon とする検索要求です。ターミナルでは URL の引用符を残し、シェルが 1 つの引数として扱うようにします。
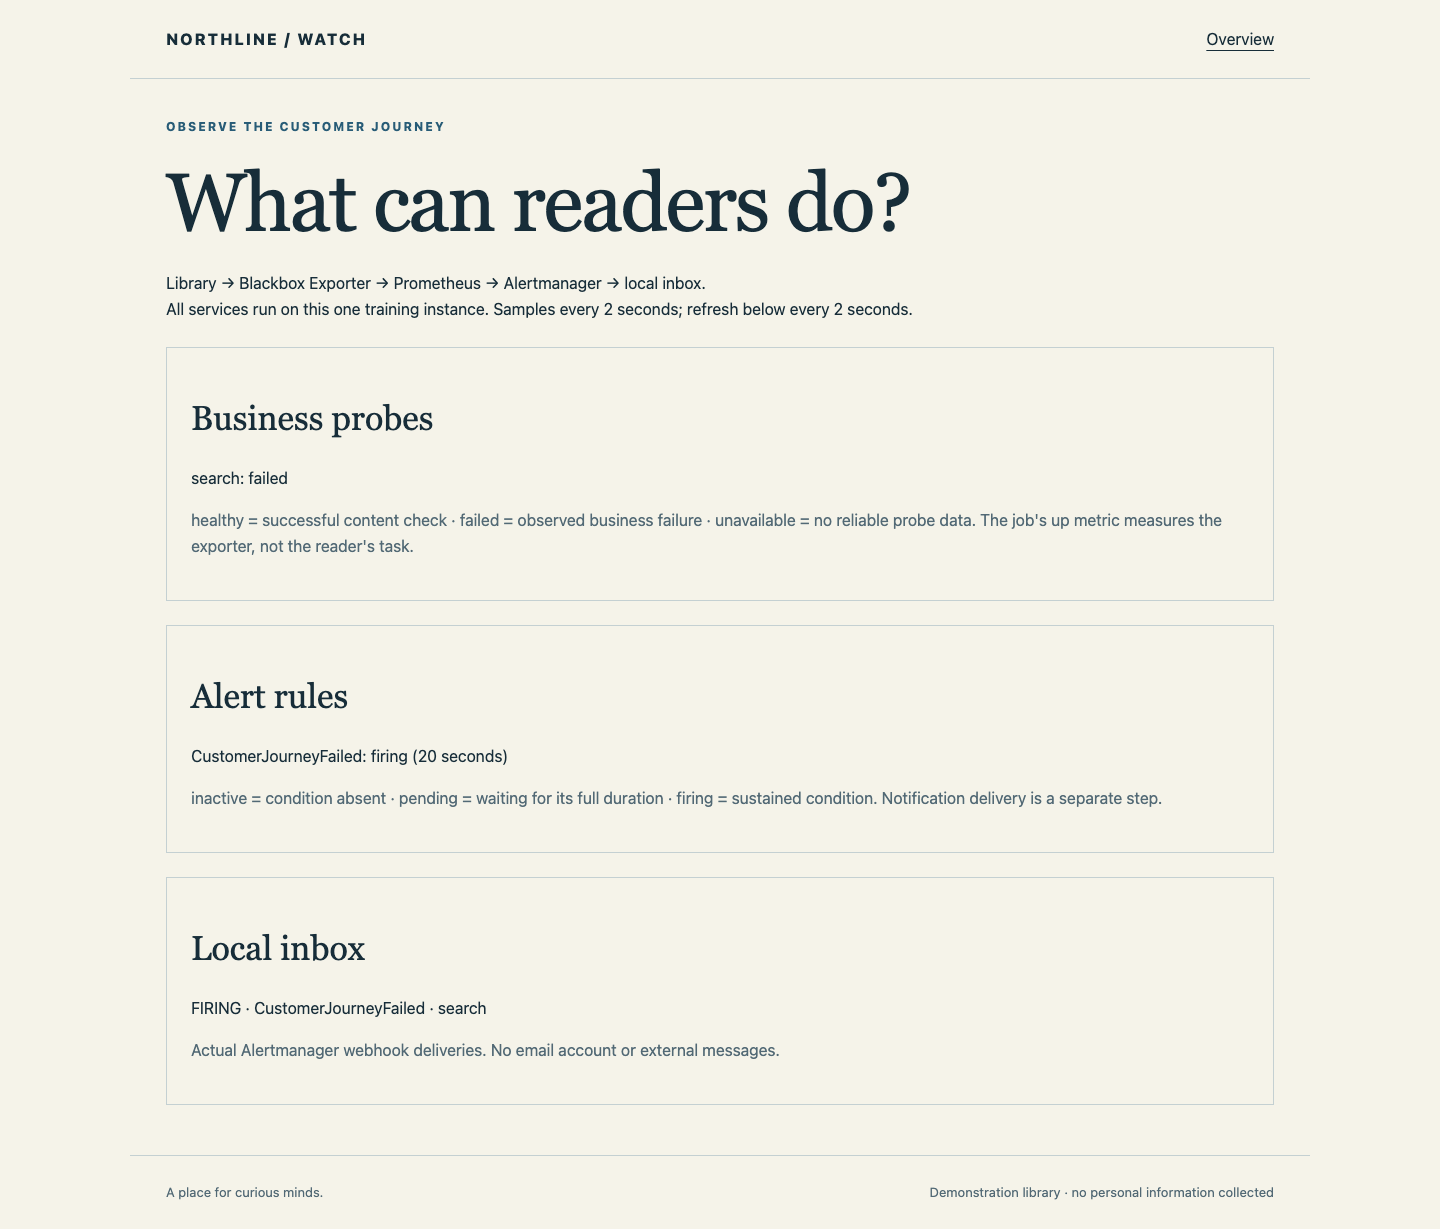
準備済みの library job は現在ホームページだけを調べます。job は名前付きのサンプリング対象グループです。ポート 9115 の exporter は実際の要求を行い、probe_success を返します。成功は 1、失敗は 0 です。search モジュールは HTTP 200 に加えて Moon Atlas と Available の本文を要求します。Prometheus は 2 秒ごとに結果を収集します。別の指標 up は exporter から収集できたかだけを表し、読者の成功は証明しません。
利用者のパスを選ぶ
cat > prometheus.yml はファイルを置き換えます。<<'YAML' は内容をそのまま扱うヒアドキュメントの開始です。最後に単独行で置く YAML まで、ブロック全体を貼り付けます。global は時間間隔、rule_files はルールの場所、alerting は準備済みの配信サービスとの接続です。これらを残して、モジュールと対象を検索経路に変えます。journey: search ラベルが業務の範囲を示します。
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload は付属の補助プログラムを実行し、構文確認後に Prometheus へ再読み込みを要求します。図書館を変更したり観測を偽造したりしません。
bash watch.sh reload
Configuration accepted を確認します。約 4 秒待って Monitoring に切り替えます。Business probes に search: healthy が表示されるはずです。YAML エラーなら Workstation に戻り、完全なブロックで置き換えて再読み込みします。サンプルが unavailable なら待って再試行します。利用不可は健全という意味ではありません。Monitoring 自身を対象にしないでください。
到達できることと成功を比較する
Workstation に切り替えます。fault search seconds 6 は検索だけを実際の 6 秒間失敗させ、その後自動復旧します。アラート状態は設定しません。curl は HTTP 要求を送り、-sS は進捗を隠しつつ接続エラーを表示します。実行します。
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
本文は Search is taking a break. になります。サーバーは意図的に HTTP 200 を返すので、ステータスだけでは業務障害を見逃します。すぐに Monitoring に切り替えます。1 サンプリング間隔内に検索が failed、復旧後に healthy になるはずです。短い時間を見逃したら同じ 6 秒の練習を繰り返します。まだアラートは設定されていません。healthy に戻ってからステップを確認します。
継続する障害だけを通知する
このステップでは、先ほどの短い障害を無視できる待機時間を持つ利用者アラートを設定します。Workstation から始めます。
条件を読む
Prometheus は 2 秒ごとにルールを評価します。probe_success{job="library",journey="search"} == 0 は library job の検索失敗サンプルを選びます。波括弧内はラベルの絞り込みで、== 0 は成功ではなく失敗を選びます。up だけでは読者ではなく収集を監視します。ラベルを省くと無関係なサービスを含む可能性があります。
for: 20s は条件が 20 秒間成立し続ける必要があるという意味です。pending は条件が存在して待機中、firing は必要時間に達した状態、inactive は条件が存在しない状態です。20 秒は練習用の短い設定であり、本番の一般的な推奨値ではありません。プローブデータが欠けると Monitoring は unavailable と表示します。これは健全の証拠でも、業務失敗のサンプルでもありません。
alert はルール名です。severity はルーティング用ラベルで、annotations.summary は利用者への影響を説明します。完全なルールを書きます。
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Configuration accepted を確認します。検証に失敗したら空白や記号を修正して再読み込みします。新しい設定が受理されるまでは、直前の有効な設定が動きます。
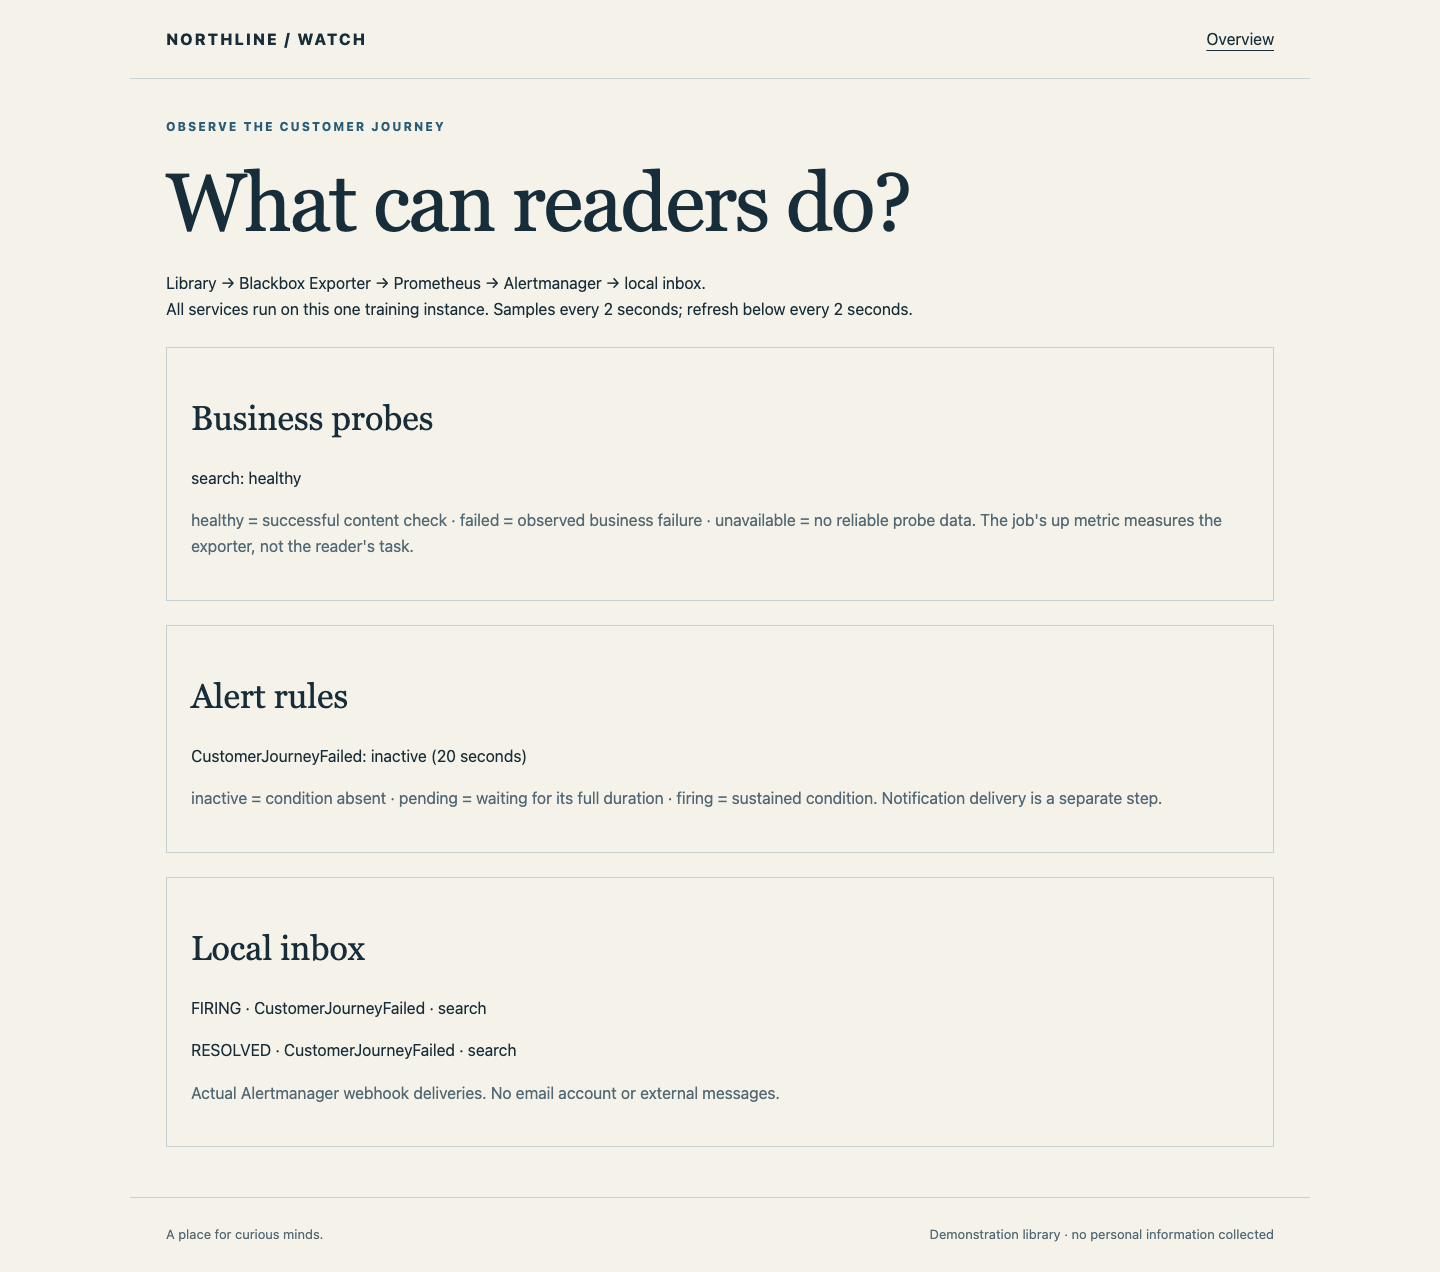
Monitoring に切り替えます。検索が正常なら CustomerJourneyFailed: inactive (20 seconds) と表示され、ローカル受信箱はまだ空のはずです。
短い障害では通知しないことを確かめる
Workstation に切り替えて同じ短い業務障害を繰り返します。
bash watch.sh fault search seconds 6
すぐに Monitoring に切り替えます。検索が失敗し、ルールが短時間 pending になる場合があります。自動復旧後、プローブとルールは healthy/inactive に戻り、受信箱は空のままです。この一巡に約 12 秒待ちます。以前長い障害を実行した場合、古い通知は残ります。証拠を消さず、新しいイベントを比較してください。
firing のルールと通知配信は別の事実です。Alertmanager は firing アラートを受け取り、グループ化し、新しいグループで 1 秒待ってからローカル webhook 受信箱に配信します。収集、評価、配信はそれぞれ少し遅延します。即座に届かないという理由だけで for を削除したり全しきい値を下げたりしないでください。
障害と復旧の通知を受け取る
このステップでは継続障害を起こし、実際の通知配信を観察します。Workstation から始めます。
継続障害を観察する
次の障害は実際に 60 秒続くため、各状態を見る時間があります。検索だけが失敗し、ホームページは動き続けます。
bash watch.sh fault search seconds 60
Library に切り替え、ブランドリンクでホームへ戻ります。正常に見えます。もう一度 moon を検索すると、エラーが読者によるカタログ利用の失敗を示します。Monitoring に切り替えます。検索は failed、ルールは最初 pending です。最初の失敗サンプルから約 20 秒で firing となり、その後受信箱に FIRING · CustomerJourneyFailed · search が追加されるはずです。障害開始から収集、評価、配信まで最大 35 秒待ちます。これは実際の観測であり、進捗アニメーションではありません。
35 秒後も受信箱が空なら、Workstation に切り替え、読み取り専用の状態コマンドを使います。
bash watch.sh status
checks と alerts を見ます。unavailable は収集不足、pending は待機時間未達、firing で受信箱イベントがない場合は配信に注目します。設定を読み直し、修正したら再読み込みします。60 秒の障害が終了したら再実行できます。偽の受信メッセージを作ったり監視を止めたりしないでください。
復旧し、解除を確認する
Workstation に切り替えます。ゼロ秒は自動終了前でも検索を直ちに復旧します。
bash watch.sh fault search seconds 0
Library に切り替え、ホームから moon を再検索します。Moon Atlas と Available が戻る必要があります。本と予約プレビューをもう一度開き、Visit も利用できることを確認します。
Monitoring に切り替えます。約 10 秒以内に検索は healthy、アラートは inactive となり、受信箱に RESOLVED · CustomerJourneyFailed · search が追加されます。元の firing 通知は残ります。resolved は今回の障害が解消したという意味で、今後の無障害を保証しません。
このステップは実際に届いた firing/resolved の組と現在利用可能な図書館を検査します。さらに読み込まれたルールを、正常、短い障害、継続障害、復旧、データ欠落、無関係な障害の隔離サンプルで検査します。採点は障害を注入せず、サービスを復旧せず、設定を変えません。図書館を正常に保ち、将来の障害を検知できるルールを残してください。
まとめ
実際の利用者の検索と本文検証プローブを選び、ラベルでアラート範囲を絞り、短い障害を無視して、本当の障害と復旧 webhook を受信しました。exporter の可用性と業務の可用性、データ欠落と成功を区別しました。独立チャレンジでは予約確認に応用し、無関係な障害サービスを除外します。