はじめに
ワークショップに割り当てられた人の比較では、B の登録率のほうが高くなっています。ページが誰の結果も変えなくても、ランダムな割り当てだけで群が異なるように見えるのでしょうか。実際のランダムな差の分布を生成する前に、小さな手作業の交換でこの問いを具体化します。
この独立した環境には、前に学んだ正しい個人結果と率の比較の関数、および独自の元データが用意されています。これらの考え方、Python 関数、基本的な NumPy 配列と Matplotlib を前提とします。前の VM のファイルや統計的推論の知識は不要です。399 回の探索的な再割り当てと実際のグラフを保存します。ここでは p 値の計算も勝者の選択もしません。すべての記録は教材独自の合成例です。55 分は、読解と一般的な誤りの修正を含む著者の見積もりです。
群の人数を変えずに人を交換する
このステップでは、6 人の差を計算し、2 人の群への所属を交換して、比較が変わる理由を確認します。
WebIDE で Terminal → New Terminal を開き、この単元のディレクトリに移動します。
cd /home/labex/project/signup-experiment
cat はファイルを変更せずに読みます。練習用カードと用意された 2 つの関数を読み直してください。
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
6 枚のカードの二値結果は、A で [1, 0, 0]、B で [1, 1, 0] です。各 1 または 0 は割り当てられた 1 人のものです。イベントの繰り返しは追加の観測ではありません。A の登録者は 1/3、B は 2/3 で、B−A は約 +33.33 パーセントポイントです。
A の 2 人目(結果 0)と B の 1 人目(結果 1)の群への所属を交換すると考えてください。A は [1, 1, 0]、B は [0, 1, 0] となり、差は約 −33.33 パーセントポイントになります。各群は依然として 3 人で、正の結果も合計 3 人のままです。変えたのは割り当てであり、個人の結果や標本サイズではありません。
差の関数を書きます。np.mean は NumPy 配列の二値の平均を求めます。B の平均から A の平均を引き、100 を掛けるとパーセントポイントになります。sample_null の骨組みは後で完成させます。関数を定義しただけでは実行されません。
シェルの > はファイルを置き換えます。引用符付きヒアドキュメント <<'PY' は、最後の PY までのブロック全体をシェル展開せずにコピーします。WebIDE の File → Save で同じ内容を保存してもかまいません。
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
実行プログラムの contrast ステージは、元のカードと、説明したとおりの交換を渡し、関数を 2 回呼んで実際の両方の結果を保存します。
python3 run.py contrast
表示プログラムは結果を作り直さず、保存されたものを表示します。
python3 show_results.py contrast
original_pp は +33.33 付近、swapped_pp は −33.33 付近になるはずです。どちらも、実在の人が別のページでどうなるかを予測していません。同じ 6 人の結果を固定したままでも、群の構成によって比較が変わることを示しています。
resample.py、その後の plot.py を編集でき、通常の Python 補助ファイルを同じ場所に追加できます。元の CSV、設定、辞書、実行プログラム、表示プログラムは保持します。ディレクトリが違う場合は pwd と ls で確認し、上の cd を繰り返してください。編集ミスはブロック全体を再コピーして直します。セットアップは既存の作業ディレクトリを上書きしません。
実際の再割り当てを生成する
このステップでは、全訪問者の結果を元の人数の群に繰り返し振り分け直し、得られた差をすべて保存します。
同じ WebIDE ターミナルの /home/labex/project/signup-experiment で続けます。固定された完全な標本は、各群 6 人、合計 12 人の割り当て済みの人です。用意された結果関数は完全な 7 日間の時間枠を使います。境界の人やイベントのない人を再確認したければ、実際の入力全体を読んでください。
cat assignments.csv
cat events.csv
この演習の効果がないという帰無仮定では、どのページに割り当てられたかによって、誰の二値結果も変わりません。そのため、固定した個人結果を 2 群間で再割り当てすると、割り当てだけによって期待される変動が分かります。この仮定は、合成記録が表すランダム化実験の設計に基づきます。任意の観察的なウェブサイトログを混ぜても、ランダム化実験にはなりません。
np.concatenate([a, b]) は 2 つの配列をまとめます。np.random.default_rng(seed) は再現可能な初期状態を持つ擬似乱数生成器を作ります。その permutation メソッドは、まとめた元の配列を変更せず、シャッフルしたコピーを返します。スライス shuffled[:len(a)] は先頭の A の人数分を、shuffled[len(a):] は残りの B の人数分を取ります。1 回の抽出で各人を 1 回使い、両群の人数を保ちます。人が重複する生のイベント行を混ぜてはいけません。
ファイルを 2 つの完全な関数で置き換えます。for ループは要求された回数だけ抽出し、append は計算した差を毎回保持します。配列を返すことで、平均だけや都合のよい 1 回ではなく、標本全体を保存できます。
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
実行プログラムは完全な個人単位の標本で関数を呼び出し、実際の群人数、観測差、399 個のシャッフルされた差を保存します。--seed は再現可能な初期状態を渡すもので、2 つのハイフンは名前付きのコマンドオプションを示します。
python3 run.py sample --seed 17
python3 show_results.py sample
完全なデータでは、依然として A は 6 人中 1 人、B は 6 人中 5 人が登録し、観測差は約 +66.67 パーセントポイントです。null_count は 399 でなければなりません。表示を短くするため、表示プログラムは最初の 8 回だけを null_preview として示します。完全な配列は output/sample.json に保存されています。
シードが唯一の正解ではない理由を理解するため、もう 1 つの通常の標本を生成します。
python3 run.py sample --seed 42
python3 show_results.py sample
これにより、保存された標本は実際のシード 42 の実行結果に置き換わります。通常は並びが変わりますが、元の個人結果、群の人数、観測された比較は変わりません。同じシードで再実行すると同じ数列が再現されなければなりません。非負で再現可能な、どのシードも、同等の独立抽出の実装も認められます。著者と同じ数列は要求しません。ページに有利に見える標本を探して何度も実行してはいけません。後の厳密な分析は、最も見栄えのよい探索的標本ではなく、すべての割り当てを使います。
シャッフル後の統計量はすべて −100 から +100 パーセントポイントの範囲ですが、その間の全数値が実現可能とは限りません。6 人の練習例では、3 人対 3 人の異なる 20 通りの割り当てにより、差 −100, −100/3, +100/3, +100 での度数は 1, 9, 9, 1 です。完全な 12 人の標本には 924 通りの割り当てがあり、−100, −200/3, −100/3, 0, +100/3, +200/3, +100 での度数は 1, 36, 225, 400, 225, 36, 1 です。次のラボでは、これらの暗記を求めず、厳密な計算を行います。
この探索的な練習課題では、各実現可能な差の標本頻度と厳密な参照頻度との差を、割合の絶対差で最大 0.15 まで認めます。例えば 0.40 と 0.46 の差は 0.06 です。これは意図的に広くした練習の受け入れ許容幅であり、信頼区間、有意水準、事業の保証、シード選びの基準ではありません。配列の完全一致を求めず、通常の標本や独立した方法を認めるためのものです。すべてが 0 の正当な例では、再割り当てした差もすべて 0 です。0 より大きいばらつきは必須ではありません。
関数の契約は、渡された二値配列と、同じ範囲内のコースの変種に適用されます。各群は少なくとも 2 人、合計は最大 14 人です。チェックは別の群人数、負や 0 の差、退化した結果を含む隔離された入力とシードを使います。既存の標本を置き換えることはありません。抽出標本からの p 値は要求も採点もしません。
保存した割り当ての差を描く
このステップでは、各差の実際の抽出度数を表示し、変わらない観測差の位置を示します。
同じ WebIDE ターミナルの /home/labex/project/signup-experiment で続けます。np.unique(..., return_counts=True) は、保存された異なる差と出現回数を返します。これは離散的な度数のグラフです。縦軸は 399 回の再割り当てのうち各差が何回生じたかを示します。効果の信頼区間ではありません。
描画関数は保存した結果と出力先を受け取ります。読みやすくするため、PNG は少なくとも 500 × 250 ピクセルにします。figsize=(9, 4.5) は図の大きさをインチで指定します。DPI(dots per inch、1 インチ当たりの点数)は保存するラスタ画像の解像度を決めます。1 インチ当たり 140 ピクセルなら、約 9 × 140 対 4.5 × 140、つまり 1260 × 630 ピクセルになります。Matplotlib の subplots は図と座標軸を作ります。bar は度数を描き、axvline は観測差を別の割り当て度数として扱わずに示します。ラベルと見える凡例でその印を識別します。横軸を −110 から +110 に固定すると、この有限標本に極端な値がなくても、二値の率の差として可能な全範囲を表示できます。縦軸は 0 から始めます。tight_layout はラベルの場所を確保し、その後 savefig が実際の PNG を書き込みます。
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
既存の保存された標本を読み、関数で描きます。
python3 run.py plot-sample
WebIDE のファイルエクスプローラーで signup-experiment/output を展開し、sample.png を開きます。両方の軸ラベルを読んでください。度数の多くは差 0 付近に集まり、赤い観測マークは約 +66.67 パーセントポイントに残るはずです。標本にない値の度数は 0 であり、人を省いたことを意味しません。399 回すべての抽出と元の 12 人すべてが、保存データに含まれています。
次の参照画像は、直前に実行した NumPy のシード 42 の例です。別の許可された抽出法やシードでは棒の高さが変わることがあります。保存ファイルには、自分の実際の抽出結果を表示してください。
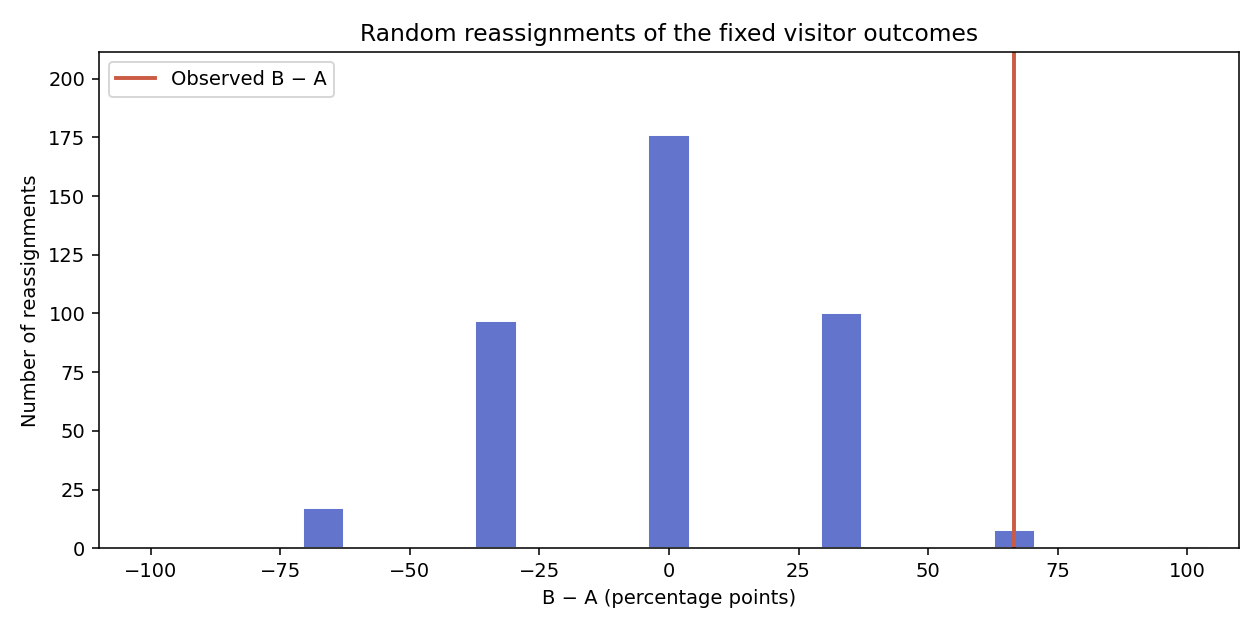
保存した PNG は、現在の描画関数と保存した標本から再現できなければなりません。実際の差の値で読みやすい棒、度数の線、点を使えます。観測差には、Observed とラベルを付けた見える線または点を置きます。可能な差の全範囲と観測マークを表示軸内に置き、度数の基準を 0 に保ち、両軸にラベルを付けてください。印を隠す、データを切り取る、無関係な画像をコピーする、密度を度数と表示する、といったものは課題の達成になりません。
PNG がなければ、まず python3 show_results.py sample で保存された標本を読めることを確かめ、その後描画コマンドを再実行します。表示プログラム自体は欠けたファイルを生成しません。次のラボでは厳密な割り当て分布を観測結果と比較し、その証拠が何を言え、何を言えないかを学びます。
まとめ
2 人の群への所属を手作業で交換し、人数を固定した 399 回の実際の再割り当てを生成して、保存された差と観測された比較を描きました。再現可能なシードは実行を繰り返せるようにするもので、答えや勝つページを選びません。次のラボの厳密な証拠を読むための直感が身に付きました。