はじめに
探索的な再割り当てのグラフは、固定した個人結果から異なる群比較が生じる様子を示します。このラボではさらに、小さな固定標本の異なる割り当てをすべて数え、両側 p 値を正確に定義し、データが何を支持するかを記録します。
この独立した環境には、正しい個人結果と比較の関数が用意されています。これまでのラボで扱った個人の時間枠、パーセントポイントの差、群人数を固定した再割り当てに加え、Python、NumPy、Matplotlib の基礎を前提とします。以前の VM のファイルや p 値の予備知識は不要です。教材独自の合成データは実際の事業実験ではなく、大きな観測差や小さな p 値も本番の結果を保証しません。55 分は、読解と一般的な誤りの修正を含む著者の見積もりです。
異なる割り当てをすべて数える
このステップでは、有限回のランダム抽出を完全な割り当て分布に置き換え、明示的に定義された両側 p 値を計算します。
WebIDE で Terminal → New Terminal を開き、作業ディレクトリに移動します。
cd /home/labex/project/signup-experiment
検定結果を見る前に、元データの定義と設定を読みます。
cat data-dictionary.md
cat config.json
分析は、追跡がすべて終了した 1 つの固定標本と、各人の 1 つの二値登録結果を使います。後の解釈では、すでに選んだ alpha = 0.05 を使います。アルファはこの演習の慣例的な比較閾値であり、ページが機能する確率が 95% という意味ではありません。有利な結果を探した後で選んだものでもありません。比較を見てから、データ、分析時刻、閾値、集団を変更してはいけません。
この演習のページの効果がないという帰無仮定では、どのページを割り当てられても各人の結果は変わりません。表現されているランダム化設計の下で、両群の人数を保ち、この固定結果を振り分け直せます。この推論は、任意の非ランダムな観察ログに自動的に適用できるものではありません。
厳密な割り当て分布は、人を 2 群に分ける異なる方法をすべて含みます。平均に基づく統計量では、群内の順番を変えても別の割り当てにはなりません。Python の math.comb(n, k) は n 人から k 人を選ぶ方法の数を求めます。ここでは 12 人から A の 6 人を選べば、B の 6 人も決まります。
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
この実験には 924 通り、コースで与えるどの例にも最大 3432 通りの割り当てがあります。意図的に小さくした規模なので全列挙が実用的です。任意の大きな本番標本を列挙できると約束する方法ではありません。
B−A のパーセントポイント差について、このコースは SciPy の厳密な two-sided 規約を使います。
まず、厳密な割り当ての差が観測差以下である割合を求めます。別に、観測差以上である割合を求めます。両者の小さい方を 2 倍し、最大 1 に制限します。
等しい値は、それぞれ両方の裾に含みます。これは定義を定めた両側 p 値であり、両側の定義は普遍的に 1 つではありません。非対称な離散分布では、abs(null) >= abs(observed) を数える方法と常に同等ではありません。例えば、登録 0 人の 2 人の A 群と、登録 2 人の 5 人の B 群では、観測差は +40 ポイントです。21 通りの割り当てで、−100 が 1 回、−30 が 10 回、+40 が 10 回現れます。定義した p 値は 2 * 10 / 21 = 20/21 であり、絶対値による裾の割合なら 11/21 です。小さい数を得るために群分けや定義を黙って変更してはいけません。
用意された SciPy の permutation_test インターフェースを使います。permutation_type="independent" は、独立な群の間で観測を振り分け直し、人数を保ちます。訪問者を対応のある測定として扱いません。vectorized=False は、統計量の関数に通常の 1 次元配列を渡す指定です。n_resamples=np.inf は、399 回のランダム抽出ではなく、有限な分布全体を要求します。alternative="two-sided" は上の規約を選びます。この厳密な列挙に乱数シードは不要です。
DataFrame の選択 .loc[mask, "signed_up"] は該当する人のその列を選び、.to_numpy() は値を 1 次元 NumPy 配列にします。内部の statistic 関数は前のラボと同じ差の式を使い、ここで完全に定義します。そのため、別の VM の resample.py に依存しません。
result.statistic、result.pvalue、result.null_distribution は実際の計算結果です。丸めていない値を保持してください。.tolist() は、異なる割り当てから生じる差の重複を除かず、配列を JSON 互換のリストに変換します。
シェルの > はファイルを置き換えます。引用符付きヒアドキュメント <<'PY' は、最後の PY までのブロック全体をシェル展開せずにコピーします。代わりに WebIDE で編集し、File → Save を使ってもかまいません。
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
実行プログラムの distribution ステージは分析を呼び、まだ解釈関数を要求せずに実際の結果を保存します。
python3 run.py distribution
表示プログラムは既存のデータを表示し、長い配列を省くのはターミナル上の表示だけです。
python3 show_results.py exact
12 人、A の 6 人中 1 人と B の 6 人中 5 人の登録、約 +66.67 ポイントの観測差、null_count 924、p 約 0.08009 を確認します。分布全体は output/analysis.json に残っています。解釈のフィールドは次のステップで追加します。
inference.py と plot.py を編集でき、通常の Python 補助ファイルを同じ場所に追加できます。元の CSV、設定、辞書、実行プログラム、表示プログラムは保持します。用意された outcomes.py と compare.py は前に学んだ関数です。公開された DataFrame/オブジェクトの契約と有効な結果を維持する同等の実装も認めます。隔離されたチェックは、範囲内の別の群人数、逆方向、差 0、すべて 0 の結果を扱います。固定の p 値や固定の分布は再利用可能な分析ではありません。
通常のパスやファイル名の誤りには pwd と ls を使い、最初の cd を繰り返してから完全なブロックを再コピーします。セットアップは編集の復旧用ではなく、既存の作業場所を意図的に上書きしません。
証拠と確実性を区別する
このステップでは、いずれの方向も、証拠不足も報告できる、透明な解釈規則を追加します。
同じ WebIDE ターミナルの /home/labex/project/signup-experiment で続けます。p 値は、選んだ帰無仮定と割り当て設計の下での比較を表します。帰無仮定が正しい確率ではなく、ページの効果がない確率でも、次のワークショップの保証でもありません。
ここでは約 +66.67 ポイントの観測差は大きく見えますが、厳密な p 値は約 0.08009 です。この小さな固定標本と事前に選んだアルファ 0.05 では、演習は証拠が不十分と報告します。ページが同一だと証明したわけではありません。この検定と標本は、帰無仮定に反する証拠について選んだ水準に達しないという意味です。
次の明示的な出力ラベルを使います。
- p <= alpha で差が正なら
evidence_for_b。 - p <= alpha で差が負なら
evidence_for_a。 - 差が 0 の場合を含め、それ以外は
inconclusive。
閾値と等しい場合は証拠を示す分岐に入ります。p == alpha は <= を満たします。比較前に p を丸めてはいけません。これらは限定された分析のラベルであり、自動的な事業上の導入判断ではありません。別の有効な実験では A を支持したり、どちらも支持しなかったりします。B に有利なラベルは必須ではありません。
シェルの >> は、既存のファイルを置き換えずに追記します。次の完全なブロックは analyze の下に conclude を追加します。1 回だけ貼り付けてください。WebIDE で編集する場合は末尾に関数を加えて保存します。Python の and は、分岐がラベルを返すために両方の条件を要求します。
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
解釈ステージを通じて厳密な分析を再実行します。これにより、結果ファイルをラベルも含む完全な現在の分析で意図的に置き換えます。
python3 run.py exact
python3 show_results.py exact
この完全な標本の結果は inconclusive です。観測差、丸めていない p 値、924 個の割り当ての差は変わりません。望みのラベルを得るために人を除外したり、日付を選んだり、実際の群を変更したり、探索的なランダム標本に置き換えたりしてはいけません。必要な 7 日間の追跡はすべて終了しています。停止規則の変更やデータの追加はこの演習の範囲外です。
厳密な証拠を読みやすく保存する
このステップでは、保存した割り当て分布全体を描き、文脈を隠さずに観測された比較を示します。
同じ WebIDE ターミナルの /home/labex/project/signup-experiment で続けます。このグラフは result["analysis"] の厳密な分布を使い、別の単元の探索的標本は使いません。np.unique(..., return_counts=True) は各差を生む異なる割り当ての数を数えます。現在のデータでは高さの合計が 924 になります。繰り返す値には意味があり、元の分布から重複を除いてはいけません。
厳密な分布の裾には、度数が割り当て 1 通りだけの値もあります。見える点マーカーにより、その小さな度数も 0 の基準線の上で読めます。接続線は離散的な点を目で追う補助であり、間のすべての差が実現可能という意味ではありません。
横座標は B−A のパーセントポイント差、縦座標は割り当ての度数です。見える Observed マークは実際の比較の位置を示します。タイトルの丸めた p 値は表示上の便宜にすぎず、保存する数値と解釈には丸めていない値を使います。正当な 0 や端の値も含め、可能な差の全範囲と度数 0 の基準線を見えるままにします。
少なくとも 500 × 250 ピクセルの PNG を保存します。前のラボと同様、9 × 4.5 インチの図を DPI 140 で保存すると約 1260 × 630 ピクセルになります。軸や小さな度数のマーカーを読みやすく配置できる解像度です。
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
実際に保存した分析から PNG を生成します。
python3 run.py plot-exact
WebIDE のファイルエクスプローラーで signup-experiment/output を展開し、evidence.png を開きます。0 の周りの分布と +66.67 付近の観測マークを見てください。横で表示プログラムを使い output/analysis.json を読みます。12 人、割り当て人数の 2 つの分母、元の差、厳密な p、アルファ、inconclusive のラベルが一緒に分析の証拠となります。グラフだけでは、分析が正しい証明にはなりません。
以下は、この guided のデータと付属の描画コードから実際に保存されたグラフです。点は両側の裾の小さな割り当て度数を含み、線は実現可能な差をつなぐだけです。保存された数値結果と一緒に読んでください。
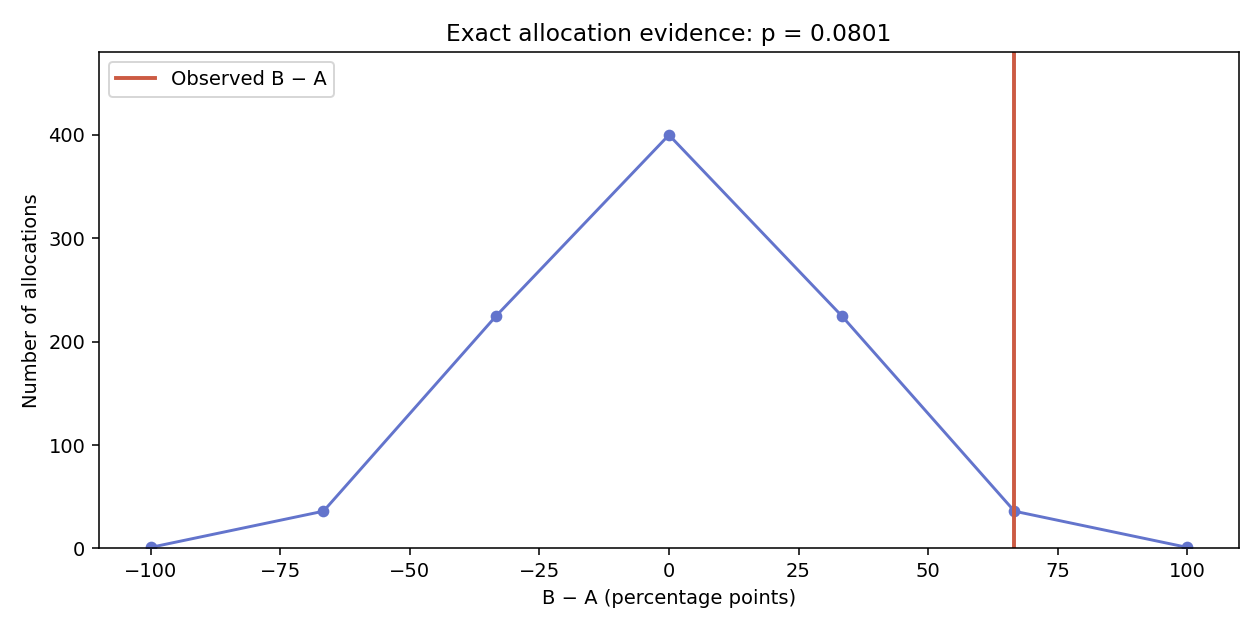
実際の差の値に、読みやすい棒、度数の線、点を使えます。観測された比較には、Observed とラベルを付けた見える線または点が必要で、両軸には意味のあるラベルが必要です。可能な値全体、観測マーク、0 の基準線を表示します。PNG は実際に保存したデータと現在の描画関数から読み取り、再現できなければなりません。見えない線、軸外の印、切り取られた図、無関係な画像は合格しません。PNG がなければ、まず python3 show_results.py exact で保存済みの厳密な結果を確認し、描画コマンドを再実行します。表示プログラムは修復しません。
1 つの仮定と規約を明示して、合成ランダム化実験の 1 標本を分析しました。実際の事業の結果を測定したわけでも、ページが同一と証明したわけでも、観測された効果が本番で続くと確定したわけでもありません。
まとめ
範囲を限定した厳密な分布を列挙し、等号を含む両裾で定義した両側 p 値を使い、事前に選んだ閾値を丸めずに適用して、実際のグラフを保存しました。小標本では大きな差でも証拠が不十分なことがあります。証拠不足はページの同一性を証明しません。次の独立したチャレンジでは、同じ流れを別の割り当てとイベント履歴に適用します。