はじめに
Commonlight の編集担当者は、まず小さな 1 ページのサンプルから、実用的な写真カタログを作ろうとしています。実際の HTTP リクエストで JSON を取得し、フィールドに基づいてレコードを選び、CSV に保存します。Commonlight は独自に制作したローカルのデモ API です。レコードとクレジットは架空で、サンプル画像は合成イラストです。記録写真でも、外部の写真サービスのコンテンツでもありません。
Python の関数、リストや辞書などのコンテナ型、ループ、例外、基本的なファイル出力を理解していることが前提です。HTTP、URL、JSON、CSV はここで説明します。WebIDE で Terminal → New Terminal を選択してください(狭い画面では Terminal メニューが More 内にある場合があります)。すべてのターミナルコマンドをそこで実行します。準備済みのサイトには Web 8080 を使います。編集するのは client.py と storage.py だけです。標準ライブラリと、この 2 ファイル内に定義する補助関数を使い、追加の補助モジュールやリソースは使わないでください。CSV はワークスペース内の実際の通常ファイルとして提出し、シンボリックリンクにしないでください。catalog.py と /opt/commonlight は変更しません。読解と練習の 40 分は著者の見積もりで、初心者による実測時間ではありません。
カタログの 1 ページを取得して理解する
このステップでは、API の 3 レコードを画面の 3 枚のカードと対応させてから、リクエスト関数を実装します。Web 8080 に切り替えてください。Harbor walks のプレビューには Morning, market、Blue hour、Window light があります。コレクション全体ではなく 1 ページの表示だと明記されています。画像は背景を伝えるためのもので、このコースでは画像をダウンロードせず、メタデータをエクスポートします。
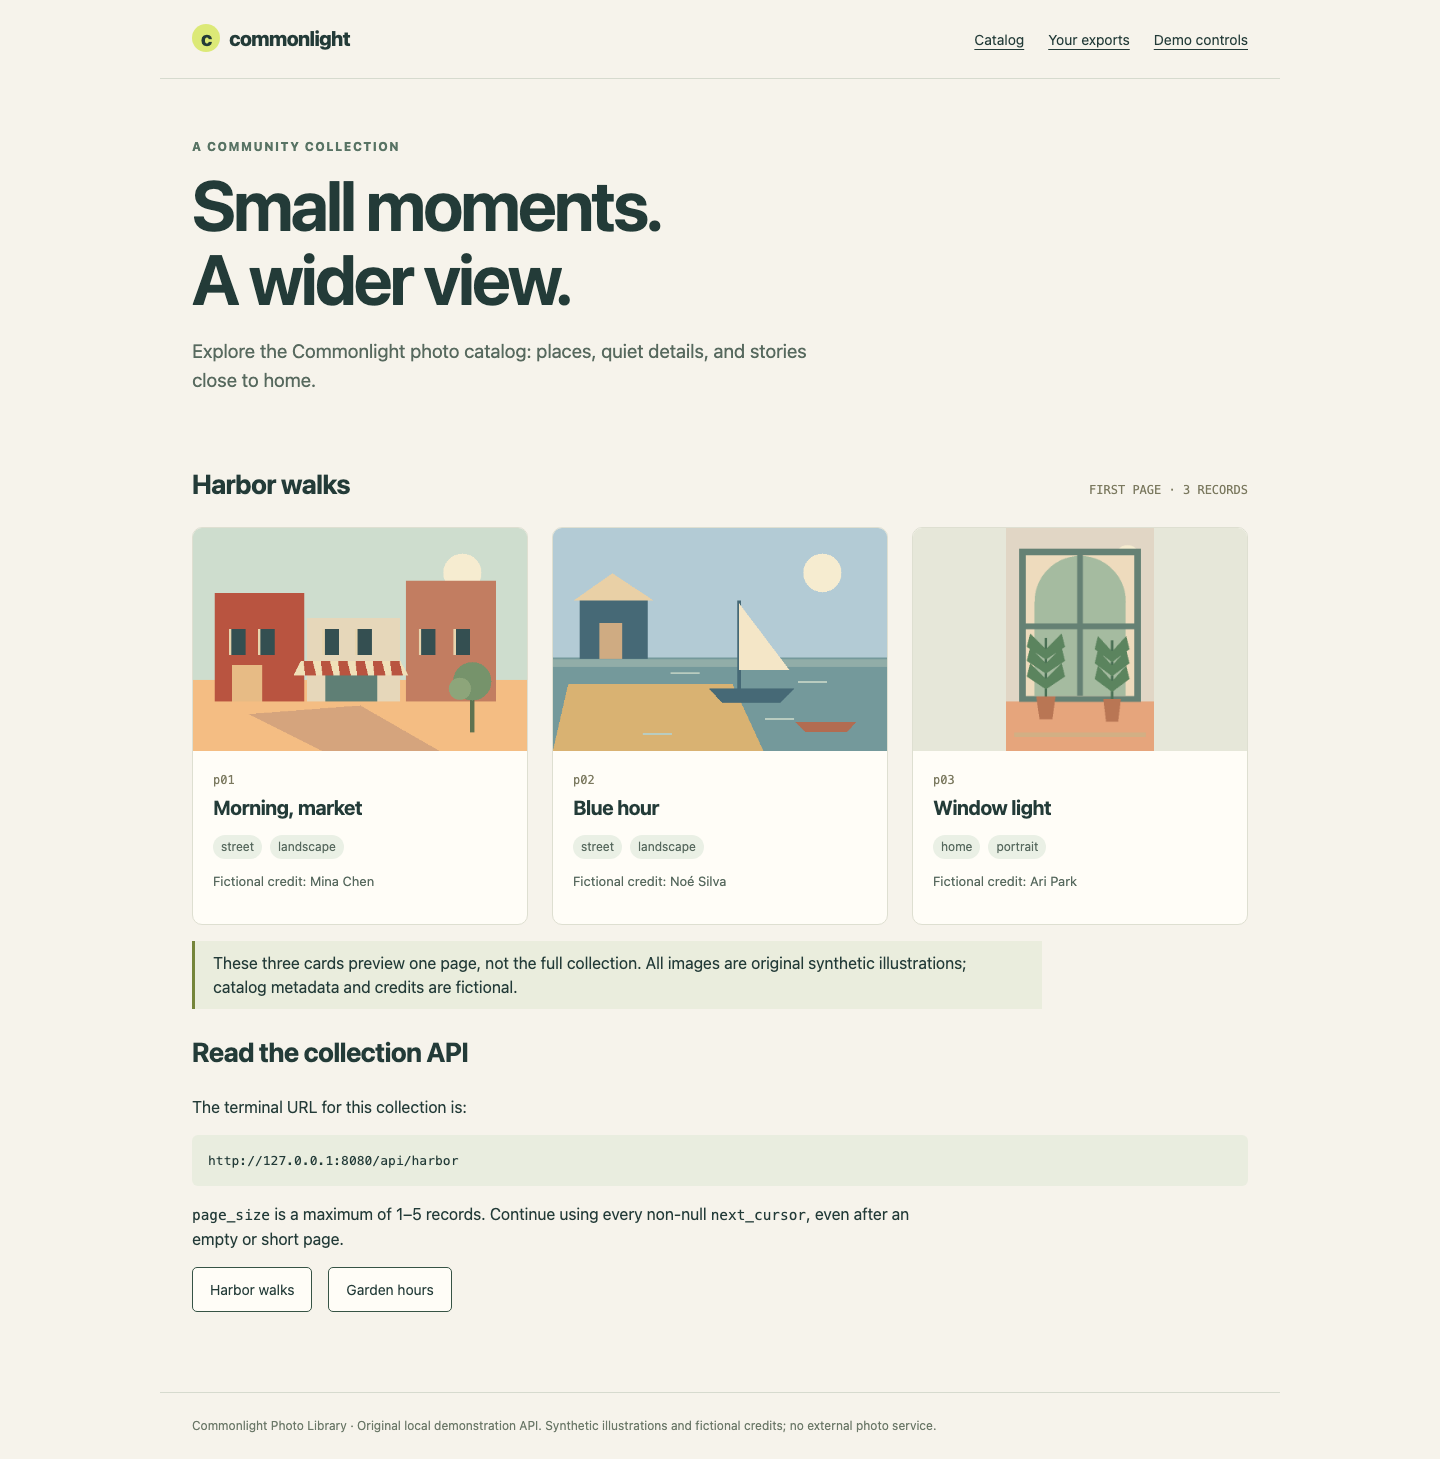
イラストの下の ID を、これから取得するレスポンスと対応させてください。
WebIDE とそのターミナルに戻ります。cd は作業ディレクトリを変更し、python3 は Python を実行します。正確に次のパスを使ってください。
cd /home/labex/project
HTTP はこのローカル API が使うリクエストとレスポンスのプロトコルです。URL はアドレスを指定します。http はプロトコル、127.0.0.1 はこの環境自身、8080 はサービスのポートで、/api/harbor がコレクションを選びます。? の後のクエリ page_size=3 は最大 3 レコードを要求します。このアドレスはターミナル用です。Web 8080 は、同じサービスに対してプラットフォームが用意するブラウザー用アドレスを開きます。
次のヒアドキュメントで小さな Python プログラムを実行します。<<'PY' は終端の PY までの各行をそのまま Python の標準入力に渡します。コピーするときは区切りの両行も含めてください。urlopen は実際の HTTP リクエストを送ります。timeout=3 は接続やソケット待機などのブロッキング操作を制限するもので、あらゆる処理全体の所要時間を制限するものではありません。with は使用後にレスポンスを閉じます。JSON は構造化テキストで、json.load がレスポンスを Python のデータへデコードします。
python3 - <<'PY'
import json
from urllib.request import urlopen
with urlopen('http://127.0.0.1:8080/api/harbor?page_size=3', timeout=3) as response:
    print('HTTP status:', response.status)
    page = json.load(response)
for photo in page['items']:
    print(photo['photo_id'], photo['title'])
print('More pages:', page['next_cursor'] is not None)
PY
HTTP status: 200
p01 Morning, market
p02 Blue hour
p03 Window light
More pages: True
ステータス 200 はリクエスト成功を意味します。外側の JSON オブジェクトは辞書になります。items の値はレコード辞書のリストであり、レスポンス全体ではありません。JSON の null は Python の None になります。ここでは next_cursor がまだ文字列なので、続きのページがあります。この単元では意図的に 1 ページだけを出力し、次の単元で全ページを巡回します。
各レコードには photo_id、title、category、orientation、credit があります。安定した ID がレコードを識別します。タイトルは表示用ラベルなので、別の写真でも同じ場合があります。準備済みの契約は /opt/commonlight/api-contract.md で読めます。cat はテキストファイルを表示します。
cat /opt/commonlight/api-contract.md
再利用できるリクエスト関数と選択関数を追加します。urlencode は辞書をクエリ文字列へエンコードします。カーソルは内部の意味を解釈しない継続トークンです。数値を推測したり文字の意味を解釈したりせず、正確にコピーしてください。省略可能な引数 cursor=None は、最初のリクエストではこのクエリパラメーターを送らないことを表します。後続ページには、エンコードが必要な +、/、= などの文字が含まれることがあります。1 回の巡回中は URL とページサイズを変えません。
選択処理はカテゴリと向きの両方を、大文字・小文字を区別して完全一致で比較します。一致しない場合は空リストが正しい結果です。リスト内包表記では、for photo in photos が各レコードをたどり、if が条件を満たすものだけを残し、and が両方の比較が真であることを要求します。受け取ったレコードを変更せず、新しいリストを作ります。
次のブロックでは cat と > を使い、Python のテキストで client.py をそのまま置き換えます。最後の PY も含めてブロック全体を実行してください。WebIDE でファイルを開いて内容を置き換え、Ctrl+S(macOS では Cmd+S)で保存してもかまいません。このブロックが変更するのはこのファイルだけです。
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    return request_page(endpoint, page_size)['items']
PY
準備済みのコマンドインターフェースがこれらの関数を呼び出します。現時点の collect は、明確に 1 ページだけの初期実装です。セルフチェックでは別の実際のローカル HTTP ソースを使うため、固定したカタログの応答ではなく、渡された URL を使う必要があります。チェックが CSV を代わりに作ることはありません。
Python ファイルを開けないと表示されたら、pwd で現在のディレクトリを、ls でファイル名を確認してください。先ほどの cd で /home/labex/project に戻り、ファイル名を修正して再実行します。VM をリセットする必要はありません。
1 ページを絞り込み、実際の CSV を保存する
このステップでは、最初のページから横向きの街の写真を選び、実際のフィールド値を持つ CSV を開きます。CSV はカンマ区切り値ですが、タイトル内のカンマは 1 つのフィールドの一部です。適切な CSV ライターは引用符で囲みます。単に文字列を連結したり、すべてのカンマで分割したりすると、この対応関係が壊れます。UTF-8 は Noé のような名前や非ラテン文字を保持します。newline='' により、csv モジュールが CSV の改行を管理できます。
FIELDS は 5 つのヘッダー名を定義します。それぞれ 1 回ずつ現れます。同等の実装ではレコードや列の順序が異なってもかまいません。DictWriter は辞書の各値を対応する名前の列へ割り当てます。writeheader がヘッダーを、writerows が選択レコードを書きます。空の選択ではヘッダーだけのファイルを作ります。ファイルを w で開くと内容が置き換わります。この単元では 1 ページのサンプルを保存し、次の単元で完全な複数ページ出力の安全な公開を扱います。
WebIDE のターミナルで、storage.py だけを置き換えてください。
cat > storage.py <<'PY'
"""Single-page CSV writer; safe publication is taught in the second guided lab."""
import csv

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    with open(output, 'w', encoding='utf-8', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(photos)
PY
準備済みの catalog.py は、コレクション URL、カテゴリ、向き、ページサイズ上限、出力ファイル名という 5 つの位置引数を受け取ります。--first-page はサンプルモードを明示的に選びます。street と landscape が 2 つの完全一致フィルターです。シェルの引用符は、特殊文字を含む URL やファイル名を 1 つのまとまりとして扱います。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Saved 2 photos to page.csv
引用符で囲まれたフィールドを復元できる DictReader で結果を読みます。API ではなく、実際に保存したファイルを読み取っています。
python3 - <<'PY'
import csv
with open('page.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'], '|', photo['credit'])
PY
p01 | Morning, market | Mina Chen
p02 | Blue hour | Noé Silva
p03 がないのは、home カテゴリの縦向き画像だからです。最初のタイトルのカンマと、クレジットのアクセント文字が、それぞれのレコードに対応したまま残ります。
次に、意図的な HTTP 拒否を観察します。API が許可するページサイズは 1–5 なので、9 は正常な空のコレクションではなく 400 を返します。このブロックを実行してください。最初のコマンドは失敗するのが期待される動作です。$? は直前のコマンドの終了ステータスで、printf が別のコマンドで上書きされる前に表示します。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 9 rejected.csv --first-page
printf 'Exit status: %s\n' "$?"
HTTP request refused: 400. No complete export published.
Exit status: 1
HTTPError はこの HTTP 拒否を表します。接続失敗は別途 Connection failed として報告されます。どちらも正常な一致件数ゼロの結果ではありません。準備済みのコマンドは例外を捕捉して説明し、非ゼロで終了します。許可されたサイズに戻して復旧してください。サービスは変更しません。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Web 8080 に切り替え、Your exports、page.csv の順に選びます。表には上記の実際の 2 レコードが必要です。Download CSV を選び、ダウンロードしたファイルをテキストまたは CSV リーダーで開いてください。ダウンロード内容は保存済みファイルのバイト列です。ページは不足レコードをソースから取得しません。ページ内ナビゲーションで Catalog に戻り、その後 WebIDE に切り替えてセルフチェックを行います。再利用できる 1 ページのサンプルができましたが、null ではない継続トークンは、まだ完全なカタログではないことを示しています。
まとめ
実際の HTTP リクエストを送り、JSON ページの外側の構造とレコードを分け、正確なフィールド値で選択し、引用符を正しく処理する UTF-8 CSV を書きました。HTTP 拒否、接続失敗、正常な空の結果は異なります。2 レコードのページサンプルは利用可能です。次の単元では残りのカーソルをたどり、完全な出力を作ります。