はじめに
3 枚のカードのプレビューは閲覧には便利ですが、編集担当者はすべての一致レコードを必要としています。同じローカルデモ API のクライアントを完成させ、継続トークンをたどり、ページをまたいで ID を保持し、バッチ全体が成功してから CSV を公開しましょう。空ページや短いページの後にも続きがある場合があります。
この単元は独立して初期化され、最初のガイド付きラボで作成したリクエスト関数と選択関数が用意されています。そのラボ、または同等の HTTP/JSON/CSV の知識が必要です。WebIDE では Terminal → New Terminal を使います。ソース、保存済み出力、公開の Demo controls には Web 8080 を使ってください。編集するのは client.py と storage.py だけです。標準ライブラリとこの 2 ファイル内の補助関数を使い、追加の補助モジュールやリソースは使いません。CSV はワークスペース内の実際の通常ファイルとし、シンボリックリンクにしません。catalog.py、/opt/commonlight、合成イラスト、架空の元レコードは変更しないでください。読解と練習の 55 分は著者による見積もりで、初心者の実測時間ではありません。
プロトコルの終了までたどる
このステップでは、各 ID を 1 回だけ保持しながら、空ページと短いデータページを含む全ページを取得します。WebIDE のターミナルで、独立して準備されたワークスペースへ移動します。
cd /home/labex/project
リクエスト関数はすでに JSON、エンコードされたカーソル、ブロッキング操作の 3 秒タイムアウトに対応しています。cat で準備済みの処理を確認してください。
cat client.py
現在の collect は 1 ページしか返しません。page_size が 3 なら最大 3 レコードであり、毎ページが 3 レコードとは限りません。この小さな列を予想してください。最初は 3 レコード、次はレコードなしでも別のカーソルがあり、その次は 1 レコードとさらに別のカーソルです。空ページはデータを追加しませんが、終了の証拠にはなりません。返されたカーソルだけを使って実行します。
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
正常なバッチの終了を示すのは next_cursor is None だけです。items が空、ページが短い、推測したページ数に達した、という理由で停止しないでください。
ページをまたいで同じ写真 ID が同じ値で再出現することがあります。photo_id をキーにした辞書は、ID とすべてのフィールドの対応を保ちます。setdefault(key, value) はキーがない場合だけ値を挿入します。これで 1 コピーを保持できます。同じタイトルであることは ID の重複ではありません。矛盾する改訂データは、このデモ契約の対象外です。Blue hour という同じ名前の異なる 2 つの ID は、両方残す必要があります。
セットは重複しない値を記録します。set() は空セットを作り、cursor in seen_cursors はトークンがすでにあるかを調べ、seen_cursors.add(cursor) は新しいトークンを記録します。このセットが既出の継続トークンを覚えます。まず正しい null 終了を確認し、その後に重複トークンを拒否します。無限ループにしたり、循環を完了とみなしたりしません。raise ValueError は、不完全な結果を保存する前に収集を止めます。通常の準備済みカタログは有限です。固定ページ数の上限も、自動再試行や途中再開もありません。
client.py を次の完全なモジュールで置き換えます。前と同様に > はこのファイルを置き換え、引用符付きのヒアドキュメントは内容をそのまま保ちます。リクエストとフィルターは変わらず、collect が新しい部分です。
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
全体を収集します。--first-page は意図的にサンプルだけを作るオプションなので省略してください。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
件数だけを信じず、保存された ID を確認します。
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
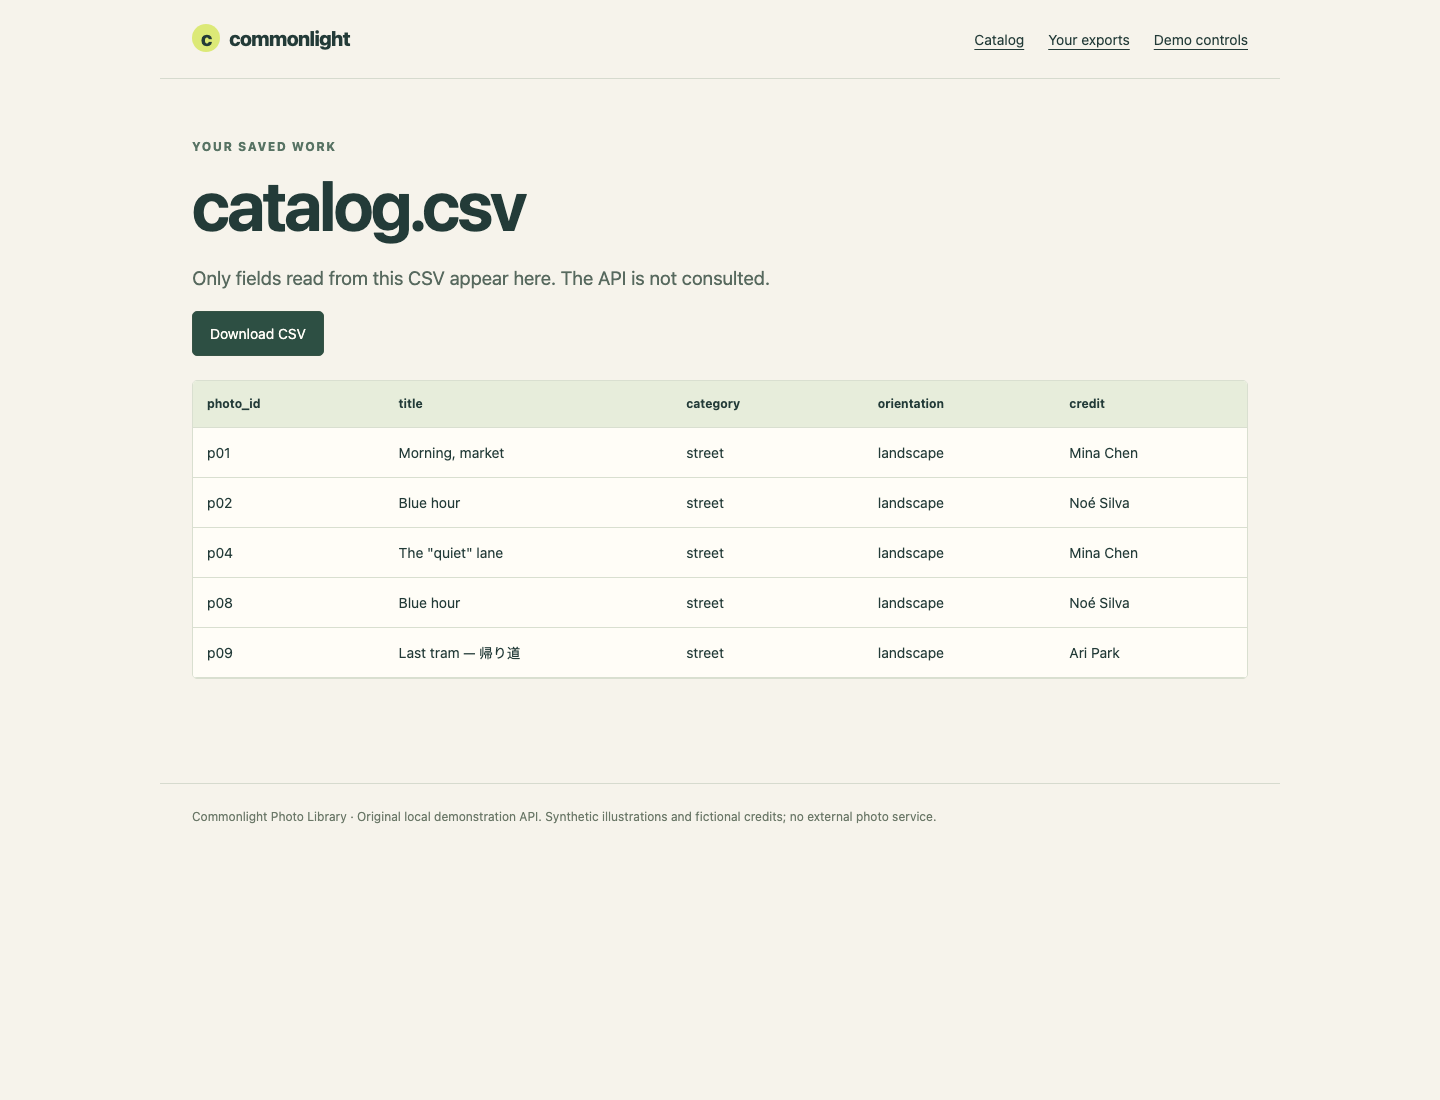
最終ページの p09 があり、p02 は 1 回だけ現れ、p08 は別の ID として同じタイトルを保っています。Web 8080 → Your exports → catalog.csv で同じ値を確認してください。この表は CSV だけを読み、不完全なファイルなら表示も不完全なままです。WebIDE に戻ってセルフチェックします。ファイル名やディレクトリを間違えた場合は、pwd、ls、先ほどの cd で復旧してから再実行してください。
完全な出力だけを公開する
このステップでは、後続リクエスト、プロトコルの循環、ファイル書き込みに失敗しても、前回の正しい出力を保護します。収集はすでに保存前に完了します。書き込みにも全体成功の境界が必要です。最終パスを w で開くと、新しい書き込みが完了する前に正常なファイルを切り詰める可能性があります。
Path(output) は渡されたファイル名文字列をパスオブジェクトにします。.parent は親ディレクトリ、.name は最終ファイル名です。NamedTemporaryFile は catalog.csv.tmp のような予測可能な隣接ファイルを流用せず、新しい一意の名前を作ります。dir=output.parent は出力先ディレクトリに配置し、同じファイルシステム内で置換できるようにします。delete=False は閉じた後もファイルを残し、置換に使えるようにします。stream.name が割り当てられた名前で、Path として保存します。finally ブロックは成功後も例外発生後も実行されます。exists() で一時パスが残っているかを調べ、unlink() は残っている場合に今回作成したファイルだけを削除します。正常に置換できた後は一時パスが消えているため、何も削除しません。例外はコマンドインターフェースへ伝わり、非ゼロ終了になります。Path.replace は with ブロックがファイルを閉じてから、完成したファイルを公開します。成功した POSIX の置換はアトミックですが、電源断後の永続性、複数ファイルのトランザクション、並行書き込みの調整は保証しません。無関係な既存の .tmp ファイルを上書きしたり削除したりしてはいけません。
WebIDE のターミナルで storage.py を置き換えます。CSV の 5 フィールドはそれぞれヘッダーに正確に 1 回ずつ必要です。同等の実装では、有効な引用方法、行順、列順が異なってもかまいません。
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
障害を再現する前に、正常なバッチを 1 回実行します。sha256sum は内容の指紋とファイル名を表示します。この指紋を覚えるか、ターミナル出力を見える状態にしてください。次の失敗したバッチでも変わってはいけません。書き込み失敗でも前回の完全なファイルを保護する必要があります。チェックでは、ワークスペースを変更せず、隔離したテストでこれを確認します。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Web 8080 に切り替えます。Demo controls、Enable middle-page failure の順に選び、Middle-page failure ON を確認してください。
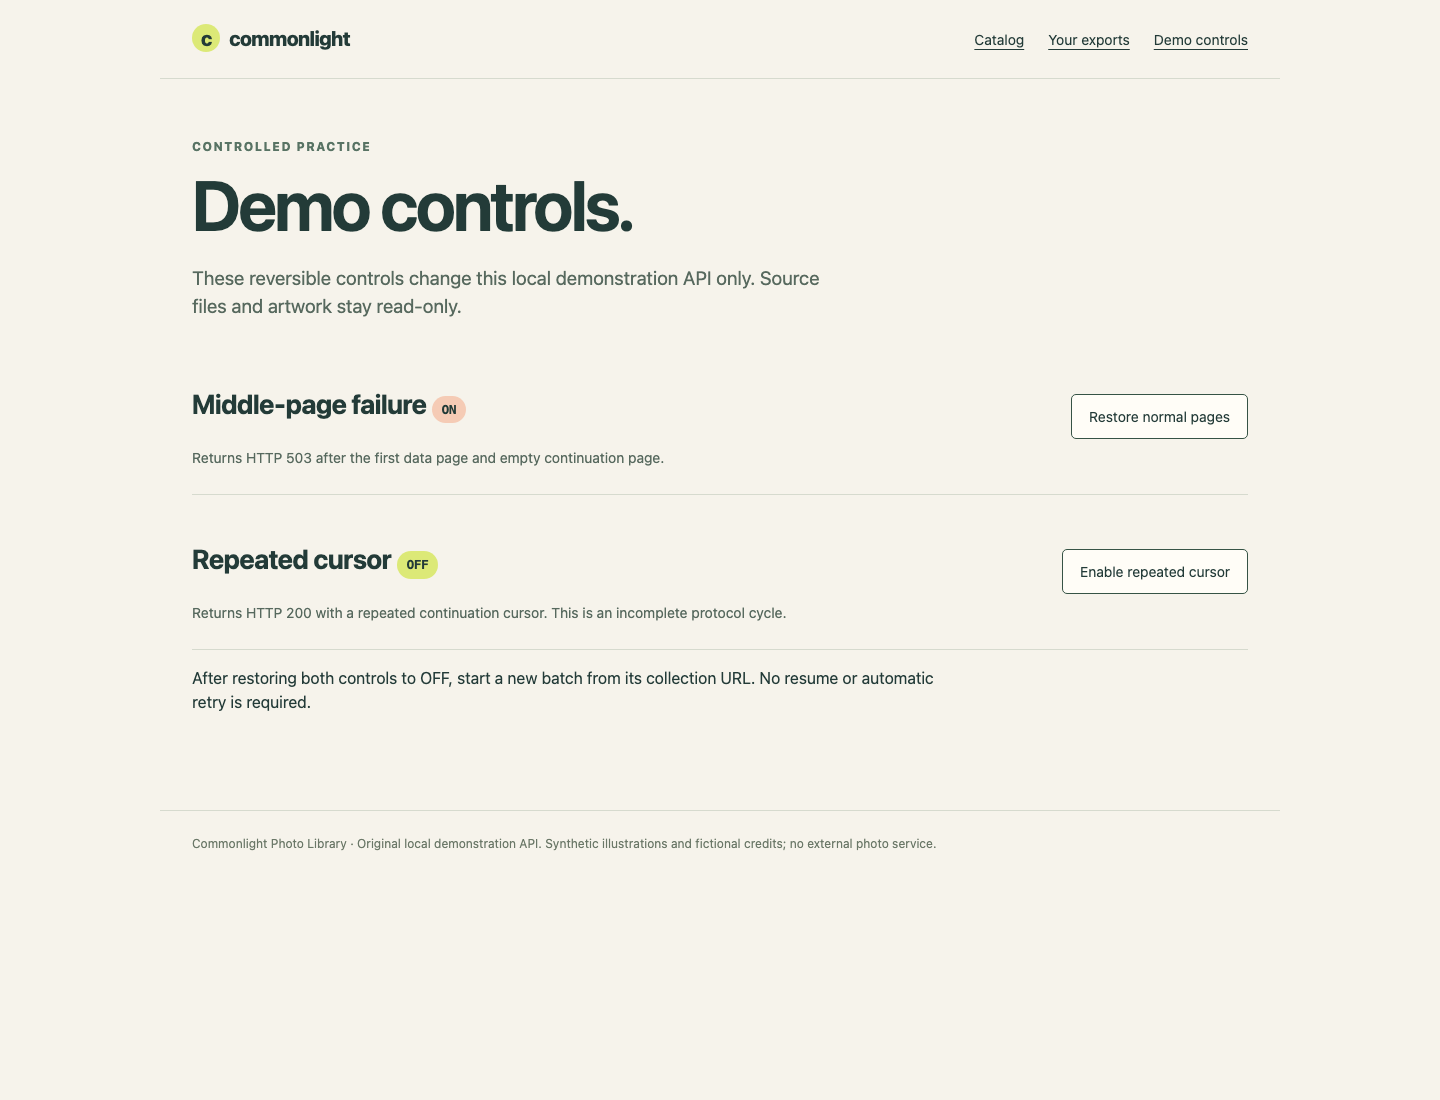
有効にした障害に対応するカードを使ってください。これはデモ API のメモリだけを変更する、明示的に許可された可逆操作です。ソースファイルは読み取り専用のままです。WebIDE に戻り、この意図的な失敗を実行します。printf が直ちに $? を取得します。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
ここでの HTTP 503 は、デモ API が中間ページのリクエストを拒否したことを意味します。接続失敗でも、正常な空の結果でもありません。指紋は前の値と同じで、以前の 5 行の出力を引き続き閲覧できる必要があります。すでにファイルを壊していたら、非ゼロ終了だけでは保護した証拠になりません。
Web 8080 → Demo controls で、中間ページ障害の Restore normal pages を選び、OFF を確認します。WebIDE に戻り、コレクション URL から新しい有限バッチを開始してください。古いカーソルは再利用しません。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
次に Web 8080 → Demo controls に切り替え、Enable repeated cursor を選びます。Repeated cursor ON と、障害側の制御が OFF であることを確認し、WebIDE に戻ってください。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
レスポンスの HTTP ステータスは 200 ですが、重複カーソルはプロトコルエラーであり、完了ではありません。セットによる防護が無限ループと公開を防ぎます。Web 8080 → Demo controls の Repeated cursor カード内で Restore normal pages を選び、OFF を確認してください。これで両方とも OFF である必要があります。WebIDE に戻って成功するコマンドを再実行し、新しい出力名で有効な一致件数ゼロの条件も試します。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
2 つ目は成功してヘッダーだけを保存しており、前の 2 種類のエラーとは違います。Web 8080 → Your exports で empty.csv を開き、5 つのヘッダーとデータ行がないことを確認します。次に catalog.csv を開き、Download CSV を選んでください。実際に保存した 5 レコードのファイルが成果物です。WebIDE に戻ってセルフチェックします。プログラムと準備済みのソースを残してください。チェックは実際の成果物を読み、変更していないコピーを隔離された実際の HTTP テストで実行し、異なる URL、条件、サイズ、書き込み失敗も確認します。
まとめ
内部を解釈しない継続トークンを明示的な null 終了までたどり、同じタイトルでも異なる ID を保持し、プロトコルの循環を拒否しました。一意の一時ファイルを通じて完全な UTF-8 CSV を公開し、失敗時には前回の正しい出力を保護しました。同じプログラムで、別のコレクションや選択条件も受け取れます。