はじめに
スタジオには、正直な予測境界ができました。小さな回帰モデルは、早期の参加人数の中央値より材料計画の見積もりを改善するでしょうか。短い Pipeline を学習し、同じラベル付きワークショップで2つの方法を比較して、実際の比較画像と未来予測を保存します。
Python の関数、pandas の選択と結合、Scikit-learn の基本的な回帰・訓練/テストの概念、Matplotlib の入門知識が必要です。前のガイド付きラボでは、7日前の締め切りと訓練データだけで学ぶ補完を説明しました。このラボは、完成済みの ID/日付分割を含む全ファイルを独立して準備します。前の VM のファイルは不要です。すべてのデータは独自の合成教材です。60分は著者の見積もりです。
早期のワークショップで小さな Pipeline を学習する
このステップでは、魅力的に見える開催後情報のモデルを、再利用可能な7日前予測器に置き換えます。
WebIDE → Terminal → New Terminal から始めます。cd はこのターミナルの作業ディレクトリを変更します。準備済み実行ファイル ./python はコース環境を起動します。./ はシステムのインタープリタではなく、このディレクトリのランチャーを選びます。
cd /home/labex/project/workshop-attendance
cat はファイルを変更せずに表示します。複数のファイル名を引数にすると、順番に表示します。
cat season.json history.csv labels.csv future.csv
過去の各行は session_id をキーとするワークショップです。labels.csv は別の行順で、そのキーに actual_attendance を対応付けます。使える数値モデル特徴は、開催のちょうど7日前に保存した booked_7d と、その時点ですでに公表されていた duration_minutes だけです。数値空欄は情報の欠損を意味し、各使用可能特徴には非欠損の訓練観測があります。ID と日付は対応付けと分割のためで、モデル入力ではありません。final_bookings と scanned_entries は開催時に生じるため、7日前には得られない情報を漏洩させます。
完成済み分割は2026年4月1日 00:00 UTC に訓練を固定し、4月12日以降の過去イベントを評価用に確保します。訓練ラベルは各早期イベントの当日終了までに判明します。ここで最後の訓練イベントは3月8日です。最初の保留予測は4月5日で、そのイベント自身の7日前スナップショットと固定済みモデルを使います。4月5日の入力が4月1日に利用可能だったとは主張しません。後期のスナップショットファイルは対応する後の予測日を再現します。future.csv に実際のラベルはなく、5月のイベントには予測だけを出し、実測誤差は計算しません。設定した空白期間に過去行はありません。逐次再学習や訓練特徴列の全欠損は、このコースでは扱いません。
cat split.py
キーによる merge、解析した日付境界、日付ソートを確認します。前のレッスンで完成した分割が、このラボを独立させるために提供されています。これと、すべての CSV/JSON 入力、python、run.py、coursekit.py、show_results.py、starter-*.py ファイルを保ってください。編集は model.py、chart.py、自分の output/ 成果物だけです。提供された model.py はスキャンを使うモデルから始まります。過去の結果が完璧に見えても、誤った情報選択は正当化できません。
Pipeline は前処理とモデルを連結します。fit では、補完器が渡された訓練特徴から平均を学び、回帰が補完後の訓練行列から学びます。predict では同じ補完器が後の入力を変換するだけです。保留・未来データで再学習することはありません。LinearRegression は通常の最小二乗法で切片と特徴係数を学習します。多数の候補を調整する代わりに、小さなモデルに留めます。
再利用可能な2つのモデル関数を書きます。FEATURES は正確に ['booked_7d', 'duration_minutes'] です。fit_model は学習済み推定器と訓練目的変数の中央値を返します。predict_events はどの入力表でも同じ使用可能特徴を選びます。仮の evaluate は次のステップで完成します。fit 段階はこれを呼びません。
シェルの > はファイルを置き換えます。<<'PY' は引用符付きヒアドキュメントを始めます。最後の PY だけの行まで貼り付けてください。シェルは Python をそのまま保存します。WebIDE Explorer で model.py を編集し、File → Save を選んでも構いません。
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
保存したプレビューは、W-88 に約 32.718 の生予測、実際の人数 46、ベースライン 24.5 を対応付けるはずです。W-09 は予測約 62.236、実際 74、同じベースラインになります。実際の人数が整数でも、回帰出力には小数があり得ます。
./python show_results.py fit
これらは誤差集計前の予測で、後期ラベルなしに学習しています。ラベルの変更は後の誤差を変えるべきで、学習済み予測を変えてはいけません。学習係数がゼロの特徴が影響しないのは正当です。任意の入力変更が必ず予測を変えるわけではありません。
同じ保留集合で連続値の誤差を比較する
このステップでは、実際の保留ラベルから絶対誤差を求め、人数単位の平均を比較します。
WebIDE の /home/labex/project/workshop-attendance で続けます。絶対誤差は actual - predicted の大きさです。np.abs は要素ごとに計算し、np.mean は結果配列を平均します。公平なベースラインでは、同じ保留実測ラベルのそれぞれから同じ早期目的変数中央値を引きます。異なるイベント集合を比較したり、実際の結果を予測で代用したりしないでください。
すべての誤差と MAE に生の連続値予測を使います。先に表示人数へ丸めると評価が変わります。補助プログラムは読みやすいようコンソールの MAE を小数点以下3桁で表示しますが、JSON には丸めない数値を保存します。
model.py を次の完全版に置き換えます。学習と予測ロジックを保ち、空だった evaluate を完成させます。この関数は各イベントの誤差配列と平均を返します。補助プログラムは output/holdout.csv を書く際、同じ保留行の ID を保ちます。誤差ベクトルは渡された実測/予測配列の位置順に従います。pandas Series を含む同等の配列状の値も、この順序で受け入れます。Series の数値インデックスラベルはワークショップ ID ではありません。
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
コンソールの予想要約:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
W-88 のモデル誤差は約 13.282 人、ベースライン誤差は 21.5 です。W-09 では約 11.764 と 49.5 です。丸めない平均は約 12.5230751656 人と、ちょうど 35.5 人です。先の練習のベースラインは18でしたが、この完全シーズンの訓練中央値は24.5です。異なる早期標本を使っているためです。
ここでは2つの保留イベントで小モデルの誤差が小さくなりました。これは小さな合成保留集合についての証拠であり、将来の信頼性や予約の因果的効果を証明しません。正しいモデルでも MAE が大きければ、この比較では改善しなかったというのが正直な結論です。採点はモデルがベースラインに勝つことを要求せず、定数特徴や情報のない特徴も正当です。
図とラベルなしの未来予測を届ける
このステップでは、保留比較を読みやすくし、実際の結果を作り上げずに未来の推定値を出力します。
WebIDE の /home/labex/project/workshop-attendance で続けます。図は、各保留 ID に対して Actual、Model、Baseline の各系列を1値ずつ描き、比較表の人数単位の生の値を使う必要があります。折れ線でも散布図でも構いません。ラベルと ID が意味を明確にします。PNG は読める状態で600×300ピクセル以上とし、同じデータで再実行すると同じ見える図を再現する必要があります。スタイルは異なって構いません。採点は自己申告の図マニフェストではなく、実際の描画値と保存画像を確認します。すべての業務上の点が可視の軸範囲内にあり、必要な系列が非表示や完全透明であってはいけません。境界ちょうどの点は許可され、色と軸範囲は変えられます。
Matplotlib の Agg バックエンドはデスクトップウィンドウを開かずに画像を書きます。subplots は図と座標軸を作り、plot は ID に対応する系列を描きます。以下のマーカー文字列は、実測の白抜き円、モデルの菱形、ベースラインの破線と十字を区別します。実測とベースラインが重なっても識別できます。tight_layout はラベルの余白を確保し、savefig は実際の PNG を書き、close は図を解放します。
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
まず無害な入力ミスを練習します。次のコマンドは意図的に無効な段階名を使い、引数エラーで終了します。保存済み結果は変えません。
./python run.py delvier
メッセージに有効な選択肢が出ます。綴りを直し、成果物を出力する段階を実行します。代わりにファイル未検出エラーが出たら、pwd と ls を使い、最初の cd で戻って正しいファイル名を試してください。
./python run.py deliver
./python show_results.py deliver
リーダーは保存済み CSV/JSON を読み、実際の PNG をデコードします。入力から結果を補うことはありません。WebIDE の Explorer で output を展開し、comparison.png を開きます。モデルは両方の実際の人数点より下にあり、ベースラインは24.5のままのはずです。異なるマーカーで同値系列も区別できます。図と並べて holdout.csv を調べ、各点を ID と実際の誤差に対応付けてください。
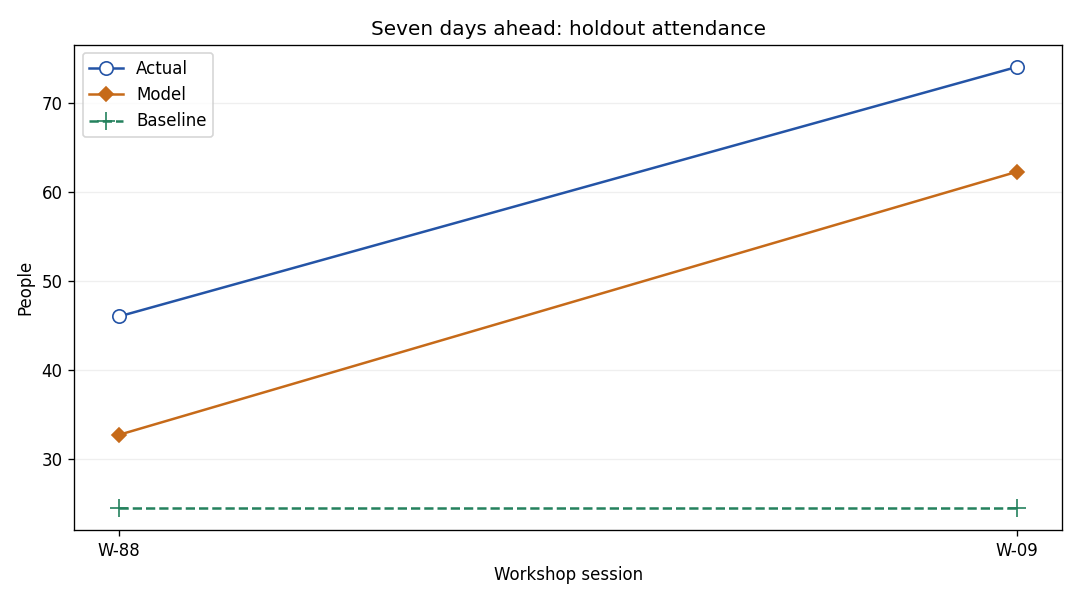
提供データの例では、W-88 と W-09 の実際の人数は46、74、モデル予測は約32.718、62.236、破線のベースラインは24.5です。実際の点から予測までの垂直距離は、そのイベントの絶対誤差です。スタイルは異なっても、ID と元の値は一致する必要があります。
forecast.csv には session_id、生の model_prediction、display_people だけが入ります。F-6 の予測は約 19.119 で表示人数は19、F-101 は約 25.245 で表示人数は25です。表示のためだけに、補助プログラムは負値をゼロに制限し、floor(max(raw, 0) + 0.5) で半端が0.5なら上へ丸めます。これは実用的な表示ルールで、評価対象モデルを変えません。予測が負や小数でも、生の予測は残ります。
未来の実測人数や未来 MAE を作ることはありません。モデルは後の予測スナップショットが到着する前に固定できます。各5月イベントの7日前の締め切りで、既存モデルと、そのイベントに保存された既知特徴を再利用します。小さな合成標本、欠損したスナップショット、参加行動の変化が分析の限界です。独立チャレンジでは同じ手順を保ち、シーズンと日付を変えます。ID 関係が正しければ、同等の数値実装、出力行順、折れ線/散布図のスタイルが 1e-8 の数値許容誤差で受け入れられます。
まとめ
早期のワークショップで小さな補完・回帰 Pipeline を学習し、生の保留誤差を訓練中央値ベースラインと比較して、ID に対応した比較図を保存しました。未知の結果を評価に含めず、未来の推定値も出力しました。保留 MAE が小さければ、この限定的な比較を支持できます。正直に計算したなら、悪い結果も同様に有効です。