Einführung
Ein KI-Endpunkt hängt von mehr als Ihrem JavaScript-Code ab. Lernende können ungültige Eingaben senden, ein ausgewähltes Modell kann eine Anfrage ablehnen, ein Konto kann sein Kontingent oder Ratenlimit erreichen, Kapazität kann vorübergehend nicht verfügbar sein oder Ihr eigener Anwendungscode kann fehlschlagen. Diese Situationen erfordern unterschiedliche Reaktionen. Wenn alle Fälle als „KI-Fehler“ behandelt werden, wird der Betrieb der Anwendung erschwert und es kann zu unnötigen Wiederholungsversuchen kommen.
In diesem Lab erstellen Sie POST /draft-reply. Ein von Cloudflare gehostetes Llama-Modell erstellt einen kurzen Antwortentwurf für den Support. Ihr Worker lehnt ungültige Eingaben vor der Inferenz ab, erkennt dokumentierte Modell- und Limitfehler, wiederholt einen vorübergehenden Fehler höchstens einmal, validiert die Modellantwort und meldet einen Anwendungsfehler getrennt. Ein begrenzter Wiederholungsversuch bedeutet, dass die maximale Anzahl zusätzlicher Versuche im Voraus festgelegt ist. Der Worker kann also nicht so lange wiederholen, bis das kostenlose Kontingent des Kontos aufgebraucht ist.
Die meisten Fehlerpfade weisen Sie mit deterministischen Fixtures nach. Eine Fixture ist ein kontrollierter Ersatz, der ein ausgewähltes Ergebnis oder einen ausgewählten Fehler zurückgibt. Damit lassen sich Kontingent- und Ausfallszenarien testen, ohne absichtlich Kontingent zu verbrauchen oder einen echten Ausfall zu verursachen. Nur eine kurze lokale Anfrage und eine bereitgestellte Anfrage verwenden das Live-Modell.
Dies ist das sechste geführte Lab des Kurses. Wenn Sie direkt hier eingestiegen sind, bearbeiten Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden. Dort lernen Sie, wie Sie das VM-Terminal verwenden, Wrangler autorisieren, Ihr Lernkonto bestätigen und dessen Account-ID konfigurieren.
Das ausgewählte Modell @cf/meta/llama-3.3-70b-instruct-fp8-fast ist über das standardmäßige Workers-AI-Kontingent verfügbar. Workers Free umfasst derzeit 10.000 Neurons pro Tag. Solange das kostenlose Kontingent verfügbar ist, benötigen Sie für dieses Lab keinen Workers-Paid-Tarif. Die sichtbare Übung und die unabhängige Prüfung senden jeweils lokal und nach der Bereitstellung eine kurze erfolgreiche Anfrage. Auch die lokale Inferenz erreicht Cloudflare und verbraucht Kontingent des Kontos. Wiederholen Sie daher eine fehlgeschlagene Live-Anfrage nicht wiederholt.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 als lokale Projektabhängigkeit in /home/labex/project/resilient-ai-reply. Außerdem stellt es deterministische Fixtures und unabhängige Prüfungen bereit. Das Setup autorisiert Wrangler nicht, erstellt keinen Worker-Quellcode, ruft kein Modell auf, führt keine Bereitstellung durch und erstellt keine Cloud-Ressource.
VM autorisieren und den robusten Worker konfigurieren
In diesem Schritt autorisieren Sie diese neue VM und konfigurieren einen einzelnen, nur für diesen Zweck verwendeten Worker. Eine Browser-Anmeldung bei Cloudflare autorisiert Wrangler nicht automatisch innerhalb einer neuen LabEx-VM.
Wechseln Sie in das vorbereitete Projekt und prüfen Sie die festgelegte CLI-Version:
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
Starten Sie den Geräteautorisierungsablauf:
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
Öffnen Sie die angezeigte Autorisierungs-URL im Browser, bestätigen Sie das vorgesehene Lernkonto und genehmigen Sie die aufgeführten Zugriffsrechte. Der KV-Kompatibilitätsbereich wird von dieser Wrangler-Version beim Löschen eines Workers benötigt. Dieses Lab erstellt oder ändert jedoch keine KV-Daten.
Bestätigen Sie die Autorisierung mit einer strukturierten Ausgabe:
npx wrangler whoami --json
Stellen Sie sicher, dass "loggedIn": true angezeigt wird, bestätigen Sie den Kontonamen und kopieren Sie die echte ID dieses Kontos in die nächste Konfiguration. Erzeugen Sie einen eindeutigen Namen und erstellen Sie wrangler.jsonc:
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
Das AI-Binding stellt dem Worker-Code eine kontogebundene env.AI-Schnittstelle bereit. remote: true bedeutet außerdem, dass lokale Wrangler-Anfragen den echten Workers-AI-Dienst verwenden und auf das gemeinsame Kontingent angerechnet werden.
Fehlerkategorien trennen
In diesem Schritt ordnen Sie mehrere sehr unterschiedliche Fehlerursachen einem kleinen öffentlichen Vertrag zu, bevor Sie den Wiederherstellungscode schreiben.
Ein HTTP-Status teilt dem Client mit, welche Art von Ergebnis eingetreten ist. Er sollte keine unveränderten Provider-Nachrichten, Kontodetails oder Stacktraces offenlegen. Dieses Lab verwendet fünf Grenzen:
400 invalid_request: Die Eingabe der lernenden Person fehlt oder überschreitet die zulässige Größe. Die Inferenz startet daher nicht.502 model_incompatibleoderincompatible_model_response: Das ausgewählte Modell oder die zurückgegebene Struktur entspricht nicht dem Anwendungsvertrag. Eine Wiederholung derselben Anfrage behebt die Kompatibilität nicht.503 model_quota_exhaustedodermodel_rate_limited: Das Konto oder das Modell meldet, dass angehalten werden soll. Ein sofortiger automatischer Wiederholungsversuch würde eine weitere Anfrage verbrauchen und zusätzliche Last erzeugen.503 model_temporarily_unavailable: Ein Timeout oder eine vorübergehend nicht verfügbare Kapazität ist zweimal aufgetreten. Die Antwort enthältRetry-After, damit ein Client vor einer späteren Anfrage warten kann.500 application_failure: Die Modellinferenz hat verwendbare Daten zurückgegeben, aber der Formatierungsschritt der Anwendung ist fehlgeschlagen.
Cloudflare dokumentiert den internen Code 3036 für ein erschöpftes tägliches kostenloses Kontingent, 3040 für vorübergehend nicht verfügbare Kapazität, 3007 für ein Timeout und 5035 für ein Modell, das Workers Paid erfordert. Die Anwendung ordnet bekannte Signale stabilen öffentlichen Fehlern zu und protokolliert nur die Kategorie, die Anzahl der Versuche und die Trace-ID.
Erzeugen Sie TypeScript-Deklarationen und prüfen Sie das AI-Binding:
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
Die erzeugte Deklaration bestätigt, dass env.AI für den Worker verfügbar ist. Sie bestätigt jedoch nicht, dass ein Modellaufruf erfolgreich sein wird. Autorisierung, Kontingent, Modellkompatibilität und Dienstzustand sind Laufzeitbedingungen.
Begrenzte Wiederherstellung implementieren
In diesem Schritt implementieren Sie die Klassifizierung, die Begrenzung auf einen Wiederholungsversuch sowie getrennte Grenzen für Modellantwort und Anwendung.
Erstellen Sie den Einstiegspunkt des Workers:
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
Die Wiederholungsschleife erlaubt insgesamt zwei Versuche: den ersten Aufruf und genau einen zusätzlichen Aufruf für eine bekannte vorübergehende Fehlerkategorie. Kontingent-, Ratenlimit- und Kompatibilitätsfehler werden sofort beendet. Beachten Sie außerdem, dass Modellaufruf, Validierung der Antwort und Formatierung durch die Anwendung getrennt sind. So können Betreiber ein Provider-Problem von einem Anwendungsfehler unterscheiden.
Die öffentliche Antwort enthält niemals die unveränderte Exception. Die Protokolle lassen die Support-Nachricht und die erzeugte Antwort weg. Sie enthalten nur die Lebenszyklus-Metadaten, die zur Untersuchung der Fehlerkategorie erforderlich sind.
Die Fehlermatrix testen, ohne Kontingent zu verbrauchen
In diesem Schritt testen Sie jede Fehlerkategorie mit kontrollierten Fixtures, bevor Sie eine echte Modellanfrage stellen.
Führen Sie die deterministische Testsuite aus:
node --test test/worker.test.mjs
Die neun Fälle verwenden Fixtures statt Live-Inferenz. Bestätigen Sie, dass ungültige Eingaben null Modellaufrufe verursachen, Kontingent- und Ratenlimitfehler genau einen Aufruf verursachen, vorübergehend nicht verfügbare Kapazität höchstens zwei Aufrufe verursacht, eine fehlerhafte Ausgabe zu einem Kompatibilitätsfehler wird und ein Formatierungsfehler zu einem Anwendungsfehler wird.
Bündeln Sie jetzt den exakten Worker:
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
Der Testlauf prüft, ob Wrangler das Modul bündeln kann, und sollte das AI-Binding aufführen. Er führt keine Bereitstellung durch und ruft das Modell nicht auf.
Erfolgreiche Inferenz ausführen und Nachweise prüfen
In diesem Schritt führen Sie jeweils eine erfolgreiche lokale und eine bereitgestellte Anfrage aus. Anschließend ordnen Sie die Ergebnisse den schreibgeschützten Nachweisen im Cloudflare-Dashboard zu.
Starten Sie Wrangler lokal im Hintergrund und warten Sie auf die Route ohne KI. Die begrenzte Schleife verhindert ein endloses Warten:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
Die Antwort sollte ein nicht leeres reply, das exakte Modell, eine Trace-ID und im üblichen erfolgreichen Fall attempts mit dem Wert 1 enthalten. Der Wert 2 bedeutet, dass ein vorübergehender Fehler innerhalb der festgelegten Grenze behoben wurde.
Führen Sie die unabhängige lokale Prüfung aus, beenden Sie den gespeicherten Prozess und stellen Sie den Worker bereit:
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Kopieren Sie die exakte workers.dev-URL aus der Ausgabe der Bereitstellung und testen Sie den öffentlichen Endpunkt:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
Die leere Nachricht sollte vor dem Start der Inferenz HTTP 400 zurückgeben. Damit weisen Sie den Eingabeschutz nach, ohne eine weitere Modellanfrage zu verbrauchen.
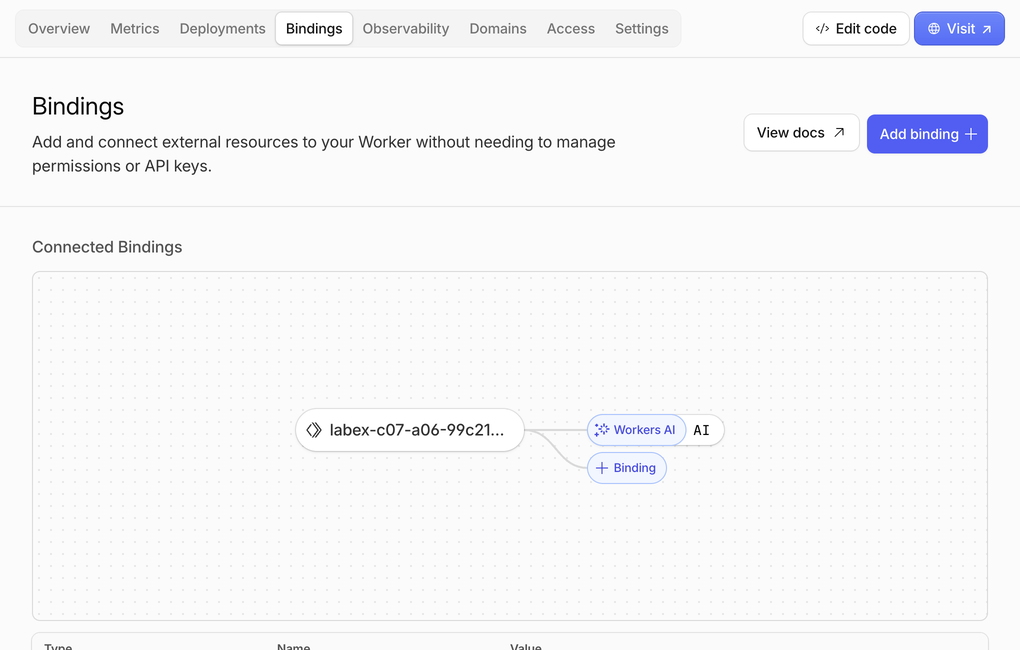
Öffnen Sie Workers & Pages, wählen Sie den exakten Namen des Workers aus und prüfen Sie Bindings. Ein Binding ist eine benannte Verbindung, über die Worker-Code einen anderen Cloudflare-Dienst erreicht, ohne einen API-Schlüssel zu speichern. Bestätigen Sie eine Verbindung zu Workers AI mit dem Namen AI. Der unten angezeigte beispielhafte Worker-Name gehört zum Testlauf; Ihr Name enthält ein anderes zufälliges Suffix.
Öffnen Sie als Nächstes Observability. Der Beispieltestlauf erzeugte sechs erfolgreiche Ereignisse und null Fehler. Die Zählwerte können abweichen, weil eine Anfrage sowohl einen Aufzeichnungsdatensatz für eine Invocation als auch ein Anwendungsprotokoll erzeugen kann und gespeicherte Protokolle nach der Antwort eintreffen können.
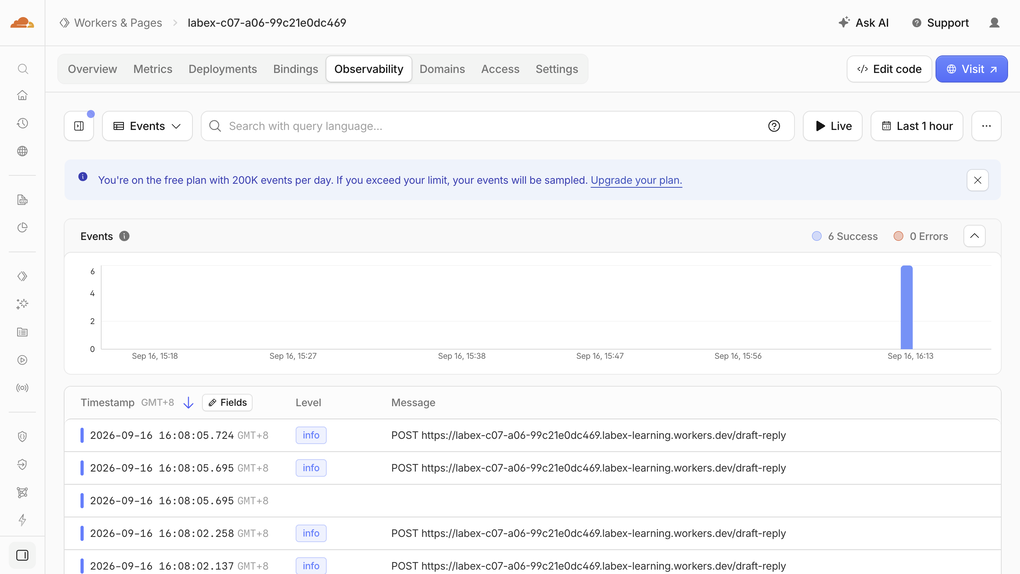
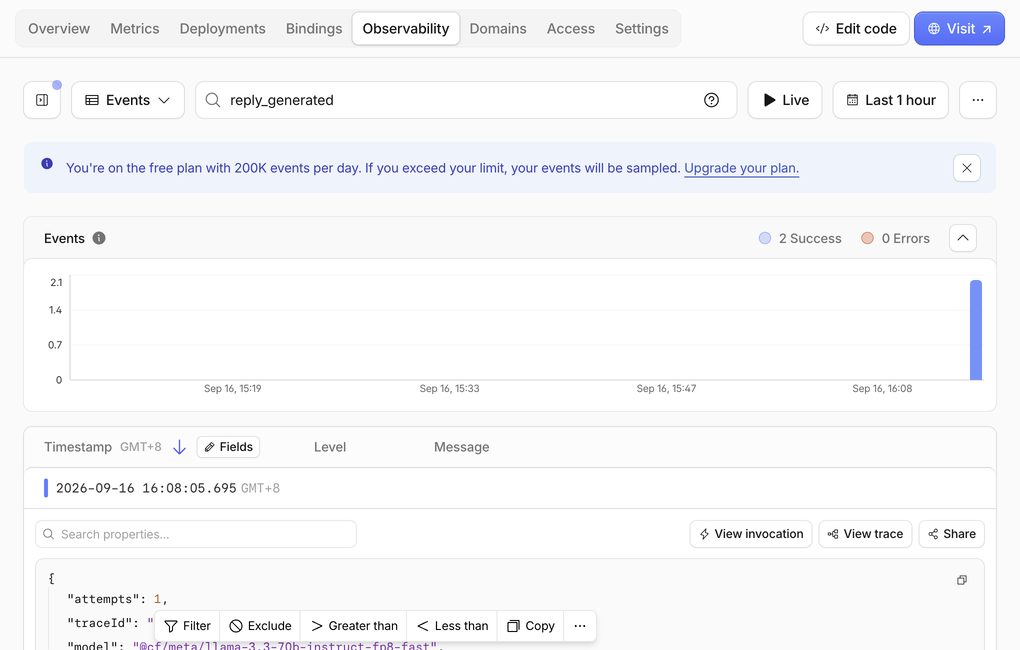
Der blaue Hinweis zum Free-Tarif beschreibt hier das Workers-Logs-Ereigniskontingent, nicht die Nutzung der KI-Inferenz. Suchen Sie nach reply_generated und erweitern Sie ein Ergebnis. Das fokussierte Beispiel zeigt zwei erfolgreiche Treffer sowie die bewusst begrenzten Felder der Anwendung: einen Versuch, eine Trace-ID und das exakte Modell. Das vollständige Ereignis enthält außerdem event: "reply_generated". Die Anwendung protokolliert jedoch weder die Support-Nachricht noch die erzeugte Antwort oder den unveränderten Provider-Fehler.
Öffnen Sie schließlich AI > Workers AI und lassen Sie den Tab Neurons ausgewählt. Ein Neuron ist die Einheit von Cloudflare für KI-Berechnungen. Das gemeinsame Beispielkonto zeigte an diesem Tag eine Nutzung von 428.59/10k Neurons; 427.82 davon entfielen auf das Llama-Modell und 0.77 auf ein früheres Embedding-Lab. Diese Summen enthalten weitere Kursübungen und können sich mit Verzögerung aktualisieren. Sie stellen nicht die Kosten einer einzelnen Anfrage dar.
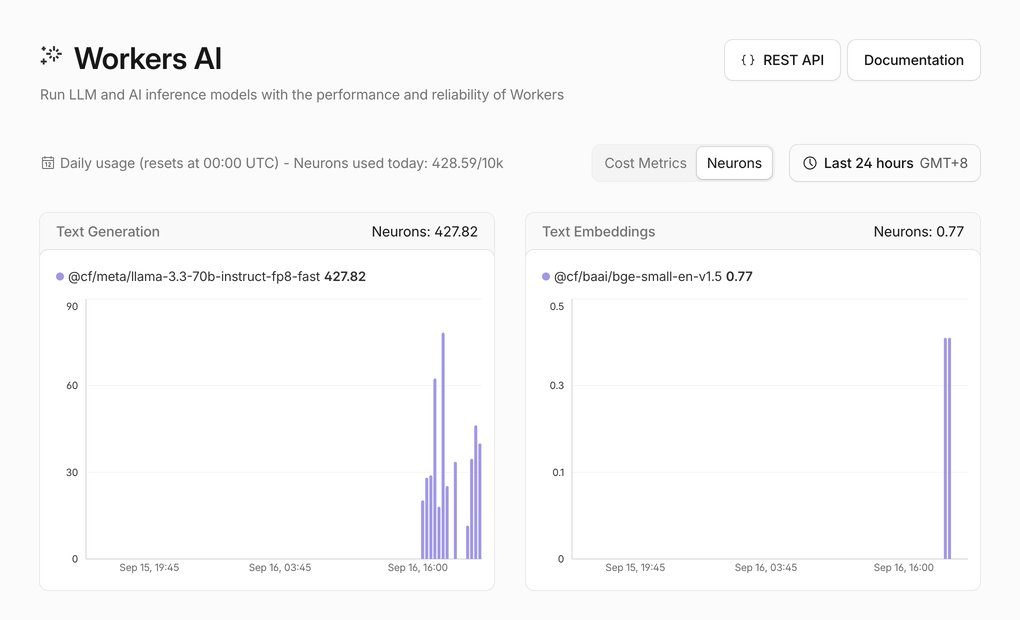
Bestätigen Sie lediglich, dass die Nutzung innerhalb des verfügbaren täglichen Kontingents bleibt. Die Dashboard-Ansichten helfen dabei, Konfiguration, Datenverkehr und Nutzung mit dem Ergebnis der Befehlszeile zu verknüpfen. Maßgeblich bleiben jedoch die Laufzeitantwort und die unabhängigen Prüfungen. Wiederholen Sie die Inferenz nicht nur, damit sich ein Diagramm verändert.
Worker löschen und abmelden
In diesem Schritt entfernen Sie den nur für diesen Zweck verwendeten Endpunkt, solange die Autorisierung noch verfügbar ist. Anschließend entfernen Sie diese Autorisierung von der VM.
Löschen Sie ausschließlich den Worker, dessen Name in wrangler.jsonc eingetragen ist:
npx wrangler delete --force
Bestätigen Sie, dass der Worker nicht mehr vorhanden ist, während Wrangler noch autorisiert ist:
./.labex/verify.py deleted
Entfernen Sie nun die gespeicherte Autorisierung dieser VM:
npx wrangler logout
npx wrangler whoami --json
Stellen Sie sicher, dass "loggedIn": false angezeigt wird, und führen Sie anschließend die abschließende Prüfung aus:
./.labex/verify.py logout
Durch das Löschen eines Workers wird die Cloud-Ressource entfernt. Durch das Abmelden wird die Autorisierung von dieser VM entfernt. Dies sind zwei getrennte Bereinigungsschritte.
Zusammenfassung
Sie haben einen Workers-AI-Endpunkt erstellt, der:
- ungültige Eingaben vor der Inferenz ablehnt;
- Kompatibilitäts-, Kontingent-, Ratenlimit-, vorübergehende und Anwendungsfehler getrennt behandelt;
- einen bekannten vorübergehenden Fehler höchstens einmal wiederholt;
- die Modellausgabe vor der Formatierung durch die Anwendung validiert;
- stabile öffentliche Fehler zurückgibt, ohne unveränderte Provider-Details offenzulegen;
- datenschutzbegrenzte Lebenszyklus-Metadaten protokolliert;
- das Fehlerverhalten mit deterministischen Fixtures nachweist, ohne Kontingent zu verschwenden;
- eine erfolgreiche lokale und bereitgestellte Inferenz mit Workers Free bestätigt; und
- den nur für diesen Zweck verwendeten Worker löscht und sich von der VM abmeldet.
Die wichtige betriebliche Gewohnheit lautet nicht „jeden KI-Fehler wiederholen“. Identifizieren Sie stattdessen die Fehlergrenze, wiederholen Sie nur eine tatsächlich vorübergehende Bedingung innerhalb einer festen Grenze und geben Sie Clients eine verwertbare Antwort.