Einführung
Eine Stichwortsuche sucht nach denselben Wörtern. Eine semantische Suche versucht, Texte mit derselben Bedeutung zu finden. Beispielsweise sollte „Ich kann mich nicht anmelden“ nahe bei einem Artikel zum Zurücksetzen eines Passworts liegen, obwohl die Sätze nicht jedes Wort gemeinsam haben.
Ein Embedding-Modell wandelt Text in einen Vektor um: eine geordnete Liste von Zahlen, die Merkmale darstellt, die das Modell aus Sprache gelernt hat. Texte mit ähnlicher Bedeutung weisen normalerweise in ähnliche Richtungen. In diesem Lab vergleichen Sie diese Richtungen mit der Kosinusähnlichkeit. Dabei handelt es sich um eine Berechnung, die für stärker ausgerichtete Vektoren einen höheren Wert zurückgibt. Ein Wert ist nur zum Vergleichen von Vektoren sinnvoll, die mit demselben Modell, derselben Dimensionsanzahl und derselben Pooling-Auswahl erzeugt wurden. Er ist kein allgemeingültiger Wahrheitsprozentsatz.
Sie erstellen POST /search. Der Worker bettet eine Suchanfrage zusammen mit drei kleinen Hilfeartikeln mithilfe des von Cloudflare gehosteten Modells @cf/baai/bge-small-en-v1.5 ein. Das Modell erzeugt für jeden Text 384 Zahlen. Ihre Anwendung validiert jeden Vektor vor dem Vergleich, lehnt inkompatible oder nicht endliche Werte ab und gibt die IDs der Artikel in Rangfolge zurück, ohne die Vektoren selbst offenzulegen.
Dies ist das vierte Lab des Kurses. Wenn Sie direkt hier eingestiegen sind, bearbeiten Sie zuerst LabEx mit Ihrem Cloudflare-Konto verbinden. Dort lernen Sie, wie Sie das VM-Terminal verwenden, Wrangler autorisieren, Ihr Lernkonto bestätigen und dessen Account-ID konfigurieren.
Kostenlose Workers-Konten erhalten derzeit ein gemeinsam genutztes tägliches Kontingent von 10.000 Neurons. Dieses Modell kostet ungefähr 1.841 Neurons pro einer Million Eingabetokens. Da dieses Lab nur wenige kurze synthetische Sätze verwendet, ist Workers Paid nicht erforderlich, solange das kostenlose Kontingent verfügbar ist. Auch lokale Inferenz erreicht Cloudflare und verbraucht Kontonutzung. Beenden Sie den Vorgang, statt ihn wiederholt zu versuchen, wenn das Modell oder das Kontingent nicht verfügbar ist.
Das Setup installiert Node.js 22.22.0 und Wrangler 4.132.0 lokal im Projektverzeichnis /home/labex/project/search-embeddings. Außerdem stellt es deterministische Tests und unabhängige Prüfungen bereit. Das Setup autorisiert Wrangler nicht, ruft kein Modell auf, stellt keinen Worker bereit und erstellt keine Cloud-Ressource.
VM autorisieren und den Embedding-Worker konfigurieren
In diesem Schritt autorisieren Sie diese neue VM und konfigurieren einen temporären Worker. Die Dashboard-Anmeldung gehört zu Ihrem Browser. Wrangler in dieser VM benötigt jedoch eine eigene, eingeschränkte Autorisierung.
Wechseln Sie in das vorbereitete Projekt und prüfen Sie die festgelegte CLI-Version:
cd /home/labex/project/search-embeddings
npx wrangler --version
Erwarten Sie 4.132.0. Fordern Sie die eingeschränkten Berechtigungen an, die in den vorherigen Workers-AI-Labs verwendet wurden. Die KV-Berechtigung unterstützt die Bereinigungsprüfung von Wrangler 4.132.0. In diesem Lab werden keine KV-Daten erstellt.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Öffnen Sie den angezeigten Link, geben Sie den aktuellen Code ein, prüfen Sie das Konto und die Berechtigungen und autorisieren Sie Ihr Lernkonto. Prüfen Sie anschließend die strukturierte Identitätsausgabe:
npx wrangler whoami --json
Bestätigen Sie loggedIn: true und erzeugen Sie anschließend einen eindeutigen Worker-Namen:
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Ersetzen Sie YOUR_ACCOUNT_ID durch die tatsächliche ID des vorgesehenen Kontos:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AI ist eine In-Process-Bindung und kein Modell-API-Schlüssel im Quellcode. remote: true bedeutet, dass die lokale Entwicklung weiterhin das kontogebundene Modell aufruft.
Den Vektorvertrag verstehen
In diesem Schritt verknüpfen Sie die Modellkonfiguration mit den Zahlen, die die Anwendung validieren muss.
Generieren Sie die Umgebungstypen und bestätigen Sie die Plattformbindung:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Suchen Sie nach AI: Ai. Das ausgewählte BGE-Small-Modell gibt für jeden Eingabetext einen Vektor mit 384 Dimensionen zurück. Dimension bedeutet die Anzahl der Positionen. Ein Batch aus vier Texten sollte daher die Form [4, 384] haben. Jede Position muss eine endliche Zahl sein, also weder NaN noch positive oder negative Unendlichkeit.
Dieses Lab fordert ausdrücklich das Pooling cls an. Pooling bezeichnet die Methode, mit der das Modell Informationen auf Tokensebene zu einem Vektor zusammenfasst. Vektoren, die mit dem Pooling cls beziehungsweise mean erstellt wurden, sind auch dann nicht kompatibel, wenn beide 384 Positionen haben. Deshalb speichert die Anwendung diese Auswahl zusammen mit Modell und Dimensionen.
Prüfen Sie die bereitgestellten deterministischen Fixtures:
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
Diese Fixtures machen Fehlertests reproduzierbar, ohne Neurons zu verbrauchen. Außerdem vermeiden sie die Prüfung eines exakten, live ermittelten Ähnlichkeitswerts, der sich durch das Modellverhalten ändern kann.
Den validierten Ähnlichkeitsendpunkt erstellen
In diesem Schritt implementieren Sie die Embedding-Anfrage, die Vektorvalidierung und den lokalen Kosinusvergleich. Der Worker gibt Dokument-IDs und Bewertungen zurück, nicht die 1.536 Rohzahlen aus vier Vektoren.
Erstellen Sie den Einstiegspunkt:
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
Die Validierung erfolgt vor der Ähnlichkeitsberechnung. Dadurch verhindert sie stilles Abschneiden, bedeutungslose Vergleiche zwischen unterschiedlichen Dimensionen und NaN-Bewertungen. Die Logs enthalten Metadaten zum Ablauf, aber weder die Suchanfrage noch den Artikeltext oder die Vektoren.
Führen Sie die fünf deterministischen Tests aus und erstellen Sie anschließend ein Bundle, ohne etwas bereitzustellen:
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
Die Tests bestätigen die lokale Mathematik und das Ablehnungsverhalten. Der Dry Run bestätigt, dass Worker und Bindungskonfiguration gemeinsam gebündelt werden können.
Einen echten Embedding-Batch ausführen
In diesem Schritt führen Sie den Handler lokal aus, während seine AI-Bindung eine echte entfernte Embedding-Anfrage ausführt.
Starten Sie Wrangler im Hintergrund und warten Sie auf die AI-unabhängige Health-Route:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
Senden Sie eine kurze synthetische Suchanfrage:
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Erwarten Sie model, dimensions: 384, pooling: "cls", drei IDs in Rangfolge und endliche Bewertungen. Verlangen Sie keine exakten Bewertungen. Die Reihenfolge ist ein Ergebnis dieser Suchanfrage und keine dauerhafte Garantie des Modells.
Lehnen Sie eine leere Suchanfrage vor der Inferenz ab:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
Erwarten Sie {"error":"invalid_query"} und HTTP 400.
Bereitstellen und Embedding-Nachweise prüfen
In diesem Schritt stellen Sie denselben Endpunkt bereit und verknüpfen Laufzeitnachweise mit dem Cloudflare Dashboard.
Beenden Sie ausschließlich den gespeicherten Entwicklungsprozess und stellen Sie den Worker bereit:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Speichern Sie die von Wrangler ausgegebene exakte URL und senden Sie eine öffentliche Suchanfrage:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Bestätigen Sie, dass die Antwort Modell, 384 Dimensionen und das Pooling cls enthält und genau die drei bereitgestellten IDs mit endlichen Bewertungen in Rangfolge zurückgibt.
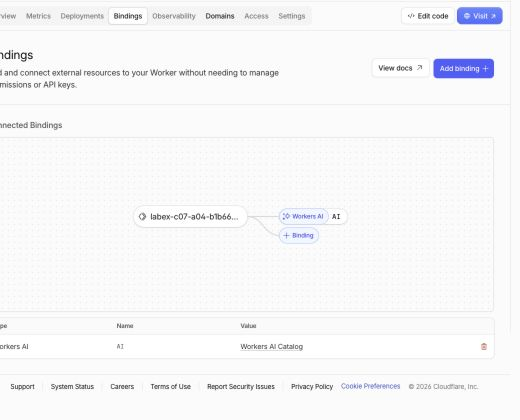
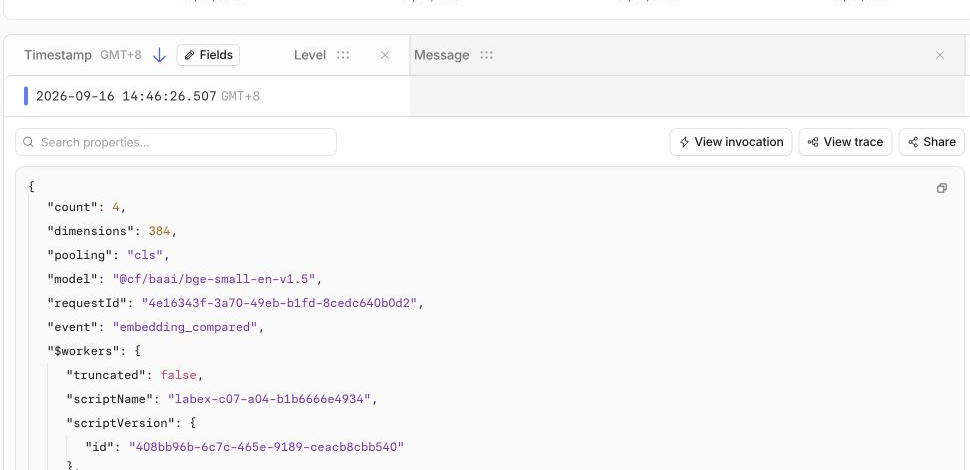
Öffnen Sie Workers & Pages → Overview → Ihren labex-c07-a04-...-Worker. Prüfen Sie unter Bindings die AI-Bindung. Suchen Sie unter Observability → Logs nach embedding_compared und erweitern Sie das Ereignis. Bestätigen Sie das exakte Modell, dimensions: 384, count: 4, pooling: cls und eine Request-ID. Suchanfrage, Dokumente und Vektoren müssen fehlen.
Die Seite Bindings macht die Verbindung sichtbar: Der Worker besitzt eine Workers-AI-Bindung mit dem Namen AI. Eine Bindung ist der sichere Zugriffspunkt, den Ihr Code als env.AI verwendet. Sie fügen keinen API-Schlüssel in die Quelldatei ein.
Die Übersicht Observability zeigt erfolgreiche /search-Anfragen und keine Fehler in diesem temporären Durchlauf. Die genauen Gesamtzahlen können abweichen, da jede Testanfrage zu einem Ereignis wird.
Erweitern Sie ein Ereignis embedding_compared. Dieses fokussierte Beispiel zeichnet nur nützliche Betriebsdaten auf: Es wurden vier Texte verglichen, jeder Vektor hatte 384 Dimensionen, das Pooling cls wurde verwendet und das Modell war @cf/baai/bge-small-en-v1.5. Die Suchanfrage des Lernenden, der Dokumenttext und die Hunderte von Vektorzahlen werden absichtlich nicht protokolliert.
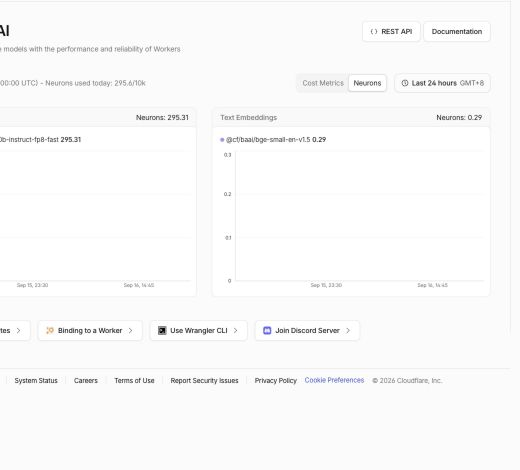
Öffnen Sie anschließend Workers AI. Suchen Sie in der heutigen Nutzung nach dem BGE-Small-Modell und bestätigen Sie, dass der begrenzte Durchlauf innerhalb des gemeinsam genutzten kostenlosen Kontingents von 10.000 Neurons bleibt. Die Anzeige im Dashboard kann verzögert sein. Warten Sie kurz, statt die Inferenz zu wiederholen, um eine Aktualisierung des Diagramms zu erzwingen.
Im getesteten kostenlosen Konto verwendete das Embedding-Modell nur 0.29 Neurons, während die Gesamtnutzung 295.6 / 10k betrug. Die höhere Gesamtsumme umfasst weitere am selben Tag ausgeführte Kurstests. Betrachten Sie diese Zahlen daher als Beispiel und nicht als erforderliches Ergebnis. Der wichtige Prüfpunkt ist, dass die Zeile für BGE Small angezeigt wird und Ihre tägliche Gesamtnutzung unter dem kostenlosen Kontingent bleibt.
Dashboard-Diagramme sind ein hilfreicher visueller Prüfpunkt. Die JSON-Antwort und das unabhängige Verifizierungsskript bleiben jedoch der maßgebliche Nachweis dafür, dass sich der bereitgestellte Worker korrekt verhält.
Worker entfernen und abmelden
In diesem Schritt entfernen Sie den temporären Endpunkt und anschließend die Autorisierung dieser VM. Die Nutzung von Workers AI gehört zur Kontohistorie. Durch das Löschen des Workers wird der Nutzungsdatensatz daher nicht entfernt.
Löschen Sie den exakten Worker aus wrangler.jsonc:
npx wrangler delete
Bestätigen Sie die Löschung nur, wenn Wrangler den eindeutigen Namen dieses Labs labex-c07-a04-... anzeigt. Verlangen Sie die Meldung Successfully deleted und führen Sie anschließend noch während der bestehenden Autorisierung die unabhängige Prüfung auf Cloud-Abwesenheit aus:
python3 .labex/verify.py deleted
Melden Sie sich erst ab, nachdem PASS: deleted ausgegeben wurde, und prüfen Sie den strukturierten Status:
npx wrangler logout
npx wrangler whoami --json
Verlangen Sie loggedIn: false. Ein geschlossener Browser-Tab oder eine fehlende lokale Datei würde die Bereinigung in der Cloud nicht beweisen.
Zusammenfassung
Sie haben mit einem von Cloudflare gehosteten Modell Embeddings mit 384 Dimensionen generiert, die Kompatibilitätsentscheidungen aufgezeichnet, jeden Vektor validiert, die semantische Richtung mit Kosinusähnlichkeit verglichen und inkompatible Daten vor der Rangfolge abgelehnt. Außerdem haben Sie die aktive Bindung und datenschutzbegrenzten Logs geprüft und anschließend den temporären Worker sowie die VM-Autorisierung entfernt.