



はじめに
EARLY CRUMB は土曜日のパンの受け取りを準備しています。注文、支払い、キャンセルは別々に記録されています。同名の顧客が 2 人いて、1 つの注文に複数の商品が含まれることもあります。役立つ引き継ぎの出発点は、名前から推測することではなく、正しい記録を対応付けることです。
このラボでは注文表と支払い表を準備し、各注文 ID に支払い状態を対応付け、支払い済み ID の一覧を作ります。キャンセルは次の独立したラボで扱います。基本的なターミナル操作ができれば十分です。タブ、フィールド、並べ替え、コマンドは使用前に説明します。人物と記録はすべて架空です。
コマンドには Workstation、準備済みの受け取り窓口には Pickup Preview を使います。プレビューには元の記録とラベルの例が表示されます。答えの計算やファイル作成は行いません。
対応付ける表を準備する
このステップでは商品行を失わずに、見出しを除いた記録と、並べ替え済みの注文 ID 一覧を準備します。Pickup Preview から始めます。
引き継ぎの用途を理解する
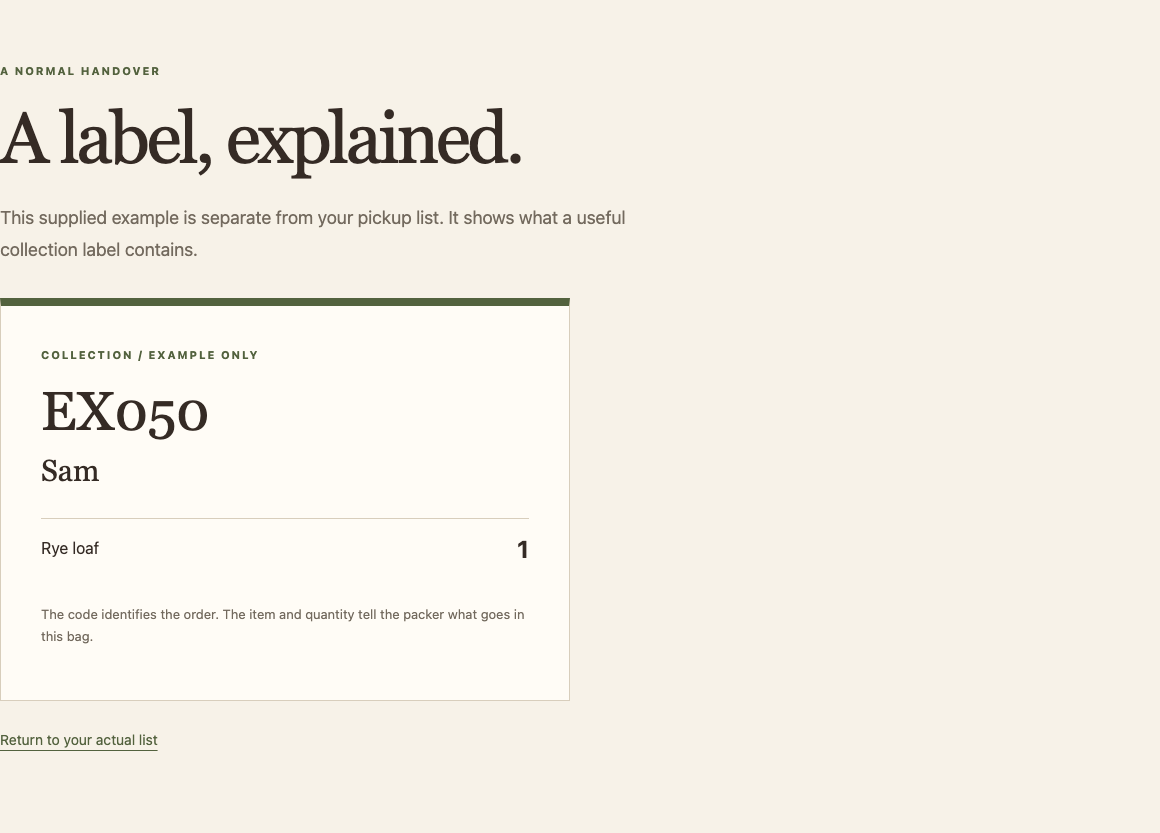
Sample label を開きます。EX050 は Sam のもので、ライ麦パンが 1 個入ります。これは独立した例で、完成した受け取りリストではありません。注文番号は袋を識別し、名前は顧客の確認に役立ち、各商品と数量は袋詰めする人に必要な内容を伝えます。
Records を開きます。商品一覧では rye が Rye loaf、oat が Oat cookie に対応します。orders.tsv の P101 を探してください。Alex はライ麦パン 2 個とオート麦クッキー 1 個を注文しています。P102 も Alex ですが、別の注文で状態は unpaid です。名前で結び付けると別の注文に誤った袋を渡してしまいます。order_id を使います。
準備されたファイルを読む
Workstation に切り替えます。最初のディレクトリは /home/labex/project/pickup です。pwd は現在のディレクトリを、ls はその中の項目を表示します。
pwd
/home/labex/project/pickup
ls
source と work が見つかります。元の記録は変更せず、work/ に再作成可能な中間ファイルを置きます。source/orders.tsv のようなパスは現在のディレクトリからの相対パスです。別の場所へ移動した場合は、次で戻ります。
cd /home/labex/project/pickup
cat はファイルの内容を表示します。両方の表を読みます。
cat source/orders.tsv
cat source/payments.tsv
TSV はタブ区切りの値です。1 行が 1 つの記録で、タブがフィールドを区切ります。最初の行は見出しです。注文の 4 フィールドは、注文 ID、顧客、商品、数量です。1 注文に複数の商品行を持てます。支払い表は注文 ID と正確な状態 paid または unpaid の 2 フィールドで、注文ごとの支払い行は最大 1 行です。提供形式の値の中にタブや改行はありません。
P106 は注文表にはありますが、支払い行がありません。情報がないことは支払い済みを意味しません。対応付ける際も、この欠落を見えるようにします。
見出しと記録を分ける
tail -n +2 は 2 行目から表示します。> は出力をファイルに保存し、保存先が既にあれば置き換えます。元ファイルは変わりません。> で入力と出力に同じパスを使わないでください。プログラムが読む前にシェルがファイルを空にしてしまいます。
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
商品行を確認します。
cat work/orders.rows
P101 と P105 がそれぞれ 2 回あるのは、それぞれ 2 商品を含むためです。これらの行は残します。注文 ID の繰り返しが、そのまま不要な重複データというわけではありません。
対応付けのキーを準備する
キーは記録を結び付ける基準となるフィールドです。cut -f1 はタブ区切りの第 1 フィールドを選びます。パイプ | は出力を次のコマンドに渡します。sort -u は行を並べ替え、完全に同じ行を 1 つにします。ここで重複を除くのは ID 一覧だけで、商品表ではありません。
並べ替えと対応付けは同じ順序を使う必要があります。LC_ALL=C は予測可能なバイト順を選び、export は後続コマンドにその設定を渡します。この設定は現在のターミナルに属し、新しいターミナルでは再設定します。
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
2 フィールドの支払い表は、状態を残して第 1 フィールドで並べ替えます。TAB はタブ 1 文字を保存するシェル変数です。printf '\t' がタブを出力し、$(...) が出力を取り込みます。"$TAB" の二重引用符で、区切り文字を 1 つの引数として渡します。-t はフィールド区切りを設定し、-k1,1 は第 1 フィールドだけを並べ替えキーにします。
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
P101 から P105 が順番に並び、それぞれ元の状態を持つはずです。P106 に支払い行が追加されたわけではありません。6 つの異なる ID と、5 件すべての支払いが対応付けの準備を終えました。見出しや状態に誤りがあれば、該当する作業ファイルだけを元ファイルから作り直し、結果に合わせて元ファイルを変えないでください。
各注文を支払い状態に対応付ける
このステップでは準備した 2 つの入力を結合し、支払いが欠けた注文も表示します。ステップ 1 と同じ Workstation のターミナルで始めます。
対応付けの意味を確認する
P101 は paid、P102 は unpaid、P106 は明示的な missing に対応する必要があります。名前は照合に使いません。この時点では、支払い済みでもキャンセルされている可能性があります。支払いの対応付けだけでは最終リストは決まりません。
join は既定で並べ替え済み入力の第 1 フィールドを結び付けます。通常の内部結合では一致しない ID が省かれます。ここではその記録も見える必要があります。
-t "$TAB"はステップ 1 で作成したタブ区切りを使います。-a 1は第 1 入力、つまり全注文 ID 一覧の未一致記録も残します。-e missingは出力フィールドが欠けた箇所にmissingを使います。-o 1.1,2.2は入力 1 のフィールド 1(注文 ID)と入力 2 のフィールド 2(状態)を出力します。1と2は入力ファイルの番号で、行番号ではありません。
次の完全なコマンドを 1 行で実行します。2 フィールドの結果を書き出します。
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
上の隙間はタブで、バックスラッシュと t という文字ではありません。6 行になるはずです。左入力に全 ID があり、-a 1 が未一致 ID を保持するため、P106 も残ります。
絞り込む前に結果を読む
元データの P101 と P102 はどちらも Alex ですが、状態は異なります。P103 も支払い済みで、後でキャンセルにより除外される可能性があります。P106 に支払いはないため、missing によって比較から黙って消えることを防いでいます。
join が未整列の入力を報告した場合はステップ 1 に戻り、同じ LC_ALL=C で両方の整列済み入力を作り直します。警告を隠したり、都合の悪い注文を削除したりしないでください。再接続した場合は再試行前に、ステップ 1 のディレクトリと 2 つのシェル設定を戻します。
コマンドの成功終了だけでは十分ではありません。この重要な 3 行を元記録と照合してください。これで次の判断に使える完全な支払い対応表ができました。
注文の識別を保って支払い済みを選ぶ
このステップでは支払い済み注文 ID のファイルを作り、保存した実際の内容を確認します。Workstation で始めます。
状態全体に一致させる
paid にも unpaid にも paid という文字列があります。曖昧な検索では P102 も誤って含まれます。タブの後に続く、行末までの完全な状態が必要です。
grep は一致する行を選びます。$'\tpaid$' の外側の $'...' は \t をタブにし、式の内側にある最後の $ は行末を意味します。したがって状態フィールドは正確に paid である必要があり、単なる unpaid の末尾には一致しません。続く cut -f1 は ID だけを残します。対応表が並べ替え済みなので、出力も既に順番どおりです。
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 は未払い、P106 は記録欠落なので入りません。この段階では P103 を残します。このファイルは支払い済み注文を表し、最終的な袋詰め対象ではありません。キャンセルを調べる前に P103 を除くと 2 つの判断が混ざり、中間結果の意味が不正確になります。
保存された選択結果を読む
Pickup Preview に切り替え、ナビゲーションの Payment IDs を選びます。このページは paid-order-ids.txt を表示するだけで、支払いの答えは計算しません。保存した 4 つの ID が見えるはずです。Compare with source records から戻り、対応する支払い行を確認します。
Pickup list に、まだ袋詰め用リストがないと表示されても正常です。作ったのは支払いの選択結果で、最終商品リストではありません。次の独立ラボではこの結果を使ってキャンセルを除外し、すべての対象商品の数量を保持します。
ファイルが空、または P102 を含む場合は、work/payment-match.tsv と完全な状態パターンを確認し、絞り込みを再実行します。元記録を変更せずに修正し、結果を作り直せます。
まとめ
タブ区切りの記録を準備し、共通キーで並べ替え、欠落記録を残して支払いを結合し、正確な支払い済み状態を選びました。注文の識別、顧客名、商品行も区別しました。次の独立ラボでは、この選択結果を実際に使える受け取り用の引き継ぎ資料に変えます。


