はじめに
Meridian Museum では、素材や物語から所蔵品を探せます。トップページが応答していても、所蔵品検索が使えるとは限りません。新しい検索コンテナは、用意された12件のレコードをメモリ上の単語索引へ取り込みます。読み込みの様子を観察できるよう、取り込み間隔を意図的に空けています。置き換えたコンテナは、それぞれ最初から自分の索引を作ります。
このラボでは、読み込み中の Pod を来館者向け Service から外し、起動に十分な時間を与え、既存レプリカが正しい検索結果を返す間にインポーターを更新します。基本的なターミナル操作と、コンテナイメージ・実行中コンテナの知識が前提です。Kubernetes オブジェクト、YAML パッチ、プローブ設定はここで説明します。クラスター、キャッシュ済みの博物館イメージ、完全なサイトは準備済みです。インストール、外部アカウント、アプリのプログラミングは不要です。
来館者の操作には Museum、コマンドには Workstation を使います。名前空間 meridian と用意された博物館の作業領域だけで作業してください。単一ノードの学習用クラスターであり、高可用性やリクエスト失敗ゼロを保証するものではありません。各ラボは独立して始まります。
検索できる Pod だけに来館者を送る
実行中のプロセスと利用可能な検索索引を区別し、来館者の実際の作業に合った readiness を追加します。Museum から始めましょう。
通常の来館者の操作を試す
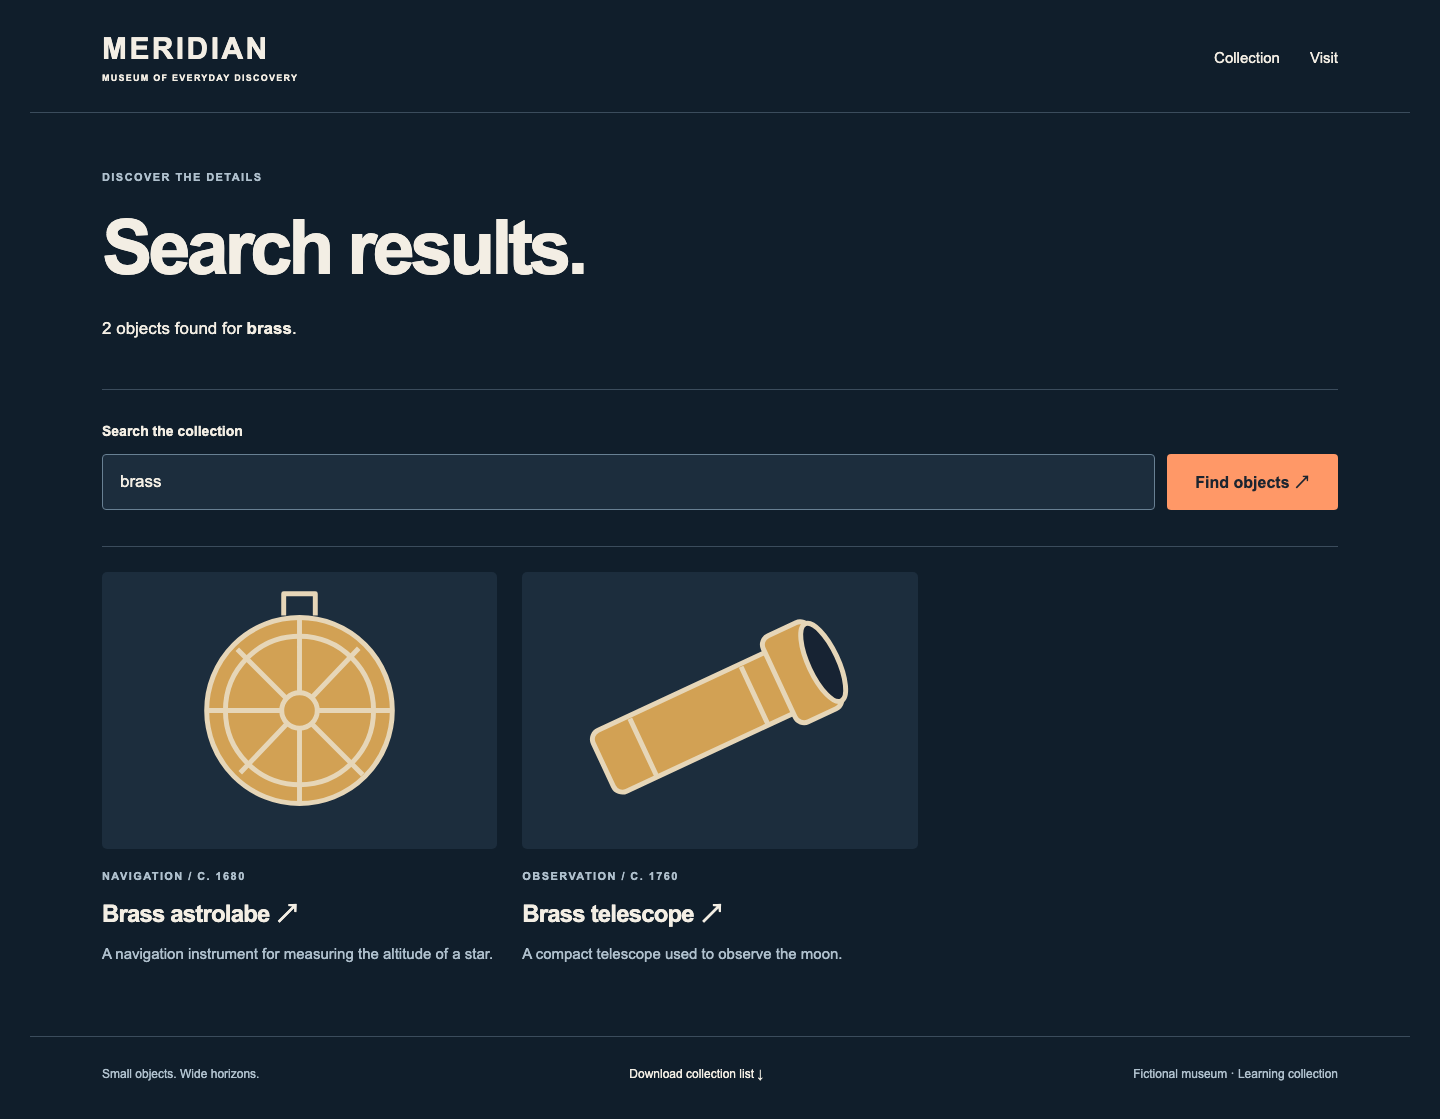
Search the collection に brass を入力し、Find objects ↗ を選びます。結果には Brass astrolabe と Brass telescope、および 2 objects found が表示される必要があります。Brass astrolabe を開くと、物語、イラスト、Gallery 1 の展示場所が表示されます。See it at the museum ↗ を選んで開館時間と段差のない入口を読み、Download collection list ↓ を選びます。ダウンロードした CSV を開き、両方の真鍮製の機器を含む12点を確認します。MERIDIAN でトップへ戻れます。変更後もこれらの機能を保つ必要があります。
3種類の Kubernetes オブジェクトを知る
Workstation に切り替えます。pwd は現在のディレクトリ、ls はそのファイル一覧を表示します。
pwd
ls
ディレクトリは /home/labex/project/museum です。Pod は博物館コンテナを実行します。Deployment は2つのレプリカ Pod を維持し、コンテナテンプレートが変わると置き換えます。Service は来館者に固定アドレスを提供し、選択された準備完了の Pod へ振り分けます。これらを結ぶのがラベルです。Service は app: search の Pod を選択します。名前空間はこのコースのオブジェクトをまとめます。以下のコマンドはすべて meridian を明示します。
kubectl はクラスターへオブジェクトの読み取りや変更を依頼します。get は一覧表示、-n は名前空間の指定です。cat でテキストファイルを表示し、用意された更新候補を読めます。
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML は key: value、スペースによる字下げ、リスト項目の - を使います。spec.template 配下のコンテナはキャッシュ済みの meridian-museum:1 イメージを使います。imagePullPolicy: Never はレジストリからダウンロードせず、用意されたイメージを使う指定です。IMPORT_INTERVAL: "2" はレコードの取り込みを2秒間隔にし、12件で約24秒かかります。最初の来館者向けレプリカは短い間隔で取り込み、正常な検索を先に体験できるようにしていました。
用意されたローリング更新は replicas: 2 を維持し、追加の候補を1つ許可し(maxSurge: 1)、既存レプリカの利用不可を許可しません(maxUnavailable: 0)。ただし正直な readiness が前提です。プローブがなければ、検索が動く前に、実行中のプロセスが対象になってしまいます。これらの設定、イメージ、ラベル、Service は変えないでください。
学習用 Service で早すぎる配信を観察する
ブラウザーは要求と応答のプロトコル HTTP を使います。ステータス 200 は成功、503 はサーバーが一時的にその要求を処理できないことを示します。トップページが動いても、検索のような別の要求が成功する証拠にはなりません。
この博物館には実際の顧客はいません。改善前に、安全でない更新を意図的に実演します。cp は候補を編集用の search.yaml にコピーします。apply -f はその YAML を送信し、Pod テンプレートの変更が更新を始めます。python3 は用意された読み取り専用の観察プログラムを実行し、--seconds 30 は実際の来館者向け Service を30秒間サンプリングします。検索応答に両方の真鍮製品があるか確認します。更新と観察を続けて実行します。
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
保護されていない新コンテナの読み込み中には、HTTP=503 correct_search=false が何行か出るはずです。回数は変動します。トップページは動き続け、503の検索応答は所蔵品を準備中と明示します。これは読み込み中の Pod の本当の応答で、成功・失敗を演出するアニメーションではありません。
rollout status はこの Deployment の更新を待ち、--timeout は待ち時間を制限します。
kubectl rollout status deployment/search -n meridian --timeout=90s
以前の読み込み期間を readiness プローブが保護していなくても、成功を報告することがあります。brass の通常の結果が戻ってから先へ進みます。HTTP ステータスではなく接続エラーなら、Pod 一覧を読み、再試行してください。サーバー不在と、サーバーが503を返す状態は別です。
業務上の準備完了を確認する
readiness プローブは、この Pod に Service のトラフィックを送ってよいか調べます。失敗すると対象から外れますが、コンテナは再起動しません。このイメージの /health/process は常に HTTP プロセスの状態を示す一方、/ready/search は12件すべての索引が完成し、既知の brass 検索が動く場合だけ200を返します。ブラウザーのトップページも取り込み中に200を返すため、トップページもプロセス用エンドポイントも適しません。
patch は選択したフィールドを変更します。--patch-file はファイルを読み、--type=strategic は名前が search のコンテナをほかの設定を残してマージします。プローブは Pod の名前付きポート http に HTTP を送り、2秒ごとに確認し、1回の失敗で未準備にします。次の小さなパッチを書きます。cat > readiness.yaml はファイルを置き換えます。<<'YAML' は文字どおりに扱うヒアドキュメントの開始です。最後の行に単独で置く YAML も含め、ブロック全体を貼り付け、字下げを保ってください。
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
新レプリカの取り込み中も、既存レプリカから正しい検索結果が返り続けるはずです。
EndpointSlice は Service の実際の Pod アドレスと準備状態を記録します。-l はサービス名ラベルで絞り、-o jsonpath は構造化された応答からアドレスと ready だけを選びます。用意された表示式はエンドポイントを順番に処理してフィールドを表示する、読み取り専用の式です。Pod と Service のアドレスを確認します。
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
取り込み中には新しい 0/1 Running Pod と ready=false のアドレスが見えることがあります。既存の準備完了エンドポイントは検索を処理し続けます。読み込みが終わると候補が準備完了になり、置き換えが進みます。短い途中状態を見逃した場合は、次のステップでより長く観察できます。
最後はちょうど2つの 1/1 Running Pod にします。更新成功後も古い Terminating Pod が短時間残る場合は、消えるまで待って get pods を繰り返してください。Museum で brass 検索とアストロラーベの詳細を再確認します。YAML エラーならパッチを直して再適用します。プローブのパスの誤字なら同じパッチのパスだけを直し、再適用します。他の名前空間を削除したり、エラーを隠すため取り込みを短くしたりしないでください。
インポーターの起動に十分な時間を与える
readiness の待機と起動失敗を区別し、実際の取り込み時間に基づいて起動予算を設定します。Workstation で始めます。
startup プローブは新コンテナの初期化に許す時間を制限します。成功するまで Kubernetes は readiness の確認を保留します。起動失敗がしきい値に達すると kubelet がコンテナを再起動します。startup プローブは任意です。短すぎるものを追加すると、本来動くアプリが準備完了になれなくなる場合があります。起動成功後の readiness の代わりにはなりません。
短すぎる予算を観察する
startup-short.yaml は用意された学習用の例です。startup プローブの失敗は再起動を要求しますが、終了処理により、表示される再起動回数の増加が遅れることがあります。次のクライアントの待機は60秒で、その違いを観察できます。適用前に例を読みましょう。
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
更新コマンドは error: timed out waiting for the condition で失敗する想定です。実際の終了ステータスはゼロ以外です。この対話型ターミナルで続行してください。例では2秒ごとの確認で2回の失敗しか許さず、起動時間はおよそ4秒です。24秒の取り込みには足りません。
実際の証拠を読みます。logs はアプリの出力、--prefix は各 Pod の識別、--tail=4 は各ログの末尾4行への制限です。セレクターで全検索 Pod を指定します。get events はクラスターの観測情報を読み、--field-selector reason=Unhealthy は失敗したヘルスチェックに絞ります。
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
新しい Pod は未準備のままで、RESTARTS が増えるはずです。CrashLoopBackOff は Kubernetes が次の再起動を遅らせている状態です。起動失敗が記録されても一覧がまだゼロなら、予算を変える前に待って get pods を繰り返します。一覧は瞬間の状態で、終了には時間がかかります。再起動のたびにメモリ内の索引は失われ、代わりのコンテナが再びレコードを取り込みます。
startup の確認がすでに失敗したコンテナから後で index_complete が出ても、予定された再起動は取り消されず、Service の準備完了バックエンドにもなりません。再起動回数と起動失敗イベントを併せて読んでください。古い Pod は 1/1 を維持し、完成済みの索引で検索を処理します。
Museum で brass を検索します。既存の準備完了レプリカから Service を通じて正しい結果が返ります。停止した更新は自動でロールバックされておらず、Deployment は依然として不良候補を要求しています。既存のサービスが続くことと、更新完了を混同しないでください。
適切な予算を計算して適用する
Workstation に戻ります。12件を2秒間隔で取り込むと約24秒です。ここでは60秒を使い、次の36秒の取り込みと12秒の学習用余裕も確保します。periodSeconds × failureThreshold は計画上の概算であり、厳密な期限の保証ではありません。スケジューリング、プローブのタイムアウト、実負荷によって変わります。本番では起動を測定し、意図を持って余裕を決めます。
同じパッチファイル方式を使い、実際の業務パスと名前付きポートを保ちます。
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
修正された startup 設定で置き換え Pod が作られます。各 Pod は再起動なしで読み込みを終え、最終一覧には RESTARTS 0 の 1/1 Running Pod が2つ必要です。終了中の古い Pod が消えるのを待ち、必要なら一覧を再表示します。起動成功後も readiness がトラフィックを制御します。
更新がまだ進まない場合は同じログとイベントを読み、ファイルのパスと予算を比較して修正し、再適用します。Pod を削除しても Deployment テンプレートは直らず、同じ不良設定で再作成されます。60秒のプローブ予算と --timeout=120s を区別してください。後者はクライアントが更新を待つ時間だけを制限します。
より遅い更新でも検索を維持する
取り込みを遅くし、Service の応答と準備完了エンドポイントを併せて更新を評価します。Workstation で始めます。
kubectl set env は Deployment のコンテナテンプレートの環境変数を変更します。置き換え Pod が作られますが、すでに動くコンテナの環境は変わりません。取り込み間隔を3秒にします。12件で約36秒になり、60秒の起動予算に収まります。
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
取り込み中の新 Pod は 0/1 Running になるはずです。既存の準備完了アドレスは正しい brass の結果を返し続けます。観察プログラムは Museum と同じ NodePort Service を使い、特定の正常な Pod を選びません。観測した実行では、保護された要求は正しいままでした。有限のサンプルから、実際のあらゆるネットワーク・アプリ・クラスター条件で失敗ゼロとは約束できません。
更新全体が終わるのを待ち、最終状態を確認します。
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
古い Terminating Pod がすべて消えたら、現在の Pod はちょうど2つ、準備完了かつ再起動ゼロで、2つのエンドポイントアドレスは ready=true を示す必要があります。取り込み中の正常な旧レプリカは役立ちますが、最後の更新は実際に新リビジョンへ収束する必要があります。
来館者向けサービス全体を確認する
Museum で MERIDIAN からトップへ戻り、再度 brass を検索します。両方の機器が表示されることを確認し、望遠鏡を開いて来館案内リンクをたどります。volcano を検索すると、失敗せず該当品なしと表示される必要があります。Collection で真鍮以外の所蔵品を開き、Visit から一覧をダウンロードします。12点すべてと、維持されたイラストやナビゲーションを確認します。
Workstation に切り替えます。curl は URL へ要求し、-sS は進行表示を隠しつつ接続エラーを表示します。127.0.0.1 はこの学習インスタンスで、ポート 30081 は実際の博物館 Service です。引用符で検索 URL を1つのシェル引数に保ちます。
curl -sS 'http://127.0.0.1:30081/search?q=brass'
HTTP の成功コードだけでなく、HTML 内の正しい2つのタイトルを読んでください。古い Pod の終了中に確認が走ったら待って再試行し、プローブ削除や取り込み短縮は行わないでください。クラスター、提供イメージ、Service、12件の元データを保ちます。正直な業務 readiness、十分な起動時間、博物館体験を守って完了した更新が最終成果です。
まとめ
readiness を実際の所蔵品索引につなぎ、短すぎる startup プローブによる候補の失敗と再起動を観察して、適切な起動時間を計算しました。既存の準備完了レプリカが検索を処理する間に間隔を設けたインポーターを更新し、現在の Pod、Service のエンドポイント、来館者の全操作を確認しました。プロセス実行中、バックエンド準備完了、更新完了は異なる事実です。この単一ノードの演習は本番の高可用性や失敗ゼロを実証するものではありません。