はじめに
Field Notes には、一部が準備されたギャラリーがあります。あるグループはソースから一時的な HTTP 503 を受け取り、他のグループは完了しました。その失敗の証拠を保持し、少数の再試行を許可した新しい Job を実行して、すでに正しい JPEG を書き直さずにコレクション全体を完成させます。
この独立した VM には、専用の 20 枚の元写真、共有ストレージ、Web サイト、失敗した Job、部分的な出力が含まれています。前の VM のファイルは不要です。先に ギャラリーをバッチ処理で作成する を完了するか、そこで扱う Indexed Job、YAML のコピーと編集、Pod の調査、ダウンロードの手順を理解している必要があります。40 分は作者による所要時間の見積もりです。
コマンドには Workspace、Web サイトには Gallery を使います。配布ファイル、元画像と参照画像、処理プログラム、計画、サービス、PVC、元の first-try Job とその Pod およびログを維持してください。
失敗した写真グループを復旧する
このステップでは、復旧ポリシーを選ぶ前に、不完全なギャラリーとネイティブに記録された失敗インデックスを結び付けます。
Gallery を開き、Open the gallery を選択して、14 of 20 images available を確認します。1 番目、3 番目、4 番目のグループは完了していますが、グループ 1 の 6 枚の写真がありません。ページのナビゲーションで Reference を開き、配布された正常な例を確認してから、Workspace に切り替えます。
ターミナルは /home/labex/project/photo-gallery から始まります。pwd で確認し、必要なら cd /home/labex/project/photo-gallery で戻ります。グループの対応表とスタッフの作業指示を読みます。
cat inputs/groups.txt
cat inputs/brief.txt
ゼロから始まる 4 つのグループがあります。インデックス 1 には photo-07 から photo-12 が含まれています。保持された試行を調べます。
kubectl describe job first-try -n photo-workshop
Completion Mode: Indexed、Completed Indexes: 0,2,3、Pods Statuses の失敗した Pod 1 つ、Events の下の FailedIndexes 警告を探します。完了したインデックスと、以下の Pod の表から、不足しているグループを特定できます。配布されたソースでポリシーを読みます。
cat starter/first-try.yaml
backoffLimitPerIndex: 0 は、インデックス内で失敗した後の代替 Pod を許可しません。backoffLimit: 6 は、これとは別の全体の失敗許容数です。インデックスごとの許容回数ゼロを上書きするものではありません。activeDeadlineSeconds: 180 はアクティブ期間の上限です。いくつかのインデックスが成功していても、Job は失敗したままです。
実際の Pod とそのインデックスラベルを一覧表示します。
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=first-try -L batch.kubernetes.io/job-completion-index
それらすべてのログを読みます。
kubectl logs -n photo-workshop job/first-try --all-pods=true --prefix=true
インデックス 1 の Pod は Source returned HTTP 503 を報告して終了します。他のグループは、完了した写真を報告します。HTTP 503 は、ソースが応答したものの一時的に利用できなかったことを意味します。Pod が存在しない場合、接続失敗、読み取れない JPEG とは異なります。
表からインデックス 1 の Pod の完全な名前をコピーし、次のコマンドの POD_NAME を置き換えてください。プレースホルダーをそのまま入力してはいけません。
kubectl describe pod POD_NAME -n photo-workshop
終了したコンテナーには Exit Code: 42 が表示されます。これは、配布されたワーカーがソースの HTTP エラーに対して意図的に返す値であり、Kubernetes 全般の HTTP エラーコードではありません。このシナリオでは、新しい各 Job のインデックス 1 における最初のリクエストに対して、実際の 503 を 1 回発生させます。同じインデックスに対する次の代替 Pod は、ソースを正常に読み取れます。これは制御された一時的障害の演習であり、本番環境のすべての 503 が安全に再試行できると主張するものではありません。
失敗した Job、その Pod とログ、既存の正しい JPEG 14 枚を保持してください。処理プログラムは、同一の JPEG を必要な場合にだけ書き込みます。すでに一致している画像のバイト列とファイルメタデータは維持します。新しく成功した試行を識別するために、Pod ごとの処理記録と画像の索引レコードは更新されることがあります。
各インデックスに有限の再試行を設定する
次に、各インデックスで 1 回の再試行を許可した新しい Job を作成します。すでに失敗した Job を新たな実行に変えようとしてはいけません。
Workspace の /home/labex/project/photo-gallery で、配布された復旧用の下書きをコピーします。
cp starter/recovery-job.yaml gallery-job.yaml
前の実験と同様、cp はコピー元をそのまま残します。コピー元が見つからない場合は、pwd を確認してワークスペースに戻り、正確に同じコピーを繰り返します。下書きを読みます。
cat gallery-job.yaml
すでに全 4 インデックスと並列度 2 を要求していますが、下書きの名前は gallery-draft で、インデックスごとの再試行がありません。sed -i で、コピーしたファイル内の各値を文字どおりに置き換えます。単一引用符は、置換式がシェルに解釈されるのを防ぎます。
sed -i 's/name: gallery-draft/name: gallery-retry/' gallery-job.yaml
sed -i 's/backoffLimitPerIndex: 0/backoffLimitPerIndex: 1/' gallery-job.yaml
ファイルをもう一度読みます。
cat gallery-job.yaml
name: gallery-retry、completions: 4、parallelism: 2、backoffLimitPerIndex: 1 を確認します。backoffLimit: 6、activeDeadlineSeconds: 180、配布されたすべての処理プログラム、マウント、実行主体、リソースの設定は維持してください。この課題では、インデックスごとに 1 回または 2 回の再試行を認めますが、小さな有限の許容回数で十分です。期限をなくしたり、無制限の再試行を許したりすると、持続的な問題が隠れてしまいます。
新しい Job には、新しい Kubernetes 上の識別情報が付与されます。以前に成功したグループも処理する可能性があります。配布されたワーカーは、一致する JPEG を書き直さずに、この反復実行を扱います。Job の成功から、処理が厳密に 1 回だけ行われたと推論してはいけません。以前の失敗した Job を残すことで、この復旧が必要になった理由も確認可能なままにできます。編集が一致しなかった場合は、適用前に下書きを再度コピーして修正します。すでに不適切な最終 Job を作った場合は、その証拠を残し、変更不能な Pod テンプレートを変えたり first-try を削除したりせず、保存するファイルに別の新しい名前を用意してください。
保存した新しい Job を適用します。
kubectl apply -n photo-workshop -f gallery-job.yaml
正常な完了を待ちます。
kubectl wait -n photo-workshop --for=condition=Complete job/gallery-retry --timeout=180s
インデックスとポリシーを調べます。
kubectl describe job gallery-retry -n photo-workshop
Completed Indexes: 0-3 が期待されます。直前の wait コマンドで、ネイティブな Complete 条件はすでに確認済みです。実際の Pod を一覧表示します。
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=gallery-retry -L batch.kubernetes.io/job-completion-index
インデックス 1 には、失敗した Pod と、それとは別の、同じインデックスに対する完了した代替 Pod があります。失敗した Pod は、この制御されたテストで想定される証拠です。出力を読みます。
kubectl logs -n photo-workshop job/gallery-retry --all-pods=true --prefix=true
実際の HTTP 503 と、その後に代替 Pod で処理が成功した様子が見えるはずです。他のグループは、すでに一致していた JPEG に対して Kept を報告します。待機がタイムアウトしたら、新しい Job と Pod のログを調べてください。以前の失敗を消したり、セットアップをリセットしたり、むやみに再試行回数を増やしたりしてはいけません。要求する並列度は、望ましい同時実行数の設定であり、置き換え中のプロセス数を絶対的に保証するものではありません。
復旧したコレクションを引き渡す
このステップでは、再試行によって利用可能なギャラリー全体ができたことを確かめ、現在のダウンロードを保存します。
Gallery に切り替え、ページのナビゲーションで Gallery を選択して更新します。20 of 20 images available を確認します。復旧したグループの最初の写真、Black-and-white blossoms(photo-07)を開き、その写真自身の元画像と比較します。Download thumbnail と Back to gallery を選択します。枚数の少ない最後のグループの Blue and yellow flowers(photo-20)も開きます。
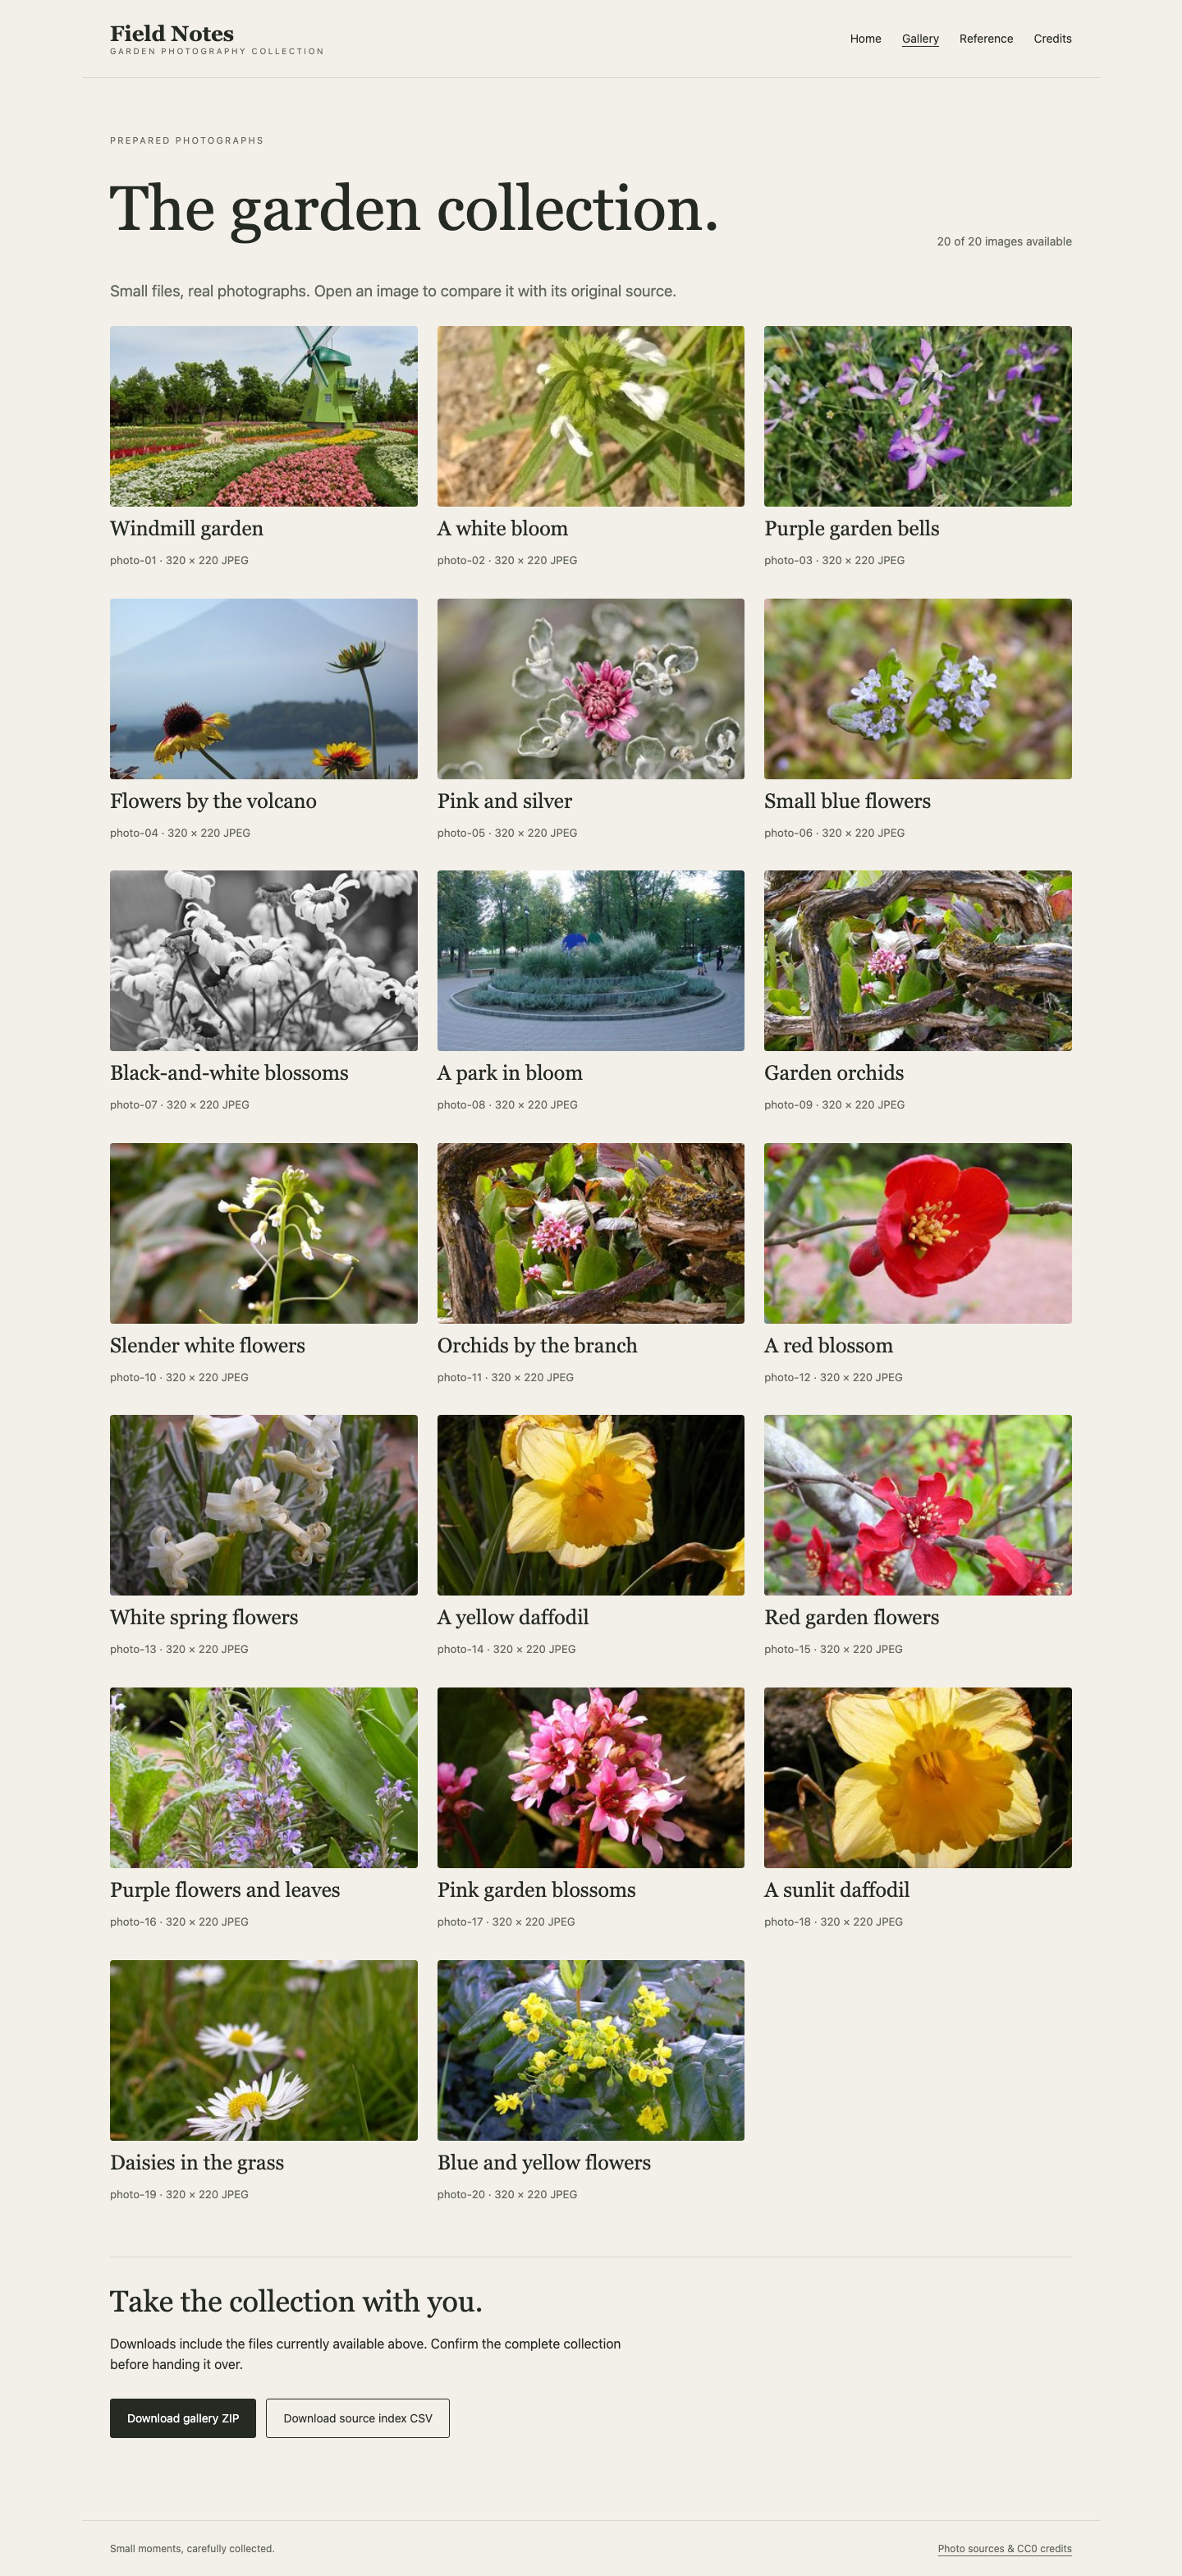
復旧したコレクションには、不足していた 6 枚と、枚数の少ない最後のグループが含まれています。ページからは、変更されていない参照用サンプルと、ライセンス付きの元画像を引き続き参照できます。
ギャラリーに戻り、Download source index CSV と Download gallery ZIP を使います。Reference を選び、配布された例がそのままであることを確認し、Credits で出典表記を確認します。サイトは、ワーカーの実際の読み取り可能な出力だけを表示します。ソースコレクションから不足画像を補うことはありません。
Workspace の /home/labex/project/photo-gallery に切り替えます。最初の実験で学んだものと同じオプションで、現在の実際の引き渡し用ファイルを保存します。
curl --fail --silent --show-error http://127.0.0.1:8091/download/index.csv -o gallery-index.csv
curl --fail --silent --show-error http://127.0.0.1:8091/download/gallery.zip -o gallery.zip
CSV のヘッダーと先頭の行を調べます。
head -n 3 gallery-index.csv
展開せずに、安全にアーカイブの一覧を表示します。
python3 -m zipfile -l gallery.zip
index.csv と、復旧したグループおよび photos/photo-20.jpg を含む 20 枚の実際の JPEG が入っています。元画像とサムネイルのハッシュが、それぞれの写真をその写真自身の結果と結び付けています。ファイル名だけでは不十分です。
最後に、両方の試行が引き続き利用できることを確認します。
kubectl get jobs -n photo-workshop
元の first-try は失敗し、新しい gallery-retry は完了しています。これが意図された最終状態です。保存したマニフェスト、ダウンロード、成功した Pod と失敗した Pod、元の JPEG 14 枚、ソース、参照用サンプルを利用可能なまま残してください。ダウンロードが失敗するか不完全な場合は、ワークロードやサービスを修正して再度ダウンロードします。受信したファイルを手作業で修復してはいけません。
まとめ
Indexed Job の部分的な失敗を診断し、ネイティブな証拠を保持して、インデックスごとに有限の再試行を設定した新しい Job で実際のコレクションを完成させました。元画像から生成されたファイル、元から成功していた JPEG、稼働中のギャラリー、保存済みマニフェスト、引き渡し用ファイルが一致しました。