はじめに
The Common Archive は PostgreSQL に 4 件の地域の記録を保存しています。参照サイトは動いていますが、新しいアーカイブでは、データベースが接続を受け付ける前にカタログのインポートを試みました。動いているコンテナーと使用可能なデータベースを区別し、初回起動を確実にしましょう。
基本的な Docker、コンテナーログ、公開ポート、ターミナルのパスを知っていることを前提とします。この実験では YAML の関係、小さな Compose ファイル、データベースのヘルスチェック、依存条件を学びます。SQL、PostgreSQL 管理、アプリケーションのコーディングは不要です。完全なデータベースイメージ、インポーター、Web サイト、データが用意されています。
Workstation、Reference Archive、Your Archive、Collection Notes を使います。素材はすべて合成の学習用記録です。意図的なデータベースとインポートの遅延は起動状態を見えるようにするもので、本番の所要時間を示しません。読む時間とよくある間違いへの対処を含め、約 45 分を見込んでください。作者による見積もりです。
使用可能なデータベースを待つ
このステップでは、小さいながら完全なアプリケーションの依存関係を 1 つ修正します。構成を置き換える前に、順に観察してください。
正常なアーカイブを使う
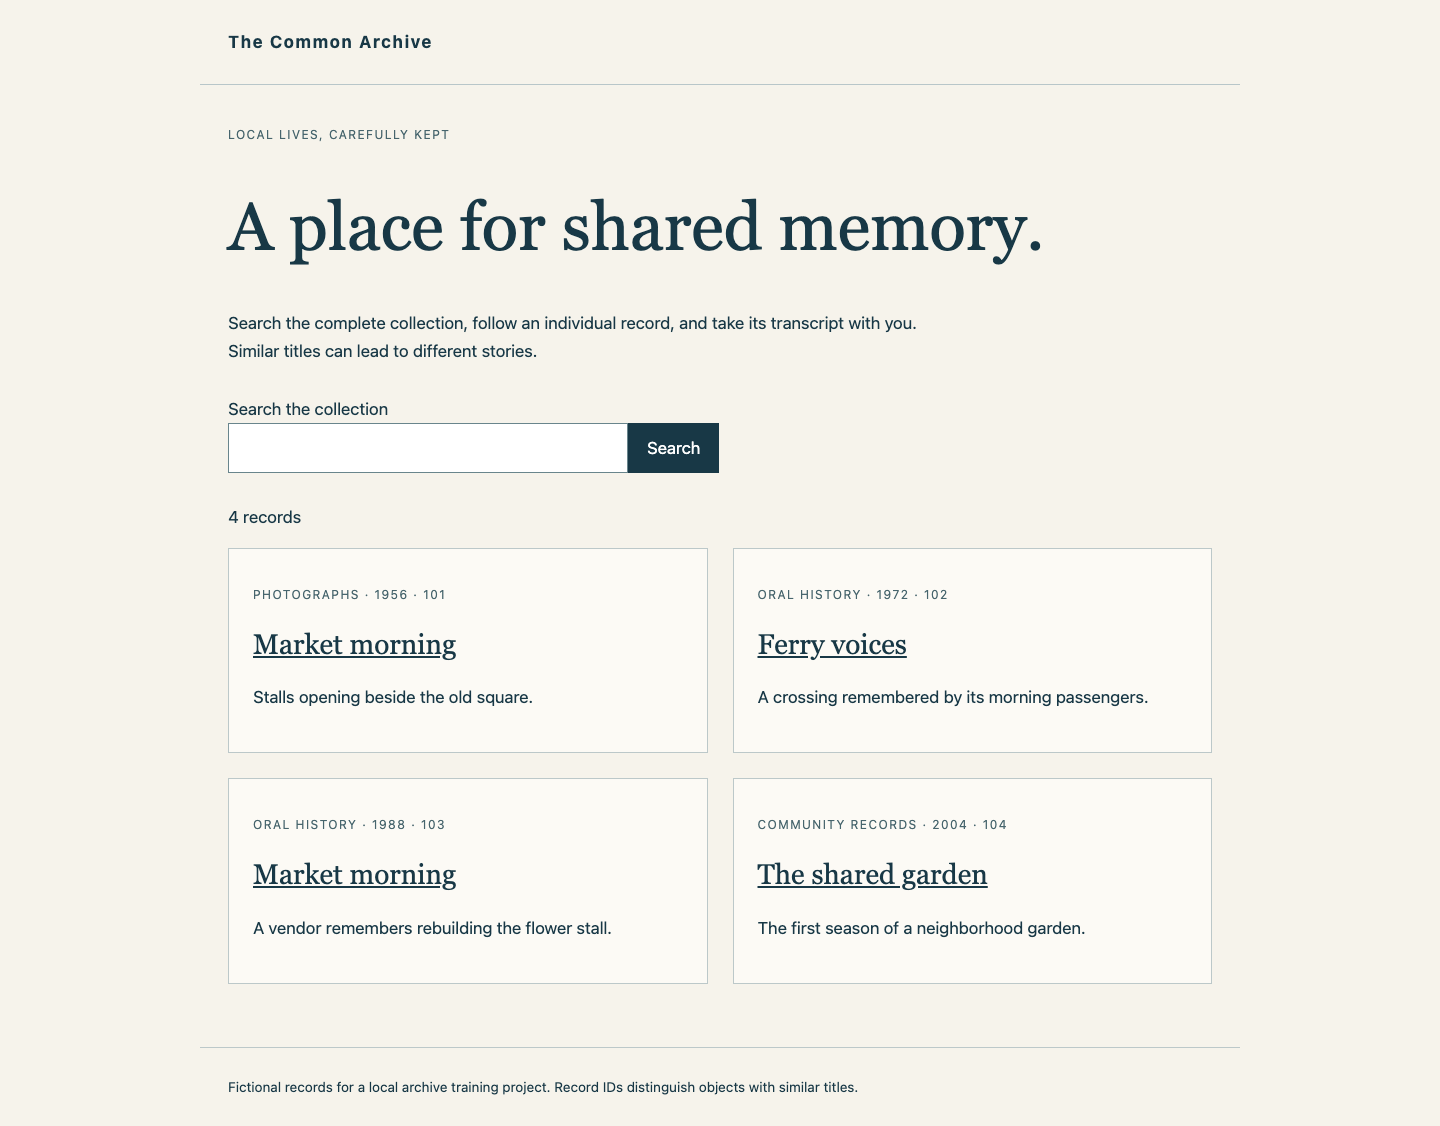
Reference Archive から始めます。Search the collection と Search で Market morning を検索します。同じタイトルの 2 件は異なる物語です。両方を開き、ID、年、カテゴリーを調べ、Download transcript を使います。Back to collection で戻り、検索を消して Ferry voices を調べます。ダウンロードはデータベース記録から得た実際のテキストであり、完了マーカーではありません。
Your Archive に切り替えます。カタログが動いていないことを説明しており、参照用のものを借りて表示しません。Collection Notes は、この案内サービスがデータベースの行を読まないため、すでに動いています。コンテナーが Up でもカタログの完全性は証明できません。
実際の起動失敗を読む
参照用コレクションには 4 件の記録があり、両方の Market morning は別々の識別情報を持ちます。
Workstation に切り替えます。開始場所は /home/labex/project/archive-startup です。必要なら cd で戻ります。cat はファイルを表示します。
cd /home/labex/project/archive-startup
cat compose.yaml
Compose は YAML を読みます。インデントは各サービスのプロパティをまとめます。タブではなくスペースを使ってください。services: の下にある 4 項目は次のとおりです。
| サービス | 実際の仕事 | 成功時の状態 |
|---|---|---|
db |
PostgreSQL が記録を保存する | 実行中で TCP 接続を受け付ける |
importer |
1 つのトランザクションで提供 CSV をインポートする | ステータス 0 で終了 |
catalog |
記録と書き起こしを検索・提供する | インポート成功後に実行中 |
welcome |
データベースを読まずに Collection Notes を提供する | インポート前に動いてもよい |
image は準備済みイメージを選びます。entrypoint は提供されたプログラムを起動し、編集しません。environment は名前付き設定をプログラムに渡します。PGHOST、PGUSER、PGPASSWORD、PGDATABASE は、使うデータベースと学習用アカウントをクライアントに知らせます。これらの認証情報はこの実験用です。POSTGRES_* は新しいデータストアにそのアカウントを準備します。認証を変更したり、別のデータベースに置き換えたりしないでください。
data ボリュームはこのプロジェクトのデータベースファイルを保持します。相対パス ./scenario は提供入力フォルダーをインポーターに読み取り専用でバインドし、:ro がそれを示します。データベースは提供された初回起動用の学習遅延スクリプトも読みます。公開ポート 8090:8080 は Your Archive を catalog に接続します。案内ページは別のポートを使います。Compose プロジェクトは資源をまとめます。以下の -p archive は常に自分の学習用アーカイブを対象とし、参照用は別のプロジェクトとボリュームを使います。
ps -a は停止済みや未起動のコンテナーも含みます。logs は実際の出力を読みます。
docker compose -p archive ps -a
docker compose -p archive logs db importer
データベースは最終的に準備完了と表示しますが、インポーターはすでに接続に失敗しています。後からデータベースが準備できても、失敗したインポートは自動再実行されません。catalog は、提供された依存関係ですでに importer の成功を待つため、未起動のままです。
PostgreSQL は最終的な TCP リスナーを起動する前に、一時的な初期化サーバーを短時間使います。ローカルの Unix ソケットだけのチェックでは、別コンテナーに対して早すぎる準備完了となる場合があります。pg_isready はサーバーが接続を受け付けるかを報告しますが、認証情報やカタログ内容の正しさは証明しません。
次の読み取り専用プローブは、意図的に間違った TCP ポートを使います。exec は db 内でプローブを実行し、-T はターミナル割り当てを無効にします。-h はアドレス、-p はポート、-U/-d は提供ユーザー/データベースを指定します。ポート 6543 にはサーバーがないため、no response とネイティブの終了ステータス 2 が想定されます。
docker compose -p archive exec -T db pg_isready -h 127.0.0.1 -p 6543 -U archivist -d archive
これはプローブの失敗であり、カタログデータの消失ではありません。最終データベースは通常の TCP ポート 5432 で待ち受けます。ヘルスチェックはその実サービスを対象とする必要があります。
準備状態を表し、新しいデータで起動する
アプリケーション設定と提供ファイルは変更しません。実際の healthcheck を db に追加し、importer のデータベース条件を service_started から service_healthy に変更します。test は Docker がデータベースコンテナー内で実行するコマンドです。JSON 風の配列は CMD を使い、シェルを介さず指定プログラムを直接実行します。-h 127.0.0.1 は最終 TCP リスナーを選び、既定ポートは 5432 です。interval: 1s、timeout: 2s、retries: 40 は時間制限付きのプローブを繰り返す指定であり、準備できたことにする固定待機ではありません。
catalog の service_completed_successfully 条件は維持します。成功した一度きりのインポートは 0 で終了し、Running のままである必要はありません。失敗したら catalog を阻止する必要があります。welcome ページはインポートされたデータを必要としないため、インポートへの依存はありません。
以下のリテラルなヒアドキュメントで構成全体を書き、インデントを再現します。cat が行を供給し、> は compose.yaml だけを置き換えます。引用した COMPOSE マーカーは終了行までのシェル展開を防ぎます。その他すべてのアプリケーション設定は維持しています。
cat > compose.yaml <<'COMPOSE'
services:
  db:
    image: dk04-postgres:16
    environment:
      POSTGRES_USER: archivist
      POSTGRES_PASSWORD: training-archive
      POSTGRES_DB: archive
      TRAINING_DB_DELAY: "8"
    volumes:
      - data:/var/lib/postgresql/data
      - ./scenario/slow-init.sh:/docker-entrypoint-initdb.d/10-training-delay.sh:ro
    healthcheck:
      test: ["CMD", "pg_isready", "-h", "127.0.0.1", "-U", "archivist", "-d", "archive"]
      interval: 1s
      timeout: 2s
      retries: 40
  importer:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/importer.py"]
    environment:
      PGHOST: db
      PGUSER: archivist
      PGPASSWORD: training-archive
      PGDATABASE: archive
      TRAINING_IMPORT_DELAY: "6"
    volumes:
      - ./scenario:/scenario:ro
    depends_on:
      db:
        condition: service_healthy
  catalog:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/archive.py", "catalog"]
    environment:
      PGHOST: db
      PGUSER: archivist
      PGPASSWORD: training-archive
      PGDATABASE: archive
      ARCHIVE_TITLE: "The Common Archive"
    ports:
      - "8090:8080"
    depends_on:
      importer:
        condition: service_completed_successfully
  welcome:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/archive.py", "notes"]
    environment:
      ARCHIVE_TITLE: "The Common Archive"
    ports:
      - "8091:8080"
volumes:
  data:
    labels:
      labex.course: dk04
COMPOSE
実行時の資源を変える前に構成を解析します。
docker compose -p archive config
YAML が失敗したら、報告された行を読み、表示したブロックをスペースで復元して再解析します。不正なファイルのまま再起動を繰り返さないでください。
空のコース用データストアで初回起動を試します。これは使い捨ての学習用データベースだけを意図的に削除し、ソース CSV や参照アーカイブは削除しません。まず実際のボリュームラベルを調べます。
docker volume inspect archive_data --format '{{json .Labels}}'
com.docker.compose.project が archive、labex.course が dk04 であることを確認します。どちらかが違えば、別の資源を削除せず、そこで止めてプロジェクトを調べます。down --volumes はこの名前の Compose プロジェクトのコンテナー、ネットワーク、宣言されたデータボリュームだけを削除します。
docker compose -p archive down --volumes
up -d はバックグラウンドで起動します。--pull never は準備済みイメージを使い、--no-build は新しいビルドでの置き換えを防ぎます。
docker compose -p archive up -d --pull never --no-build
docker compose -p archive ps -a
docker compose -p archive logs importer
healthy なデータベース、Exited 0 の importer、Running の catalog と案内ページが想定されます。提供された初回起動遅延とインポート遅延は、明示的に学習用です。Compose ファイルの固定 sleep は、実際の準備完了やインポート成功の代わりにはなりません。以前の試行で失敗コンテナーが残っていれば、ログを調べて構成を修正し、コース用ボリュームのラベルを確認して、この範囲を限定した新規データ起動を繰り返します。
完成したカタログを使う
Your Archive に切り替えて再読み込みします。Market morning を検索すると、異なる ID、年、カテゴリー、物語を持つ 2 件が出るはずです。それぞれを開き、Download transcript を使い、Back to collection で戻ります。Ferry を検索して Ferry voices を開き、書き起こしをダウンロードします。検索を消して全 4 件を表示します。The shared garden とそのダウンロードも調べます。不明な記録の URL には、接続失敗やカタログ利用不能とは異なる Record not found が表示されるはずです。
Collection Notes に切り替えます。独立した案内ページは利用できる必要があります。Reference Archive も元の完全なコレクションを提供し続ける必要があります。完成したアーカイブは動かしたままにします。チェックはまず稼働中のデータベース、完了したインポート、完全な業務結果を観察します。次に、明示された別の学習遅延と不正なインポートサンプルを使い、変更していないヘルス/依存条件を別の使い捨て新規データストアで実行します。これらの fixture は稼働中のアーカイブを初期化・修復しません。別の隔離テストでは、データベースサーバーがない状態で未変更のヘルスコマンドを実行します。利用不能な接続先を拒否する必要があります。
まとめ
データベースコンテナーの起動と最終的な TCP の準備完了を区別し、実際のヘルスチェックを構成して、インポーターがそれを待つようにしました。新しいデータストアは、それを使うサービスが開く前に完全なカタログを受け取り、独立した案内ページも利用できるままでした。