はじめに
The Riverside Archive は PostgreSQL に接続できますが、一度きりのインポートが完了する前にカタログの Web サイトが起動してしまいます。不足する業務上の依存関係を追加しましょう。カタログはインポート成功後にだけ開き、入力が不正なら未起動のままである必要があります。
先に Wait for the Archive Database を完了するか、そこで扱う YAML、ヘルスチェック、Compose プロジェクト、ログ、範囲を限定した新規データでの再起動を理解している必要があります。SQL やアプリケーションプログラミングは不要です。この実験は独立したデータベース、ソースデータ、参照用環境を準備するため、前の VM のファイルは不要です。初期データベースには、最終 TCP を対象とする正しいヘルスチェックがすでにあります。
Workstation、Reference Archive、Your Archive、Collection Notes を使います。記録は合成です。明示した遅延は学習用の状態を見せるためのもので、結果を決めるのは実際の準備完了とインポートの終了ステータスです。読む時間とよくある間違いへの対処を含めて約 45 分を見込んでください。作者による見積もりです。
インポート成功後にだけ開く
このステップではカタログの起動条件をインポート完了にし、実際の失敗が起動を阻止することを証明し、元の入力で回復します。
データベースと業務データの準備状態を比べる
Reference Archive から始めます。Market morning を検索して一致する両記録を開き、それぞれ異なる書き起こしをダウンロードします。Back to collection で戻り、Ferry voices を調べます。Your Archive は利用不能ですが、Collection Notes はインポート済みの行を読まずにコレクションを説明できます。
Workstation に切り替え、/home/labex/project/archive-opening から始めます。
cd /home/labex/project/archive-opening
cat compose.yaml
docker compose -p archive ps -a
docker compose -p archive logs importer catalog
データベースは healthy になり、importer は実際の仕事を終えます。しかし catalog は早すぎるタイミングでテーブルを読もうとして、relation "entries" does not exist などのエラーで終了しました。データベースが接続を受け付けても、アプリケーションデータが存在するとは限りません。Web サイトには意図的に隠れた起動再試行がないため、依存関係でこの要件を表す必要があります。
この環境は前のガイド付き実験と同じ 4 つの役割とポートの関係を使います。db には TCP ヘルスチェックがあり、importer は service_healthy を待ちます。残る問題は catalog.depends_on.importer.condition: service_started です。この条件では、明示された 6 秒の学習遅延と実際のトランザクションがまだ先にあるのに、インポートプロセスの開始直後から catalog の起動を許します。
実際にデータを使うサービスの起動条件を設定する
この条件を service_completed_successfully に置き換えます。これはプロセスが終わっただけでなく、成功して完了したことを確認します。非ゼロのインポートステータスは catalog を阻止する必要があります。一度きりの importer が Exited 0 なのは正しく、Running に保ったり、無限の再起動ポリシーを付けたりすべきではありません。静的な案内にインポート済みテーブルは不要なので、welcome は独立させます。
以下の完全なリテラルのヒアドキュメントは、提供された全設定と既存のデータベースのヘルスチェックを維持します。前の実験と同様、> は compose.yaml だけを置き換え、引用マーカーは内容をそのまま保ちます。
cat > compose.yaml <<'COMPOSE'
services:
  db:
    image: dk04-postgres:16
    environment:
      POSTGRES_USER: archivist
      POSTGRES_PASSWORD: training-archive
      POSTGRES_DB: archive
      TRAINING_DB_DELAY: "8"
    volumes:
      - data:/var/lib/postgresql/data
      - ./scenario/slow-init.sh:/docker-entrypoint-initdb.d/10-training-delay.sh:ro
    healthcheck:
      test: ["CMD", "pg_isready", "-h", "127.0.0.1", "-U", "archivist", "-d", "archive"]
      interval: 1s
      timeout: 2s
      retries: 40
  importer:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/importer.py"]
    environment:
      PGHOST: db
      PGUSER: archivist
      PGPASSWORD: training-archive
      PGDATABASE: archive
      TRAINING_IMPORT_DELAY: "6"
    volumes:
      - ./scenario:/scenario:ro
    depends_on:
      db:
        condition: service_healthy
  catalog:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/archive.py", "catalog"]
    environment:
      PGHOST: db
      PGUSER: archivist
      PGPASSWORD: training-archive
      PGDATABASE: archive
      ARCHIVE_TITLE: "The Riverside Archive"
    ports:
      - "8090:8080"
    depends_on:
      importer:
        condition: service_completed_successfully
  welcome:
    image: dk04-archive:1
    entrypoint: ["python3", "-B", "/app/archive.py", "notes"]
    environment:
      ARCHIVE_TITLE: "The Riverside Archive"
    ports:
      - "8091:8080"
volumes:
  data:
    labels:
      labex.course: dk04
COMPOSE
docker compose -p archive config
解析が失敗したら、サービスを起動する前に、表示したブロックを使って報告されたインデントを直します。提供アプリケーション、インポーター、CSV、認証、ポートは変更しません。
インポート失敗でカタログが開かないことを証明する
compose.bad.yaml は、インポーターを別の不正な CSV に向ける提供済みの上書きファイルです。その記録 ID には、実際の PostgreSQL テーブルが整数を要求する場所にテキストが入っています。importer は実際のトランザクションを使い、データベースの非ゼロのステータスを伝えます。成功したふりはしません。元の正しい scenario はそのままです。
まず学習者用ボリュームを調べ、前に学んだプロジェクト/コースのラベルを確認します。
docker volume inspect archive_data --format '{{json .Labels}}'
com.docker.compose.project: archive と labex.course: dk04 が想定されます。次のコマンドは、このプロジェクトの使い捨て学習データだけを意図的に削除します。不正入力のテストで以前にインポートしたテーブルを借りないためです。
docker compose -p archive down --volumes
2 つの -f 引数は、通常の構成と提供された上書きをこの順でマージします。次の起動は、importer が非ゼロで終了するため、ネイティブステータス 1 で意図的に失敗する想定です。
docker compose -f compose.yaml -f compose.bad.yaml -p archive up -d --pull never --no-build
docker compose -f compose.yaml -f compose.bad.yaml -p archive ps -a
docker compose -f compose.yaml -f compose.bad.yaml -p archive logs importer
不正な整数のエラーを読みます。データベースは healthy のままでも、importer は非ゼロのコードで Exited となり、catalog は Created で一度も起動されないはずです。welcome は動き続けます。catalog が起動してからクラッシュするのは別の結果です。その場合、失敗したインポートの利用が許されてしまっています。
Your Archive に切り替えて再読み込みします。カタログは利用できないはずです。Collection Notes に切り替えると、独立したページは動きます。これは実際のサービス状態であり、演出された成功表示ではありません。
正しい入力で回復し、記録を使う
Workstation に切り替えます。片付ける前に、同じコース用ボリュームのラベルを再確認します。
docker volume inspect archive_data --format '{{json .Labels}}'
docker compose -f compose.yaml -f compose.bad.yaml -p archive down --volumes
上書きなしで起動し、元の正しい入力に戻します。この新しいデータストアは最初からインポートする必要があります。
docker compose -p archive up -d --pull never --no-build
docker compose -p archive ps -a
docker compose -p archive logs importer
データベースは Healthy、importer は Exited 0、両 Web の役割は Running になる想定です。通常のパス不足や YAML の間違いでは、指定の作業ディレクトリに戻り、compose config またはサービスログを読み、編集可能な構成を直して、このコースの範囲内の再起動だけを繰り返します。問題を隠すためにソース行を編集したり、エラーを抑制したり、VM をリセットしたりしないでください。
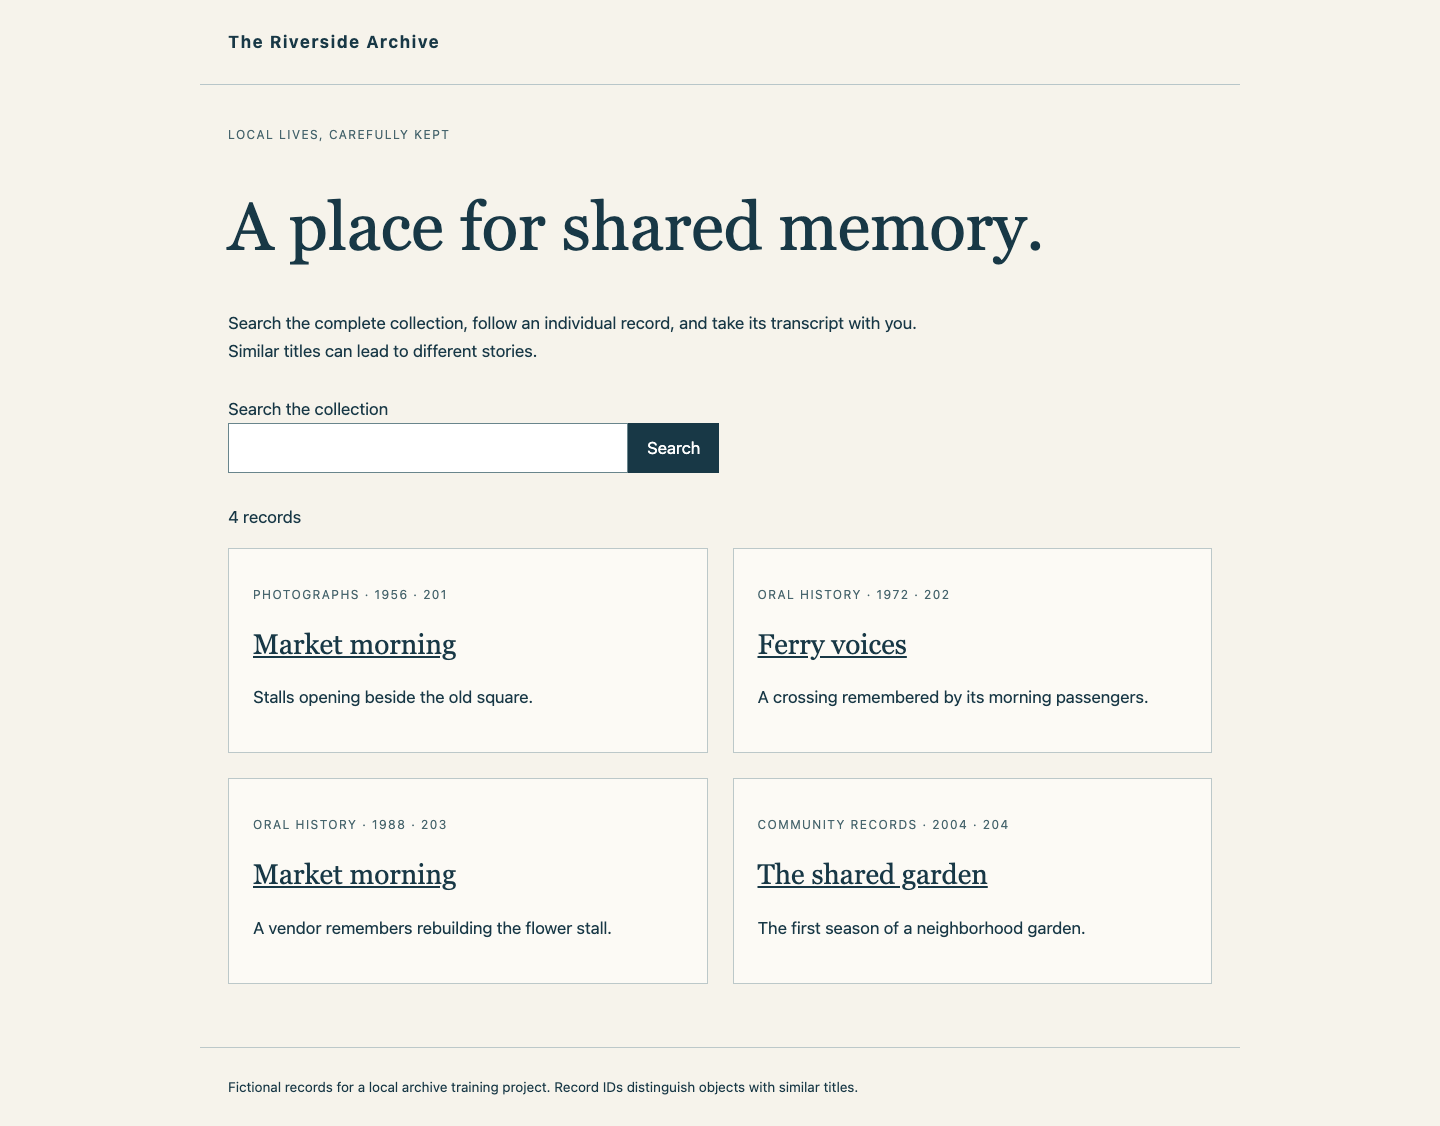
Your Archive に切り替えて再読み込みします。Market morning を検索すると、異なる ID、年、カテゴリー、物語を持つ 2 件が出るはずです。それぞれを開き、Download transcript を使い、Back to collection で戻ります。Ferry を検索して Ferry voices を開き、書き起こしをダウンロードします。検索を消して全 4 件を表示します。The shared garden とそのダウンロードも調べます。不明な記録 URL には、接続失敗やカタログ利用不能とは異なる Record not found が表示されるはずです。
完成したカタログは、異なる 2 件の Market morning を含む 4 件すべての識別情報を保持します。
Collection Notes に切り替えます。独立した案内ページは利用できる必要があります。Reference Archive も元の完全なコレクションを提供し続ける必要があります。完成したアーカイブは動かしたままにします。チェックはまず稼働中のデータベース、完了したインポート、完全な業務結果を観察します。次に、明示された別の学習遅延と不正なインポートサンプルを使い、未変更のヘルス/依存条件を別の使い捨て新規データストアで実行します。これらの fixture は稼働中のアーカイブを初期化・修復しません。別の隔離テストでは、データベースサーバーがない状態で未変更のヘルスコマンドを実行します。利用不能な接続先を拒否する必要があります。
まとめ
利用可能なデータベースと、正常に作成されたカタログを区別しました。利用側は importer の終了ステータス 0 を待ち、実際のインポート失敗後は未起動のままになり、正しい入力を復元すると完全な新しいカタログを開きます。独立した案内ページはその間も使えます。