はじめに
Riverside のコレクションには、6 つの HTML 口述史文書の検索可能なインデックスが必要です。提供コンテナーツールは実際に HTML を解析して Unicode の単語を数えますが、4 ワーカーのバッチは 160 MiB のメモリ枠を超えます。正確なコンテナーに結び付いた証拠で失敗を診断し、制限を上げたり文書を除いたりせずに完全なインデックスを作ってください。
基本的な Docker run、ターミナルのパス、バインドマウントの目的を知っていることを前提とします。この実験ではメモリオプション、実際のユーザー ID、引用したパス、コマンド置換、証拠を読む小さなパイプラインを使用前に説明します。Python プログラミング、HTML の作成、検索アルゴリズムの実装は不要です。Docker、インデックス作成イメージ、読み取り専用の Search Desk は準備済みです。
この文書群は明示的に合成です。各文書は、実際のパーサーによるメモリ負荷を観察できるよう、展開した学習用抜粋を 10,000 個含みます。結果はそれらのバイトに対する実際のインデックスであり、メモリ割り当てのシミュレーションや本番容量の保証ではありません。読む時間とよくある間違いへの対処を含め、約 60 分を見込んでください。作者による見積もりです。
メモリ枠内で完全なインデックスを作る
このステップでは正常な検索結果を確認し、メモリ制限による失敗を再現し、ネイティブな証拠を結び付け、バッチを制限して全コレクションを完成させます。
まず小さな正常なインデックスを使う
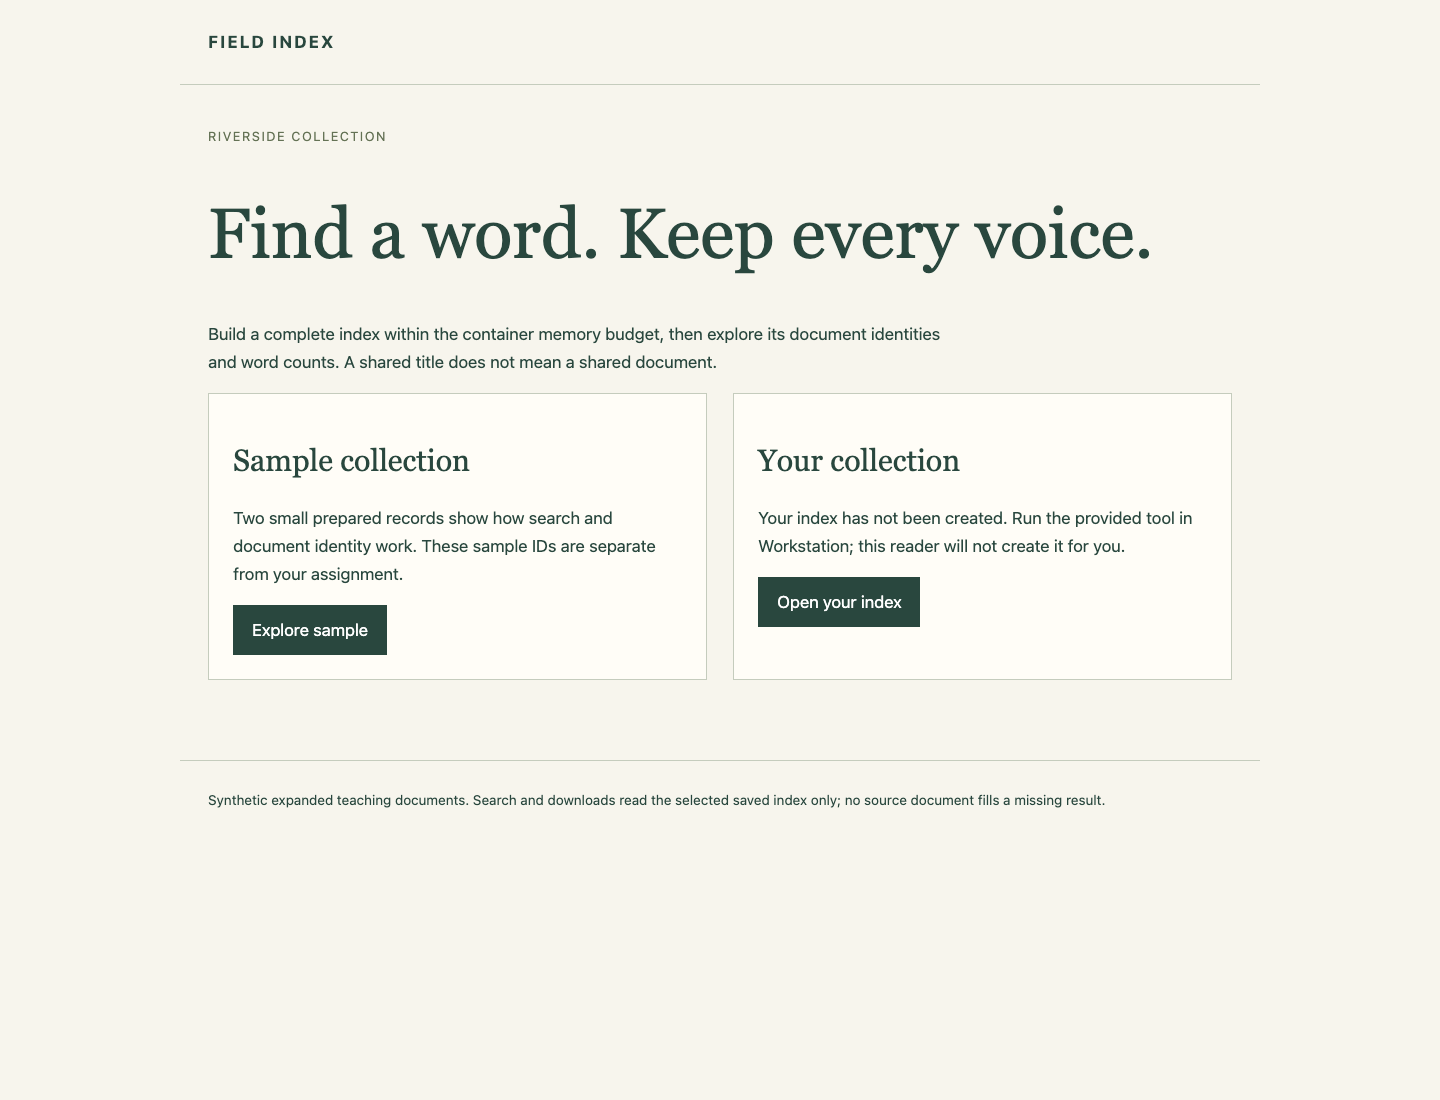
Search Desk から始め、Explore sample を選びます。この別途準備されたサンプルには小さな文書が 2 つあります。Search one word と Search で café を検索します。両記録のタイトルは Riverside memories ですが、sample-oral- で始まる別々の ID を持ちます。それぞれを開いてソースハッシュと選ばれた単語の出現回数を調べ、Back to collection を使います。Download index で実際のサンプル JSON ファイルを調べ、Back to Search Desk で戻ります。
2 つのパネルは準備済みサンプルと割り当てられたコレクションを分けています。自分のインデックスは最初は利用不能です。
転置インデックスは、単語を文書 ID と出現回数に結び付けます。documents メタデータには各 ID、タイトル、元のバイトの指紋であるソース SHA-256 が記録されます。同じタイトルの 2 件を 1 つの識別情報にまとめてはいけません。閲覧サービスは選択した保存済みインデックスだけを使い、未完成の作業をソース HTML から補いません。
Open your index を選びます。現在は HTTP 503 で Collection not indexed と表示されます。小さなサンプルは自分の 6 文書の結果ではありません。
パスとメモリ境界を理解する
Workstation に切り替え、/home/labex/project/collection-index から始めます。cd はそこへ戻り、ls はファイルを一覧にします。
cd /home/labex/project/collection-index
ls source output
source/ には元の HTML が 6 ファイルあります。output/ は書き込み可能な配布用ディレクトリです。元ファイル、準備済みイメージ dk06-indexer:1、別のサンプル閲覧サービスは維持します。作成するのはこのコースのコンテナーとインデックス出力だけです。
イメージの entrypoint はすでにインデックス作成プログラムを実行します。イメージ名の後の --source /input、--output /output/attempt.json、--workers 4 はプログラム引数で、Docker のフラグではありません。ワーカーは実際の HTML を文書ツリーに解析します。バッチは単語を抽出する間、選んだツリーを保持し、その後解放します。ワーカーを増やすとメモリが多く必要な場合があり、速度向上の約束ではありません。
イメージ名の前の Docker オプションで動作の境界を設定します。
| オプション | ここでの意味 |
|---|---|
--name |
ネイティブな調査のために明確な名前でコンテナーを保持する |
--memory 160m |
160 MiB の RAM 枠を適用する |
--memory-swap 160m |
RAM と swap の合計を同じ量にし、追加の swap 枠をなくす |
--network none |
このファイル処理ジョブにネットワークは不要 |
--user |
実際の通常アカウントとして出力を書く |
2 つの --mount オプション |
元の入力を読み取り専用にし、別の出力フォルダーに書く |
id -u と id -g は実際の数値ユーザー/グループ ID を表示します。1000 と仮定しないでください。$(...) はコマンドの出力をこのコマンドへ置換します。ダブルクォートは、ユーザー/グループの組と各マウント値全体を 1 引数に保ちつつ、現在のディレクトリ $PWD の展開を許します。末尾のバックスラッシュは、次の物理行を同じコマンドにつなぎます。
ホストの入力 source/ はコンテナー内で /input、ホストの output/ は /output になります。readonly はそのマウント経由の入力を保護します。ソースに書き込める別名マウントを追加しないでください。両メモリオプションを保ち、OOM killer の無効化やプラットフォーム設定の変更はしません。
失敗を再現し、原因を対象に結び付ける
提供された 4 ワーカーの試行を実行します。これはインデックス完成前にネイティブステータス 137 で意図的に終了する想定です。
docker run --name index-attempt \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/attempt.json --workers 4
停止前は最初の Parsing batch 行だけが見えるかもしれません。停止コンテナーを保持します。識別情報と有効な設定が重要なので、--rm はありません。
docker inspect はネイティブなコンテナーフィールドを読みます。シングルクォートは各小さな format テンプレートをそのまま保ちます。まず終了コードと Docker の OOM フラグ、次に両制限をバイト単位で読みます。
docker inspect index-attempt --format '{{.State.ExitCode}} {{.State.OOMKilled}}'
docker inspect index-attempt --format '{{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}'
docker logs index-attempt
設定された制限値は両方とも 167772160、つまり 160 × 1024 × 1024 バイトです。終了 137 だけでは、このメモリ失敗と強制 kill を区別できません。Docker の OOMKilled フラグは記録すべきですが、この実験で検証した Engine では、カーネルが本当の memory-cgroup kill を報告していても false のままの場合があります。いずれかのフィールドだけで説明せず、実際のカーネル証拠を照合してください。
完全なコンテナー ID をシェル変数に読みます。代入では = の前後にスペースを入れません。コマンド置換は inspect の結果を取得します。
container_id=$(docker inspect --format '{{.Id}}' index-attempt)
変数はこの Workstation シェルに属します。ブラウザーのタブを切り替えても変わりませんが、新しいシェルを開いたら代入を繰り返します。sudo dmesg は保護されたカーネルログを消去せずに読みます。パイプ | はその出力を grep に渡します。-F は正確な ID を通常の文字列として含む行を選び、引用はその値を 1 引数に保ちます。
sudo dmesg | grep -F "$container_id"
CONSTRAINT_MEMCG と、この完全な Docker コンテナー ID を指定する oom_memcg パスを含む行を見つけてください。これは無関係なプロセスやプラットフォーム全体の不足ではなく、このコンテナーのメモリ制御グループにおけるメモリ不足の処置を示します。停止した試行とその実際の制限と比較します。偽ログを作ったり、手動で kill したプロセスでこの試行を置き換えたりしないでください。
バッチを減らし、仕事全体は保つ
メモリ枠は固定です。バッチを 1 ワーカーに減らすと、同じ単語集計アルゴリズムと全 6 文書を維持しながら、実際に解析した文書ツリーを一度に 1 つだけ保持できます。これはこの文書群で実行可能な選択であり、1 ワーカーが常に最適という意味ではありません。同じ制限下で完全なジョブが実際に終わるなら、ほかの実行可能なワーカー値も受け入れられます。
別の保持される配布コンテナーを作ります。両マウント、準備済み entrypoint、メモリオプションを維持し、出力ファイル名とワーカー数を変えます。
docker run --name index-delivery \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/index.json --workers 1
すべてのバッチに続き Indexed 6 documents and ... terms が出て、正常な終了ステータス 0 になる想定です。語の総数は観察であり、それだけでは証明になりません。
docker inspect index-delivery --format '{{.State.ExitCode}}'
ls -l output/index.json
出力は通常ユーザー/グループが所有し、コンテナー終了後も編集できます。両停止コンテナーを保持します。入力パスを誤記した場合、Docker は処理前にバインド元不足を報告します。指定の作業ディレクトリに戻り、ls source output で調べ、引用パスを直して繰り返します。間違いを隠すための代用入力は作りません。
実際に配布したインデックスを使う
Search Desk に切り替え、必要なら Back to Search Desk、次に Open your index を選びます。サンプルの 2 ID ではなく、6 つの文書が表示される必要があります。café を検索すると、全 6 文書がそれぞれ 10,000 回の出現で表示されるはずです。別々の oral-0 と oral-1 ID を使い、両 Riverside memories を開きます。ソースハッシュと単語の関係は別々に保たれる必要があります。
配布コレクションは、同じタイトルの両記録を含め、元の全 6 ID を持ちます。
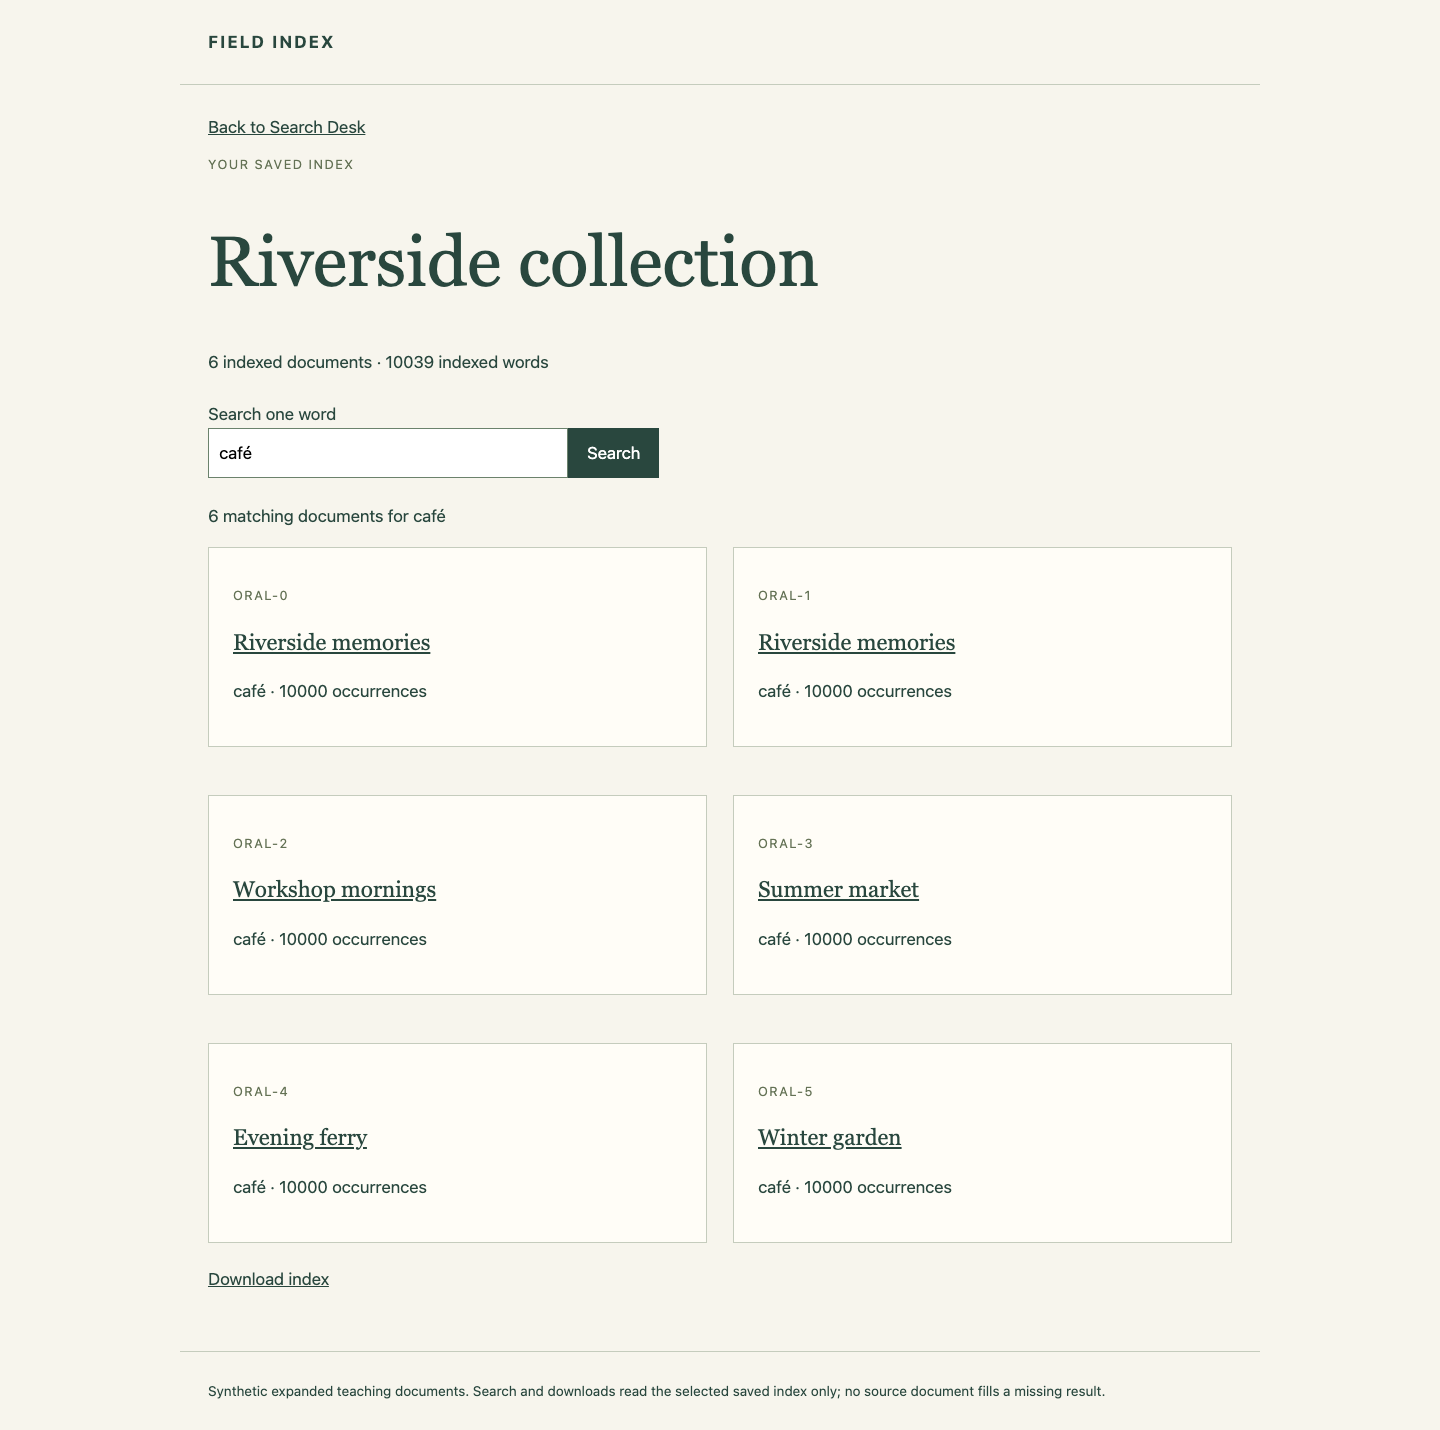
Back to collection で戻り、résumé、続いて naïve を検索し、全 6 件が実際の回数で検索できることを確認します。notawordinthiscollection を検索すると、一致する文書はないはずです。Download index で実際の配布 JSON を調べます。documents、ソースハッシュ、postings は元の全入力に対応します。閲覧サービスは不足する結果を再生成しません。
チェックは、この実行の正確な memory-cgroup イベントとコンテナーを結び付け、成功した配布の有効なメモリ枠とマウントを調べ、元 HTML の全バイトを独立してストリーム処理し、Unicode のすべての単語/文書の回数を確認します。実際のジョブの再実行や、代わりにインデックスを書くことはしません。
失敗した配布だけから回復する
配布の試行もメモリ不足になったら、停止状態とログを調べ、実行可能なバッチを選び、失敗した index-delivery コンテナーだけを docker rm index-delivery で削除してから、表示した配布コマンドを再試行します。証拠として index-attempt と元の全 HTML を保持します。成功した再実行は自分の出力を完全なインデックスで上書きします。回数の手編集や、小さなサンプルの配布先へのコピーはしないでください。
まとめ
実際の memory-cgroup OOM の処置を正確なコンテナーと有効な制限に結び付け、実際の HTML バッチの並列数を減らし、同じ 160 MiB の枠内で完全なインデックスを完成しました。保存したインデックスは、全 6 件の識別情報、重複タイトル、元のソースハッシュ、Unicode の単語回数を保持し、コンテナー終了後も利用できます。