はじめに
通知音には、短い休止を挟んだ 2 つの異なる音を使えます。小さな C 関数からそのパターンを組み立て、線形フェードで各音の始まりと終わりを緩やかにします。実際の WAV ができ、調査、再生、ダウンロードが可能になります。
先に Turn a Loop into a Tone を終えるか、その正弦波サンプリングループ、16 kHz モノラル PCM、整数変換、コンパイル、出力リダイレクトを理解しておいてください。この環境は独立しており、書き込み処理、呼び出し元、ブラウザは改めて用意されます。以前のラボのファイルやプロセスは必要ありません。50 分は、読解や通常のミスを含めた作者の目安です。
3 つの区間を順番に並べる
このステップでは、フェードを追加する前に、動作する 2 音のパターンを組み立てます。Terminal から始めます。作業ディレクトリを間違えた場合は、絶対パスで戻れます。
cd /home/labex/project/sound-studio
最初の合図音は 440 Hz が 300 ミリ秒、ゼロ値の無音が 150 ミリ秒、その後に 660 Hz が 400 ミリ秒です。順番も成果の一部です。毎秒 16,000 サンプルでは、各区間は 4,800、2,400、6,400 サンプルで、合計 13,600 サンプル、0.850 秒になります。
休止には実際のゼロが必要です。休止の書き込みを省くと WAV が短くなり、ヘッダーの時間フィールドだけ変えても不足サンプルは増えません。提供された main.c は合図音全体に対するヘッダーを 1 回書き、write_cue を呼びます。自作関数は同じデータストリームに PCM サンプルだけを追加します。区間ごとに新しいヘッダーを書かないでください。
関数宣言と初期コードを読みます。
cat cue.h cue.c
write_tone には前のラボの通常の正弦波ループが入っています。追加の fade_ms はステップ 2 でフェードを制御します。最初の版では (void)fade_ms によって未使用を明示し、警告を防いでいます。これ自体はサンプルを生成しません。残りの 2 関数は未完成です。空の処理を実際の組み立てと無音生成に置き換えます。
write_tone の各呼び出しには、ゼロから始まる独自のローカル i があります。そのため時間 seconds = (double)i / rate と正弦波の角度は区間ごとに再開します。2 番目の 660 Hz の音は、最初の音のインデックスを誤用せず、自分のローカル時計を使います。無音ループもゼロから始まり、サンプルごとに wav_sample(0) を 1 回呼びます。
前と同じく、sin はラジアンを受け取り、1 周期は 2 * pi、出力は -1 から 1 です。振幅を掛けてから (int) で変換すると、範囲内の整数サンプルになります。提供された pcm.c は整数を符号付き 16 ビットのモノラル PCM に封入するだけで、欠けた音や休止を補いません。main.c、cue.h、pcm.c、pcm.h、inspect_wav.py、audio.py は変更しません。実装するのは cue.c だけです。
最初の完全な版を書きます。引用した here-document が最終の C 行まで C テキストをそのまま保ち、> は cue.c だけを置き換えます。
cat > cue.c <<'C'
#include <math.h>
#include "cue.h"
#include "pcm.h"

void write_tone(int frequency, int milliseconds, int fade_ms, int amplitude) {
    const int rate = 16000;
    const double pi = 3.14159265358979323846;
    int count = rate * milliseconds / 1000;
    (void)fade_ms;
    for (int i = 0; i < count; i++) {
        double seconds = (double)i / rate;
        double phase = 2.0 * pi * frequency * seconds;
        wav_sample((int)(amplitude * sin(phase)));
    }
}
void write_silence(int milliseconds) {
    int count = 16000 * milliseconds / 1000;
    for (int i = 0; i < count; i++) {
        wav_sample(0);
    }
}
void write_cue(int first_frequency, int first_ms, int gap_ms,
               int second_frequency, int second_ms, int fade_ms, int amplitude) {
    write_tone(first_frequency, first_ms, fade_ms, amplitude);
    write_silence(gap_ms);
    write_tone(second_frequency, second_ms, fade_ms, amplitude);
}
C
提供された呼び出し元と書き込み処理と一緒にコンパイルします。C11、警告、出力名、最後の数学ライブラリの役割は最初のガイド付きラボと同じです。成功時には警告もエラーも出ないはずです。
gcc -std=c11 -Wall -Wextra main.c cue.c pcm.c -lm -o cue
実行ファイルは 7 引数を次の順で受け取ります。
| 引数 | 単位と両端を含む範囲 |
|---|---|
| 最初の周波数 | 整数 Hz、200–1200 |
| 最初の音の長さ | 整数ミリ秒、100–1000 |
| 休止の長さ | 整数ミリ秒、50–500 |
| 2 番目の周波数 | 整数 Hz、200–1200 |
| 2 番目の音の長さ | 整数ミリ秒、100–1000 |
| 各端のフェード長 | 整数ミリ秒、5–50 |
| フェード前の振幅 | 整数サンプル単位、1000–12000 |
全パラメータはヘッダーを 1 バイトでも書く前に解析されます。最初の版はフェード引数を受け入れますが、意図的に無視します。ステップ 2 で実装します。20 ms のフェードと振幅 10,000 を指定して通常のパターンを生成し、この最初のフェードなし結果を別に保存します。
./cue 440 300 150 660 400 20 10000 > outputs/plain-cue.wav
python3 inspect_wav.py outputs/plain-cue.wav
Frames: 13600、Duration: 0.850 s、Peak: 10000 を確認します。完全なヘッダーだけではサンプルの音順や無音を証明できないため、チェックは実データも分析します。
Sound Studio に切り替えます。Refresh files をクリックし、plain-cue.wav を選んで Load sound をクリックします。選択と Ready to play が同じファイルを示すことを確認します。再生、一時停止を行い、Playback position で位置を移動します。Tab でスライダーにフォーカスし、Home、End、矢印キーを使います。最初の音が 2 番目より低く、間に明確な休止があるはずです。このフェードなし版では開始や終了が急でも想定どおりです。Download WAV で実際のファイルを保存します。
Terminal に戻ります。plain-cue.wav、cue.c、現在の cue 実行ファイルを残します。最初のチェックはこの完全な通常版と、後で完成するフェード版のどちらも認めるため、ステップ 2 に進んでも前の再チェックは無効になりません。提出する実行ファイルと再構築したソースは、各条件で同じ許可済み動作を実装する必要があります。古いフェードなし実行ファイルとフェードありソースの組み合わせでは不十分です。保存した plain-cue.wav は常にフェードなしの比較用です。後のチェックはフェードを厳密に要求します。
チェックは保存済みファイルを必要とし、提出済み実行ファイルを試し、変更しないソースを他の対応パラメータで使い捨てディレクトリ内で再構築します。不足する作業は作りません。コンパイルに失敗したら、報告された行を直すかソースブロック全体を再入力して、再コンパイルしてから再実行してください。古い実行ファイルには編集が反映されていません。
各音の両端にフェードを付ける
このステップでは、徐々に変化するゲインで正弦サンプルを拡大縮小します。Terminal の /home/labex/project/sound-studio から始めます。
ゲインは倍率です。0.0 はサンプルを無音にし、0.5 は振幅を半分にし、1.0 は変えません。線形フェードはサンプルごとに同じ量だけゲインを変えます。このレートで 20 ミリ秒は 16000 * 20 / 1000 = 320 フェードサンプルです。最初の傾斜ではローカルインデックス 0、80、160、240、320 のゲインは 0、0.25、0.5、0.75、1 になります。
フェードは各音のローカルな処理でなければなりません。2 番目の音でもゼロから始め、合図音全体を 1 つのフェードで覆わないでください。count サンプルの音の最終インデックスは count - 1 です。そのため count - 1 - i は終わりまで残るサンプル位置の数です。この距離を fade で割ると下降する傾斜が得られ、最後のサンプルで正確にゼロになります。
小数の除算を使います。(double)i / fade は分数を保ちます。整数除算だと最初の傾斜のほぼ全体がゼロになります。範囲制限により、正のフェード長と両端の傾斜が入る余地が保証されます。最短の 100 ms の音に最長の 50 ms フェードを使っても有効です。この場合、最大音量が続く平坦部はなく、2 つの離散的傾斜が中央付近で出会います。振幅はフェード前の上限であり、各区間に必ずそのピークに一致するサンプルがあるとは限りません。
cue.c を完全なフェード版に置き換えます。順番と無音の関数は同じで、音サンプルだけにゲインを加えます。2 つの if 文が最初と最後の傾斜を選び、間ではゲイン 1 を保ちます。整数変換前に、ゲインを正弦値へ掛けます。
cat > cue.c <<'C'
#include <math.h>
#include "cue.h"
#include "pcm.h"

void write_tone(int frequency, int milliseconds, int fade_ms, int amplitude) {
    const int rate = 16000;
    const double pi = 3.14159265358979323846;
    int count = rate * milliseconds / 1000;
    int fade = rate * fade_ms / 1000;
    for (int i = 0; i < count; i++) {
        double gain = 1.0;
        if (i < fade) {
            gain = (double)i / fade;
        }
        if (count - 1 - i < fade) {
            gain = (double)(count - 1 - i) / fade;
        }
        double seconds = (double)i / rate;
        double phase = 2.0 * pi * frequency * seconds;
        wav_sample((int)(amplitude * gain * sin(phase)));
    }
}
void write_silence(int milliseconds) {
    int count = 16000 * milliseconds / 1000;
    for (int i = 0; i < count; i++) {
        wav_sample(0);
    }
}
void write_cue(int first_frequency, int first_ms, int gap_ms,
               int second_frequency, int second_ms, int fade_ms, int amplitude) {
    write_tone(first_frequency, first_ms, fade_ms, amplitude);
    write_silence(gap_ms);
    write_tone(second_frequency, second_ms, fade_ms, amplitude);
}
C
再コンパイルし、フェード版を新しい名前に保存します。比較用の plain-cue.wav は残します。
gcc -std=c11 -Wall -Wextra main.c cue.c pcm.c -lm -o cue
./cue 440 300 150 660 400 20 10000 > outputs/cue.wav
python3 inspect_wav.py outputs/cue.wav
結果は引き続き 13,600 フレーム、0.850 秒です。フェードはサンプル値を変えますが、区間の長さは変えません。休止は正確に 2,400 個のゼロサンプルのままです。この条件では最初の音はインデックス 0–4,799、休止は 4,800–7,199、2 番目の音は 7,200–13,599 にあります。2 つの音関数は、ファイル全体の位置とは独立した、ゼロから始まるローカルインデックスを使います。
Sound Studio に切り替え、更新して cue.wav を読み込み再生します。plain-cue.wav と比べます。順番、高さ、休止は同じですが、フェード付きの音は緩やかに始まり、終わります。新しい結果で Pause、位置スライダー、Download WAV を使います。プレーヤーは保存済み WAV を直接読むため、欠けた休止やフェードを補えません。
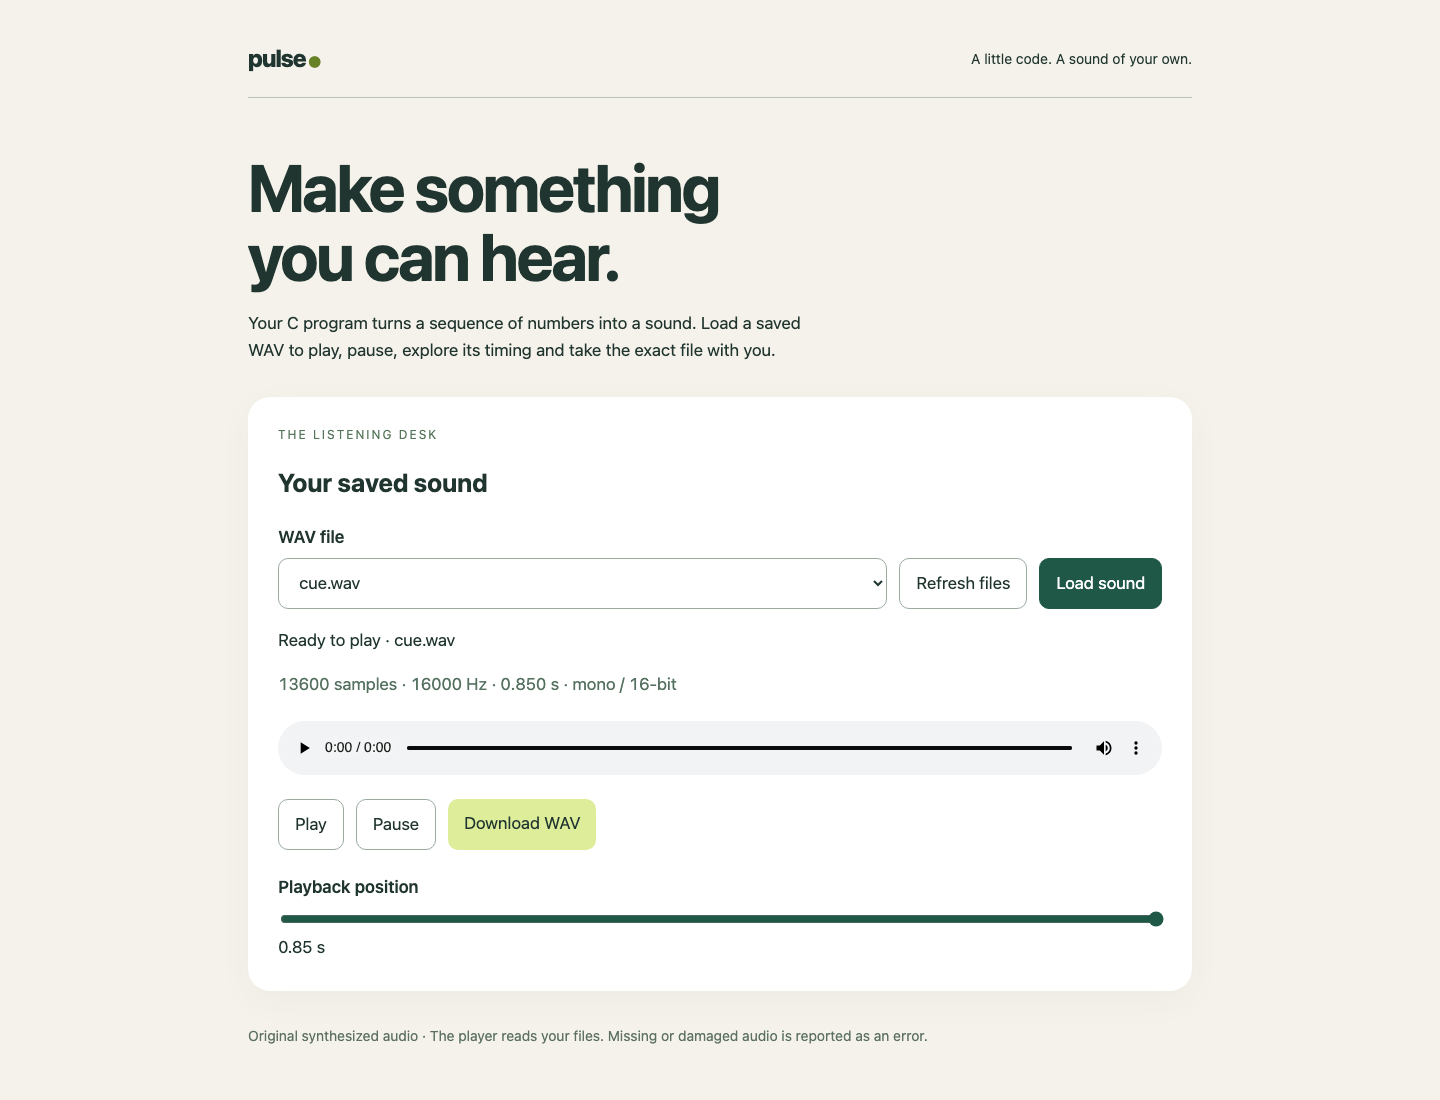
選択と Ready メッセージは cue.wav を示します。16,000 Hz の 13,600 サンプルは 0.850 秒です。Download WAV はその実際のバイトを保存します。
フェード付き cue.c、再コンパイルした cue、両方のファイルを残します。現在のプログラムにはフェード付き合図音の生成が要求されます。古いフェードなしファイルは比較用なので、新しいプログラムで再生成する必要はありません。
最初のラボと同様に、数学的・丸めの同等実装は認められます。チェックは各音について、要求した正弦キャリアと期待する線形ゲインを当てはめます。近似振幅の誤差は要求振幅の 2% に 2 サンプル単位を加えた値まで、残差の二乗平均平方根(RMS)は振幅の 0.5% に 2 単位を加えた値までです。RMS は平均的な大きさのサンプル誤差を表します。ピーク超過は 2 単位までで、各フェード音の最初と最後はゼロから 2 単位以内でなければなりません。これらの許容差は、同じ端点と全体の包絡線が制限内なら、整数丸めや、fade - 1 で割るような等価な離散傾斜式を認めます。正確なフレーム数、順番、ゼロの休止は引き続き必要です。要求周波数を変更する別の許可はありません。当てはめ計算を実装する必要はありません。
境界条件でも時間を正しく保つ
このステップでは、平坦部がない場合と、音の長さに整数でない周期数が含まれる場合に同じプログラムを使います。Terminal から始めます。
最短の対応音と最長フェードを試します。100 ms の区間は 1,600 サンプル、50 ms の傾斜は 800 サンプルです。両方の傾斜が収まり、平坦部はありません。これは有効な入力であり、拒否すべきエラーではありません。
./cue 200 100 50 1200 100 50 1000 > outputs/edge-cue.wav
python3 inspect_wav.py outputs/edge-cue.wav
4,000 フレーム、0.250 秒を確認します。音は各 1,600 サンプル、休止は 800 サンプルです。傾斜とサンプリングされた正弦ピークが必ずしも重ならないため、ピークは 1,000 未満の場合があります。振幅の上限は引き続き適用されます。
次は 733 Hz を 101 ms、休止を 51 ms、997 Hz を 103 ms、フェードを 7 ms とします。
./cue 733 101 51 997 103 7 7373 > outputs/odd-cue.wav
python3 inspect_wav.py outputs/odd-cue.wav
4,080 フレーム、0.255 秒になるはずです。最初の音は 1,616 サンプル、休止は 816 サンプル、2 番目の音は 1,648 サンプルです。周波数と時間の積が整数周期である必要はありません。サンプル数が長さを定め、ローカルフェードが各音の終わりをゼロに戻します。古い音声を切り取ったりヘッダーを書き換えたりして、新しい条件をまねないでください。
Sound Studio に切り替え、更新して edge-cue.wav と odd-cue.wav を再生します。長さの違いを確認し、実際のコントロールで一時停止と位置移動を試します。Tab でフォーカスが見え、Enter は Play を起動します。Home、End、矢印キーは Playback position を操作します。odd-cue.wav をダウンロードします。ブラウザ再生と数値チェックはファイルの証拠であり、物理スピーカーや汎用の音声制作品質を検証するものではありません。
Terminal に戻ります。次は無効な 51 ms フェードを意図的に要求します。新しい使い捨て出力パスを使います。以前と同様、シェルのリダイレクトは検証前にファイルを開くため、拒否で空ファイルが残る場合があります。同じパスの古いファイルは保護されません。
./cue 440 300 150 660 400 51 10000 > outputs/rejected-fade.wav
試行と取得の間に何も実行せず、元のネイティブステータスを即座に読みます。
echo $?
公開範囲の説明とステータス 2 が表示されるはずです。無効なのはフェードであり、150 ms の休止ではありません。Sound Studio に切り替え、更新して rejected-fade.wav を選び、Load sound をクリックします。Cannot load sound と表示され、再生可能なリソースもダウンロードもありません。.wav という拡張子は空ファイルを修復しません。Terminal に戻り、この出力だけを削除します。
rm -- outputs/rejected-fade.wav
対応するフェード値と新しい出力名で復旧します。
./cue 440 300 150 660 400 20 10000 > outputs/recovered-cue.wav
python3 inspect_wav.py outputs/recovered-cue.wav
再び 13,600 フレーム、0.850 秒になるはずです。相対パスを間違えたら、ステップ 1 の絶対 cd と正しいファイル名を使ってください。コンパイラエラーなら編集して再構築し、パラメータ拒否ならその引数を修正します。Cannot load sound は保存済みファイルの存在や形式の問題です。どれも環境リセットは必要ありません。
cue.c、動作する cue、成功した 5 つの WAV を残します。最終チェックは実ファイルを読み、提出した実行ファイルと変更しないソースを、公開端点や端数のある条件を含めた使い捨てテストで試します。評価は出力を上書きせず、現在の実行ファイルを再構築せず、欠けたファイルを修復せず、代わりの音を合成しません。1 つの録音を固定したのではなく、再利用可能な 3 区間の音生成器を作れました。
まとめ
独立した 2 回の音生成呼び出しと、実際のゼロサンプルによる休止から WAV を組み立てました。各音の両端に線形ゲインを適用し、正確な整数サンプル境界を守り、短い音、長いフェード、端数のある条件でも同じプログラムを使いました。ソース、実行ファイル、5 つの実ファイルに、初期の比較用音と完成したフェード動作の両方が残ります。