



はじめに
注文アプリは現在、読み取りと書き込みを 1 つのプライマリに送っています。PostgreSQL リードレプリカを作成してクエリを振り分け、新しい書き込みがレプリカで読めるようになることと、レプリカが書き込みを拒否することを確認します。
これは接続、SQL、回復の実習後に行う任意の拡張です。環境は独立して開始し、プライマリと 3 件のサンプル注文があります。最後にレプリカとプライマリを削除します。
認定試験との関連
この実習では、次の試験トピックに関する入門的な操作を練習します。
- Cloud Practitioner (CLF-C02) · タスク 3.4:リレーショナルデータベースのリードレプリカの用途を理解します。
- Solutions Architect – Associate (SAA-C03) · タスク 3.3:アプリの読み取りアクセスパターンに合わせてレプリカを設定します。
リードレプリカを作成して確認する
このステップでは、プライマリから変更を受け取る 2 つ目の PostgreSQL インスタンスを作成します。
リードレプリカはコピーされたデータからクエリに応答します。PostgreSQL は先行書き込みログ(WAL)でプライマリの変更を送信します。スタンバイは変更を再生します。レプリカは別のエンジンであり、複製が直前にコミットした書き込みより遅れることがあります。
リードレプリカと Multi-AZ スタンバイの目的は異なります。レプリカはアプリのクエリ用エンドポイントを提供します。標準の Multi-AZ DB インスタンス構成のスタンバイは可用性とフェイルオーバー用であり、アプリの読み取りには応答しません。この実習はレプリカを実装し、Multi-AZ フェイルオーバーは行いません。
用意された接続設定を読み込みます。
cd /home/labex/project
source database.env
ソースを確認します。
aws rds \
  describe-db-instances \
  --db-instance-identifier orders-db \
  --query 'DBInstances[0].{Identifier:DBInstanceIdentifier,Status:DBInstanceStatus,BackupRetention:BackupRetentionPeriod,Endpoint:Endpoint}'
RDS のリードレプリカのソースには、0 より大きいバックアップ保持期間が必要です。この実習のプライマリは 1 に設定されています。用意された設定を使い、自動バックアップのスケジュールはテストしません。
レプリカを作成します。
aws rds \
  create-db-instance-read-replica \
  --db-instance-identifier orders-reader \
  --source-db-instance-identifier orders-db \
  --db-instance-class db.t3.micro \
  --no-publicly-accessible \
  --query 'DBInstance.{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Status:DBInstanceStatus,Endpoint:Endpoint}'
aws rds \
  wait db-instance-available \
  --db-instance-identifier orders-reader
両方のリソースを確認します。
aws rds \
  describe-db-instances \
  --query 'DBInstances[].{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Endpoint:Endpoint.Address}' \
  --output table
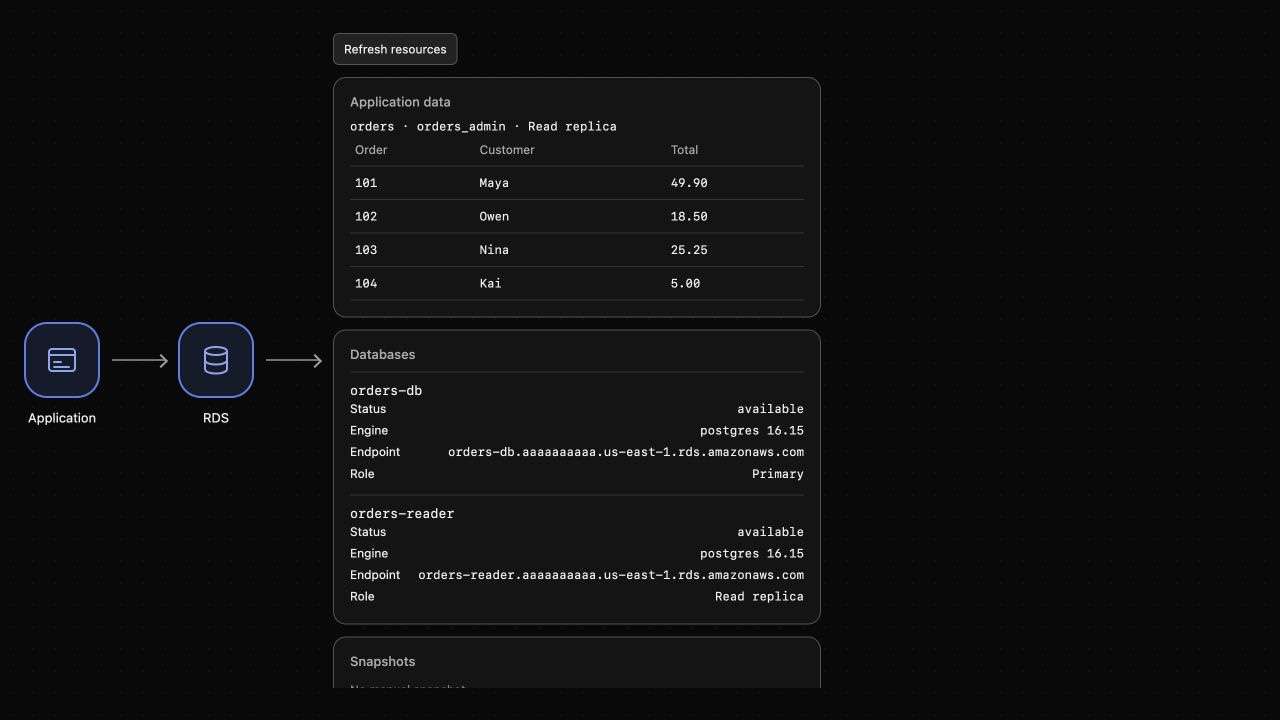
orders-reader の独自のエンドポイントと、orders-db へのソース関係が表示されます。AWS View にプライマリとレプリカが表示されます。
実際のレプリカエンジンをクエリします。
psql \
  "service=orders-reader" \
  --command 'SELECT current_database(), pg_is_in_recovery();'
データベース orders と、t(true)の pg_is_in_recovery が表示されます。単に RDS リソースにレプリカのラベルがあるのではなく、PostgreSQL が実際にスタンバイ回復モードで動作しています。
アプリの読み取りと書き込みエンドポイントを分離する
このステップでは、書き込みをプライマリに残し、クエリをレプリカに送ります。
アプリの設定を確認します。
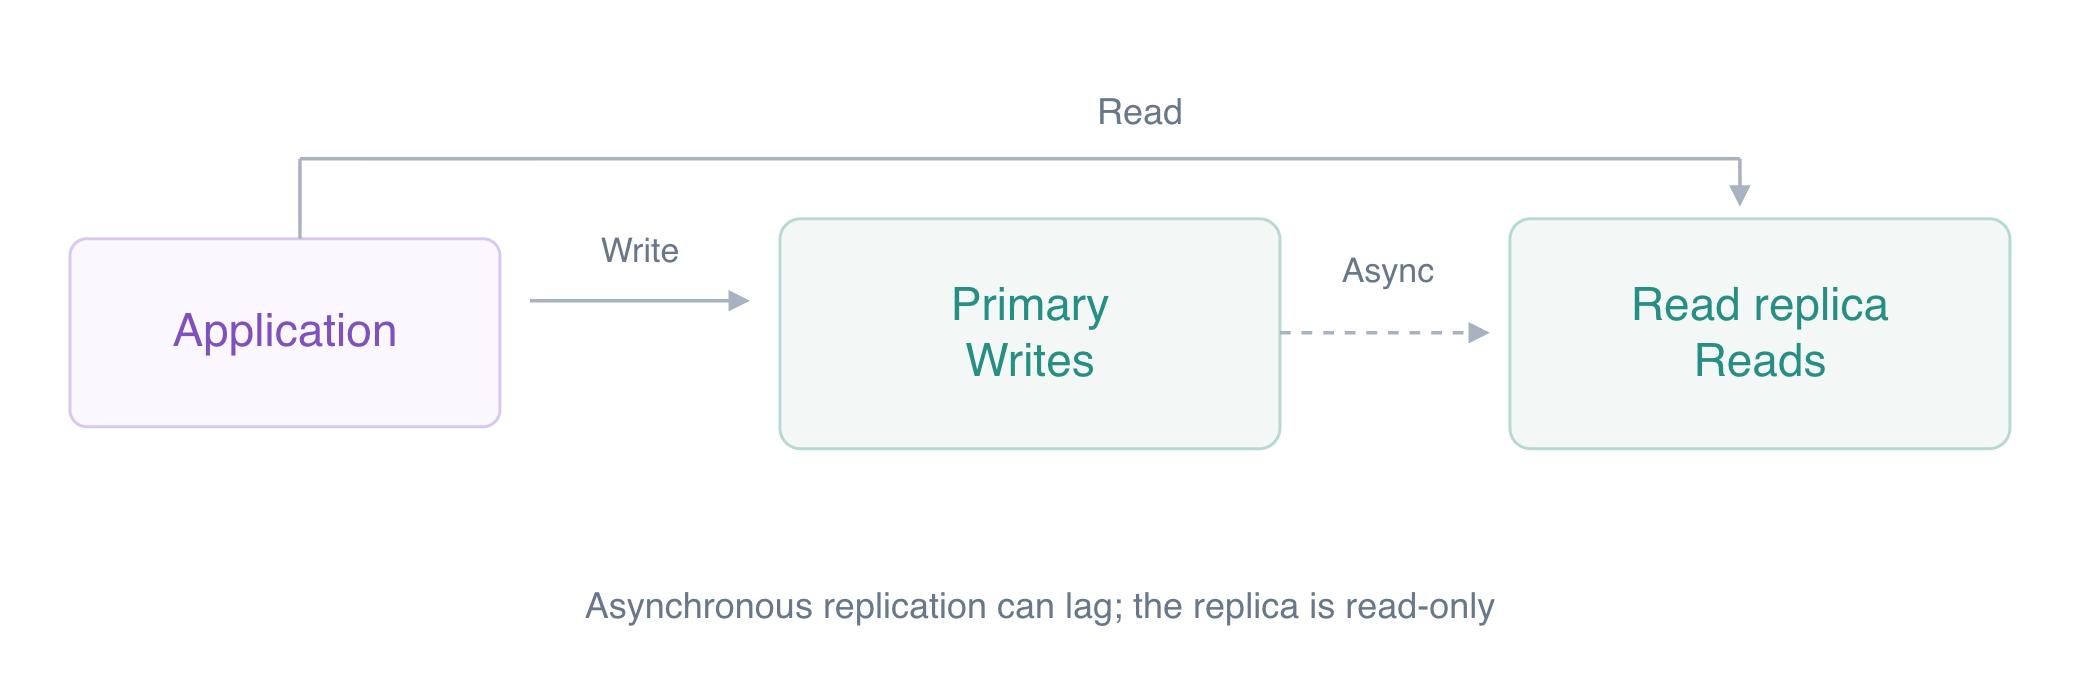
概念図:書き込みはプライマリへ、読み取りは非同期で更新されるレプリカを使用できる。
cat app-config.json
現在、両ホストフィールドはプライマリを示しています。レプリカのエンドポイントを取得します。
READER_ENDPOINT=$(aws rds \
  describe-db-instances \
  --db-instance-identifier orders-reader \
  --query 'DBInstances[0].Endpoint.Address' \
  --output text)
read_host だけを変更します。
jq \
  --arg host "$READER_ENDPOINT" \
  '.read_host = $host' \
  app-config.json > app-config.new
mv app-config.new app-config.json
アプリから読み取ります。
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
元の 3 件の注文と read_only: true が表示されます。応答はアプリからスタンバイへの実際の SQL 接続によるものです。AWS View のデータソースはリードレプリカになります。
レプリカはソースから複製されたデータベースユーザーを使います。エンドポイントは接続先インスタンスを決めますが、データベース認証と SQL 権限は引き続き適用されます。
複製とレプリカへの書き込み拒否を観察する
このステップでは、プライマリで新しい注文を保存し、レプリカから読み取ります。
アプリから注文を追加します。POST ハンドラーは、引き続きプライマリを示す write_host を使います。
curl \
  --silent \
  --show-error \
  --fail \
  --request POST \
  --header 'Content-Type: application/json' \
  --data '{"order_id":104,"customer":"Kai","total":"5.00"}' \
  http://127.0.0.1:8080/application/orders
saved: true が表示されます。ソースとレプリカを別々にクエリします。
psql \
  "service=orders-db" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
psql \
  "service=orders-reader" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
両方に Kai の 5.00 の注文が表示されます。最初のレプリカクエリにまだ行がなければ、少し待って同じクエリを繰り返してください。非同期複製には遅延があります。読み取りが多い処理には便利ですが、即時の整合性が必要なら直前に書いた値をプライマリから読む必要があります。
アプリの一覧をもう一度読み取ります。
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
4 件の注文と read_only: true が表示されます。
レプリカで実際に挿入を試します。
psql \
  "service=orders-reader" \
  --set=ON_ERROR_STOP=1 \
  --command "INSERT INTO orders (order_id, customer, total) VALUES (105, 'Lena', 9.00);"
読み取り専用トランザクションでは INSERT を実行できないというエラーが表示されます。回復モードはマスターユーザーでも書き込みを拒否します。試した注文がどちらのエンジンにもないことを確認します。
psql \
  "service=orders-db" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
psql \
  "service=orders-reader" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
両方で 0 が表示されます。書き込みはプライマリで行い、整合性の要件が許す場合にはクエリでレプリカを使用できます。
レプリカとプライマリを削除する
このステップでは、2 つの練習用インスタンスを削除します。
先にレプリカを、次にソースを削除します。
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-reader \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-reader
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-db \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-db
aws rds \
  describe-db-instances \
  --query 'DBInstances[].DBInstanceIdentifier'
[] が表示され、AWS View にデータベースがなくなります。用意されたアプリとネットワークリソースは保持してください。
まとめ
PostgreSQL リードレプリカを作成し、実際のスタンバイ回復モードを確認しました。読取と書込のエンドポイントを分離し、プライマリの新しい書き込みがレプリカに到達することと、直接書き込みが拒否されることを確認しました。最後に両方を削除しました。
リードレプリカは読み取りアクセスを支え、標準の Multi-AZ DB インスタンス構成のスタンバイとは目的と動作が異なります。最後のチャレンジでは、学んだデータベース接続と診断のスキルを使います。


