はじめに
店舗は売上を月別に保存しています。September は登録済みで、October の新しいファイルはローカルにあります。月別 S3 プレフィックスへアップロードし、Glue パーティションを登録して、Athena で新月と両月を調べます。
先に Query S3 Data with Athena を完了してください。独立した環境に分割済みの sales テーブル、September のデータと登録、ローカル CSV、設定済み AWS ID が用意されます。個人アカウントや以前の VM リソースは不要です。Terminal で通常の S3/Glue/Athena コマンドを使い、AWS View でファイル、登録場所、実際の結果を比較します。
認定試験との関連
| 認定 | 試験タスク | 実践内容 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Glue メタデータによって月別 S3 データを Athena 分析に利用できる仕組みを説明します。 |
新しい月のファイルを追加する
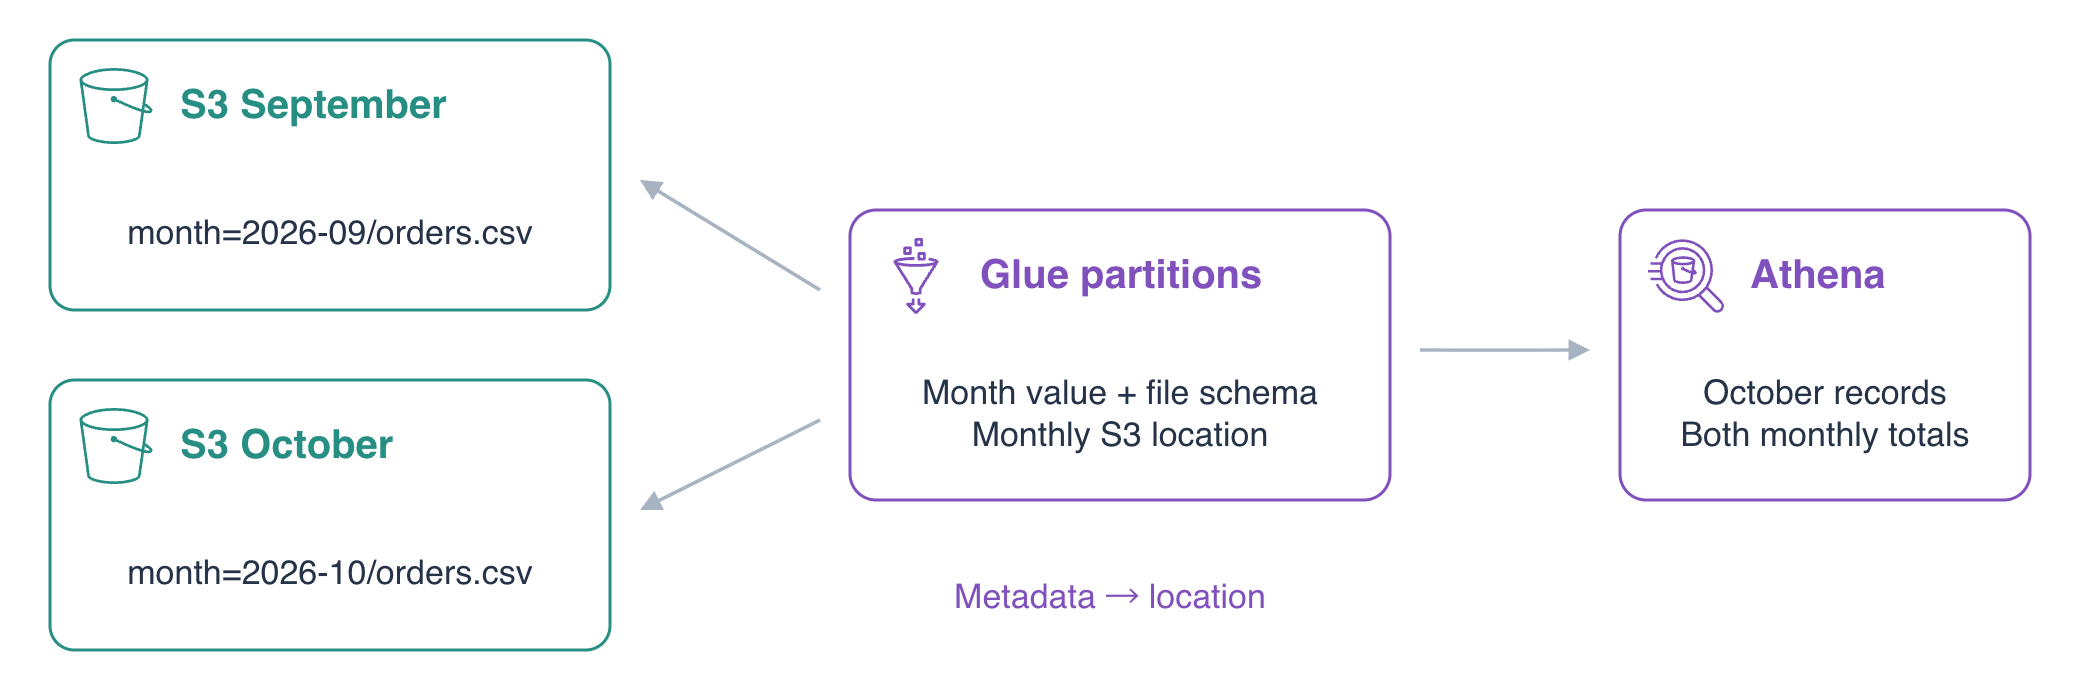
このステップでは、September を変えずに October をアップロードします。パーティションは月などのキーでデータを分類します。sales/month=2026-09/ は September、sales/month=2026-10/ は October 用です。key=value の名前は分類を示しますが、アップロードだけでカタログ登録されるわけではありません。
プロジェクトで ID を確認します:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN は labex-an03-operator で終わります。jq -r で JSON 文字列を取得し、$(...) で変数へ保存します:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive で子プレフィックスのオブジェクトも一覧表示します:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
sales/month=2026-09/orders.csv があるはずです。September は 1000、2000、500 セント、計 3500。このファイルと無関係な reference/notes.txt を保ちます。新しい CSV を確認します:
cat october.csv
O01/east/700、O02/west/900、O03/east/400 の三件、計 2000 セントです。September と同じ三列です。専用の月別場所へアップロードします:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
実際のオブジェクトを読み戻します:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
末尾の - は内容を端末へ表示します。AWS View では S3 に二つのファイル、Glue に September だけが見えます。到着と登録は別です。
October をカタログに登録する
このステップでは、ファイル到着だけでは不十分な理由を確認し、メタデータを追加します。パーティション定義はキー値を S3 場所とスキーマに結び付けます。month は文字列のパーティションキーです。CSV には order_id、region、total_cents だけがあり、クエリの month は定義から得られます。
キーを確認します:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
month、型 string です。登録前に October を数えます。COUNT(*) は一致行数を数え、引用符付き heredoc は SQL をそのまま保持します:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
用意されたデータベースと出力先で送信し、ID を表示します:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
QUEUED、RUNNING なら繰り返し、SUCCEEDED で続けます。失敗なら Reason を読みます:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
結果を読みます:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
ファイルがあっても件数は 0 です。このテーブルは登録済みの場所を読み、ディレクトリ名だけではメタデータを作りません。
同じ列と CSV 形式を保つためストレージ記述子を再利用します。> は JSON をファイルへ書きます:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg は実際の場所を文字列で渡します。.Location = $location が October の場所に置換し、Values が単一キーの値を指定します:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
通常の JSON を確認します:
cat october-partition.json
Values が 2026-10、列が CSV と一致、場所が /sales/month=2026-10/ で終わることを確認します。${SALES_LOCATION} の波括弧は変数名と追加文字列を区切ります。file:// で JSON を読み、登録します:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
両パーティションを一覧表示します:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
各月がそれぞれの S3 場所を指し、AWS View に二つの対応が表示されます。登録はメタデータを変え、CSV をコピー・書き換えません。
新しい月と両月の合計を調べる
このステップでは、October を照会でき、September が正しいことを確認します。キーへの WHERE で月を選びます。記録の検証であり、本番速度やスキャン料金の測定ではありません。
October のクエリを書きます:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
新しい実行を送ります。登録しても以前のゼロ件という結果は書き換わりません:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
状態を確認し、待機中・実行中は繰り返し、成功後に進み、失敗なら理由を読みます:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
行を読みます:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
ヘッダー後に O01/700、O02/900、O03/400 が続きます。登録前に見えなかった同じファイルから三件を取得できました。
両月を集計します。SUM は金額、COUNT(*) は各 GROUP BY month の注文数を計算します:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
別の実行 ID を表示します:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
成功を確認します。必要なら繰り返し、失敗理由を調べます:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
集計結果を取得します:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September は 3500 セント・3 件、October は 2000 セント・3 件です。September を変更せず October を追加しました。AWS View で Glue の場所、SQL、行を比較します。
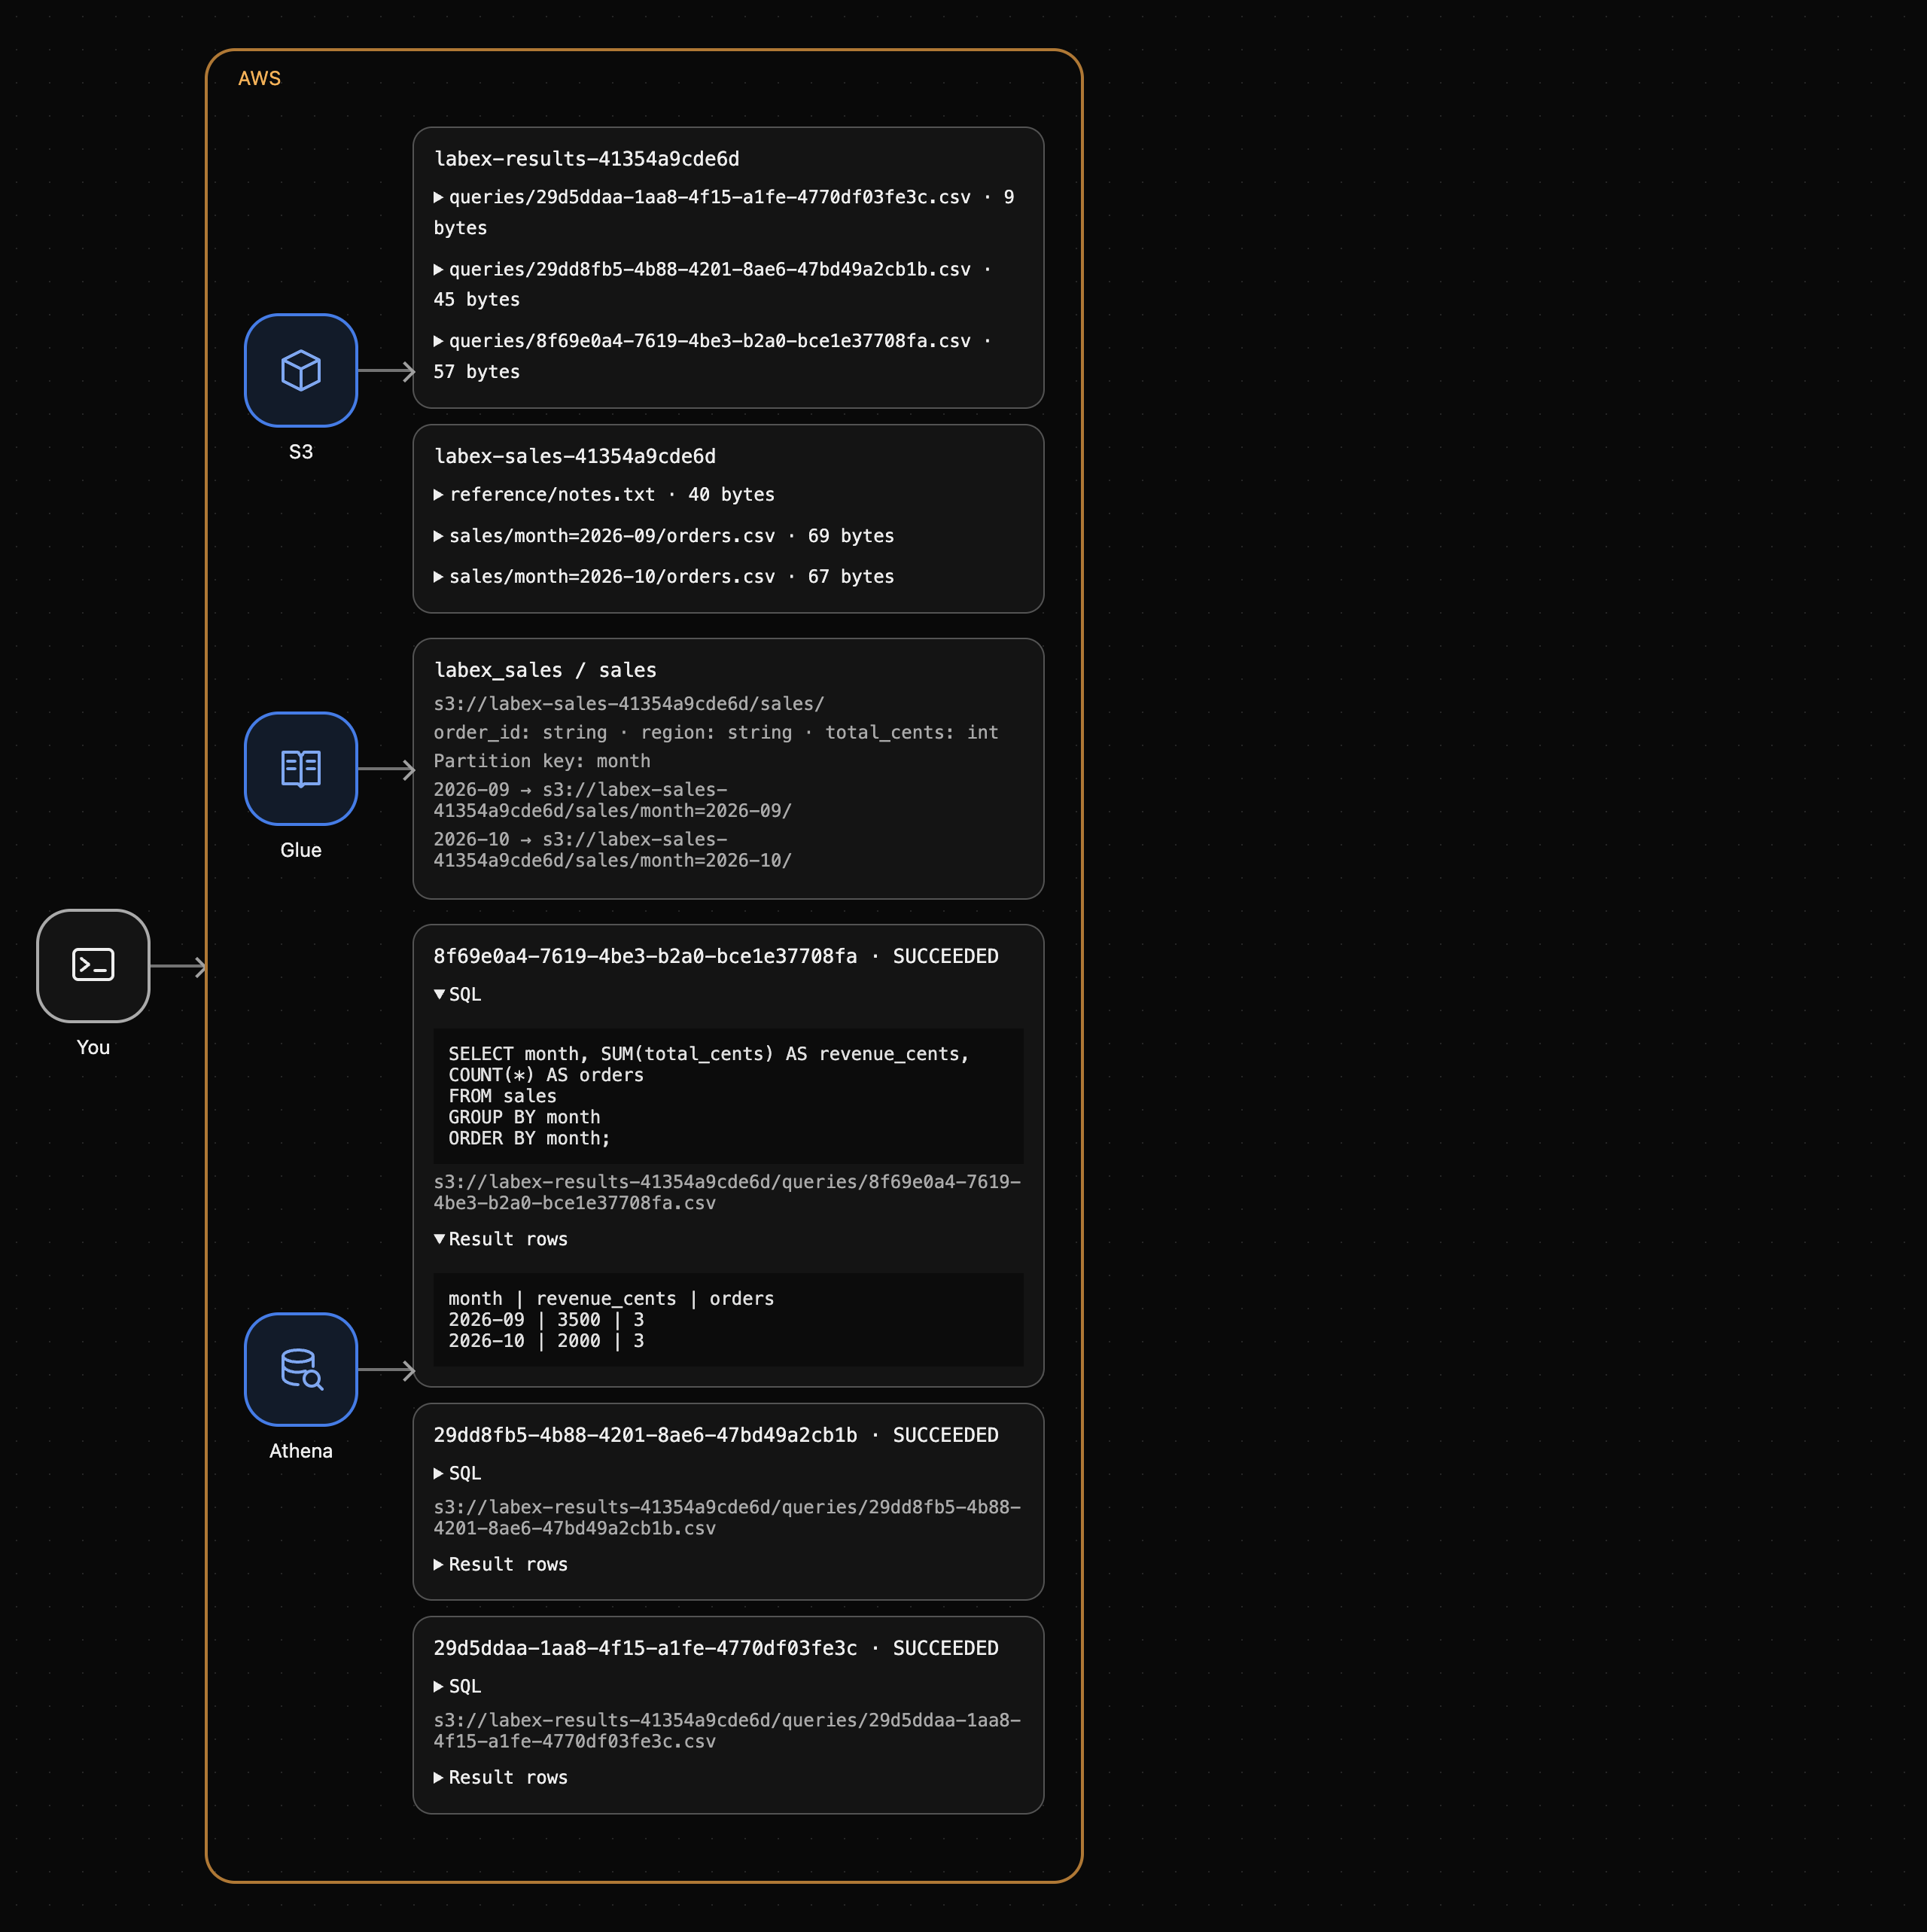
以前のゼロ件結果は、以前のカタログ状態に対する別の出力として残ります。
まとめ
月別 CSV をアップロードし、未登録では行が返らないことを確認し、Glue の場所とスキーマを登録して October と両月の合計を検証しました。ファイルとメタデータは別で、このテーブルは正しい登録後に新規場所を読めます。次は実際の結果を再利用できる集計ファイルにします。
詳しくは、AWS 公式ドキュメントを参照してください:パーティションキー、場所、登録。