



はじめに
無効な注文ジョブは、ワーカーが処理するたびに失敗します。試行回数を制限し、調査のために別のキューへ保持して、正常な注文は引き続き完了することを確認します。
先に 可視性タイムアウトと再配信を扱う と、その前提となるガイド付きラボを完了してください。この独立した VM は、ワーカーと空の注文テーブルを提供します。キュー、メッセージ、コンシューマーの接続は自分で作成します。
認定試験との関連
このラボでは、次の試験トピックに関連する実践的な演習を行います。
- Solutions Architect – Associate (SAA-C03) · タスク 2.1: 回数を限定したメッセージ処理と失敗したジョブの隔離。
- Developer – Associate (DVA-C02) · タスク 1.1: 回数を限定したメッセージ処理と失敗したジョブの隔離。
- DevOps Engineer – Professional (DOP-C02) · タスク 5.1: 基礎演習:回数を限定したメッセージ処理と失敗したジョブの隔離。
- Solutions Architect – Professional (SAP-C02) · タスク 2.4: 基礎演習:回数を限定したメッセージ処理と失敗したジョブの隔離。
送信元キューをデッドレターキューに接続する
このステップでは、空の Standard キューを 2 つ作成し、送信元キューに回数を限定したリドライブを設定します。
デッドレターキュー(DLQ)は、送信元キューの受信上限を超えたジョブを保持します。Terminal の隣で AWS View を使い、両方のキュー、実際の試行、保存された注文を比較してください。参照データを保持します。
cd /home/labex/project
失敗したジョブの移動先を作成し、キューアドレスを保存します。
DEAD_URL=$(aws sqs create-queue --queue-name labex-q03-dead --query QueueUrl --output text)
リドライブポリシーは、キュー URL ではなく、移動先のサービスリソース識別子である ARN を参照します。その ARN を選択します。
DEAD_ARN=$(aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names QueueArn --query Attributes.QueueArn --output text)
小さな JSON ポリシーを書き込みます。シェルは $DEAD_ARN に移動先 ARN を挿入します。maxReceiveCount は 2 回の配信試行を許可し、その後の受信でメッセージが DLQ へ移動します。
cat > redrive-policy.json <<EOF
{
  "deadLetterTargetArn": "$DEAD_ARN",
  "maxReceiveCount": 2
}
EOF
SQS キュー属性では、別の JSON ドキュメント内の JSON 文字列としてリドライブポリシーを表します。--rawfile はポリシーファイルをその文字列として読み取り、> は属性ファイルを書き込みます。
jq -n --rawfile policy redrive-policy.json '{VisibilityTimeout:"30",RedrivePolicy:$policy}' > queue-attributes.json
それらの属性で送信元キューを作成します。
QUEUE_URL=$(aws sqs create-queue --queue-name labex-q03-jobs --attributes file://queue-attributes.json --query QueueUrl --output text)
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names QueueArn VisibilityTimeout RedrivePolicy
可視性タイムアウトは 30、ポリシーの移動先は labex-q03-dead、受信上限は 2 となるはずです。コンシューマー接続のために、送信元 ARN を保存します。
QUEUE_ARN=$(aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names QueueArn --query Attributes.QueueArn --output text)
AWS View には両方の空のキューが表示され、ワーカー実行も注文もありません。リドライブポリシー自体はメッセージを処理しません。コンシューマーによる受信が必要です。
コンシューマーを接続して正常な処理を確認する
このステップでは、Lambda イベントソースマッピングを接続し、有効なジョブの実際の処理を確認します。
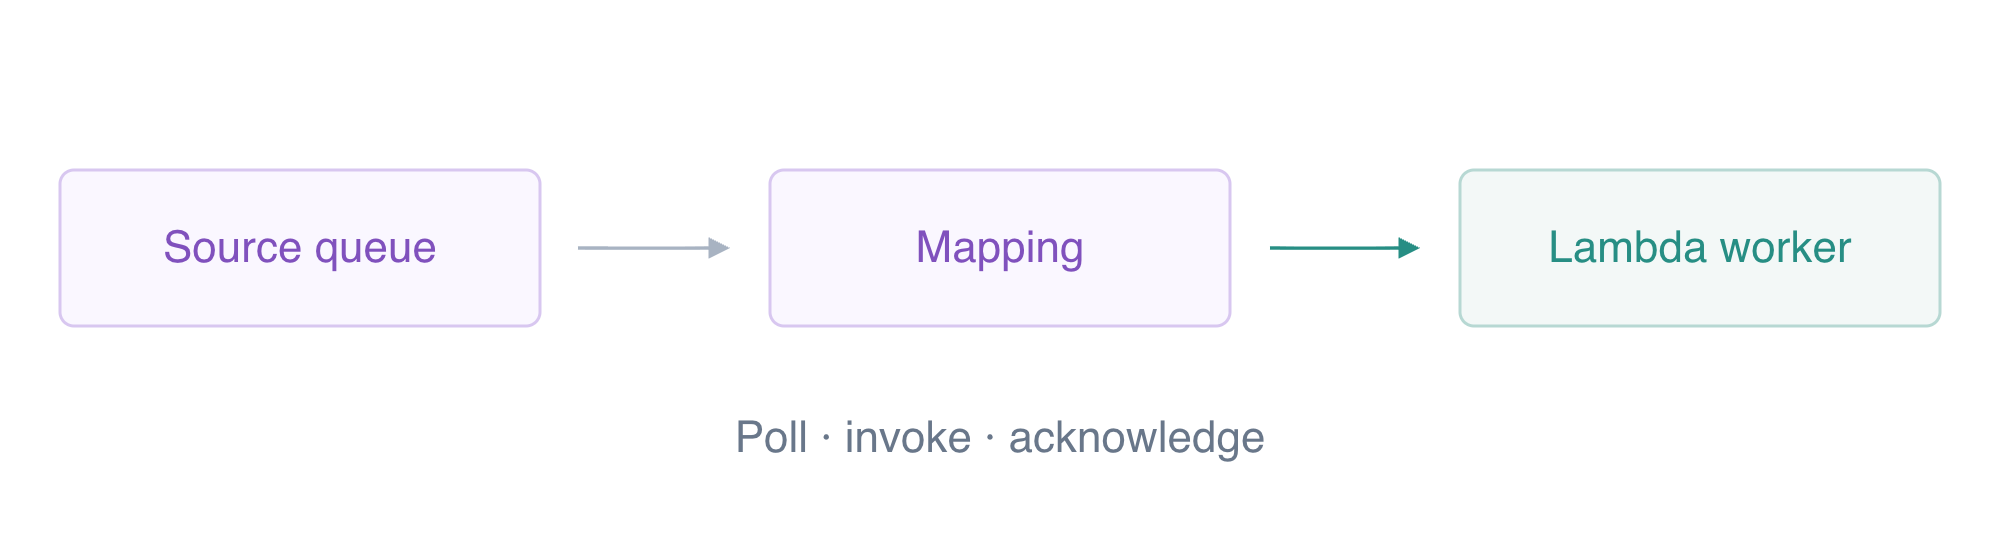
マッピングはキューをポーリングし、ワーカーを呼び出します。処理が成功すると、メッセージを処理済みとして確認できます。
イベントソースマッピングは、送信元キューと Lambda コンシューマーを接続します。メッセージをポーリングして SQS の Records イベントとして渡し、正常に処理されたメッセージを削除します。提供された実行ロールには、送信元キューの受信・削除権限、注文テーブルへの書き込み、ログ用権限だけがあります。ワーカーは 1~10 の範囲外の数量を拒否します。コードと権限は準備済みのリソースです。自分の作業は、キューの接続と失敗の隔離です。
各試行で確認するジョブを 1 件にするため、バッチサイズ 1 のマッピングを作成します。
MAPPING_ID=$(aws lambda create-event-source-mapping --function-name labex-q03-worker --event-source-arn "$QUEUE_ARN" --batch-size 1 --enabled --query UUID --output text)
接続を読み取ります。
aws lambda get-event-source-mapping --uuid "$MAPPING_ID" --query '{Source:EventSourceArn,Function:FunctionArn,Batch:BatchSize,State:State}'
送信元 ARN は labex-q03-jobs、関数は labex-q03-worker、バッチサイズは 1、状態は Enabled となるはずです。マッピングの存在は設定の証拠です。実際に保存された注文が処理の証拠になります。
正常なジョブを送ります。
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"good-order","quantity":2}'
ワーカーが結果を返し、注文テーブルに good-order が表示されるまで AWS View を観察します。処理は非同期です。このメッセージを手動で受信せず、コンシューマーのために少し時間を置いてください。その後、注文を読み取ります。
aws dynamodb get-item --table-name labex-q03-orders --key '{"id":{"S":"good-order"}}' --consistent-read --query Item
数量 2 と合計 600 が返るはずです。両方のキューを確認します。
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names ApproximateNumberOfMessages
両方のキューが空になるはずです。ワーカーが業務データの書き込みを完了し、コンシューマーが成功したジョブを処理済みとして確認しました。正常なメッセージは DLQ に送るものではありません。
回数を限定した再試行と失敗の隔離を観察する
このステップでは、無効なジョブを送り、ネイティブなリドライブによって DLQ に置かれる前に、実際の処理失敗を観察します。
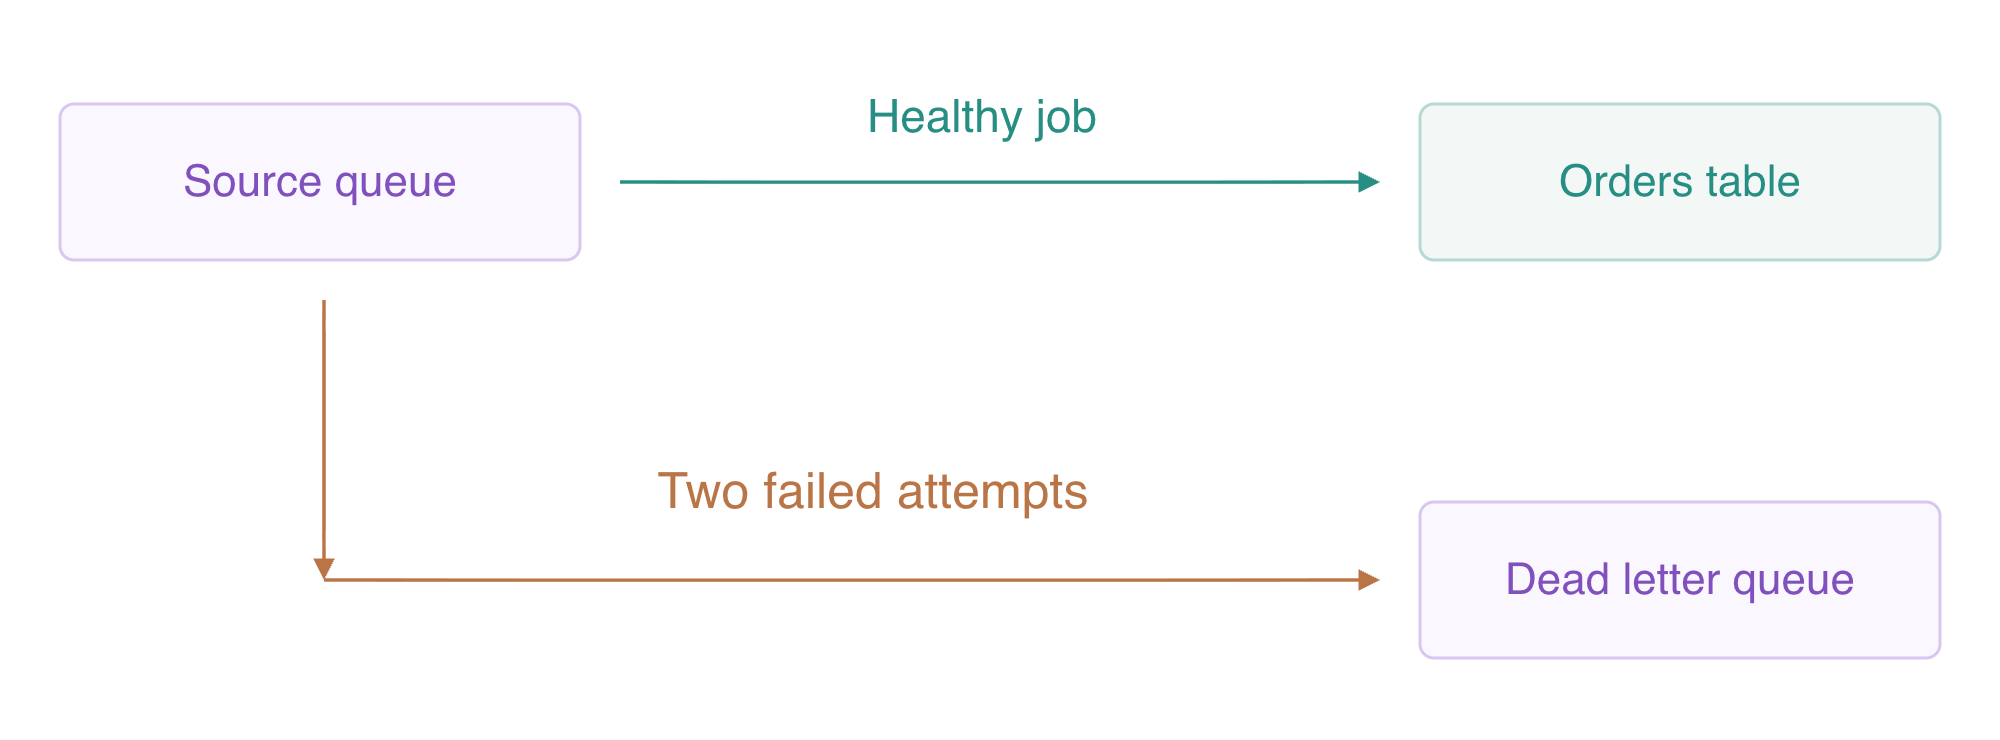
このラボの受信上限 2 では、その後の受信で失敗したジョブが DLQ へ移動し、ワーカーは 3 回目に呼び出されません。
ポイズンメッセージは、そのデータや処理ロジックによって繰り返し失敗するメッセージです。合成データとして無効な数量 0 を送ります。
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"poison-order","quantity":0}'
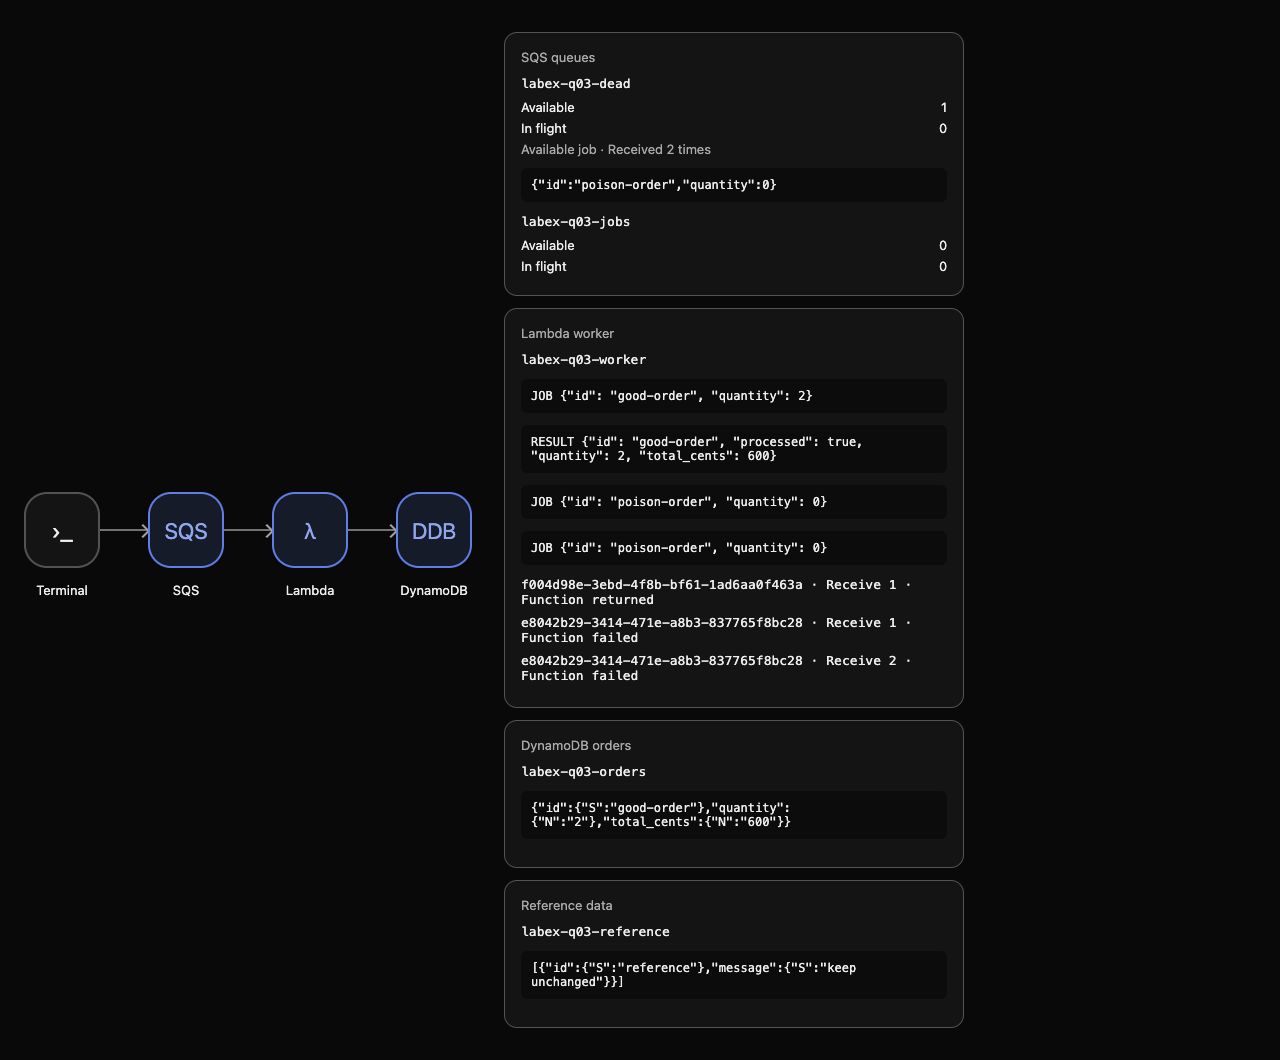
AWS View に、ワーカーの失敗した試行が表示されます。メッセージは可視性が期限切れになるまで処理中のままになり、その後コンシューマーが再び受信できます。DLQ に利用可能なジョブが 1 件表示されるまで、試行とキュー件数を観察してください。30 秒の時間枠と 2 回の試行では、およそ 1 分に処理時間を加えた時間を見込んでください。コンシューマーの動作中にジョブを手動で受信したり削除したりしないでください。受信回数と実験が変わってしまいます。
2 回の失敗試行は、同じメッセージ ID と受信回数 1、2 を持ちます。poison-order の保存された注文は表示されません。受信上限に達した後、その後のネイティブな受信は関数を 3 回目に呼び出す代わりに、送信元キューからメッセージを移動します。
CLI でキュー状態を確認します。
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
aws sqs get-queue-attributes --queue-url "$DEAD_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
送信元は利用可能なジョブも処理中のジョブも 0 件で、DLQ には利用可能なジョブが 1 件あるはずです。AWS View は元の本文を表示します。実際のワーカーログで、無効な数量と失敗を確認します。
aws logs filter-log-events --log-group-name /aws/lambda/labex-q03-worker --query 'events[].message'
すべての注文アイテムを読み取ります。
aws dynamodb scan --table-name labex-q03-orders --query Items
good-order/2/600 だけが残ります。メッセージを破棄したり無効な注文を書き込んだりせずに、失敗を隔離できました。DLQ への移動は、修復や業務処理の成功ではありません。ジョブの復旧と重複排除は、後のユニットとプロジェクトチャレンジで扱います。
接続と所有リソースを削除する
このステップでは、キューと結果を削除する前に、自分のコンシューマー接続を停止します。
最初にイベントソースマッピングを削除します。
aws lambda delete-event-source-mapping --uuid "$MAPPING_ID" --query UUID --output text
両方の使い捨てキューを削除します。これにより、DLQ に保持された合成データのポイズンジョブも破棄されます。
aws sqs delete-queue --queue-url "$QUEUE_URL"
aws sqs delete-queue --queue-url "$DEAD_URL"
正常な注文と、このラボの実行ログを削除します。
aws dynamodb delete-item --table-name labex-q03-orders --key '{"id":{"S":"good-order"}}'
aws logs delete-log-group --log-group-name /aws/lambda/labex-q03-worker
成功した API レスポンスで、不在と参照リソースの保持を確認します。
aws lambda list-event-source-mappings --function-name labex-q03-worker --query EventSourceMappings
aws sqs list-queues
aws dynamodb scan --table-name labex-q03-orders --query Items
aws dynamodb scan --table-name labex-q03-reference --query Items
マッピングと注文の一覧は空になり、キュー URL は残らず、参照アイテムには引き続き keep unchanged があります。提供されたワーカーとテーブル構造は残ります。AWS View にも同じリソース状態が表示されます。認証やネットワークの失敗は削除の証拠になりません。
通常のローカルポリシーファイルを削除します。
rm -f redrive-policy.json queue-attributes.json
環境を終了する前に、後片付けの検証を実行してください。
まとめ
受信上限を指定して SQS の送信元キューを DLQ に接続し、Lambda コンシューマーを関連付け、正常な保存された注文を確認しました。無効なジョブが 2 回失敗し、業務データへの書き込みなしで DLQ へ移動することを観察しました。その後、提供されたリソースを保持しながら、自分のマッピング、キュー、結果、ログを削除しました。


