はじめに
CloudWatch アラームを設定し、誤った公開の失敗を確認して正常な要求と OK 状態を復元します。
先にログのラボを完了してください。新環境はサイト、三つの非公開 S3 画像、作品一覧、ロール、ログ、要求メトリクスを提供します。以前のリソースや認証情報なしでアラーム作成、障害と復旧を行います。
認定試験との関連
| 認定 | タスク | 練習内容 |
|---|---|---|
| AWS Certified Cloud Practitioner (CLF-C02) | Task 3.8 | メトリクスとアラームで障害と復旧を観察する。 |
ラボの概要
エラーのアラームを作成する
このステップでは作品ページの実際のエラーにアラームを設定します。
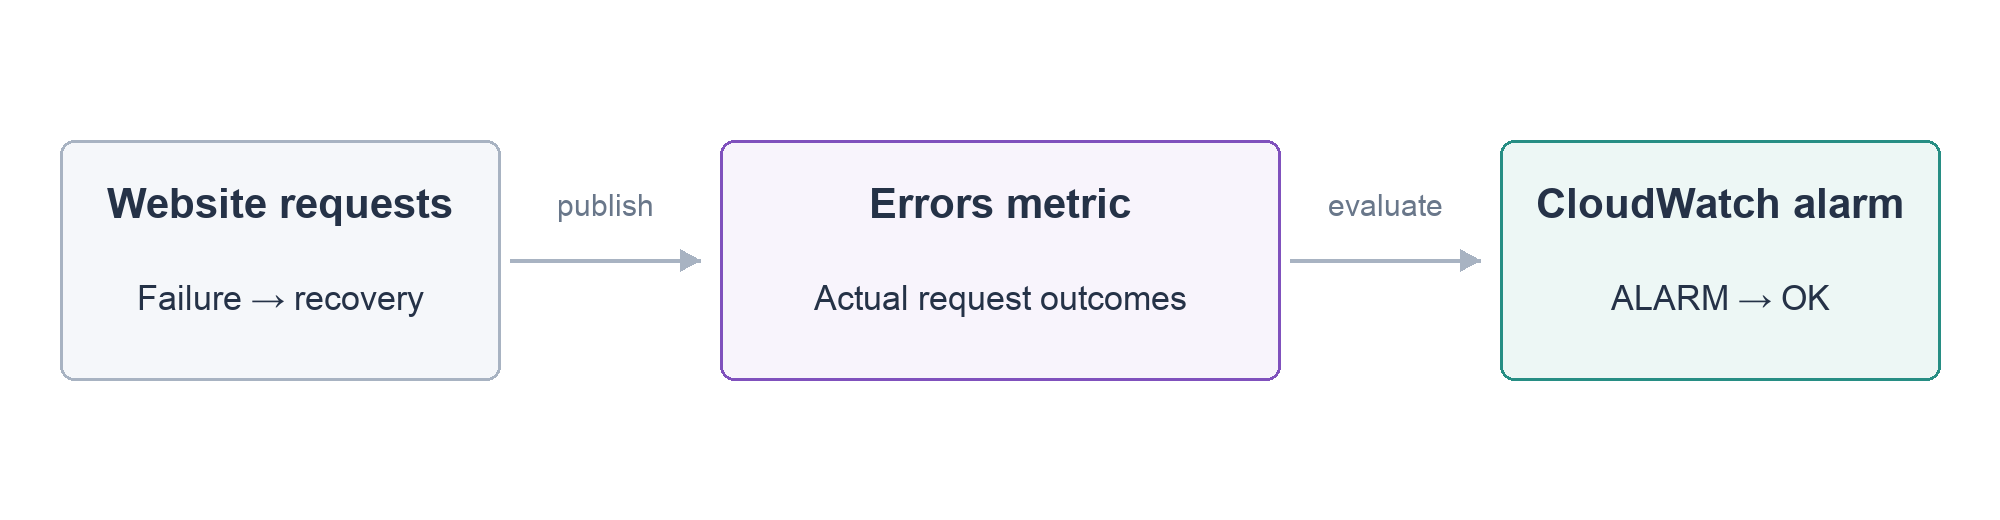
AWS View からサイトを開き確認します。各 /website 要求は Errors を発行し、失敗は 1、成功は 0 です。画像などは別ログに記録され、このページメトリクスには入りません。
メトリクスは時間に沿った数値です。namespace は分類、dimension はアプリの識別に使います。ここでは LabEx/Portfolio の Errors、Application=portfolio です。アラームは評価データとしきい値を比較し、サイトを自動修復するものではありません。
識別子を読み込み表示します。順番にインスタンス ID、SCP アドレス、ロググループです:
cd /home/labex/project
source website.env
echo "$INSTANCE_ID"
echo "$PUBLIC_IP"
echo "$LOG_GROUP"
準備済みファイルを読みます。表は評価する設定を示します:
cat website-alarm.json
| 設定 | 意味 |
|---|---|
MetricName: Errors |
ページの要求エラー |
Statistic: Sum |
周期内のエラーを合計 |
Period: 10 |
十秒周期を評価 |
EvaluationPeriods: 1 |
一周期で判定 |
Threshold: 0 / GreaterThanThreshold |
一つのエラーでもゼロを超える |
TreatMissingData: missing |
要求なしを正常とみなさない |
Unit: Count |
失敗要求の回数 |
十秒アラームには高解像度カスタムメトリクスが必要で、連携は一秒の解像度で発行します。通知先はありません。launch.json と同様、--cli-input-json は file:// でローカルファイルを読みます:
aws cloudwatch put-metric-alarm \
  --cli-input-json file://website-alarm.json
成功時は出力がありません。--query で名前、状態、理由だけを読みます:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
評価データがなければ StateValue は INSUFFICIENT_DATA から始まることがあります。AWS View も同じ状態です。次は実際の要求で状態を動かし、手動設定はしません。
実際の障害を検知する
このステップでは無効なプロフィールを公開し、実際の失敗をアラームと対応させます。
profile-broken.json を確認します。{invalid-json は用意した障害で、アプリは JSON として解析できません。既習の SCP 接続とパスで公開します:
cat profile-broken.json
scp -F ssh_config profile-broken.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
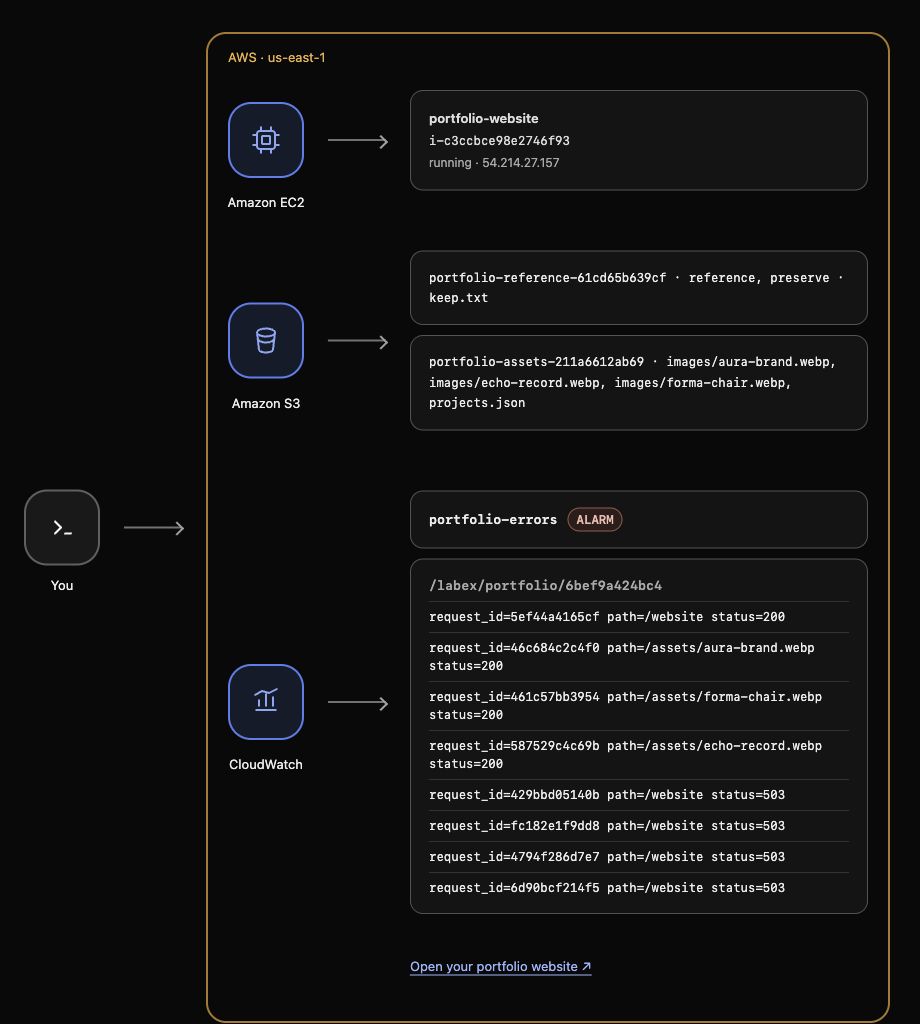
再読込すると Website unavailable が表示され、AWS View の EC2 は running のままです。サーバーは動いてもページを処理できません。ログを探します:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=503"' \
  --query 'events[].message'
path=/website status=503 を確認します。HTTP 503 は失敗した応答を示します。直前の公開は調べる原因ですが、状態コードだけで全原因は分かりません。
評価に約十秒待ち、アラームを読みます。まだ ALARM でなければ失敗ページを再読込して新しい要求を作り、別周期を待って同じ確認を繰り返します:
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
応答と AWS View の StateValue: ALARM を確認します。古い 503 ログは新しい測定値ではないので、確認中も失敗要求を新しくします。公開と実測エラーが対応しました。
十秒の評価を待つ間、約五秒ごとに再読込し、隣接周期にも要求を送ります。期待する状態を読めたら、要求が新しいうちに Check を押します。
サイトを修復して回復を確認する
このステップでは有効なプロフィールを戻し、成功要求とアラームを確認します。
profile-working.json は正しい三項目を持ちます。同じ保存先へ公開します:
cat profile-working.json
scp -F ssh_config profile-working.json ubuntu@"$PUBLIC_IP":/home/ubuntu/portfolio/profile.json
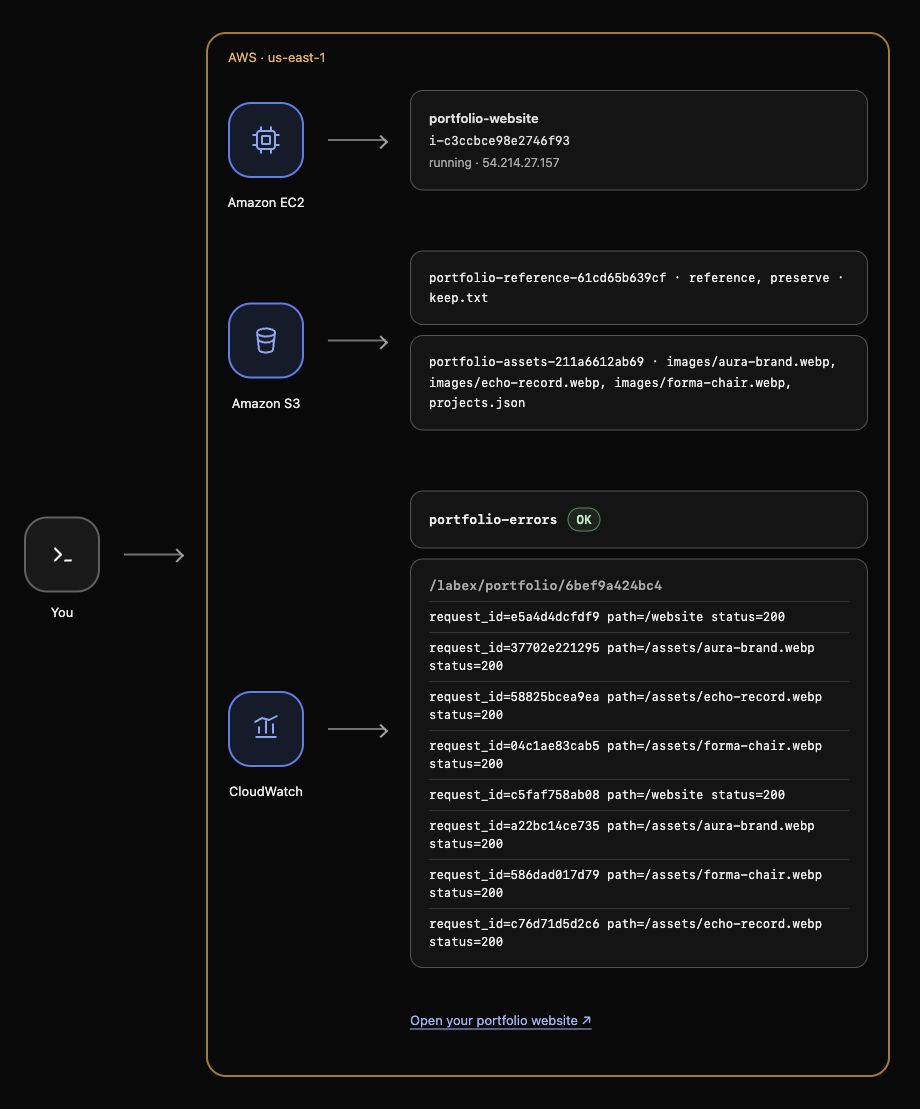
再読込すると Alex Morgan、Make it memorable.、三つの画像が戻り、修復を確認できます。成功メッセージを読みます:
aws logs filter-log-events \
  --log-group-name "$LOG_GROUP" \
  --filter-pattern '"status=200"' \
  --query 'events[].message'
障害後の新しい path=/website status=200 を探します。以前の 503 は履歴に残ります。後の成功で前の周期のエラーは消えないため、ページが先に戻る場合があります。
成功要求を新しい評価周期へ送ります。約五秒ごとに正常ページを再読込し、必要に応じ状態を読み StateValue: OK を確認します。評価データはしきい値を超えていません。要求が止まると INSUFFICIENT_DATA に戻る場合があり、正常な通信の証明ではありません。
aws cloudwatch describe-alarms \
  --alarm-names portfolio-errors \
  --query 'MetricAlarms[0].{AlarmName:AlarmName,StateValue:StateValue,StateReason:StateReason}'
十秒の評価を待つ間、約五秒ごとに再読込し、隣接周期にも要求を送ります。期待する状態を読めたら、要求が新しいうちに Check を押します。
まとめ
誤った公開、応答ログ、実測エラー、修復でサイトと OK が戻る実際の運用を完了しました。データなしと成功要求も区別でき、サイトを引き続き確認できます。
公式ドキュメント: CloudWatch alarms, high-resolution custom metrics.