はじめに
店舗には共有できる月別売上 CSV が必要です。Athena で合計を計算し、S3 の実際の出力を取得し、金額を訂正して新しい集計を作ります。二つの出力から、結果が実行時の入力に対応することを確認します。
先に Query Partitioned Sales Data を完了してください。独立した環境は二つの月別 S3 ファイル、登録済み Glue パーティション、AWS ID、ローカルの訂正版 September を提供します。個人アカウントや以前の VM リソースは不要です。Terminal で公式 AWS CLI を使い、AWS View でファイル、場所、結果を確認します。
認定試験との関連
| 認定 | 試験タスク | 実践内容 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Athena と Glue で S3 データを分析し、計算結果を取得します。 |
月別集計を計算する
このステップでは、現在の売上を集計します。Glue がスキーマと各月の場所を記録し、Athena がデータを読んで月別にまとめます。各実行には独自の ID とファイルがあります。
プロジェクトで ID を確認します:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN は labex-an04-operator で終わります。jq -r は JSON 文字列、$(...) は出力を変数へ保存します:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
登録済み場所を確認します:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
両月が登録済みです。整数のセントで total_cents を合計すると丸めを避けられます。COUNT(*) は注文数、GROUP BY month は月別グループ、ORDER BY month は比較順です。引用符付き heredoc で SQL をそのまま書きます:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
データベースと S3 出力先で送信します。file:// は SQL ファイルを読み、CLI の --query と --output text が ID を取得します:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
QUEUED、RUNNING は繰り返し、SUCCEEDED で続け、FAILED は Reason を読みます:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
入れ子の [*] は行ごとの列構造を保ちます:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
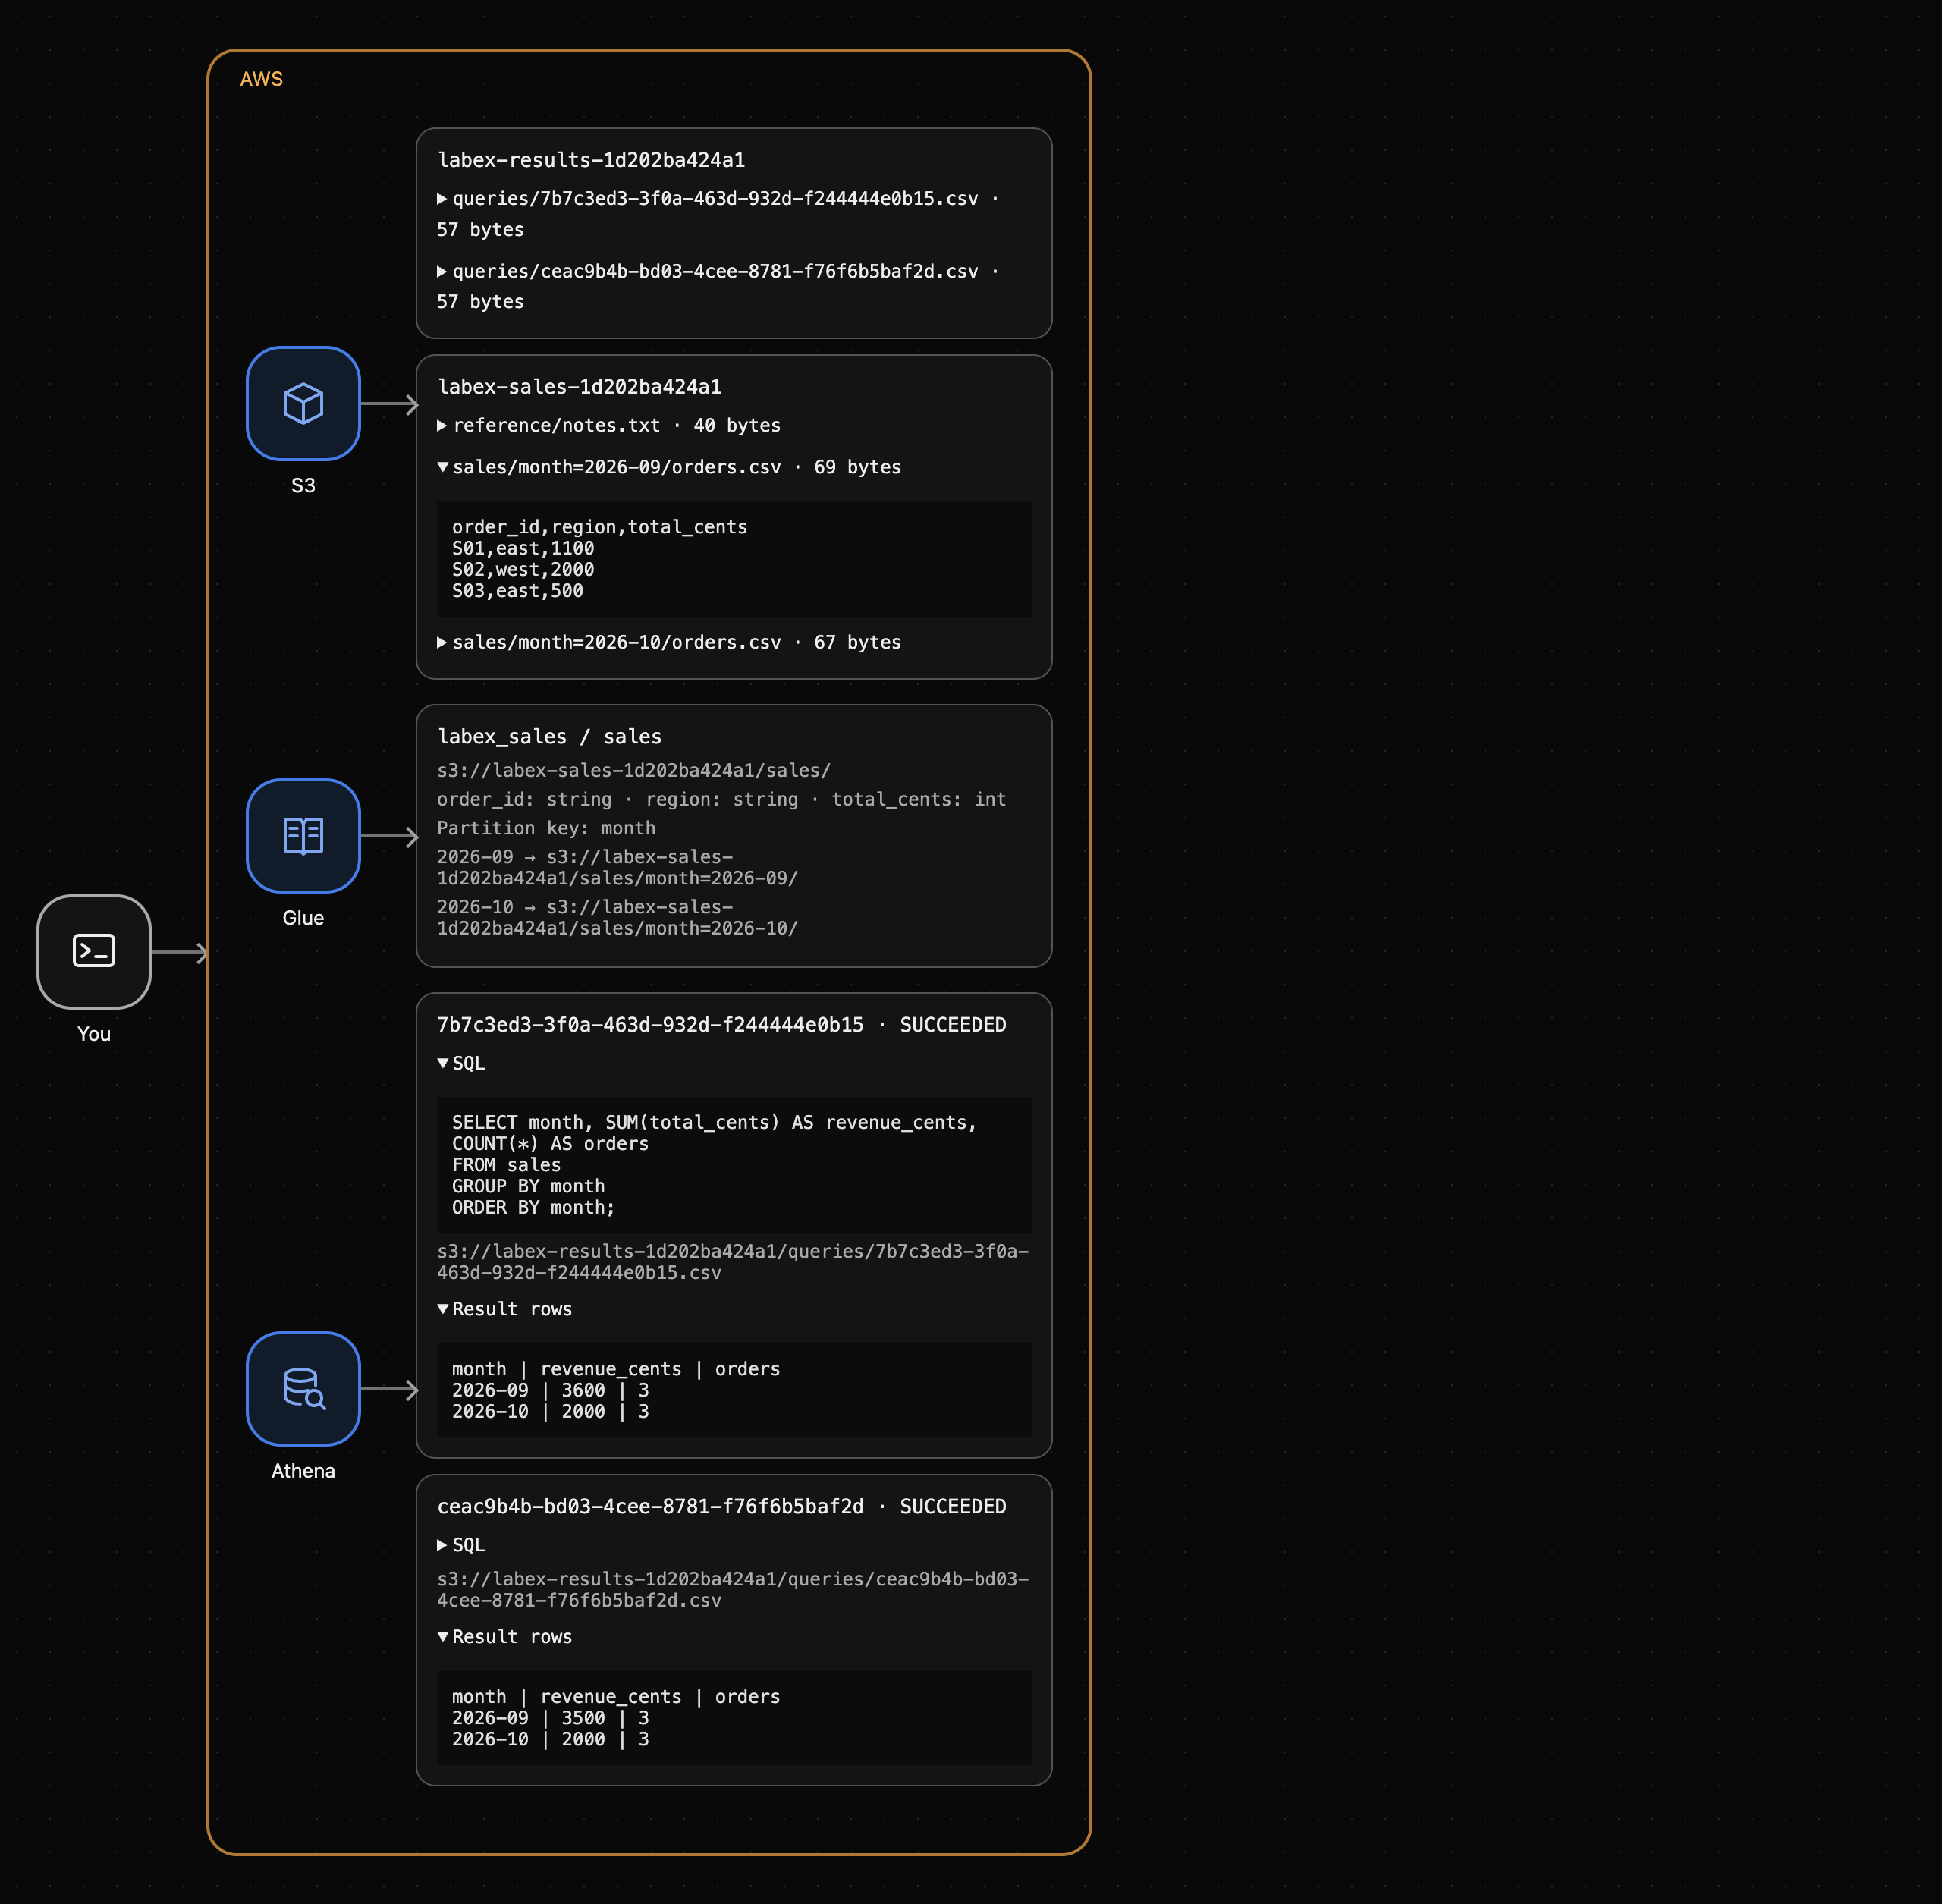
September は 3500 セント/3 件、October は 2000/3 件。AWS View の SQL と行を月別場所と比較します。
実際の S3 結果をダウンロードする
このステップでは、この実行の CSV を取得します。結果 API は行を表示し、実行メタデータは S3 場所を示します。バケット名や ID を推測せず正確な場所を読みます。
URI を取得・表示します:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
末尾は /queries/<your-execution-id>.csv。ID がクエリとファイルを結びます。summary.csv にダウンロードします:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
内容を確認します:
cat summary.csv
ヘッダーと二件の行です:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
API と同じ値です。手書きのレポートではなく、S3 から取得したファイルです。ローカル summary.csv と元の S3 出力を比較用に保持します。
入力訂正後に再計算する
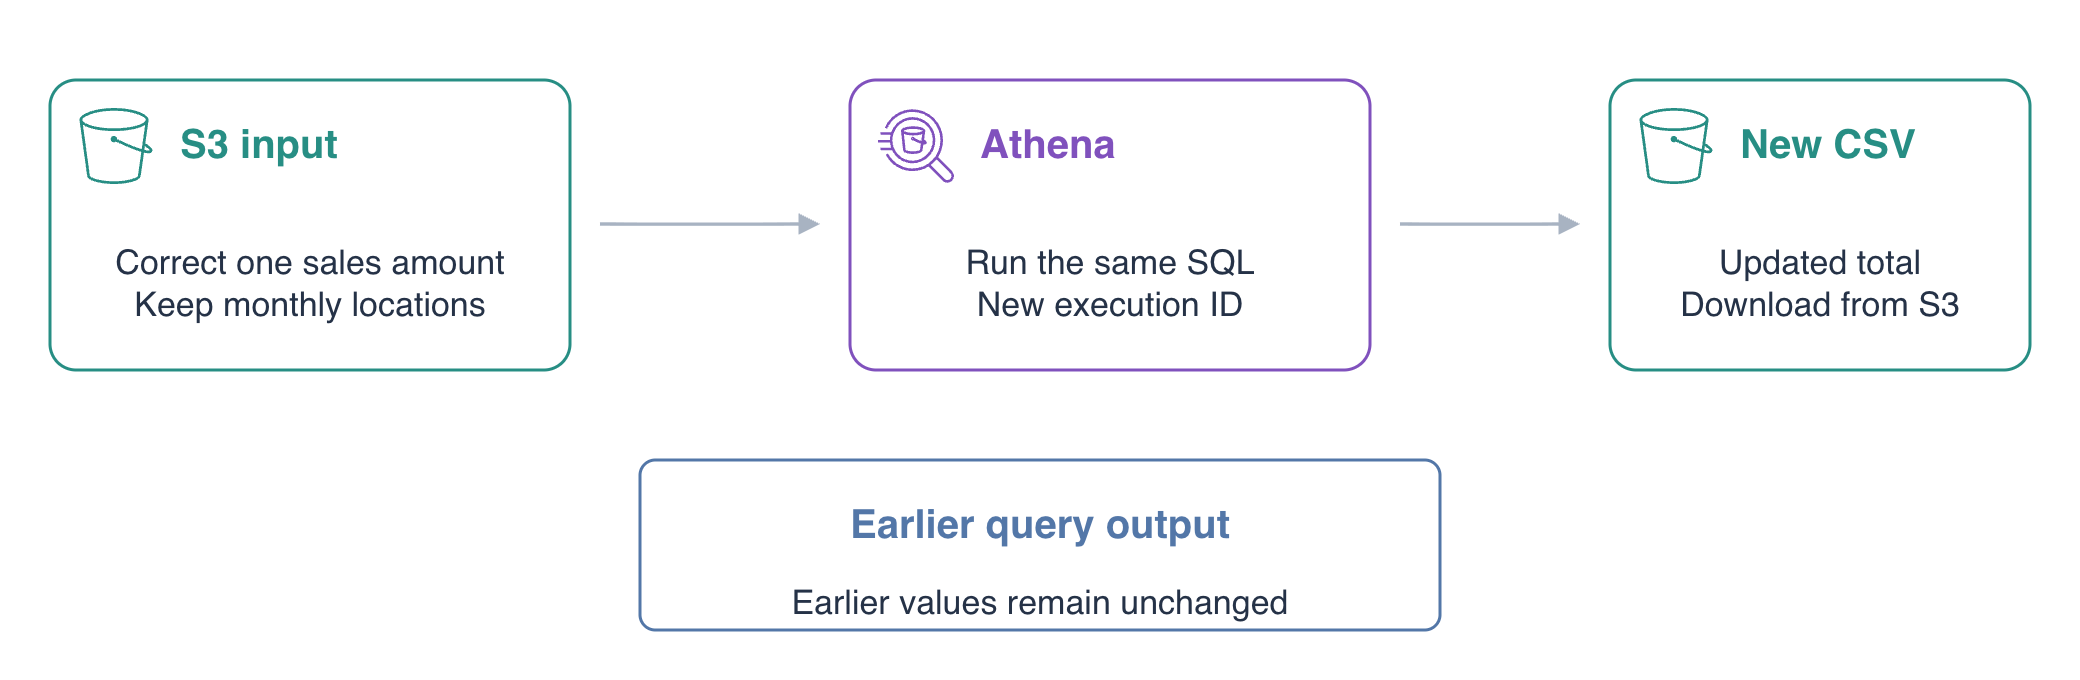
このステップでは、September の一件を訂正し同じ SQL を再実行します。以前の結果は入力変更で自動更新されず、新規実行が現在の入力を読む必要があります。
訂正版を確認します:
cat september-revised.csv
S01 は 1000 から 1100 セント、ほかは同じなので合計は 3600。既存オブジェクトを更新し、October と reference/notes.txt は保ちます:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
読み戻して確認します:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
末尾 - が内容を表示します。場所とスキーマは同じなので Glue 定義は有効です。同じ SQL を新規実行します:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
成功を確認します。待機・実行中は繰り返し、失敗なら理由を確認します:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
行を取得します:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September は 3600/3 件、October は 2000/3 件のまま。変更が計算に反映されました。
新規実行の出力先を取得します:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
旧ローカル集計を上書きせず取得します:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
新しい CSV を確認します:
cat summary-revised.csv
S3 の元の出力を読みます:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
元の September は 3500 のままです。別々の ID とファイルが旧入力と訂正入力に対応します。AWS View で現在の入力と両結果を確認します。これは正確性の検証で、本番費用や性能測定ではありません。
まとめ
登録済み S3 データを集計し、正確な CSV を取得し、入力訂正後に再計算しました。September は 3500 から 3600、October は 2000 のまま。以前の結果は値を保持するため、入力変更後は再実行が必要です。
詳しくは、AWS 公式ドキュメントを参照してください:クエリ実行ごとの出力ファイルを探す; SELECT のフィルター、グループ化、並べ替え。