はじめに
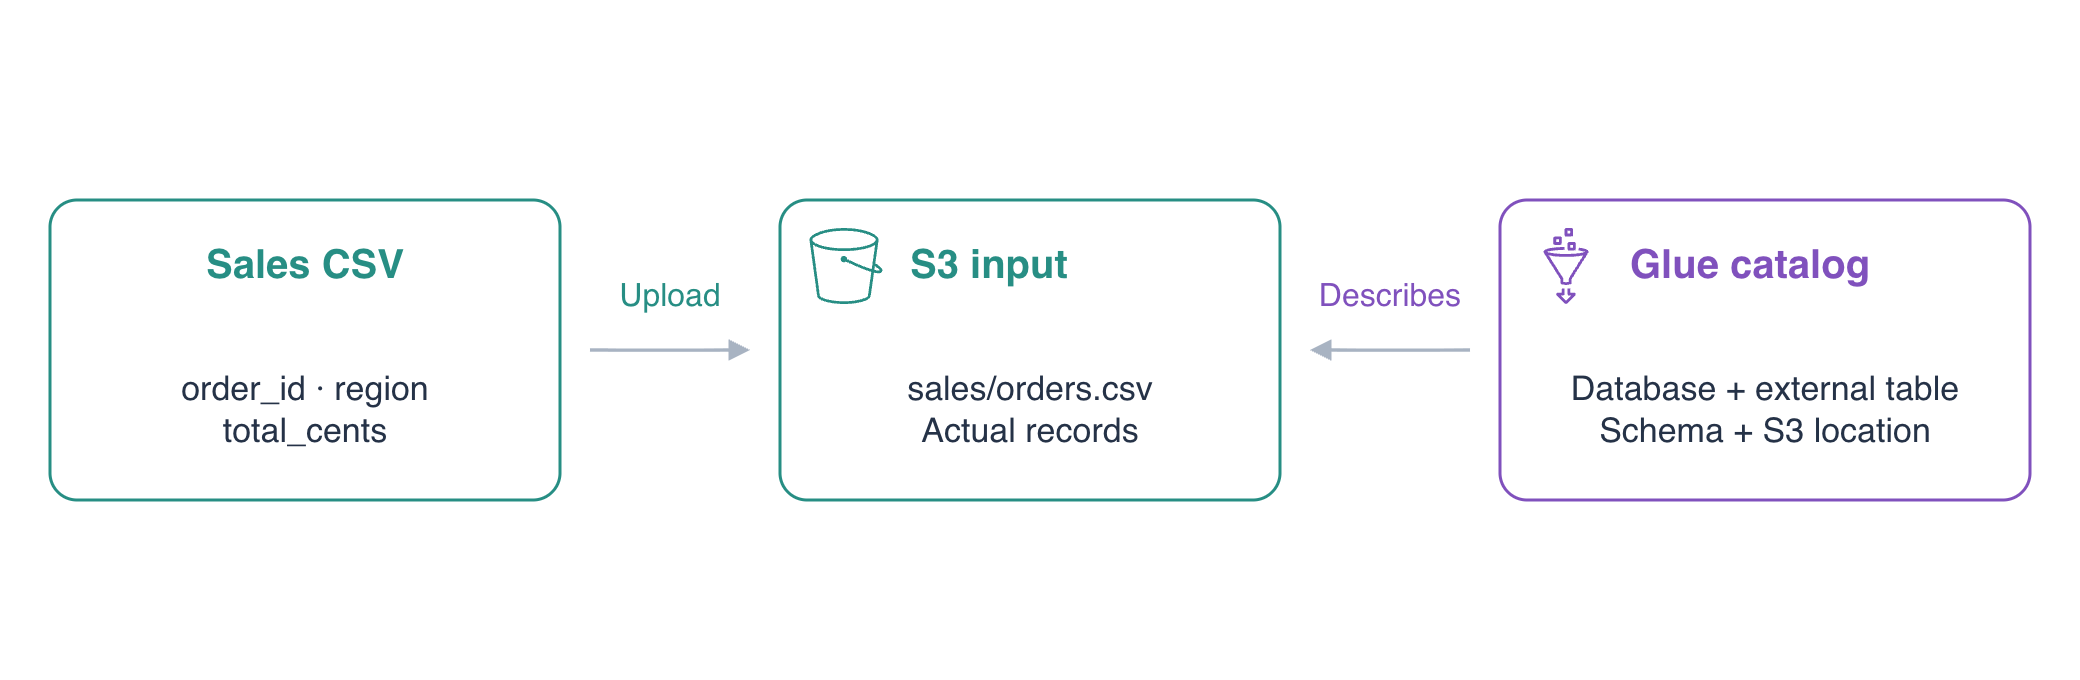
小さな店舗は販売データを CSV に出力します。分析担当者はデータベースサーバーへコピーせずにファイルを照会したいと考えています。Amazon S3 に保存し、AWS Glue Data Catalog に定義します。このメタデータのディレクトリは、データの場所と読み方をクエリサービスに伝えます。
AWS Foundations for Beginners、基本的な S3 操作、IAM の ID の基礎を先に学んでください。この独立環境には空の S3 バケット、CSV、設定済み AWS CLI の ID があり、個人アカウントや別ラボのリソースは不要です。Terminal で操作し、AWS View で実際のオブジェクトとカタログを確認します。カタログはファイルを記述するだけで、コピー、変換、照会は行いません。Athena は次のラボで使います。
認定試験との関連
| 認定 | 試験タスク | 実践 |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | ファイル分析における Glue のカタログと S3 のデータ保存を区別します。 |
販売ファイルをアップロードする
このステップでは、提供データを確認して S3 にアップロードします。CSV は 1 行が 1 レコードで、フィールドはカンマ区切りです。最初の行はフィールド名です。スキーマは名前、順序、型を定義し、クエリがレコードを正しく解釈できるようにします。
プロジェクトへ移動して設定済みの ID を確認します:
cd /home/labex/project
aws sts \
  get-caller-identity
ARN の末尾は labex-an01-operator です。この ID の S3 と Glue リソースを使います。September のファイルを読みます:
cat september.csv
3 件の販売記録には order_id、region、total_cents があります。最初の 2 列は文字列、金額は整数のセントです。1000、2000、500 の合計は 3500 セントです。値は引用符なしで、ヘッダーは 1 行です。
新しい環境には一意の入力バケットがあります。jq -r は JSON 値を文字列として取り出し、$(...) は出力を変数に保存します。名前を保存して表示します:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
表が読むデータをまとめる sales/ プレフィックスの sales/orders.csv にアップロードします:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
実際のオブジェクトを読み戻します:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
末尾の - は内容を端末に表示します。ヘッダーと 3 レコードは september.csv と一致するはずです。AWS View でオブジェクトを展開し、内容を比較してください。sales/ 外の無関係な reference/notes.txt は変更しません。
カタログデータベースを作成する
このステップでは、テーブル定義の名前空間を作ります。Glue データベースはカタログテーブルをまとめ、メタデータを保存します。データベースサーバーではなく、作成しても S3 ファイルは移動しません。
リソース一覧から名前を読みます:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input は名前と説明の通常の JSON 定義を受け取ります:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
作成成功時は本文が表示されません。読み戻して存在を確認します:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
名前は labex_sales、説明は指定した値です。AWS View にデータベースとまだテーブルがない状態が表示されます。S3 ファイルは元の場所にあります。
外部テーブルでファイルを定義する
このステップでは、 CSV フィールドを名前と型に対応付け、実際の S3 プレフィックスを指す表を作ります。外部テーブルはカタログの外にあるデータを記述します。表定義を削除しても S3 オブジェクト自体は削除されません。
ストレージ記述子には列、場所、読み取り設定があります。SerDe はシリアライザー/デシリアライザーで、レコードを表のフィールドへ解釈します。LazySimpleSerDe は引用符なしのカンマ区切りを読みます。ヘッダーは販売記録ではないため、skip.header.line.count で最初の行を除外します。
表の場所に使うプレフィックスを保存、表示します:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF は終了の EOF までの内容をファイルへ書きます。区切りが引用されていないため、$SALES_LOCATION は実際のバケットの場所に展開されます:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys は空です。最初の表は分割されていない 1 つのプレフィックスを読み、月別パーティションは後で学びます。2 つの形式クラスはテキスト入力と通常の Hive 互換出力を記述します。自分でインストールや実行は不要です。
file:// でローカル JSON を CLI に読み込ませ、表を作ります:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Glue から定義を読み戻します:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
列順が CSV のヘッダーと一致し、total_cents が int、場所が /sales/ で終わり、ヘッダー設定が 1 であることを確認します。AWS View は S3 と Glue の定義を並べて表示します。
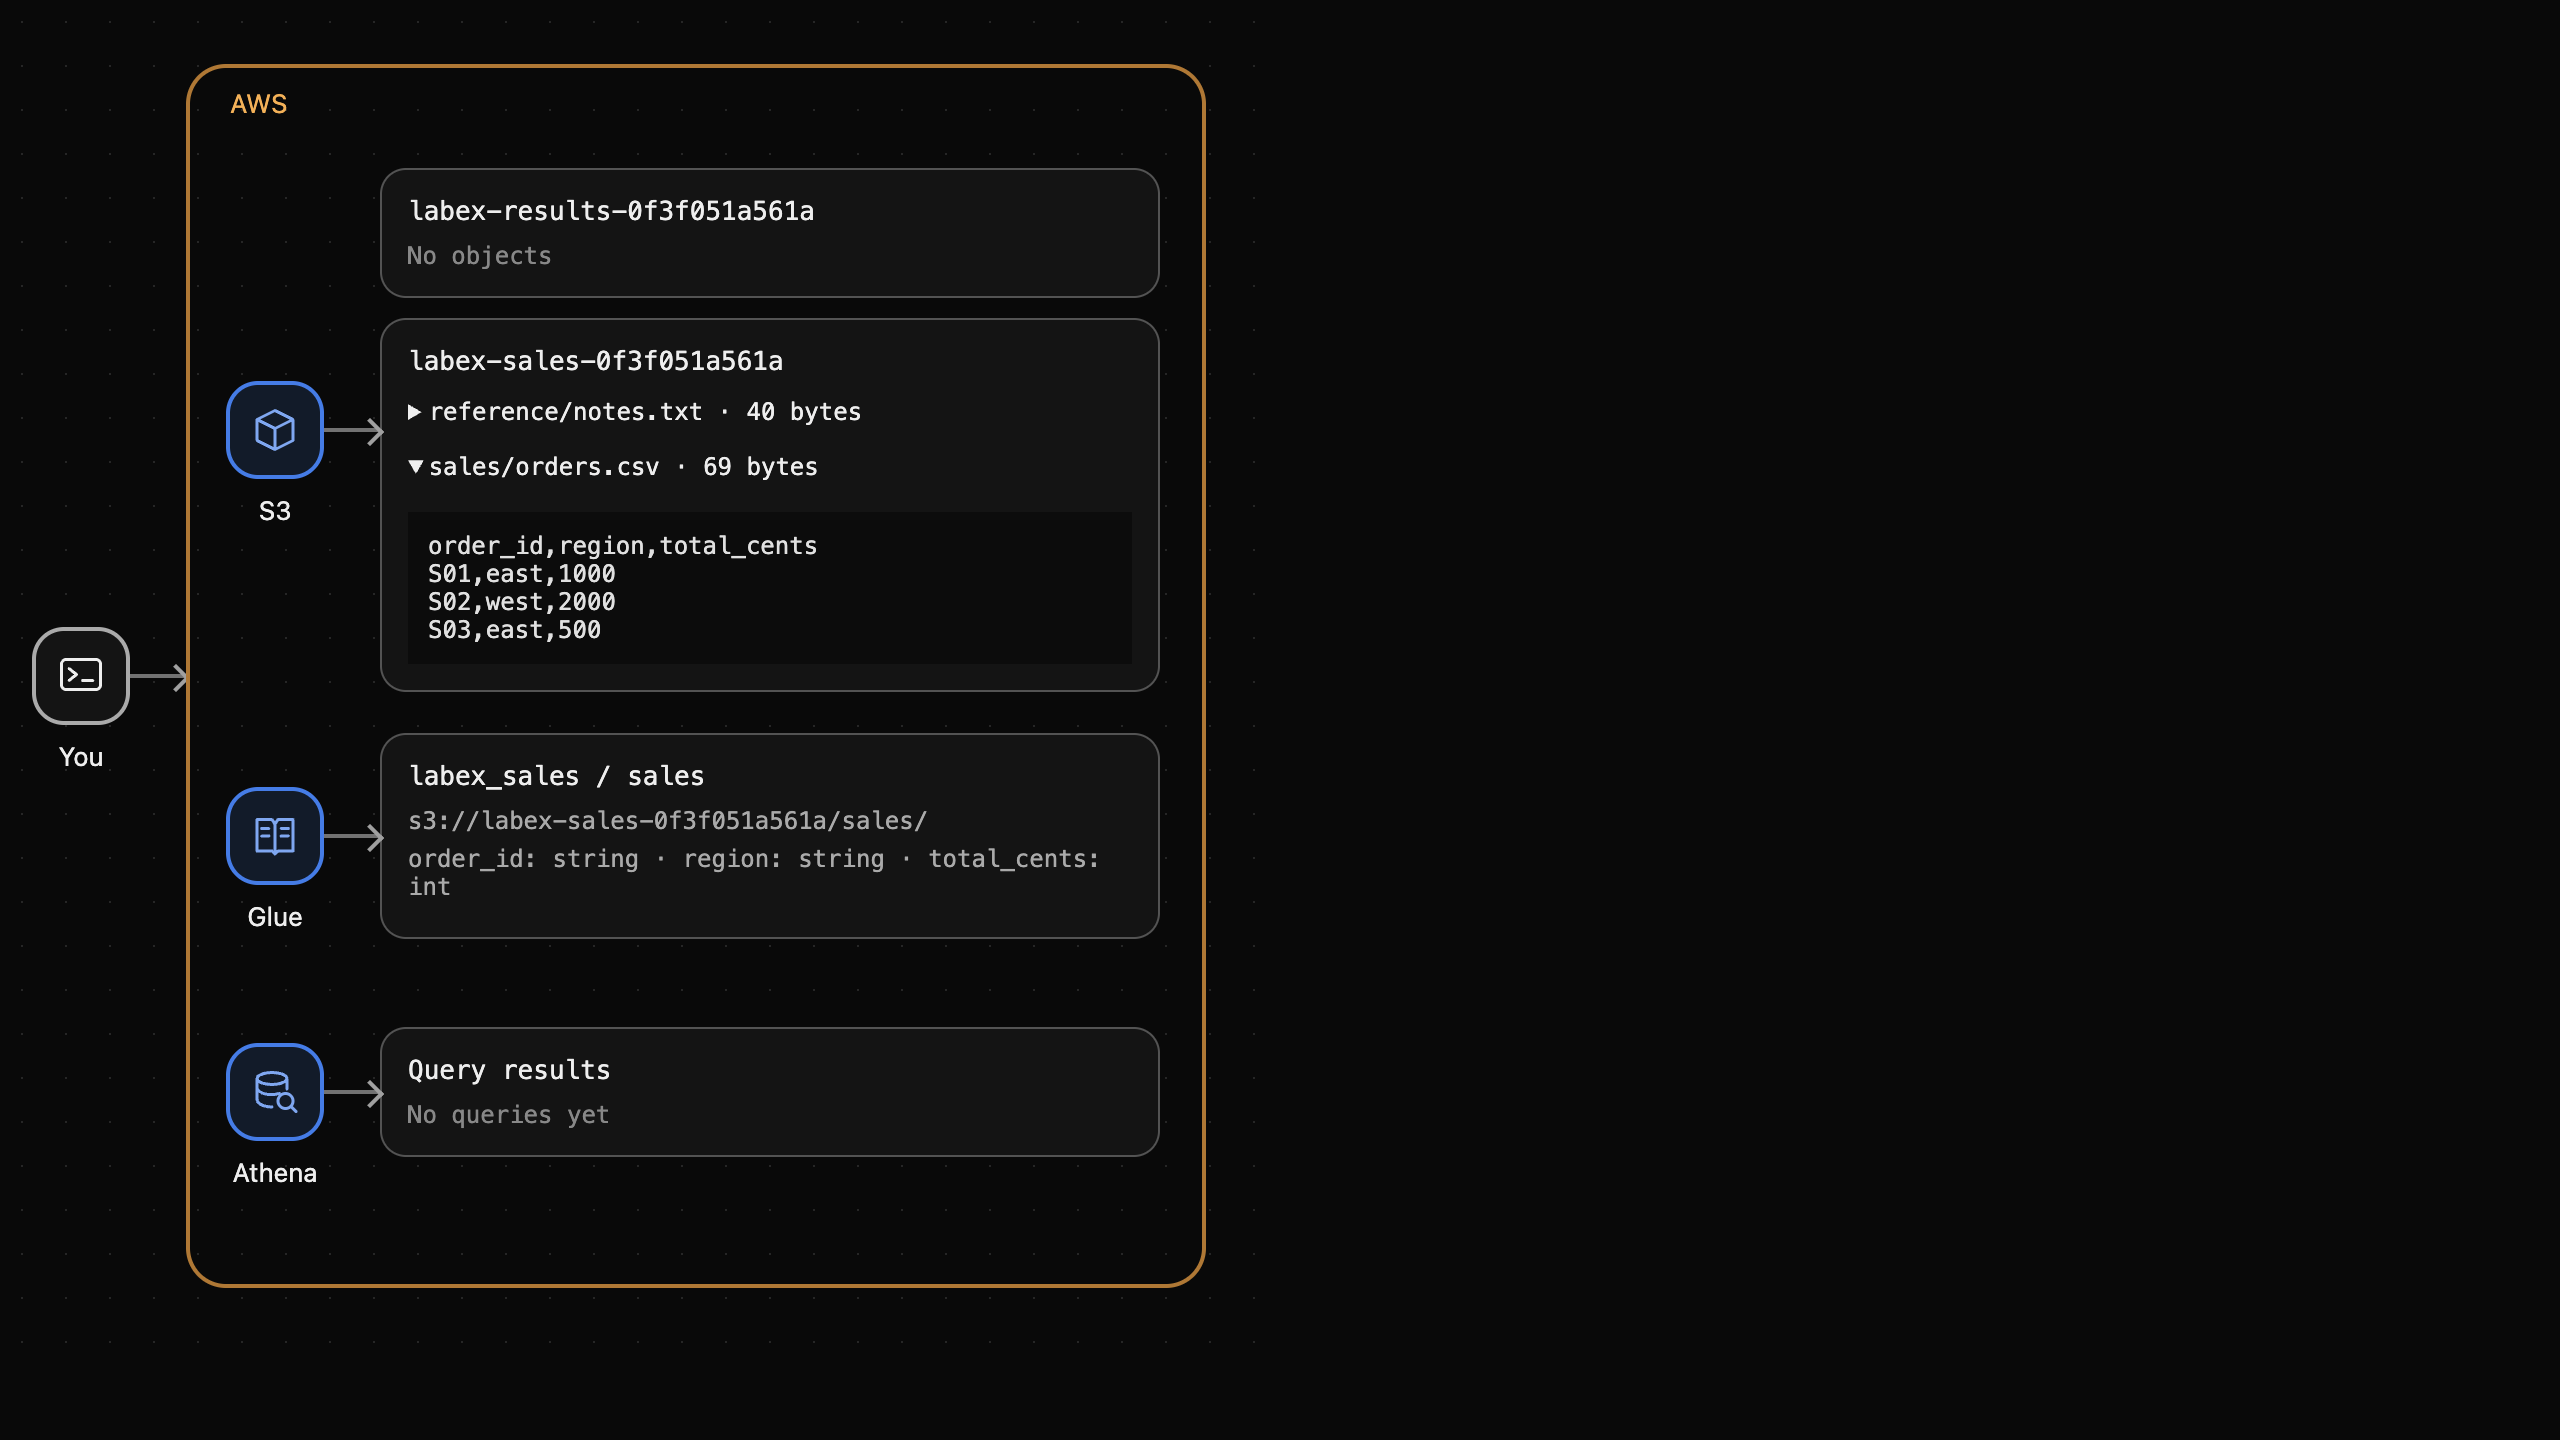
カタログ作成は CSV を変更せず、Athena の結果も生成しません。スキーマや場所が間違うと後のクエリが失敗したり、別の記録を読んだりします。正しいメタデータがクエリの土台になります。
まとめ
実際の販売記録を S3 にアップロードし、Glue データベースと、列、CSV 形式、場所が一致する外部テーブルを作りました。S3 はデータ、Glue はメタデータを保持します。次のラボでは独立して準備されたデータをこのモデルで Athena から照会します。
詳しくは、AWS 公式ドキュメントを参照してください:カタログメタデータを手動で定義する; 引用符なしの CSV フィールドとヘッダー処理。