はじめに
運用チームには、リクエストが失敗すると発生し、正常なトラフィックの後に回復するエラーのシグナルが必要です。このラボでは、メトリクスアラームを設定し、実際のリクエストによる両方の状態遷移を観察します。ゼロと欠損データを比較し、最後に自分のアラームを削除します。
最初に CloudWatch メトリクスでアプリケーションの健全性を測定する を完了し、メトリクスのディメンションと Sum を学んでください。このラボには、新しいアプリケーションとメトリクス系列が用意されています。
認定試験との関連
| 認定資格 | 試験タスク | 実習内容 |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | タスク 1.1 | CloudWatch アラームの評価、正常状態への復帰、欠損データ。 |
| DevOps Engineer – Professional (DOP-C02) | タスク 4.2 | 基礎演習:CloudWatch アラームの評価、正常状態への復帰、欠損データ。 |
| Solutions Architect – Professional (SAP-C02) | タスク 3.1 | 基礎演習:CloudWatch アラームの評価、正常状態への復帰、欠損データ。 |
実験の概要
メトリクスアラームを設定する
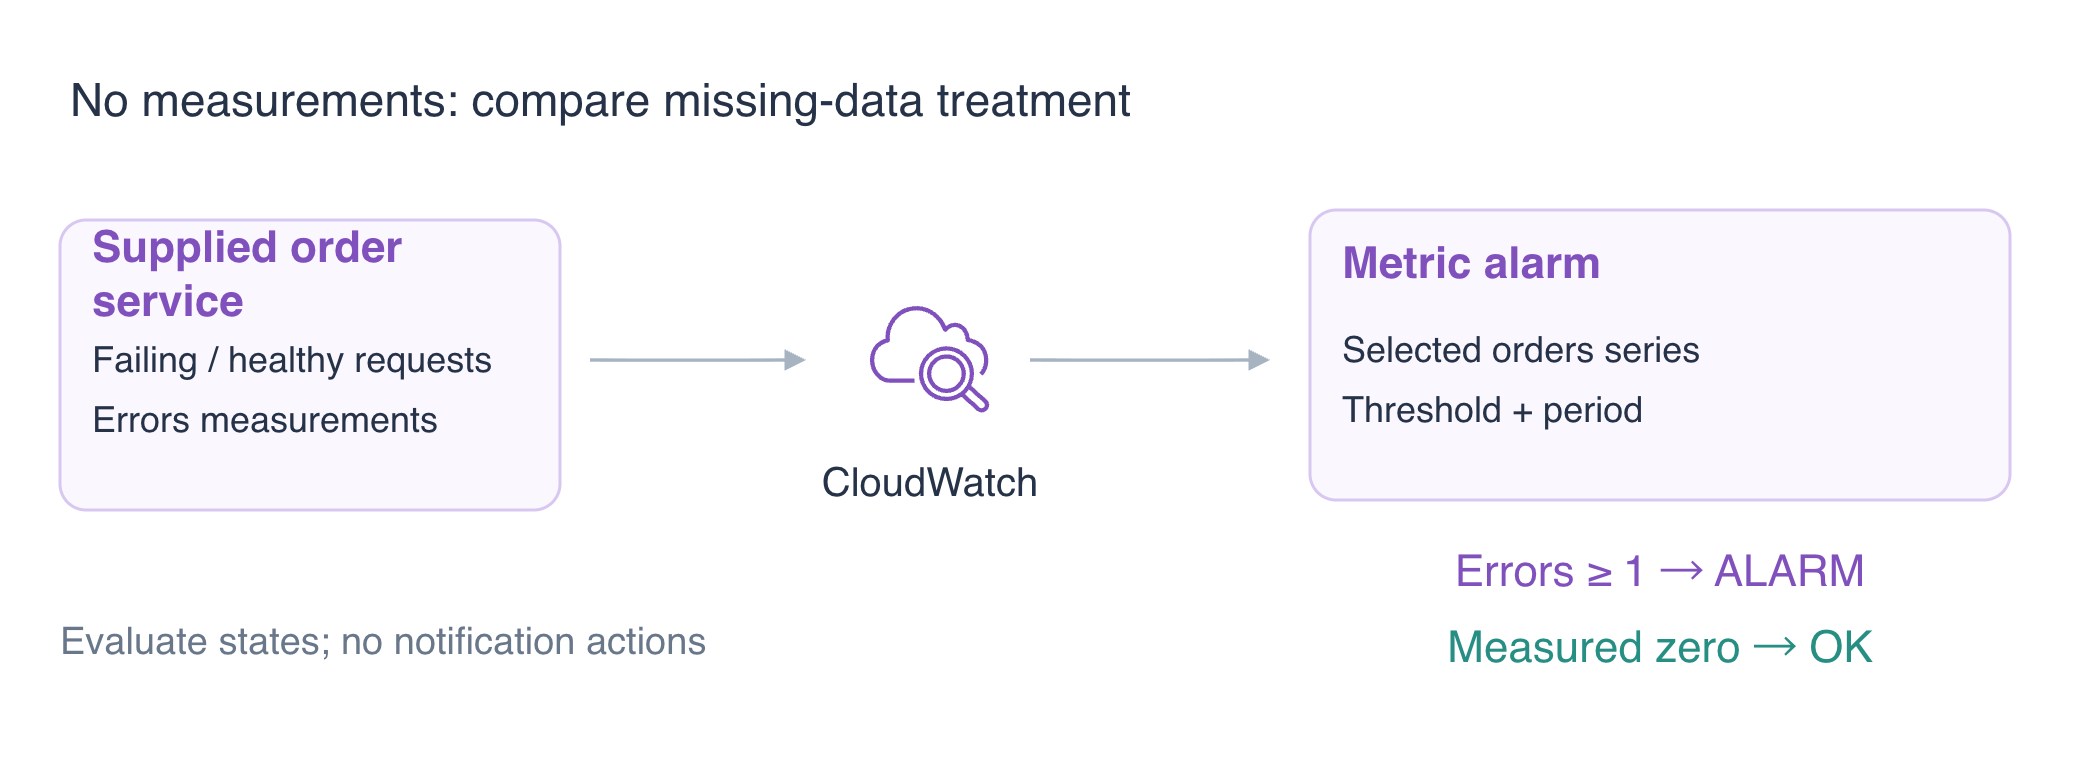
このステップでは、orders アプリケーションのサーバーエラー数を監視します。アラームは、メトリクスをしきい値と比較して評価し、OK、ALARM、INSUFFICIENT_DATA を報告します。アクションを設定しない限り、通知は送信しません。この演習では評価に集中します。
独立して準備されたアプリケーションは、実際のリクエストのメトリクスを公開します。Errors メトリクスは HTTP 5xx で 1、正常なリクエストで 0 です。高解像度の公開により 10 秒周期を使えるため、いくつもの周期を短時間で観察できます。本番環境の周期としきい値は、ワークロードと費用に応じて決まります。
cd /home/labex/project
単一メトリクスのアラームを作成します。名前空間、名前、ディメンションで系列を選びます。Sum は、完了した各周期のエラー数を数えます。
アラームは、完了した 10 秒周期を 1 つ評価します(--period 10、--evaluation-periods 1)。Sum が 1 以上になるとしきい値に達します。GreaterThanOrEqualToThreshold は「しきい値以上」を意味します。notBreaching は、測定値がない周期を、しきい値を超えていないものとして扱います。これにより、アイドル状態の周期は OK になりますが、アプリケーションの健全性を証明するわけではありません。
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
以下のコマンドでアラームを読み取ります。評価がまだ完了していない場合は、数秒待ち、OK を返すまでこの読み取りコマンドを繰り返してください。
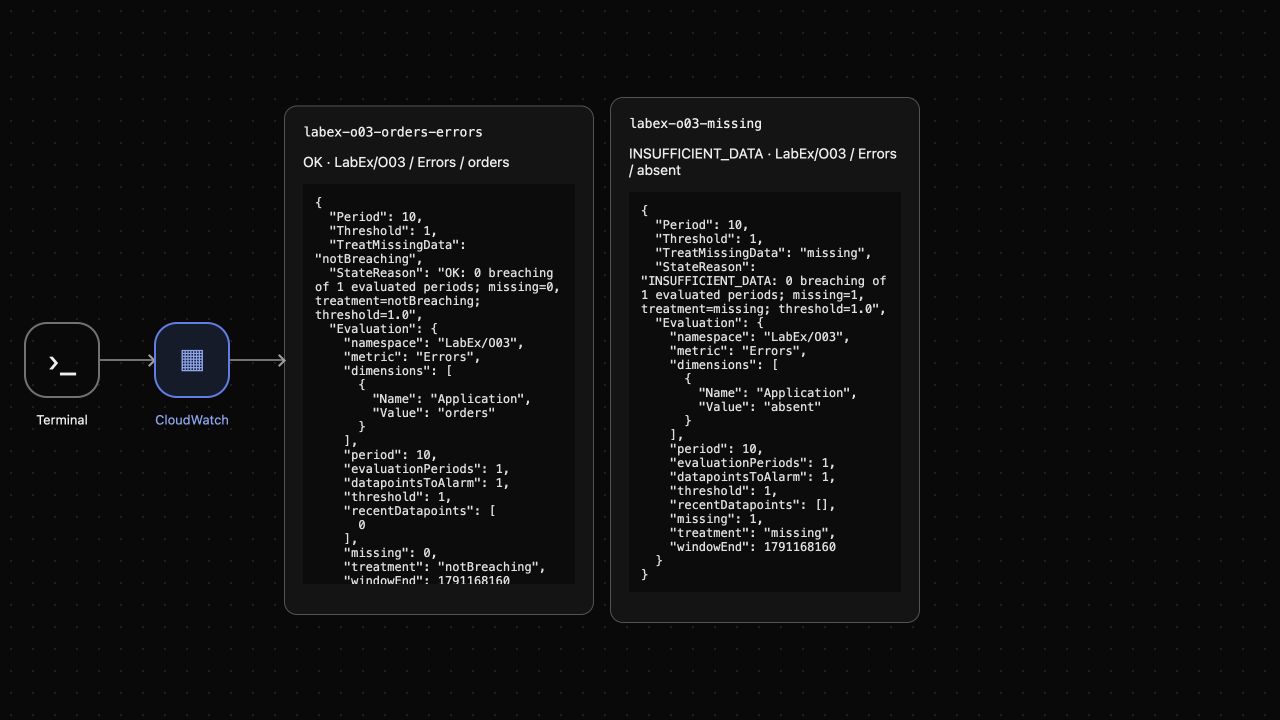
最初の OK は、欠損データの扱いによるものであり、ヘルスチェックが成功したためではありません。評価理由を確認します。
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
/labex/o03-reference は変更せずに保持します。各ラボは独立して開始するため、以前のメトリクスデータは必要ありません。
実際の失敗でアラームを発生させる
このステップでは、実際に失敗するリクエストを生成し、自動評価を待ちます。完了した周期には、現在の未完了の周期のデータポイントは含まれません。HTTP レスポンスの確認とアラーム状態の確認は、別々の観察です。
提供されたサービスでは pear は利用できません。このループは、複数の 10 秒周期にまたがるように、2 秒間隔で 9 件のリクエストを送ります。for はコマンドを繰り返し、sleep 2 はリクエスト間で待ちます。-f を付けない curl は HTTP 503 でもレスポンス本文を返すため、失敗を観察できます。
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
評価された状態を読み取ります。まだ ALARM になっていない場合は、数秒待ち、このコマンドを繰り返してください。StateReasonData は文字列として保存された JSON なので、レスポンスでは引用符がエスケープされて表示されます。recentDatapoints には、評価された周期の合計値が並びます。
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
ALARM と、StateReasonData 内の 1 以上の recentDatapoints 値が返るはずです。評価に前の周期がまだ表示されている場合は、数秒待って読み取りコマンドを繰り返してください。状態は、実際のリクエストから生成されたデータポイントに従います。アラーム状態を手動で設定しないでください。このアラームは orders だけを監視するため、別のアプリケーションの系列は評価に含まれません。
注文チームにとって ALARM は、選択した期間にサーバーエラーがあるかを示します。どのリクエストが失敗したか、なぜ在庫がなかったかまでは説明しません。HTTP 応答は業務リクエストの失敗、評価されたデータポイントはアラームの状態変化を示し、リクエストログは診断の詳細を提供します。調査対象を決めるときは、それぞれの観察結果を区別してください。
回復と欠損データを観察する
このステップでは、実際のゼロと、測定データがない状態を区別します。正常な apple のリクエストを送り、完了した周期に測定された Errors=0 を含めます。複数の周期にわたって繰り返すことで、現在の未完了の集計区間を回復と誤認しないようにします。
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
評価された状態を読み取ります。まだ OK になっていない場合は、数秒待ち、このコマンドを繰り返してください。
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
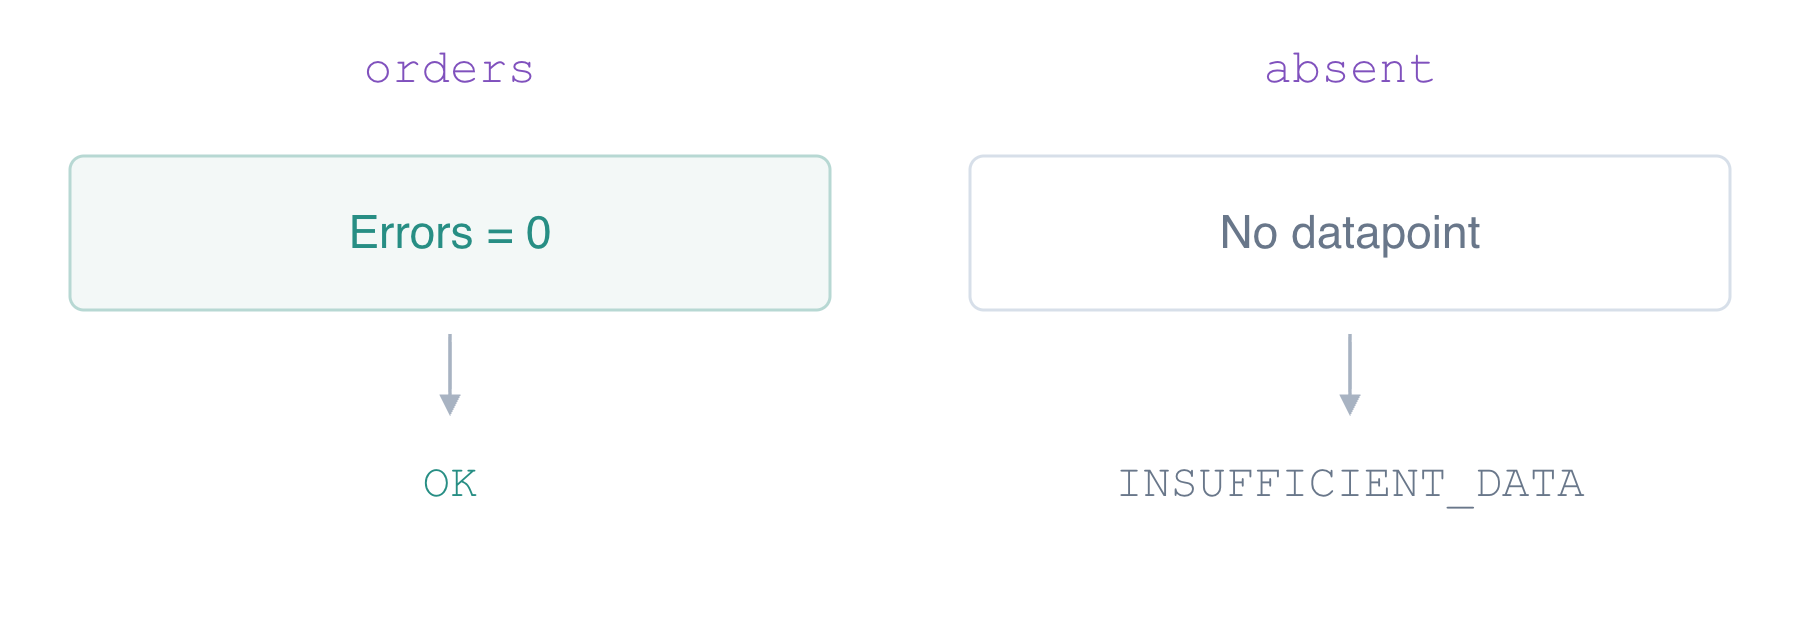
OK と recentDatapoints: [0] が返るはずです。空のリストは測定データがないことを意味するため、先に進む前に、測定されたゼロを確認してください。
アプリケーションが一度も公開しない系列である Application=absent に対して、別のアラームを作成します。欠損データを正常とは扱わず、欠損として扱います。
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
選択した系列に測定値がないため、新しいアラームは INSUFFICIENT_DATA のままになるはずです。
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
orders は測定されたゼロによって OK、absent は INSUFFICIENT_DATA になるはずです。評価理由を使い、測定されたゼロと測定データがない状態を区別してください。
AWS View は、実際のサービスの状態と、評価されたデータポイントを表示します。すべての OK をアプリケーションの健全性の証明として扱わず、理由を比較してください。
所有するアラームを削除し、公開を停止する
このステップでは、このラボのアラームだけを削除し、無関係なデータを保持します。削除前に計測を無効にし、アプリケーションが新しいデータポイントを公開しないようにします。
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
アラーム一覧は空になり、INFO platform reference keep unchanged が返るはずです。既存のメトリクスのデータポイントは保持されます。CloudWatch には、個別のメトリクスを削除する明示的な API はありません。その後、制作者やプラットフォームによる後片付けで、この使い捨ての環境を削除します。
まとめ
エラーのアラームを設定し、実際のリクエストによる自動発生と回復を観察しました。測定されたゼロと欠損データを区別し、参照ログを保持しながら、所有するアラームを削除しました。
詳しくは、AWS 公式ドキュメントを参照してください:メトリクスアラームとアクション; 欠落データがある場合のアラーム評価。