はじめに
梱包チームは、顧客をまたいで NEW 状態の注文を取得する必要があります。顧客と日付を使ったプライマリキーでは、ベーステーブルへの 1 回の Query でこのアクセスパターンに対応できません。このラボでは、グローバルセカンダリインデックスを追加し、投影する属性を選び、実際の待ち行列をクエリします。さらに、ベーステーブルへの書き込み後、梱包済みになった注文がインデックスのパーティション間を移動する様子を確認します。
最初に「パーティションキーとソートキーで注文をクエリする」を完了してください。この新しい VM には、ベーステーブル、架空のレコード、参照テーブル、アプリケーションのひな形だけが準備されています。インデックスの作成と検索の設定は、自分で行います。/home/labex/project、公式 AWS CLI、AWS View を使用してください。
認定試験との関連
| 認定資格 | 試験タスク | 演習内容 |
|---|---|---|
| Solutions Architect – Associate (SAA-C03) | タスク 3.3 | DynamoDB のセカンダリインデックスと属性の射影。 |
| Developer – Associate (DVA-C02) | タスク 1.3 | DynamoDB のセカンダリインデックスと属性の射影。 |
| Data Engineer – Associate (DEA-C01) | タスク 2.4 | 基礎演習:DynamoDB のセカンダリインデックスと属性の射影。 |
ラボの概要
別のアクセスパターンを追加する
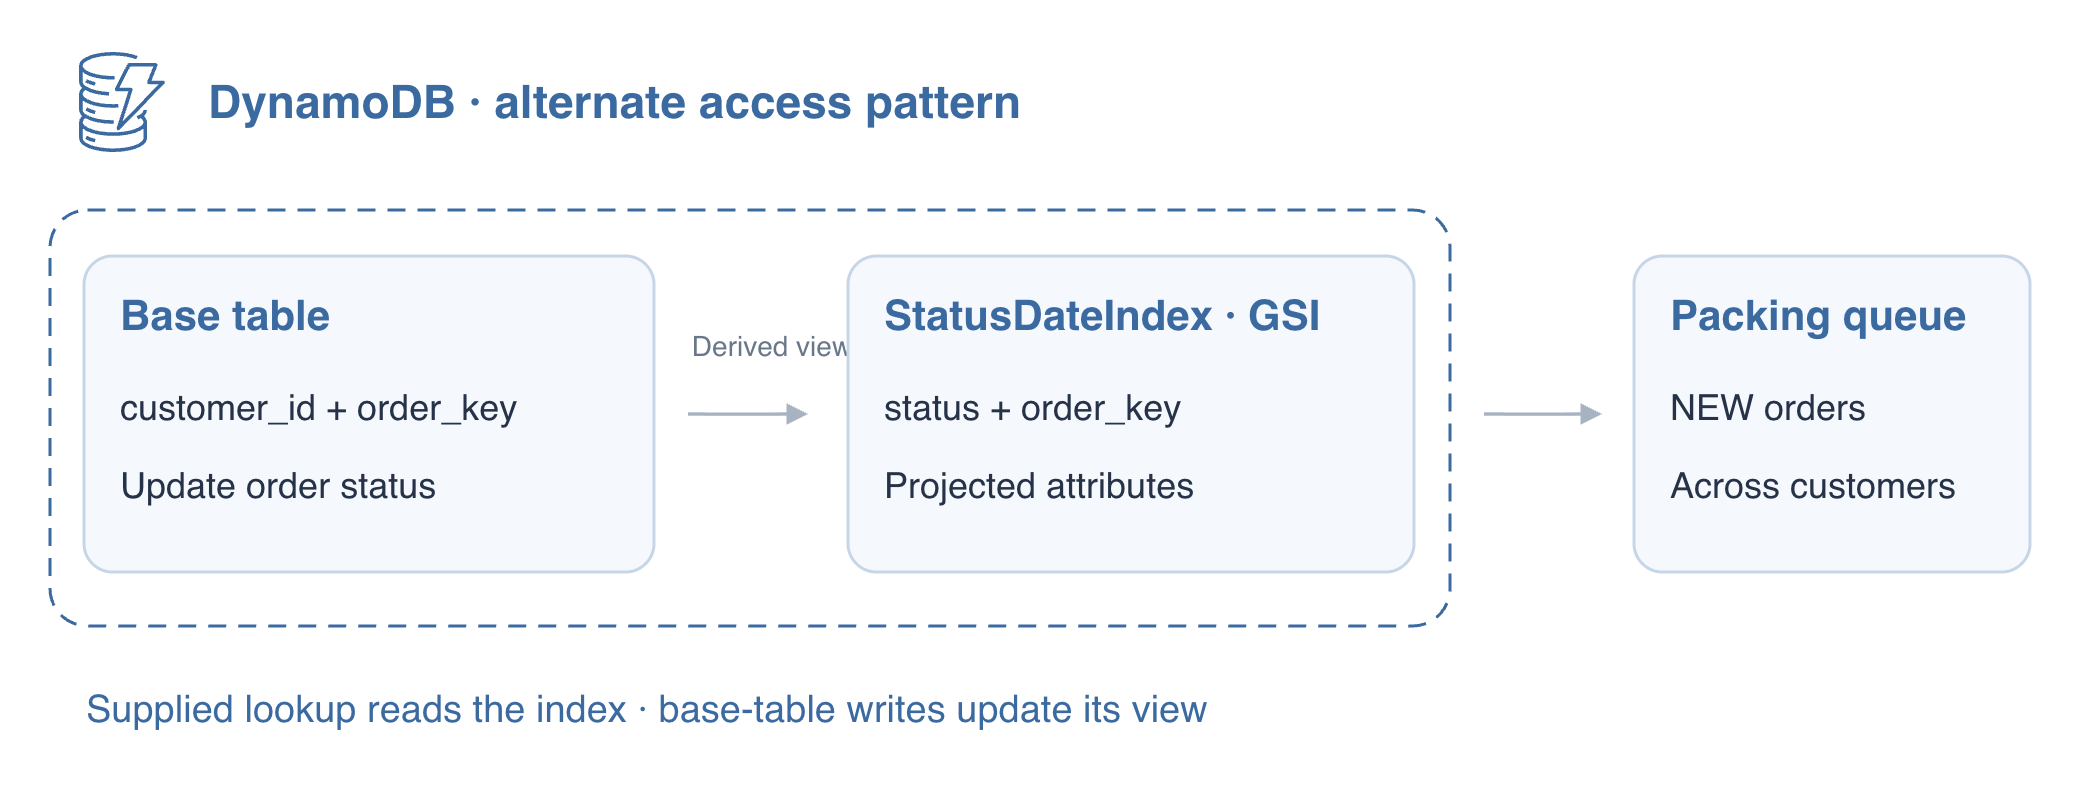
このステップでは、顧客をまたいで NEW 状態の注文を取得する梱包待ち行列のインデックスを追加します。準備済みのテーブルは customer_id と order_key を使っています。status はそのパーティションキーではないため、ベーステーブルの Query では状態を指定してすべての顧客を選択できません。グローバルセカンダリインデックス(GSI)は、同じアイテムを別のパーティションキーとソートキーで参照するビューを提供します。
顧客検索と梱包キューは、同じ注文に対して異なる業務上の問いに答えます。GSI により、キューは顧客をまたぐステータスのパーティションを直接選べます。顧客の Query にステータスのフィルターを追加しても、その顧客のパーティションだけが対象となり、キューに必要な別のアクセス経路は作れません。
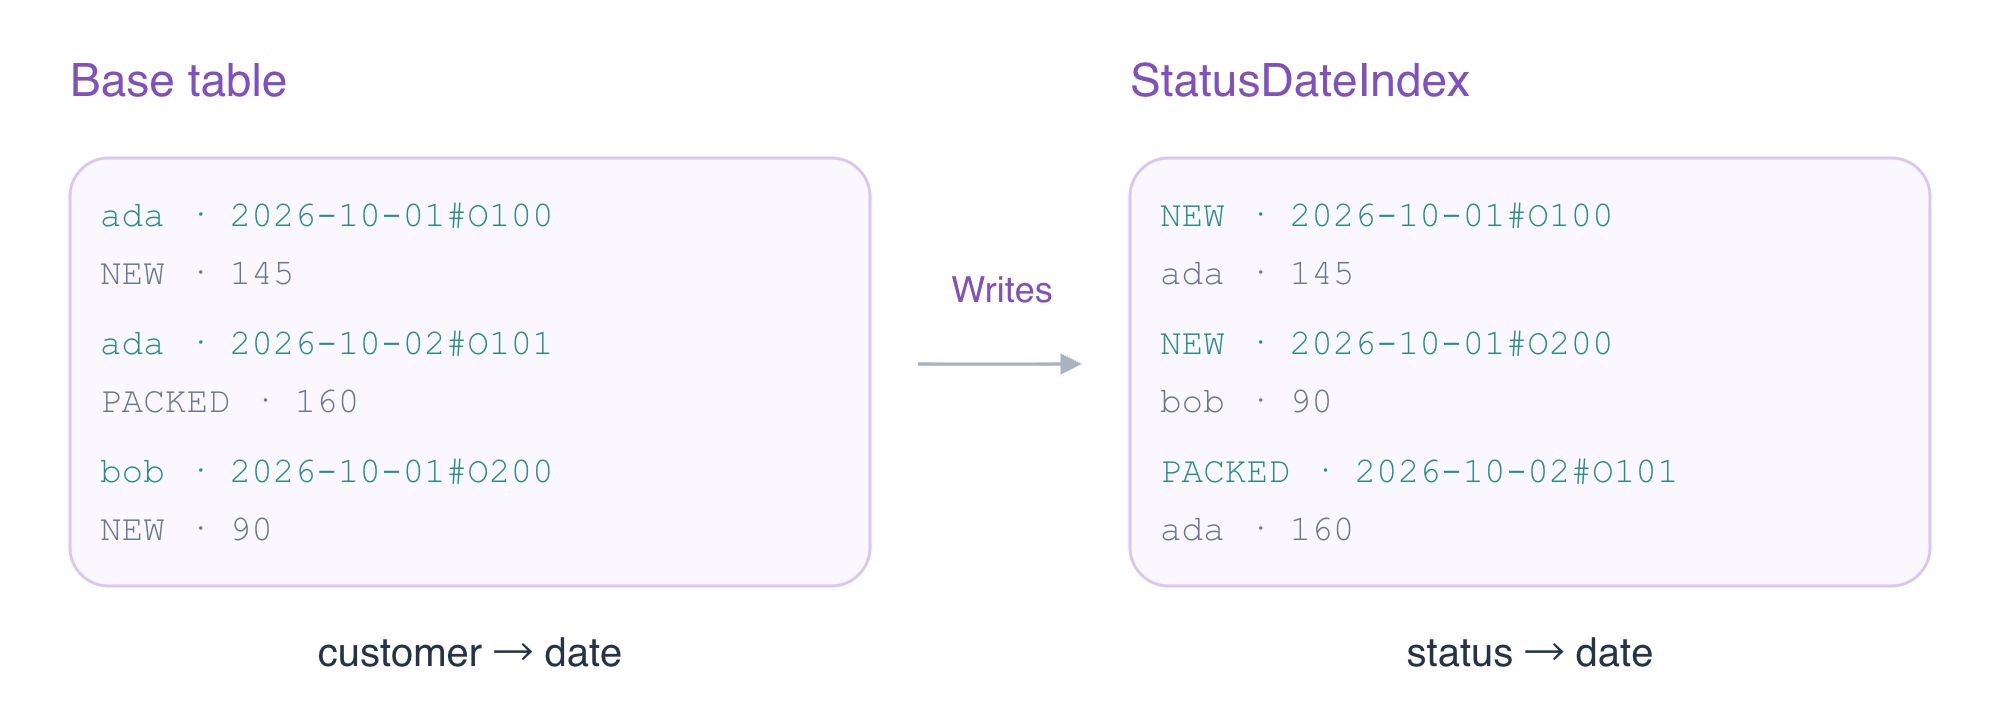
新しいアクセスパターンに集中できるように、注文テーブルと 3 件の架空のレコードは独立して準備されています。まず内容を確認してください。このラボで行う状態更新以外は、すべてのレコードを変更せずに保持します。
cd /home/labex/project
aws dynamodb describe-table --table-name labex-d03-orders --query 'Table.KeySchema'
aws dynamodb scan --table-name labex-d03-orders --consistent-read
status をパーティションキー、order_key をソートキーとする StatusDateIndex を追加します。投影は、インデックスに保存する属性を決めます。INCLUDE で amount を追加します。テーブルとインデックスのキーは自動的に含まれます。キーではない source 属性は、ベーステーブルだけに残ります。AWS では、インデックスの保存と書き込みに費用がかかります。
aws dynamodb update-table \
  --table-name labex-d03-orders \
  --attribute-definitions AttributeName=status,AttributeType=S AttributeName=order_key,AttributeType=S \
  --global-secondary-index-updates '[{"Create":{"IndexName":"StatusDateIndex","KeySchema":[{"AttributeName":"status","KeyType":"HASH"},{"AttributeName":"order_key","KeyType":"RANGE"}],"Projection":{"ProjectionType":"INCLUDE","NonKeyAttributes":["amount"]}}}]'
aws dynamodb describe-table \
  --table-name labex-d03-orders \
  --query 'Table.GlobalSecondaryIndexes[].{Name:IndexName,State:IndexStatus,Keys:KeySchema,Projection:Projection}'
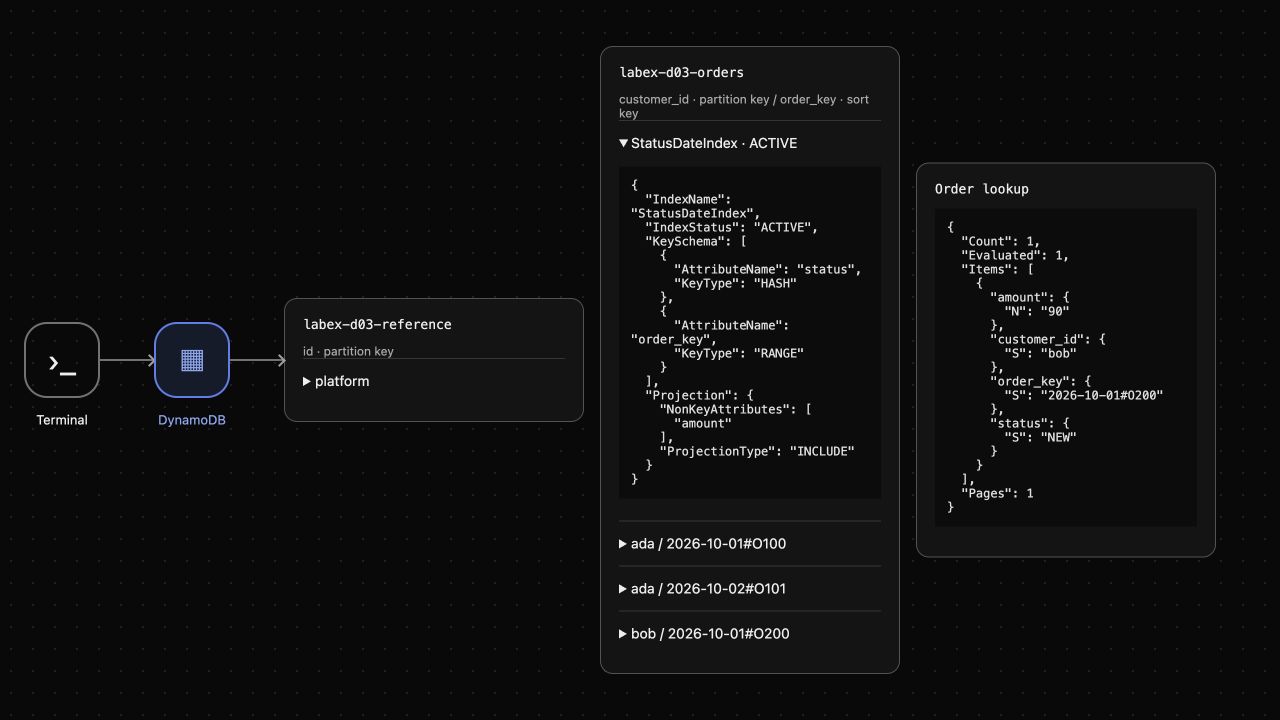
StatusDateIndex が ACTIVE を返してから先に進んでください。AWS では作成に時間がかかる場合があります。作成中であれば、describe コマンドを繰り返してください。table-exists の waiter では、新しいインデックスの準備完了は証明できません。AWS View は、サービスがインデックスを返すようになると、テーブルのカード内に表示します。
状態インデックスをクエリし、投影を確認する
このステップでは、別のキーを使って NEW の待ち行列を読み取ります。--index-name で GSI を選択します。キー条件には status の等価条件を使います。ベーステーブルのスキャンにフィルターを付ける方法では、先に無関係なアイテムも読み取ることになります。
aws dynamodb query \
  --table-name labex-d03-orders \
  --index-name StatusDateIndex \
  --key-condition-expression '#state = :state' \
  --expression-attribute-names '{"#state":"status"}' \
  --expression-attribute-values '{":state":{"S":"NEW"}}'
インデックスは Ada の O100 と Bob の O200 を返し、それぞれに amount が含まれます。source 属性は投影しなかったため含まれません。ベーステーブルの追加属性を取得するには、キーを指定した別の読み取りが必要です。
AWS では GSI の更新は非同期で行われ、GSI の読み取りは結果整合性を持ちます。GSI の Query に --consistent-read を追加しないでください。そのリクエストは ValidationException で拒否されます。最近の書き込みがまだインデックスに反映されていない場合は、待ってから読み取りを繰り返してください。古い結果を、書き込みが失敗した証拠として扱ってはいけません。
前のラボで使った、提供済みの order-lookup アプリケーションは、通常の lookup.json 設定を読み取ります。このインデックスと NEW の待ち行列を選択するリクエストを書き込みます。引用符付きのヒアドキュメントは JSON をそのまま書き込みます。ConsistentRead: false により、インデックスの読み取り方法を明示します。
cat > lookup.json <<'JSON'
{
  "paginate": true,
  "request": {
    "TableName": "labex-d03-orders",
    "IndexName": "StatusDateIndex",
    "KeyConditionExpression": "#state = :state",
    "ExpressionAttributeNames": {
      "#state": "status"
    },
    "ExpressionAttributeValues": {
      ":state": {
        "S": "NEW"
      }
    },
    "ConsistentRead": false
  }
}
JSON
./order-lookup
アプリケーションは同じ 2 件の注文を返します。AWS View で StatusDateIndex を展開し、実際に投影された属性と検索結果を比較してください。状態別の待ち行列では、両方の顧客の注文を含めるのが正しい動作です。顧客別のビューには別のキーパターンが必要になります。
注文が状態別の待ち行列間を移動する様子を確認する
このステップでは、O100 を梱包済みにし、インデックスのエントリが移動する様子を確認します。GSI はベーステーブルへの書き込みに追従します。インデックスに直接書き込むことはありません。status を更新すると、ベーステーブルのプライマリキーは変わらず、アイテムが属するインデックスのパーティションが変わります。
aws dynamodb update-item \
  --table-name labex-d03-orders \
  --key '{"customer_id":{"S":"ada"},"order_key":{"S":"2026-10-01#O100"}}' \
  --update-expression 'SET #state = :state' \
  --expression-attribute-names '{"#state":"status"}' \
  --expression-attribute-values '{":state":{"S":"PACKED"}}' \
  --return-values ALL_NEW
./order-lookup
NEW の待ち行列には、Bob の O200 だけが残ります。PACKED をクエリし、O100 がサービスから消えたのではなく、O101 とともに表示されることを確認します。
aws dynamodb query \
  --table-name labex-d03-orders \
  --index-name StatusDateIndex \
  --key-condition-expression '#state = :state' \
  --expression-attribute-names '{"#state":"status"}' \
  --expression-attribute-values '{":state":{"S":"PACKED"}}'
PACKED には Ada の O100 と O101 が含まれるはずです。AWS では、インデックスへの反映を確認できるまで読み取りを繰り返してください。更新レスポンスと、強い整合性のあるベーステーブルの読み取りが、更新直後のアイテム状態を示す確かな情報です。GSI は結果整合性を持つ派生ビューです。AWS View には O100 の新しい状態と、O200 だけを含む NEW の検索結果が表示されます。
所有するインデックスとテーブルを削除する
このステップでは、別のビューを削除してから、所有するテーブルを削除します。インデックスを削除しても、ベーステーブルのアイテムはそのまま残ります。テーブルを削除すると、そのアイテムと残っているインデックスも削除されます。所有するリソースだけを名前で指定してください。
aws dynamodb update-table \
  --table-name labex-d03-orders \
  --global-secondary-index-updates '[{"Delete":{"IndexName":"StatusDateIndex"}}]'
aws dynamodb describe-table \
  --table-name labex-d03-orders \
  --query 'Table.GlobalSecondaryIndexes'
インデックスの一覧が空になってから先に進みます。AWS では、削除中は DescribeTable を繰り返してください。この時点では、テーブルに 3 件のアイテムが残っています。
aws dynamodb scan --table-name labex-d03-orders --consistent-read --select COUNT
aws dynamodb delete-table --table-name labex-d03-orders
aws dynamodb wait table-not-exists --table-name labex-d03-orders
aws dynamodb list-tables
aws dynamodb get-item \
  --table-name labex-d03-reference \
  --key '{"id":{"S":"platform"}}' \
  --consistent-read
注文テーブルとそのインデックスはなくなり、参照テーブルの note は keep unchanged のままです。一覧と参照データを正常に読み取れることにより、削除が完了した状態と、サービスに接続できない状態を区別できます。AWS View には無関係な参照テーブルだけが残ります。この使い捨ての接続は、VM とともに終了します。
まとめ
顧客をまたぐ状態別の待ち行列のために GSI を追加し、投影する属性を選択して、実際のクエリでインデックスのキーを使いました。ベーステーブルの状態を更新すると、プライマリキーを変えずに注文がインデックスのパーティション間を移動しました。ベーステーブルの更新直後の状態と、インデックスへの結果整合性による反映を区別し、最後に所有するインデックスとテーブルだけを削除しました。
詳しくは、AWS 公式ドキュメントを参照してください:グローバルセカンダリインデックス、射影、整合性。